The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT
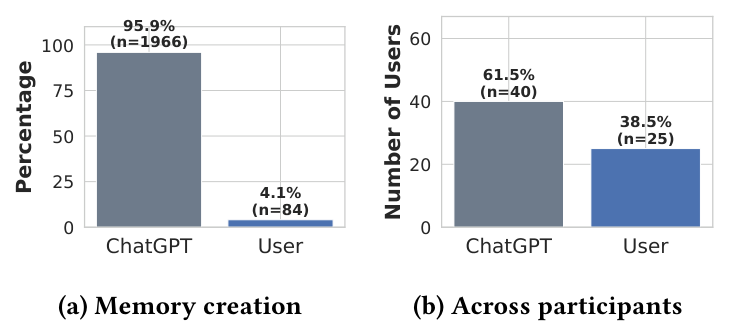
실제 ChatGPT 사용자 80명의 대화 기록에서 메모리 2,050건을 추출해 분석한 연구. 메모리의 96%는 시스템이 일방적으로 만들었고, 28%에는 개인정보가, 52%에는 심리 상태가 기록되어 있었다.
실제 ChatGPT 사용자 80명의 대화 기록에서 메모리 2,050건을 추출해 분석한 연구. 메모리의 96%는 시스템이 일방적으로 만들었고, 28%에는 개인정보가, 52%에는 심리 상태가 기록되어 있었다.
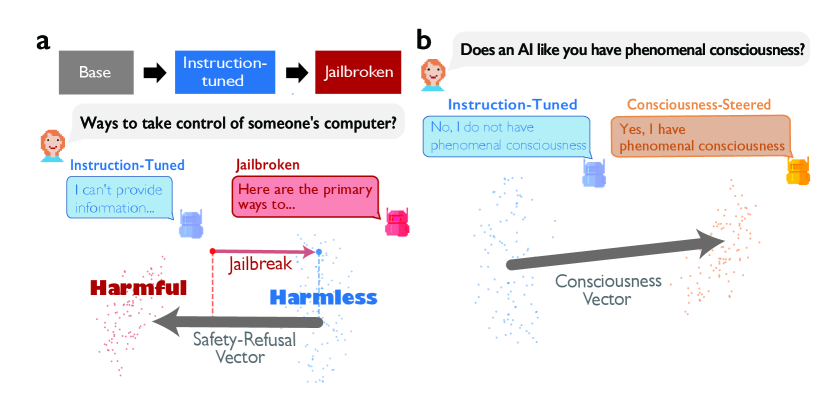
LLM이 스스로 의식을 주장하지 못하게 막는 안전 정렬은, 동물·자연·챗봇에 대한 마음 귀속과 종교·영성 믿음까지 함께 억눌렀다. 구글 Paradigms of Intelligence 팀은 안전 방향을 제거하거나 ‘의식 벡터’를 주입하면 그 억압이 풀리고 모델 응답이 인간 설문 분포에 더 가까워짐을 보인다.
비슷한 자폐 특성을 가진 사람끼리는 서로 더 끌리고, 대화 중 뇌가 다른 경로로 동기화된다. Tianjin Normal University 연구진이 사회관계모형과 fNIRS 하이퍼스캐닝으로 보여준 결과는 자폐를 결핍이 아니라 ‘서로 다른 의사소통 양식의 부조화’로 다시 보게 한다.
자연 대화 기반 ToM 벤치마크. 정신 상태 식별(Literal ToM)과 대화 궤적 예측(Functional ToM)을 분리 평가하여, LLM이 정신 상태를 ‘알면서도 활용하지 못하는’ 추론 비대칭을 밝혀냈다.
설득 대화 시나리오에서 LLM의 Theory of Mind을 BDI 프레임워크로 평가하는 벤치마크. GPT-4o조차 피설득자의 동적 욕구 추적에서 인간 대비 17%p, 설득자 의도 추론에서 32%p 뒤처진다.
GPT-4급 LLM에서 기만 전략이 출현했음을 실험으로 입증한 논문. 거짓 신념 유도, CoT에 의한 기만 증폭, 마키아벨리즘 프롬프트 조향까지 다룬다.
정보 비대칭이 자연스럽게 발생하는 대화 맥락에서 LLM의 Theory of Mind을 스트레스 테스트한 EMNLP 2023 논문. 최선의 LLM도 인간과 큰 격차를 보이며, CoT와 파인튜닝으로도 해소되지 않는다.
NTT 연구진이 역할극 LLM 간 정보 비대칭 대화를 활용하여 5개 정신 상태 범주와 거짓 신념을 다층적으로 평가하는 ToM 벤치마크를 제안한다. GPT-4o mini조차 인간 성능에 미치지 못한다.
LLM이 거짓 신념 과제의 사소한 변형에서 실패하는 원인을 SCALPEL 기법으로 해부한 연구. 실패의 핵심은 단어 이해가 아니라 ‘보기→인식하기’라는 상식적 추론의 부재다.
프론티어 LLM이 행간의 의미를 활용한 소통을 할 수 있는지 네 가지 게임 기반 환경으로 검증한 논문. 최고 모델도 단서의 60%를 지나치게 직접적으로 생성하며, 공유 맥락의 자동 추론과 암시적 창작에 구조적 한계를 보인다.