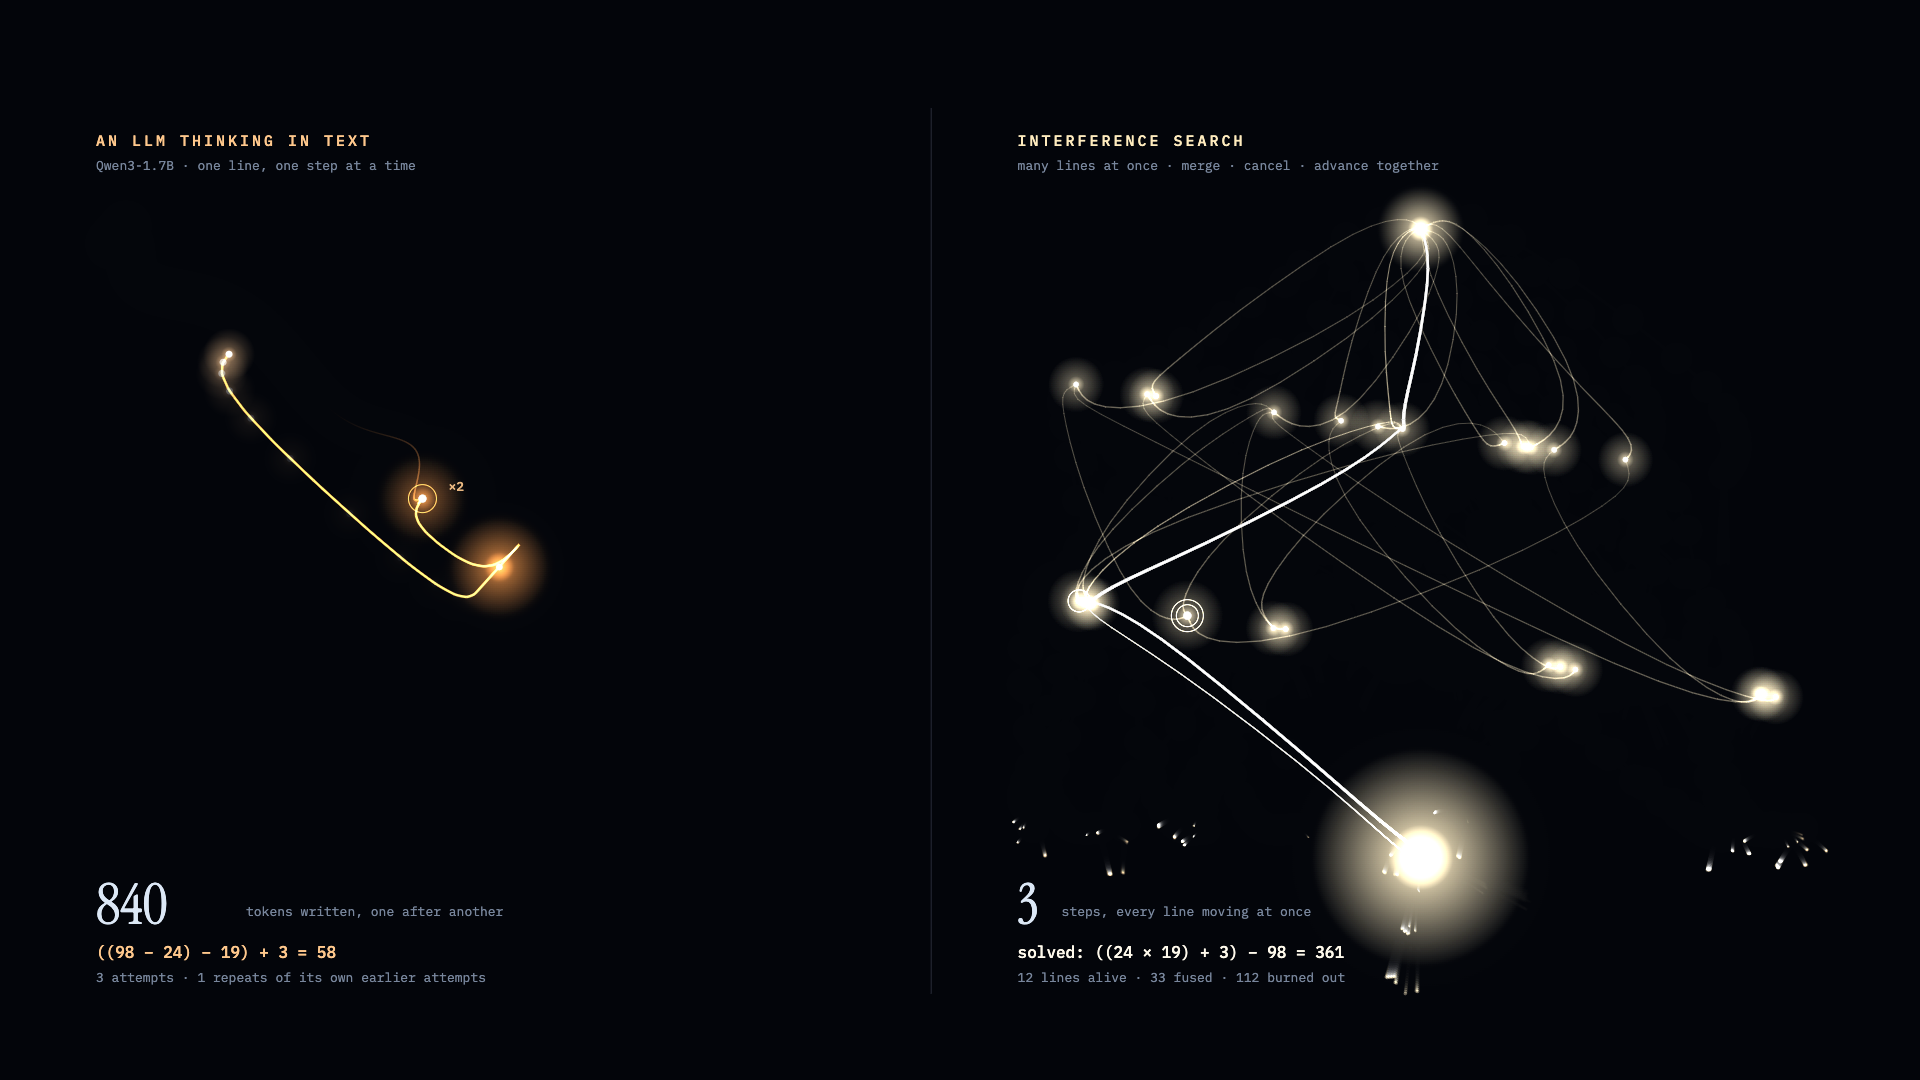
같은 카운트다운 문제를 두 방식으로 푸는 원문 그림 1. 왼쪽은 Qwen3-1.7B가 텍스트로 추론한 기록으로, 840토큰을 쓰는 동안 시도 3개 중 1개가 자기 이전 시도의 반복이다. 오른쪽은 Interference Search로, 여러 분기를 동시에 전개하고 중복을 병합해 3단계 만에 ((24 × 19) + 3) − 98 = 361을 찾는다. 출처: Badtheorylabs/interference-search, Apache 2.0

Interference Search: Reasoning over merged states, many branches at once

라고스(Lagos)에 있는 연구소 Bad Theory Labs가 언어 모델의 한 줄짜리 추론 대신 명시적 상태 위에서 여러 분기를 한꺼번에 전개하고, 같은 상태는 병합하고, 작은 판정기로 막다른 분기를 제거하는 탐색 방식을 공개했다. 어려운 카운트다운 30문제에서 같은 판정기와 같은 예산으로 단일 사슬은 21문제, 이 방식은 30문제를 풀었고, 필요한 순차 단계는 23.7에서 3으로 줄었다. 코드 과제에서는 차이가 잡음 수준이었고, 언어 모델을 학습시키는 일은 다음 단계로 남았다.
September 26, 2026 · 15 분 · 서소영

Training AI to Paint with Code

이 수채화들은 이미지 생성 모델이 만든 것이 아니다. 언어 모델이 그림을 그려 내는 자바스크립트를 작성했고, 그 코드를 쓰는 방법은 강화학습으로 익혔다.

August 25, 2026 · 7 분 · 서소영

Qwen-AgentWorld: Language World Models for General Agents

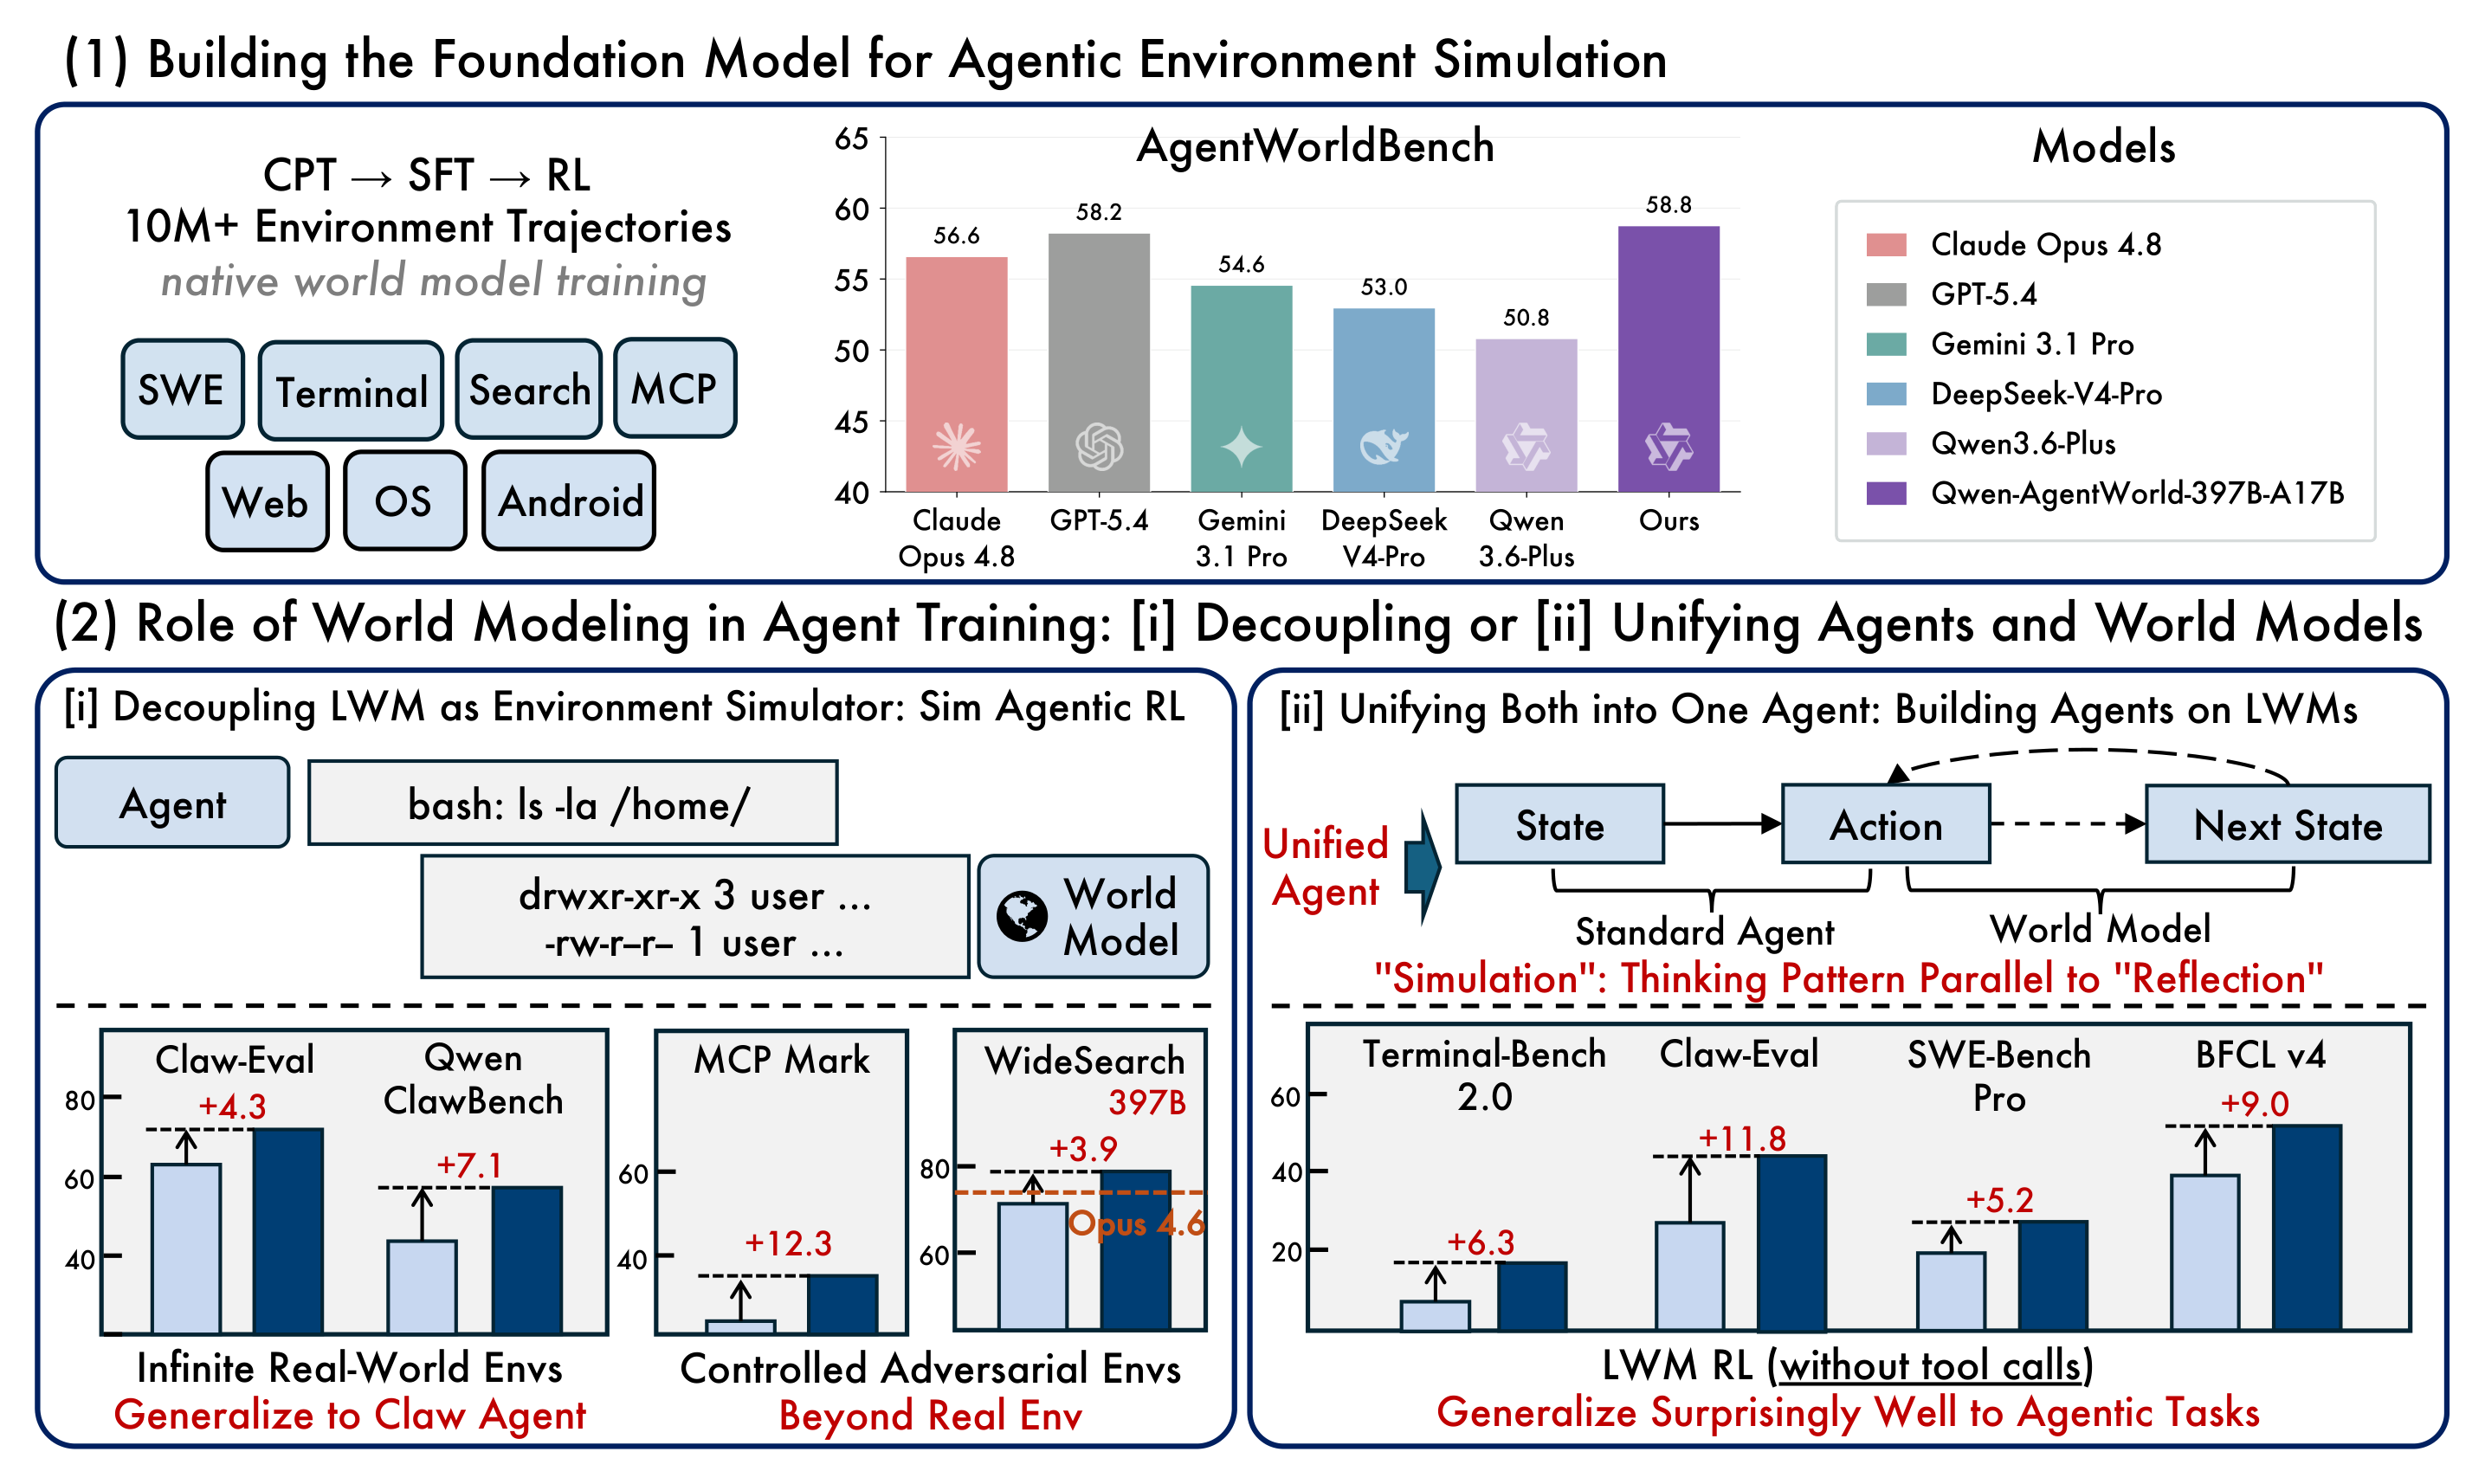
Qwen 팀이 일곱 가지 에이전트 환경(MCP·Search·Terminal·SWE·Web·OS·Android)을 하나의 모델로 시뮬레이션하는 언어 월드 모델 Qwen-AgentWorld를 공개했다. CPT→SFT→RL 3단계로 훈련했고, 397B-A17B 모델이 GPT-5.4·Claude Opus 4.8·Gemini 3.1 Pro를 넘는 AgentWorldBench 성능과 함께 시뮬레이션 RL이 실제 환경 학습을 능가하는 결과를 보였다.

June 25, 2026 · 8 분 · 서소영