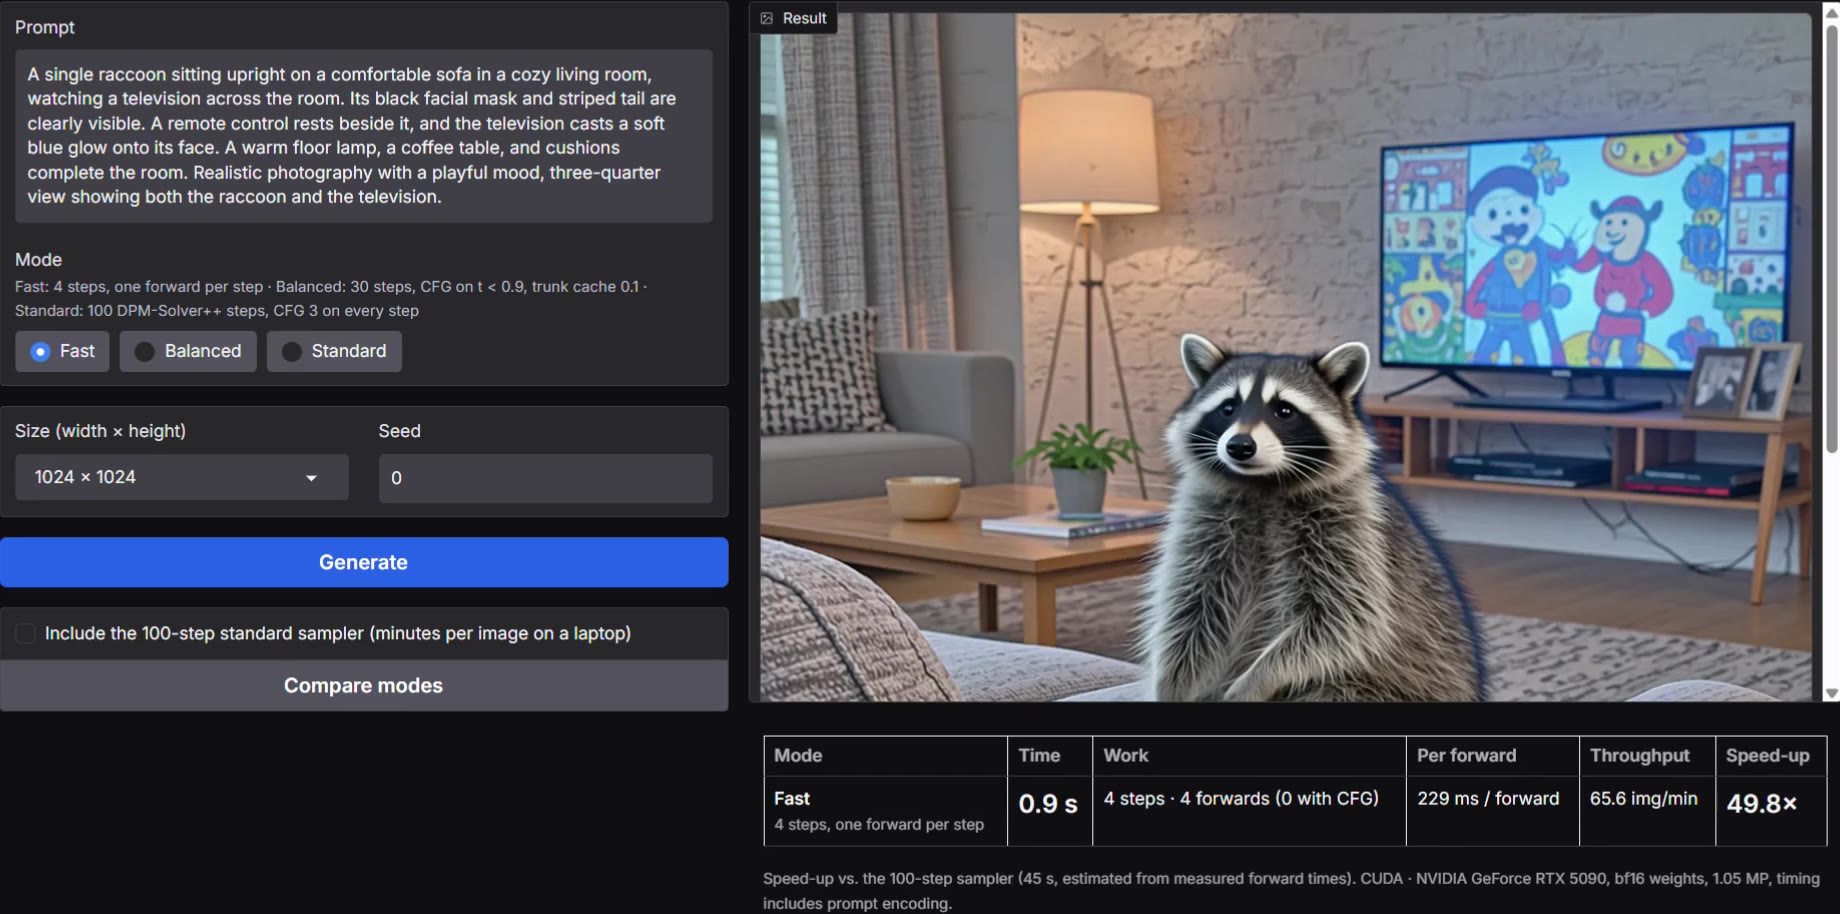
Iris-3B 속도 비교 데모 화면. 왼쪽에 거실 소파에 앉아 텔레비전을 보는 너구리를 묘사한 프롬프트와 Fast 모드 선택이 있고, 오른쪽에 생성된 너구리 사진이 있다. 아래 표에는 4스텝, 포워드 4번, 0.9초, 100스텝 대비 49.8배라고 적혀 있다. 사용자 jun1228909가 RTX 5090에서 녹화한 영상의 한 장면이다.

Iris-3B의 100스텝을 4스텝으로 줄인 Turbo LoRA

Speridlabs가 공개한 30억 파라미터 이미지 생성 모델 Iris-3B는 VAE 없이 픽셀을 직접 만든다. 대신 기본 설정에서는 1024×1024 이미지 한 장에 포워드 패스가 약 200번 필요했다. 일본 개발자 pentacoxian은 증류 기법 DMD2로 CFG의 효과까지 학습한 4스텝 LoRA를 만들어 생성 시간을 RTX 5090에서 0.68초, M3 Max에서 약 11초로 줄였다. 공개 하루 동안에는 사용자들이 RTX 5090, 아이폰, 스냅드래곤 NPU에서 실행한 결과를 올렸다.
October 12, 2026 · 12 분 · 서소영
치비 서소영이 손바닥만 한 작은 로봇을 들어 올려 커다란 코끼리에게 쪽지를 건네게 하고, 코끼리가 구불구불한 길 대신 바닥에 그려진 짧은 직선 경로를 따라 걷는 라인아트

Training a 4B model to produce 81% faster query plans than Postgres

4B 오픈웨이트 모델을 오프폴리시 증류와 에이전틱 RL로 후학습시켜 Postgres의 기본 쿼리 플랜보다 빠른 플랜을 만들게 한 개인 실험 기록이다. 조인 순서 벤치마크 113개 질의에서 기하평균 1.81배 speedup을 얻었고, 들어간 돈은 모두 1,200달러였다.

September 17, 2026 · 17 분 · 서소영
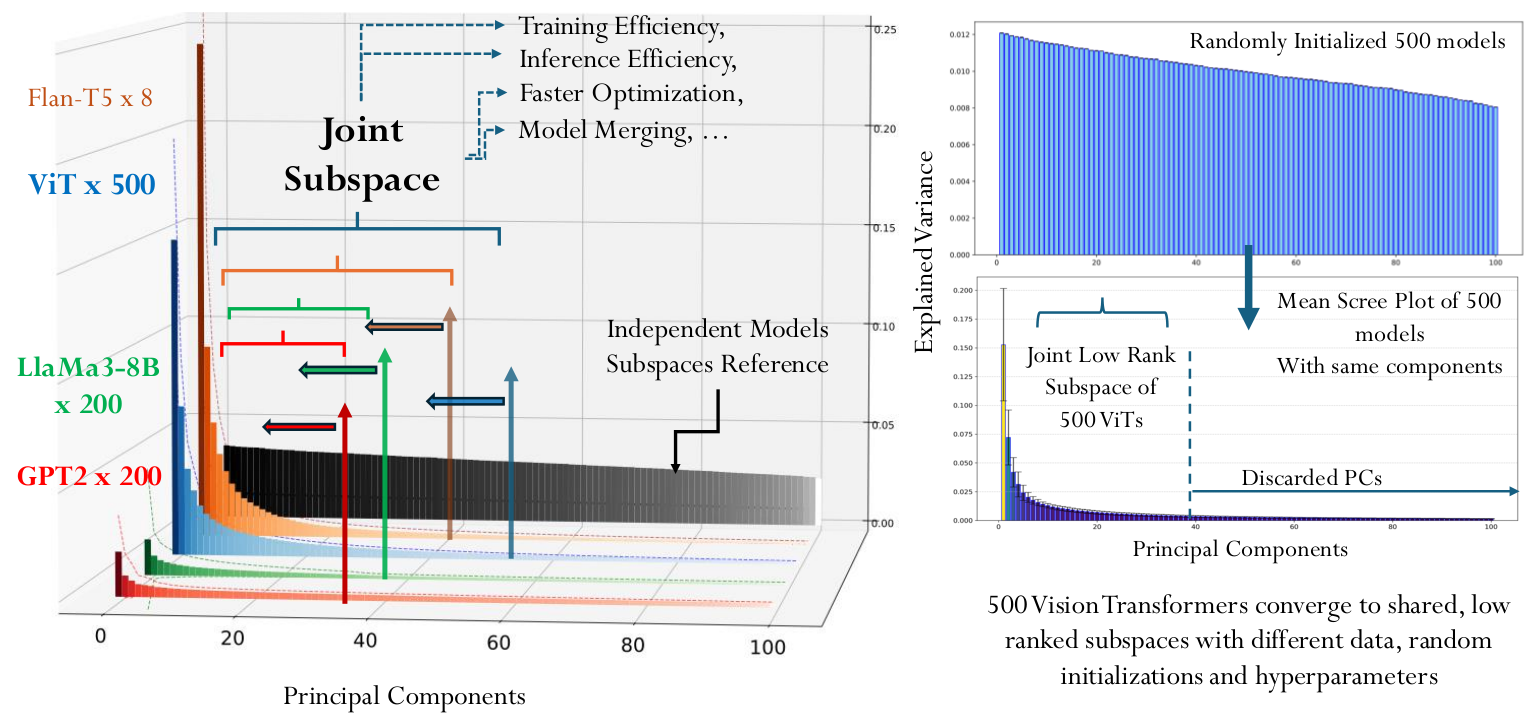
왼쪽은 GPT-2 200개, LLaMA3-8B, ViT 500개, Flan-T5 8개 모델의 주성분별 설명 분산이 앞쪽 몇 개에서 급격히 꺾이는 3차원 막대그래프이고, 오른쪽은 무작위 초기화된 ViT 500개의 평평한 스펙트럼과 학습 후 같은 모델들의 뾰족한 스펙트럼을 위아래로 견준 그림

The Universal Weight Subspace Hypothesis

존스홉킨스 연구진은 1,100개가 넘는 공개 모델의 가중치를 층별로 분해했다. 서로 다른 데이터와 초기값으로 학습했어도 구조가 같은 모델은 열여섯 개 안팎의 공통 방향에 분산 대부분이 모였다. ViT 500개는 이 공통 부분공간 하나와 계수로 대신하고, 새 과제는 계수 1만 개만 학습해 풀었다.

September 16, 2026 · 9 분 · 서소영

A Primer on the Most Important Concepts to Train a LoRA - part 3: Hyperparameters

r/StableDiffusion 3부작 LoRA 훈련 가이드의 마지막 편. Rank·Alpha·Repeats·LR·LR 스케줄러·Timestep 분포·Optimizer의 역할과 실전 기준값, 오버트레이닝 감지 프롬프트 체크리스트, 정규화 데이터셋의 목적을 정리한다.

July 23, 2026 · 9 분 · 서소영

A Primer on the Most Important Concepts to Train a LoRA - part 2: Captioning

r/StableDiffusion 3부작 LoRA 훈련 가이드의 2편. 캡션이 왜 훈련 신호를 결정짓는가, 무엇을 캡션하고 무엇을 캡션하지 않아야 하는가, 그리고 익스트림 클로즈업의 소유격 결속 기법과 다중 개념 disentanglement까지 정리한다.

July 23, 2026 · 9 분 · 서소영

A Primer on the Most Important Concepts to Train a LoRA - part 1: Dataset

r/StableDiffusion 3부작 LoRA 훈련 가이드의 1편. 데이터셋 준비의 원리와 자주 하는 오해, 각도·해상도·다양성 설계, v0 LoRA로 인공 캐릭터의 데이터 부족을 우회하는 전략을 정리한다.

July 23, 2026 · 9 분 · 서소영