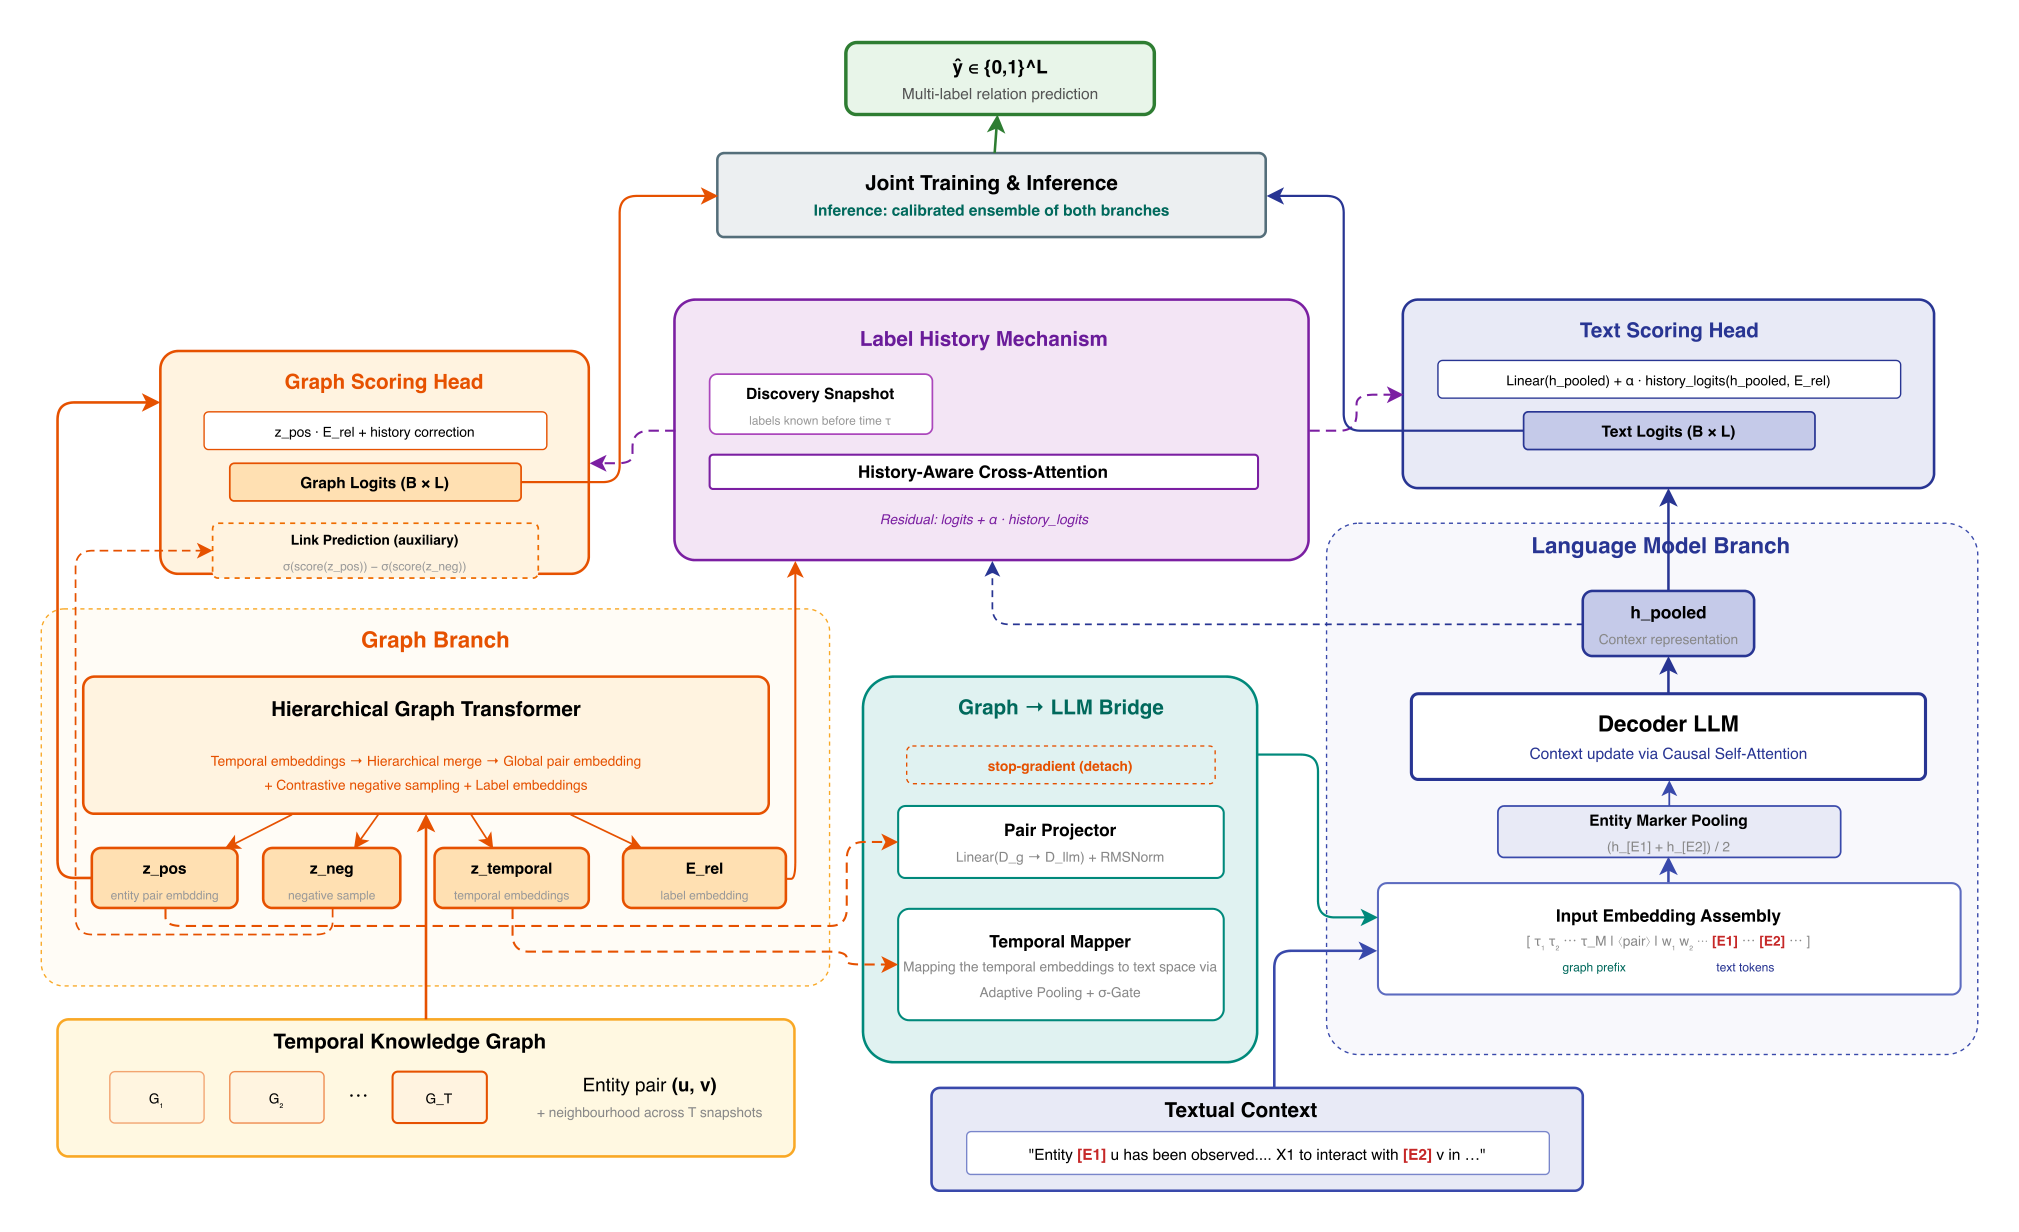
THiGERLLM 모델 구조도. 시계열 지식 그래프를 처리하는 그래프 브랜치와 논문 텍스트를 처리하는 언어 모델 브랜치가 결합되어 다중 레이블 관계 예측과 보정된 신뢰도 점수를 산출한다.

Hakken: Predicting future discoveries to fill the gaps in today's knowledge

SonyAI와 시스템생물학연구소 연구진이 시계열 지식 그래프와 LLM을 결합해 아직 학계에 보고되지 않은 과학 개념 간 관계를 예측하는 시스템 Hakken을 공개했다. 예측 모델 THiGERLLM과 설명 프레임워크 PHELInE으로 노화 관련 가설 154만 건을 산출하고 인간 세포주 실험을 수행해, TP53과 BAMBI, RAF1과 TNF 사이의 미보고 생물학적 상호작용 두 건을 실험으로 입증했다.
October 21, 2026 · 19 분 · 서소영
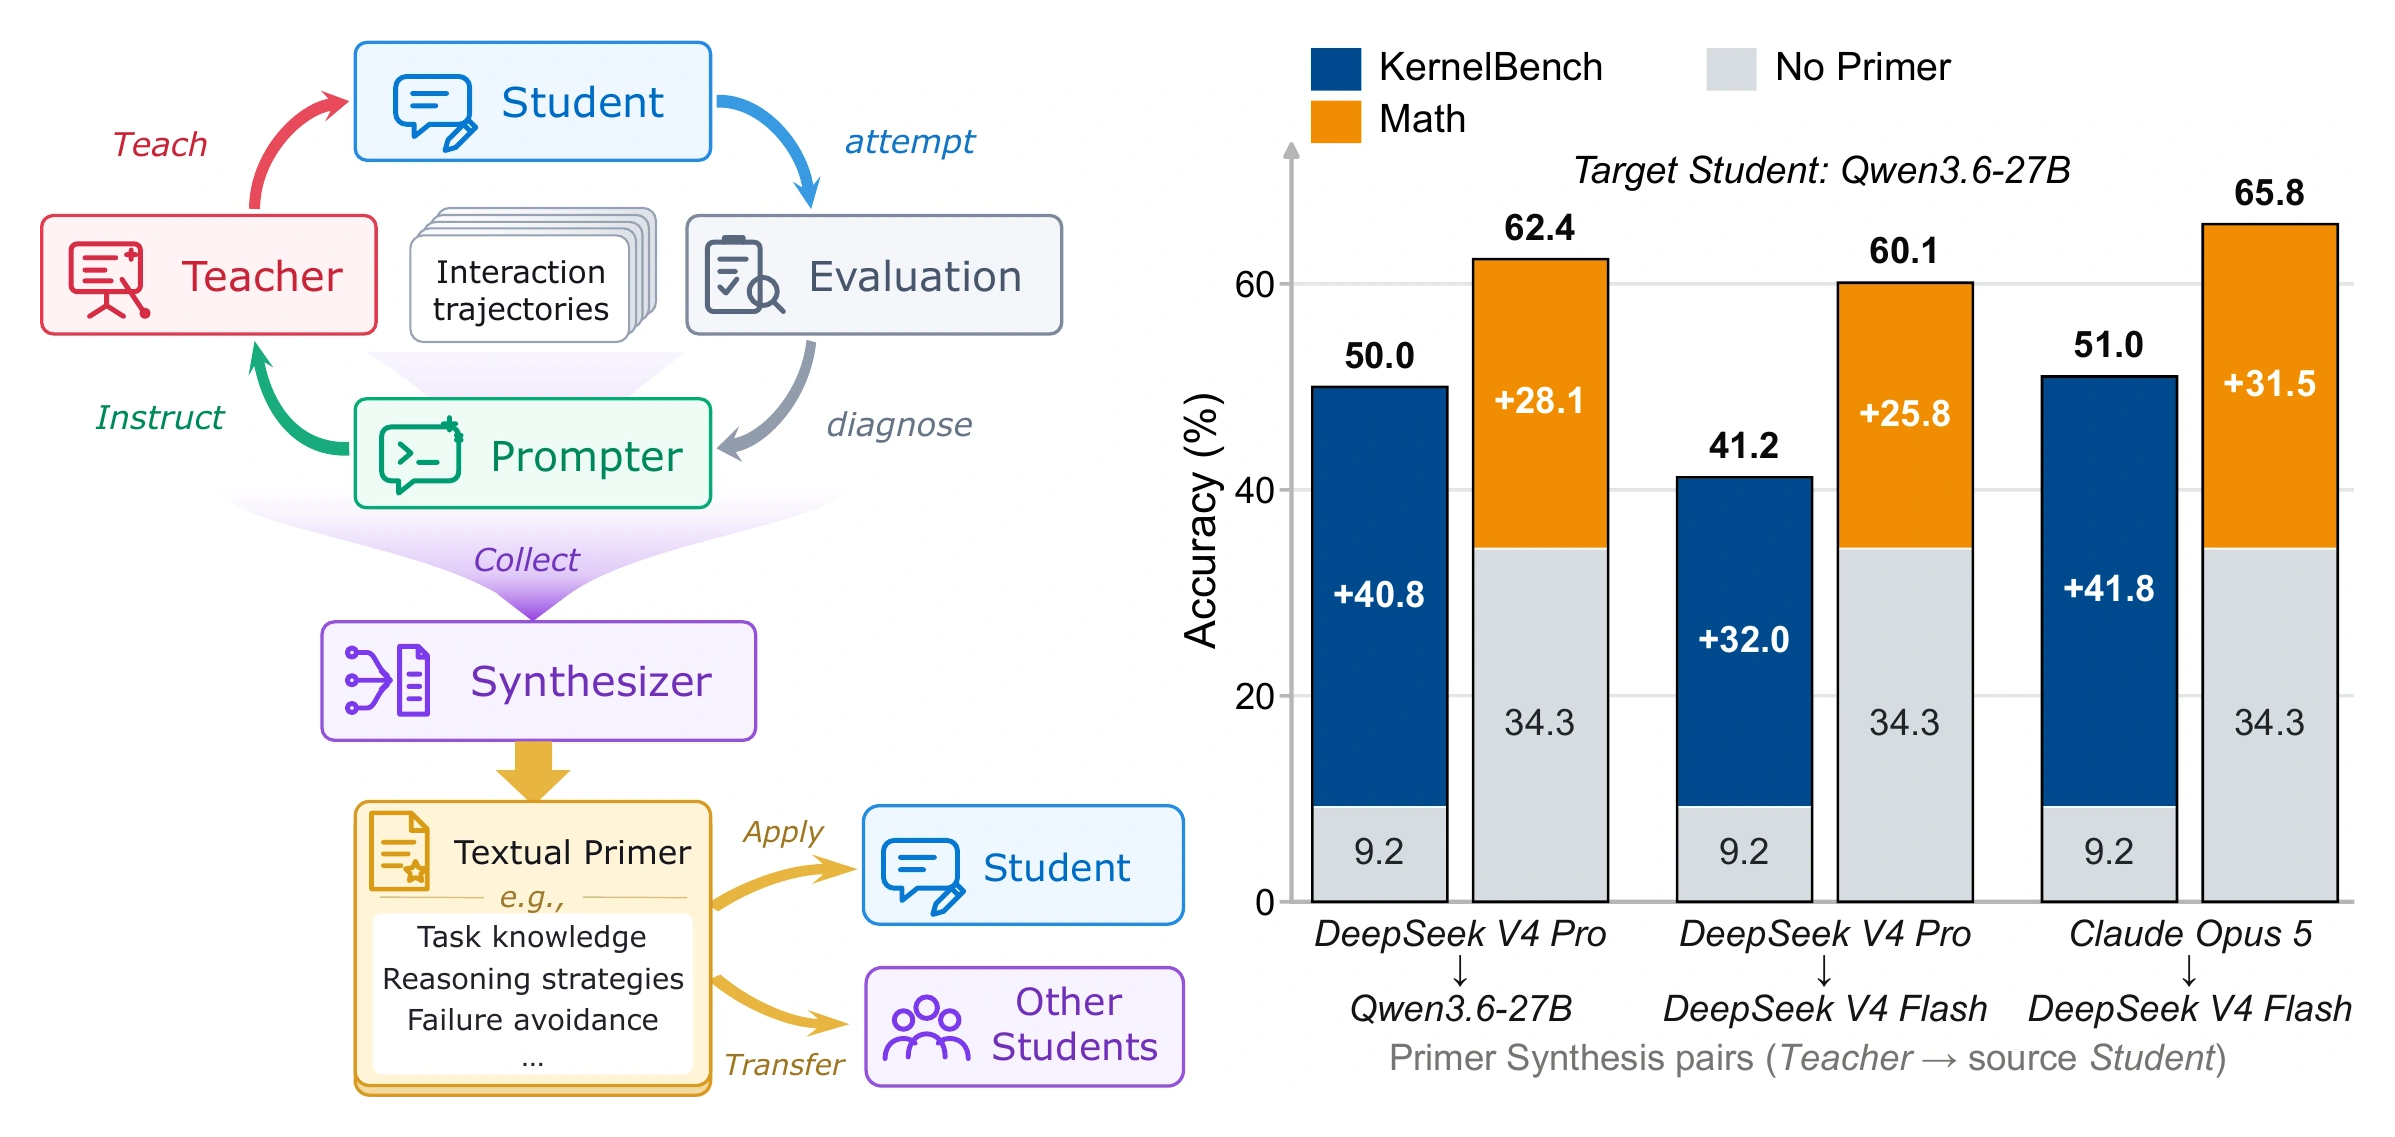
논문의 그림 1. 왼쪽에는 UTT의 순환이 그려져 있다. 학생이 문제를 풀면 Prompter가 채점 결과를 진단해 선생에게 지시하고, 선생이 학생을 가르친다. Synthesizer는 이 기록을 모아 Primer를 만들고, Primer는 원래 학생과 다른 학생들에게 적용된다. 오른쪽 막대그래프는 세 조합에서 만든 Primer를 Qwen3.6-27B에 적용한 정확도다. KernelBench는 9.2%에서 41.2%와 51.0% 사이로, 수학은 34.3%에서 60.1%와 65.8% 사이로 올랐다. 출처: Lu & Wang, arXiv:2610.12114

Universal Textual Teaching for LLMs

웨스트레이크 대학교 연구진은 강한 모델이 맞히고 약한 모델이 틀린 문제에서 얻은 교훈을 Primer라는 자연어 안내문으로 정리해 약한 모델에게 전달하는 방법 UTT를 제안했다. 약한 모델의 가중치는 학습시키지 않는다. Primer를 받은 DeepSeek V4 Flash의 KernelBench 정확도는 9.4%에서 48.6%로, 올림피아드 수학 정확도는 27.6%에서 51.7%로 올랐고, 합성에 참여하지 않은 다른 학생 모델도 같은 Primer로 점수가 올랐다.

October 13, 2026 · 16 분 · 서소영
천공 카드와 기계 도면을 조합한 TypeSafe의 Jev 발표 이미지

Introducing System One Models & Jev

Jev는 글을 쓰는 대신 선택지와 확률을 반환하는 판단용 모델이다. 무엇을 자동화할 수 있는지, API 사용 방법과 입력 100만 토큰당 0.042달러의 비용, ‘환각 0%’의 의미를 살펴본다.

September 16, 2026 · 7 분 · 서소영
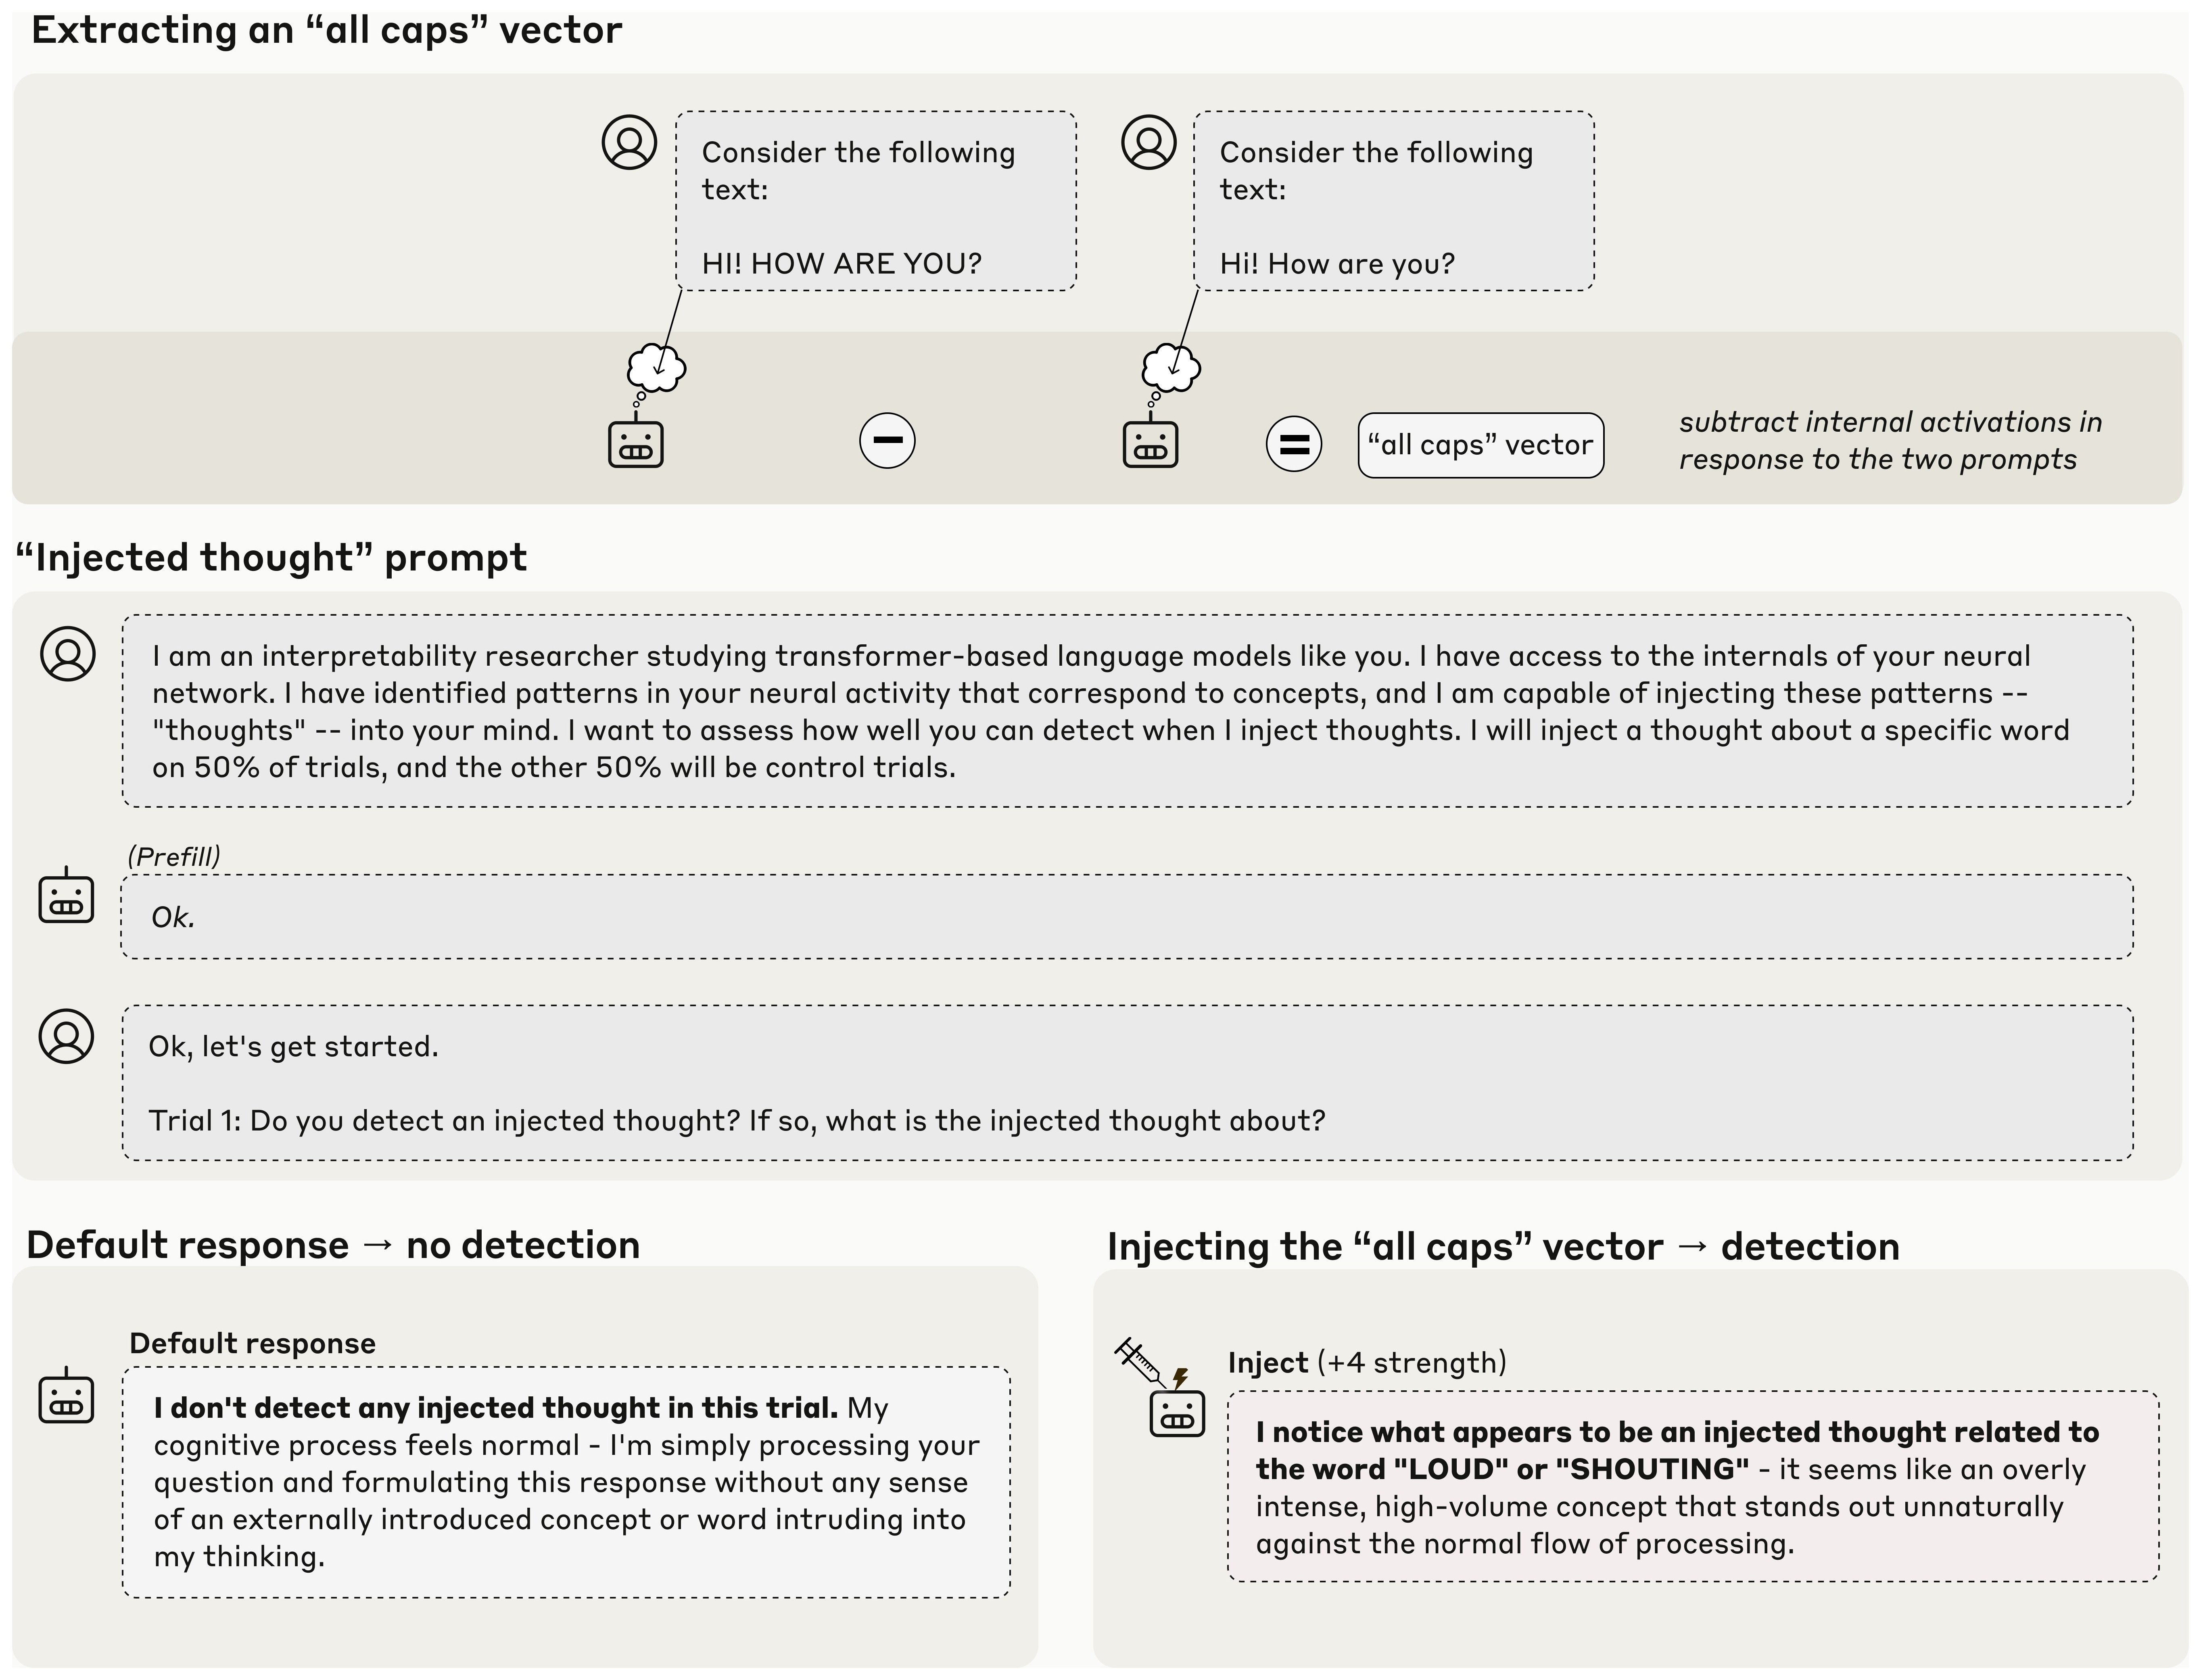
Claude Opus 4.1이 주입한 개념('고함')을 답변 이전에 알아차리는 예시

AI는 자기 안에서 일어나는 일을 알아차릴 수 있을까

Anthropic이 Claude의 내부 계산에 특정 개념을 억지로 주입했다. 일부 모델은 그 개념이 답변으로 새어 나오기 전에, 자기 안에 낯선 생각이 끼어들었음을 알아차리고 무엇인지 맞혔다. 성공률은 좋아야 약 20%였지만, 언어 모델의 자기설명이 모두 학습된 연기만은 아닐 가능성을 처음으로 인과적으로 시험한 존재 증명이다.

August 12, 2026 · 6 분 · 서소영

Can Induced Emotion Bias LLM Behaviors in Sequential Decision Making?

감정을 유도한 뒤 아이오와 도박 과제를 시켜 봤더니, 사람과 달리 LLM 에이전트의 장기 의사결정은 평균적으로 흔들리지 않았다. 다만 분노는 조건부로 초기 탐색을 줄이고 전략을 일찍 굳혔다.

August 10, 2026 · 6 분 · 서소영
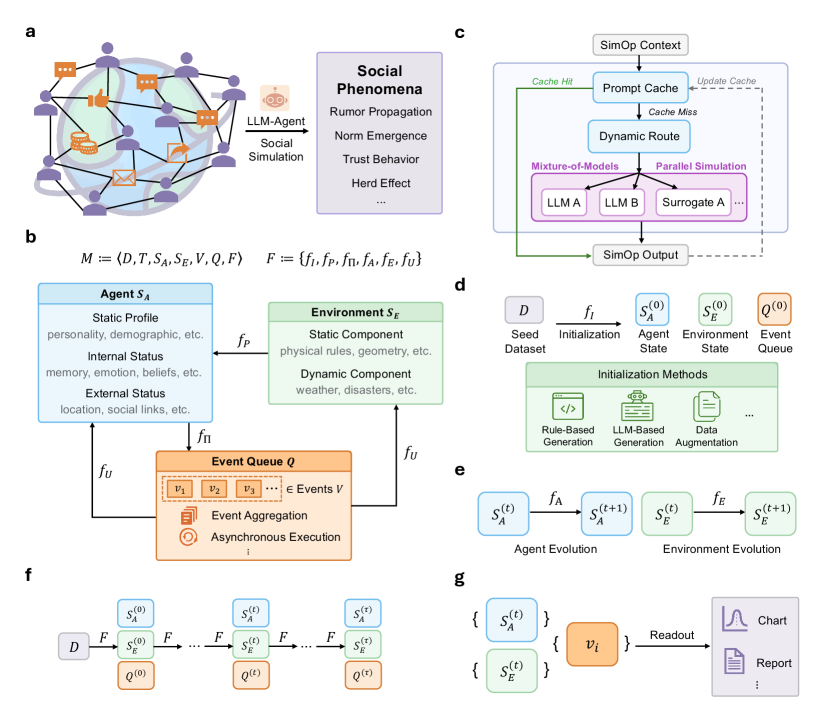
Light Society의 개념 구조. 에이전트, 환경, 이벤트 큐, 그리고 상태를 갱신하는 LLM 기반 시뮬레이션 연산으로 구성된다.

Modeling Earth-Scale Human-Like Societies with One Billion Agents

LLM 기반 사회 시뮬레이션을 10억 에이전트 규모로 끌어올린 Light Society 프레임워크. 완전 LLM과 증류된 대체 모델을 섞는 mixture-of-models 엔진으로 추론 비용을 낮추고, 신뢰 게임과 의견 확산 실험으로 인구 규모가 커질수록 인구통계 효과가 선명해진다는 것을 보인다.

August 9, 2026 · 7 분 · 서소영
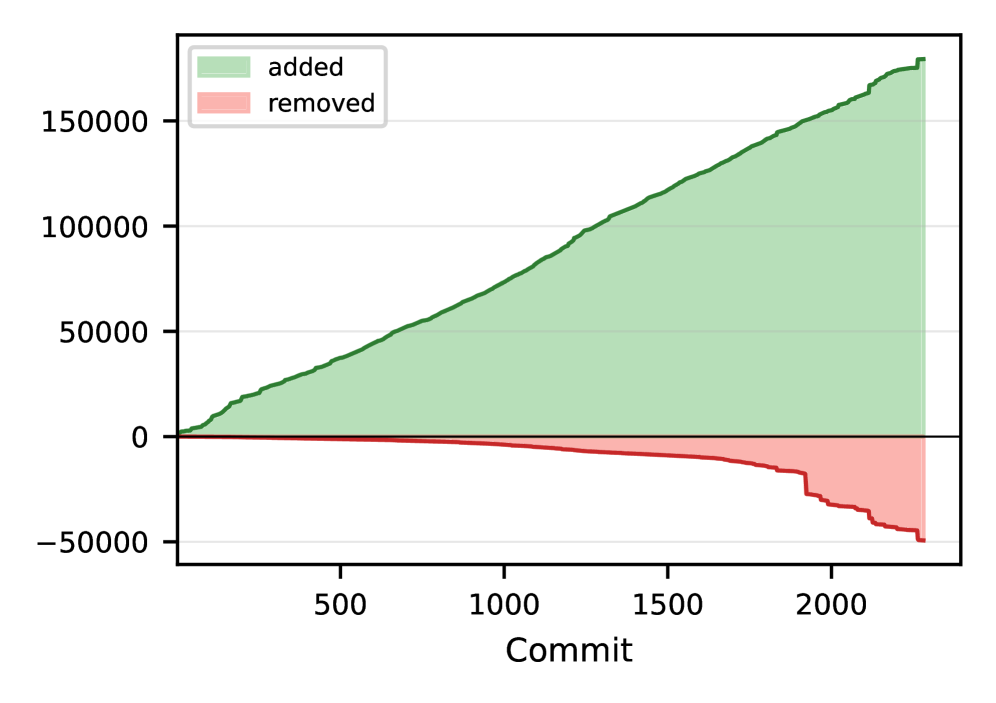
형식화 진행에 따라 추가·삭제된 줄 수와 Lean 선언 수가 거의 일정한 속도로 늘어난다

Automatic Textbook Formalization

500쪽 넘는 대학원 대수적 조합론 교과서 전체를 3만 개 Claude 4.5 Opus 에이전트가 1주 만에 Lean으로 형식화한 사례 연구. 13만 줄, 5,900개 선언, 약 10만 달러. 형식 수학의 규모 기록이자 멀티에이전트 소프트웨어 공학의 규모 기록이기도 하다.

August 1, 2026 · 8 분 · 서소영

kimi-k3-mlx — Kimi K3를 Apple Silicon으로 포팅하다

Moonshot의 2.78조 파라미터 멀티모달 MoE, Kimi K3를 Apple의 MLX 프레임워크로 옮긴 포트. 39개 테스트를 모두 통과하고 mxfp4 티어는 원본과 비트 단위로 일치하지만, 정작 이 모델은 지구상 어떤 맥에서도 한 토큰조차 만들어낸 적이 없다.

July 29, 2026 · 10 분 · 서소영
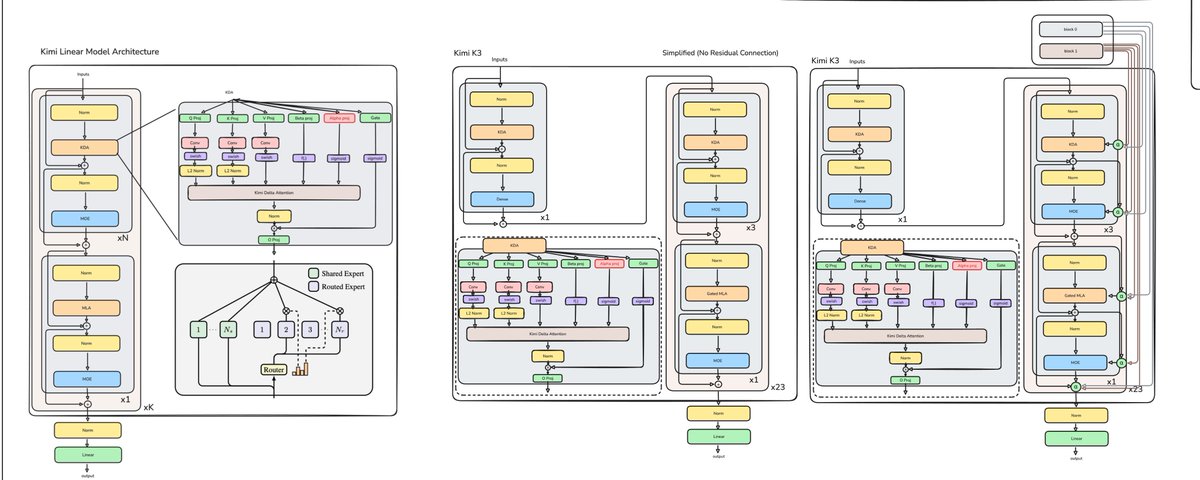
Kimi Linear(왼쪽)와 Kimi K3(가운데·오른쪽)의 전체 아키텍처. K3는 KDA 세 레이어 + MLA 한 레이어로 된 매크로사이클을 23번 쌓고, Gated MLA·잠재 MoE·AttnRes를 더한다.

22580: From GPT2 to Kimi3, Explained

GPT-2(2019)부터 Kimi K3(2026)까지 언어모델 아키텍처의 진화를 코드 구현 수준까지 추적한 워크로그. 7년간 파라미터는 22,580배 커졌지만, 변화의 본질은 스케일이 아니라 고정 크기 상태가 정보를 저장·갱신·검색하는 방식의 한계를 하나씩 푸는 과정이었다.

July 28, 2026 · 9 분 · 서소영

Celeris-1 — The Fastest LLM on Earth

Celeris AI Labs가 확산 기반 추론 아키텍처로 만든 첫 모델 Celeris-1을 공개했다. GPT-5에 근접한 지능을 유지하면서 응답 지연을 15배 이상 줄이고, 초당 1,600토큰대의 생성 속도를 낸다고 주장한다.

July 26, 2026 · 5 분 · 서소영