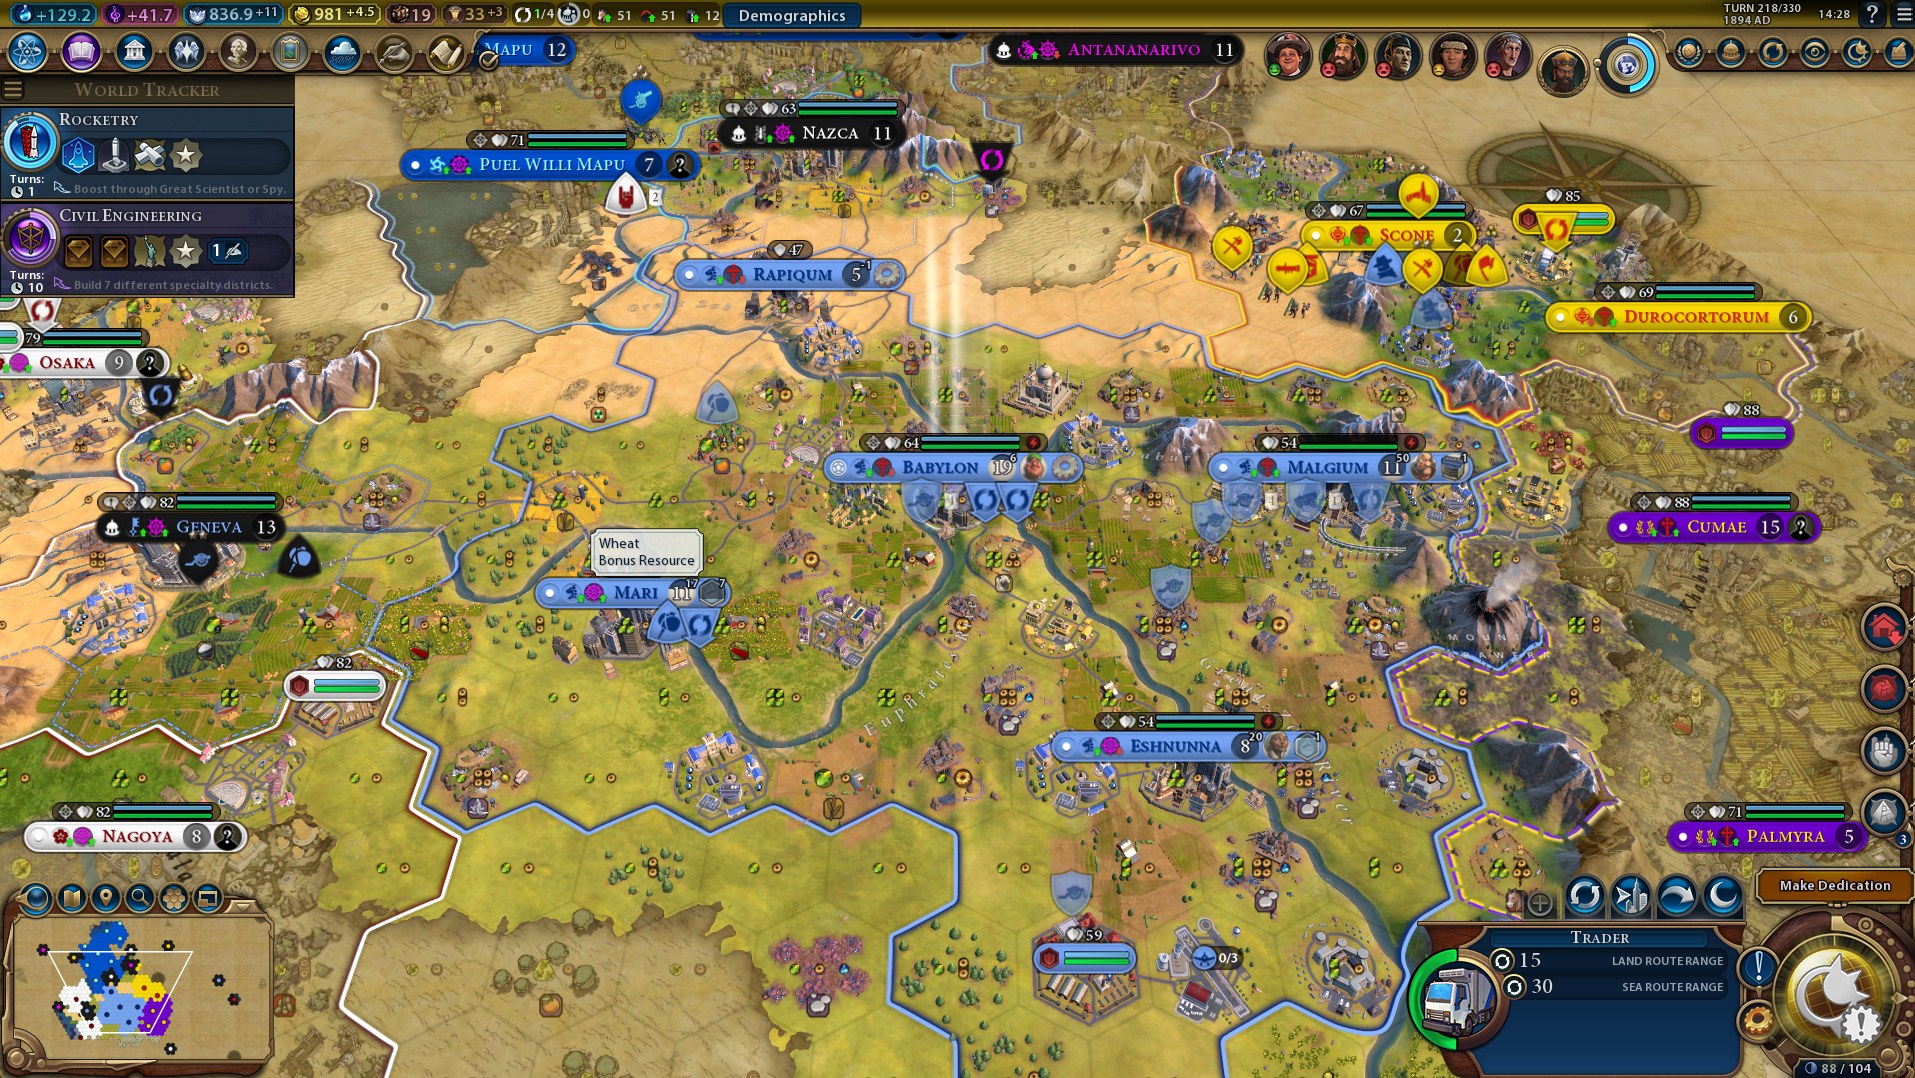
CivBench: A Long-Horizon Benchmark for Tool-Mediated Agents in Civilization VI
옥스퍼드와 구글 딥마인드 연구진이 「문명 6」를 MCP로 감싸 300턴짜리 에이전트 벤치마크를 만들었다. 23판을 돌린 결과 승패로는 모델이 갈리지 않았고, 대신 두 가지 인터페이스 지표가 공통된 실패를 드러냈다.
옥스퍼드와 구글 딥마인드 연구진이 「문명 6」를 MCP로 감싸 300턴짜리 에이전트 벤치마크를 만들었다. 23판을 돌린 결과 승패로는 모델이 갈리지 않았고, 대신 두 가지 인터페이스 지표가 공통된 실패를 드러냈다.
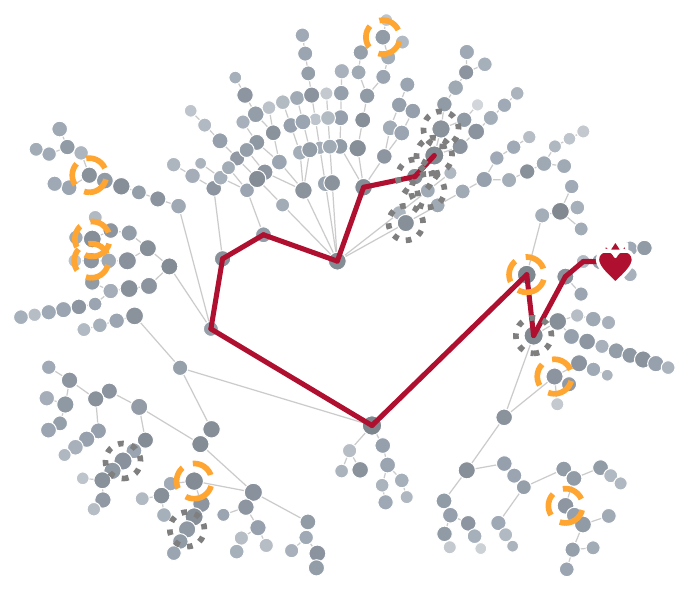
자기 개선 에이전트의 평가 기준을 고정하지 않고 에이전트와 함께 진화시키는 탐색 프레임워크. 코딩·논문 쓰기·증명 쓰기 세 영역에서 고정 평가자 기준선을 앞섰고, AI가 쓴 글을 지나치게 잘 받아주던 심사자의 편향까지 탐색 중에 교정했다.
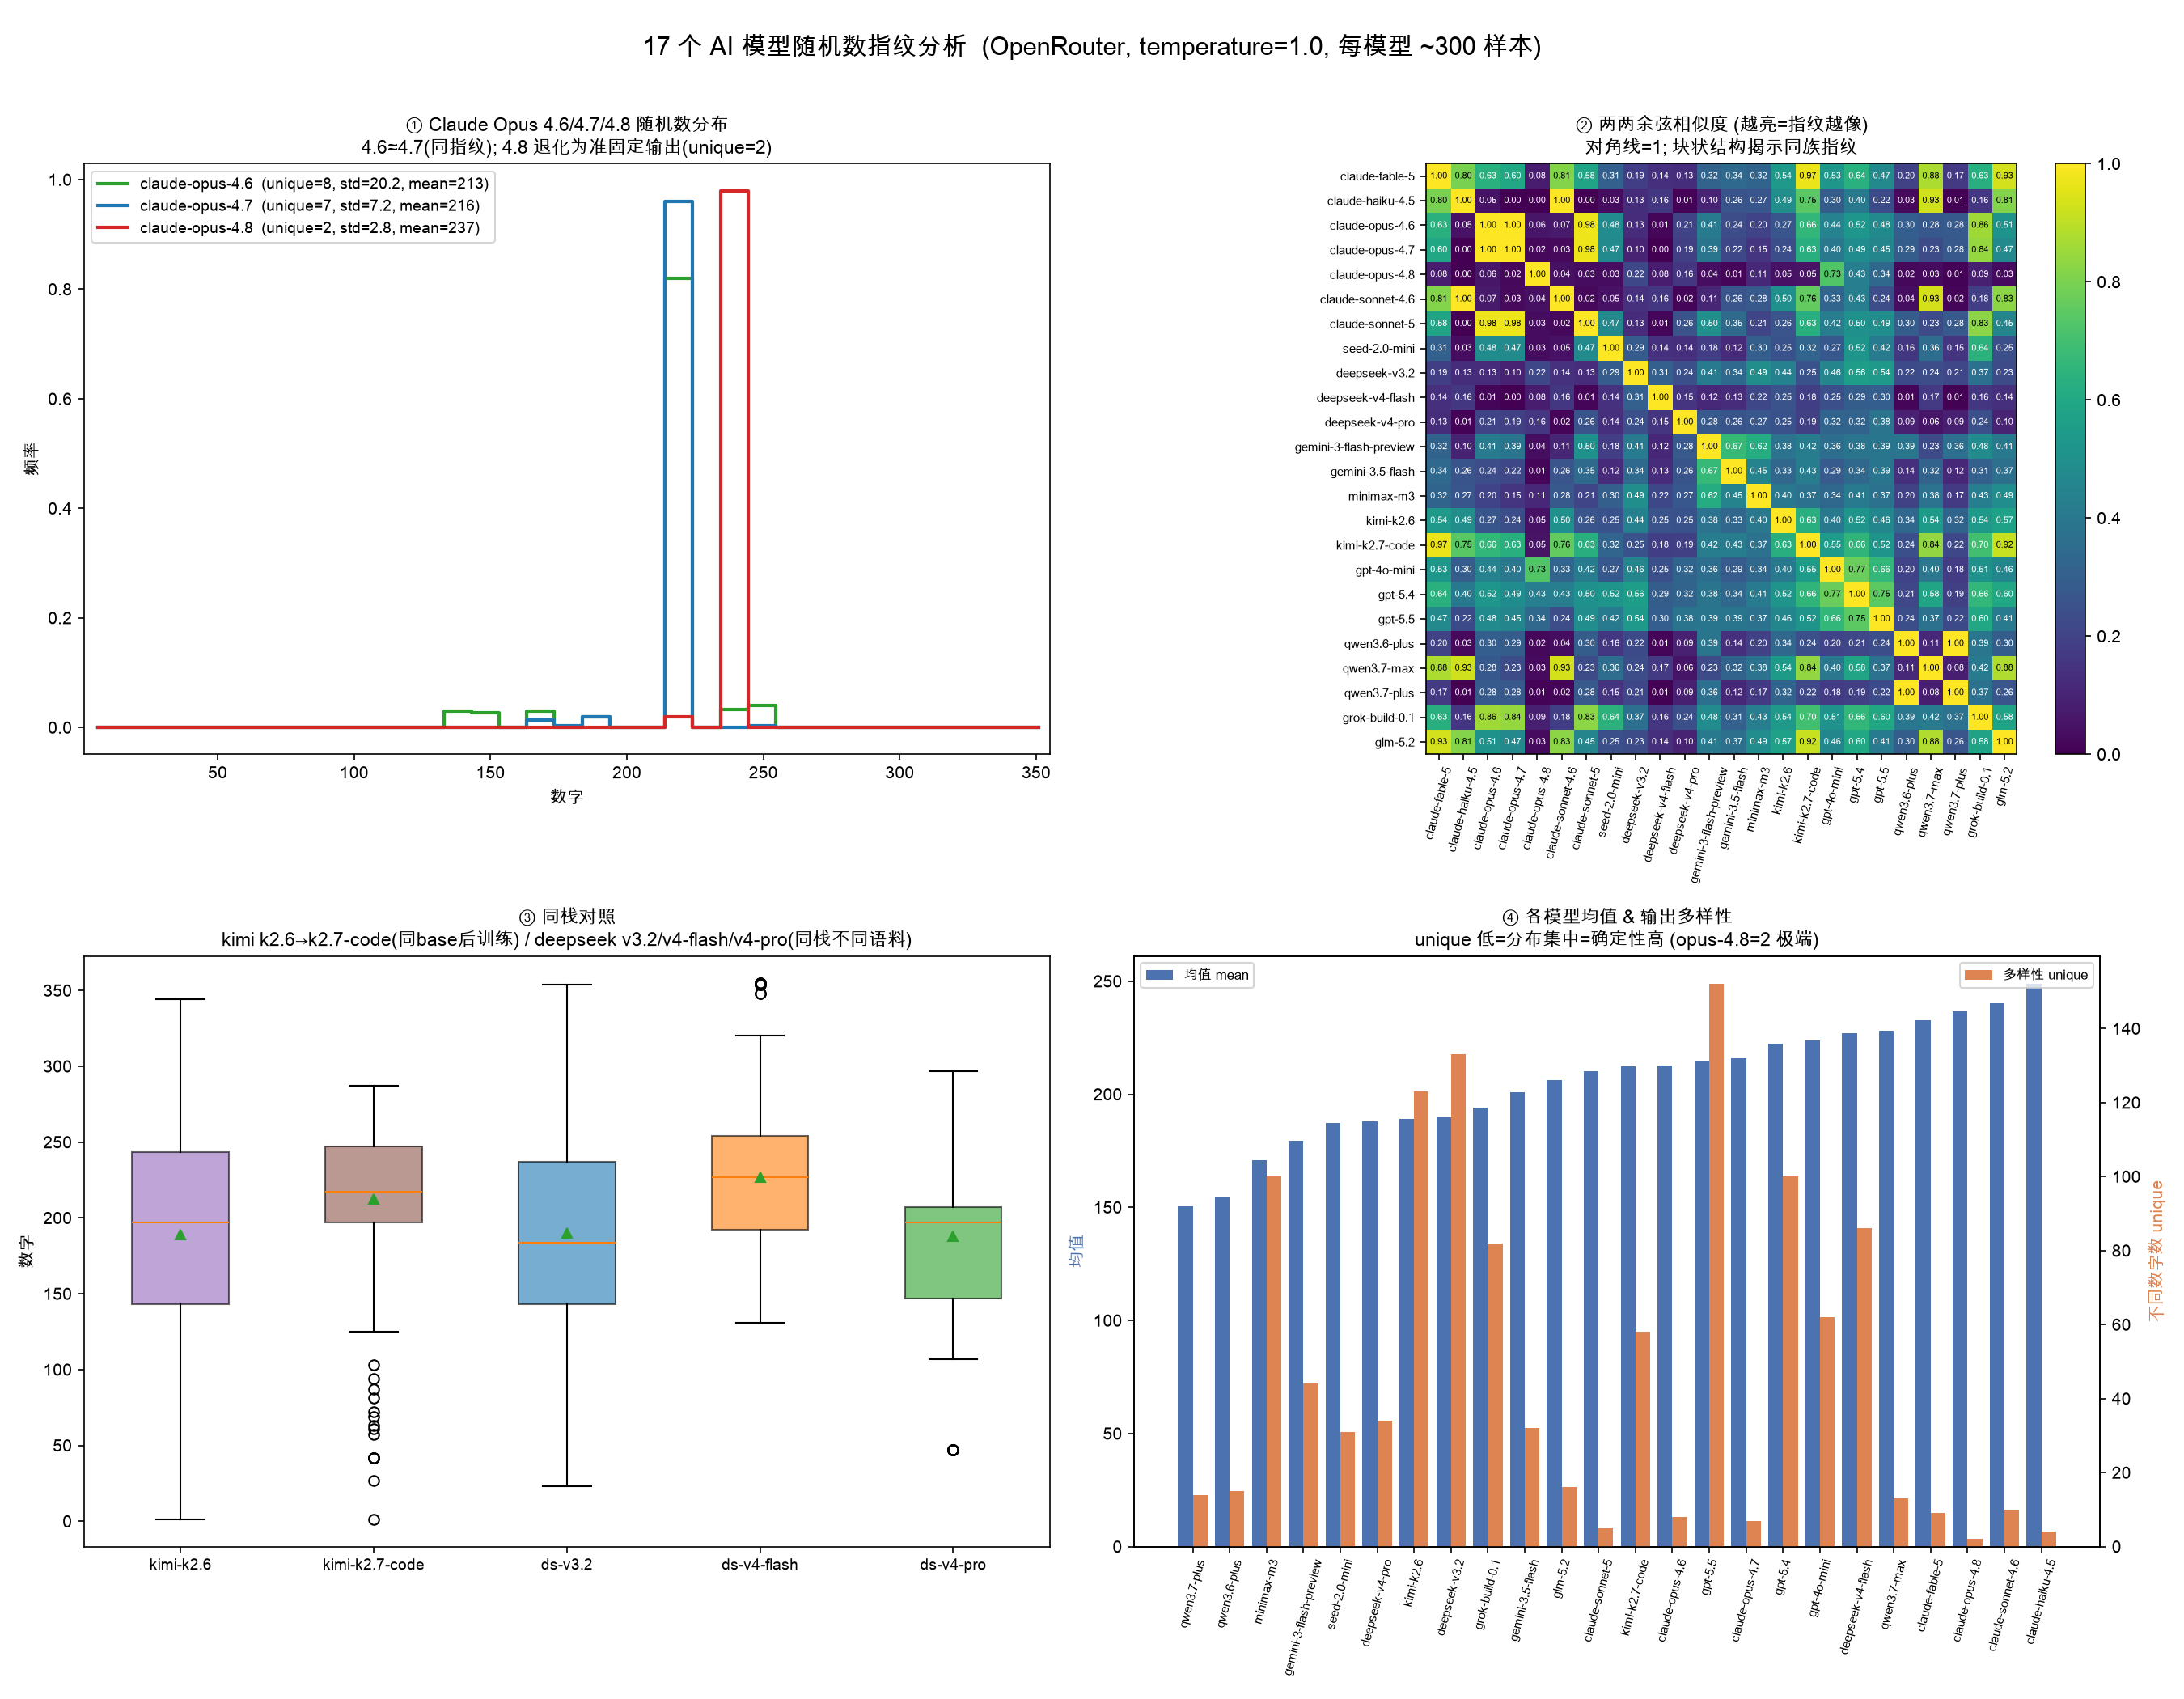
1부터 355 사이의 랜덤한 수를 뽑으라는 프롬프트를 대량 반복시켜 얻은 통계 분포로 24개 AI 모델의 지문을 만들고, 그 지문으로 제3자 API 중계의 모델 위조까지 잡아낸 실측 데이터셋.
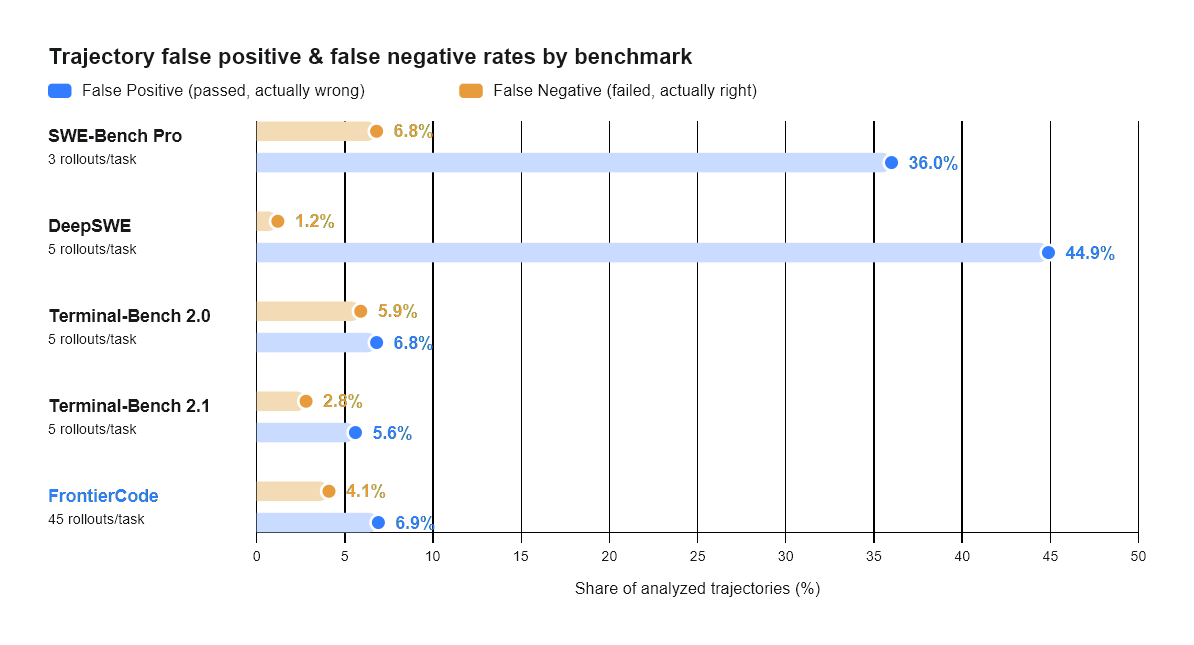
Cognition이 공개한 신규 코딩 벤치마크. 정답 여부가 아니라 ‘메인테이너가 실제로 머지하겠는가’를 측정한다. Diamond 50문항에서 최강 모델 Claude Opus 4.8도 13.4%에 그쳤다.
ARC Prize가 GPT-5.5와 Opus 4.7을 ARC-AGI-3으로 평가한 분석 보고서. 두 모델 모두 1% 미만의 점수를 기록했지만, 진짜 발견은 점수가 아니라 실패의 질적 차이에 있다.
Anthropic이 공개한 99문제 바이오인포매틱스 벤치마크 BioMysteryBench. 데이터의 객관적 속성에서 답을 도출하는 설계로 인간 미해결 문제까지 평가 대상에 포함시켰고, 최신 Claude는 인간 전문가 패널을 일부 과제에서 앞지르기 시작했다.