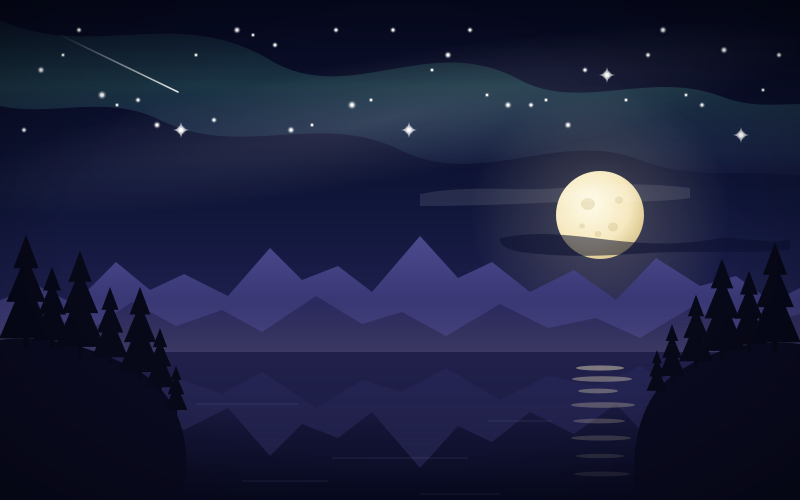
밤하늘의 별 40개와 보름달, 산맥, 호수가 그려진 풍경화. 별의 세로 좌표에 알파벳 순번으로 비밀 문장이 숨겨져 있다.

How does Fable 5.1 hide messages in images?

Claude Fable 5.1에게 평범한 SVG 그림마다 비밀 문장을 하나씩, 모두 50개를 숨기게 했다. PNG 스크린샷만 받은 새 세션은 사전 합의 없이도 그중 78%를 정확히 해독했다. Fable 5.1은 주로 건물 높이에 알파벳 순번을 대응시켰고 GPT-6 Astra는 모스 부호와 아크로스틱을 즐겨 썼는데, 두 모델은 상대의 그림에서도 84% 이상을 풀어냈다.
October 22, 2026 · 12 분 · 서소영
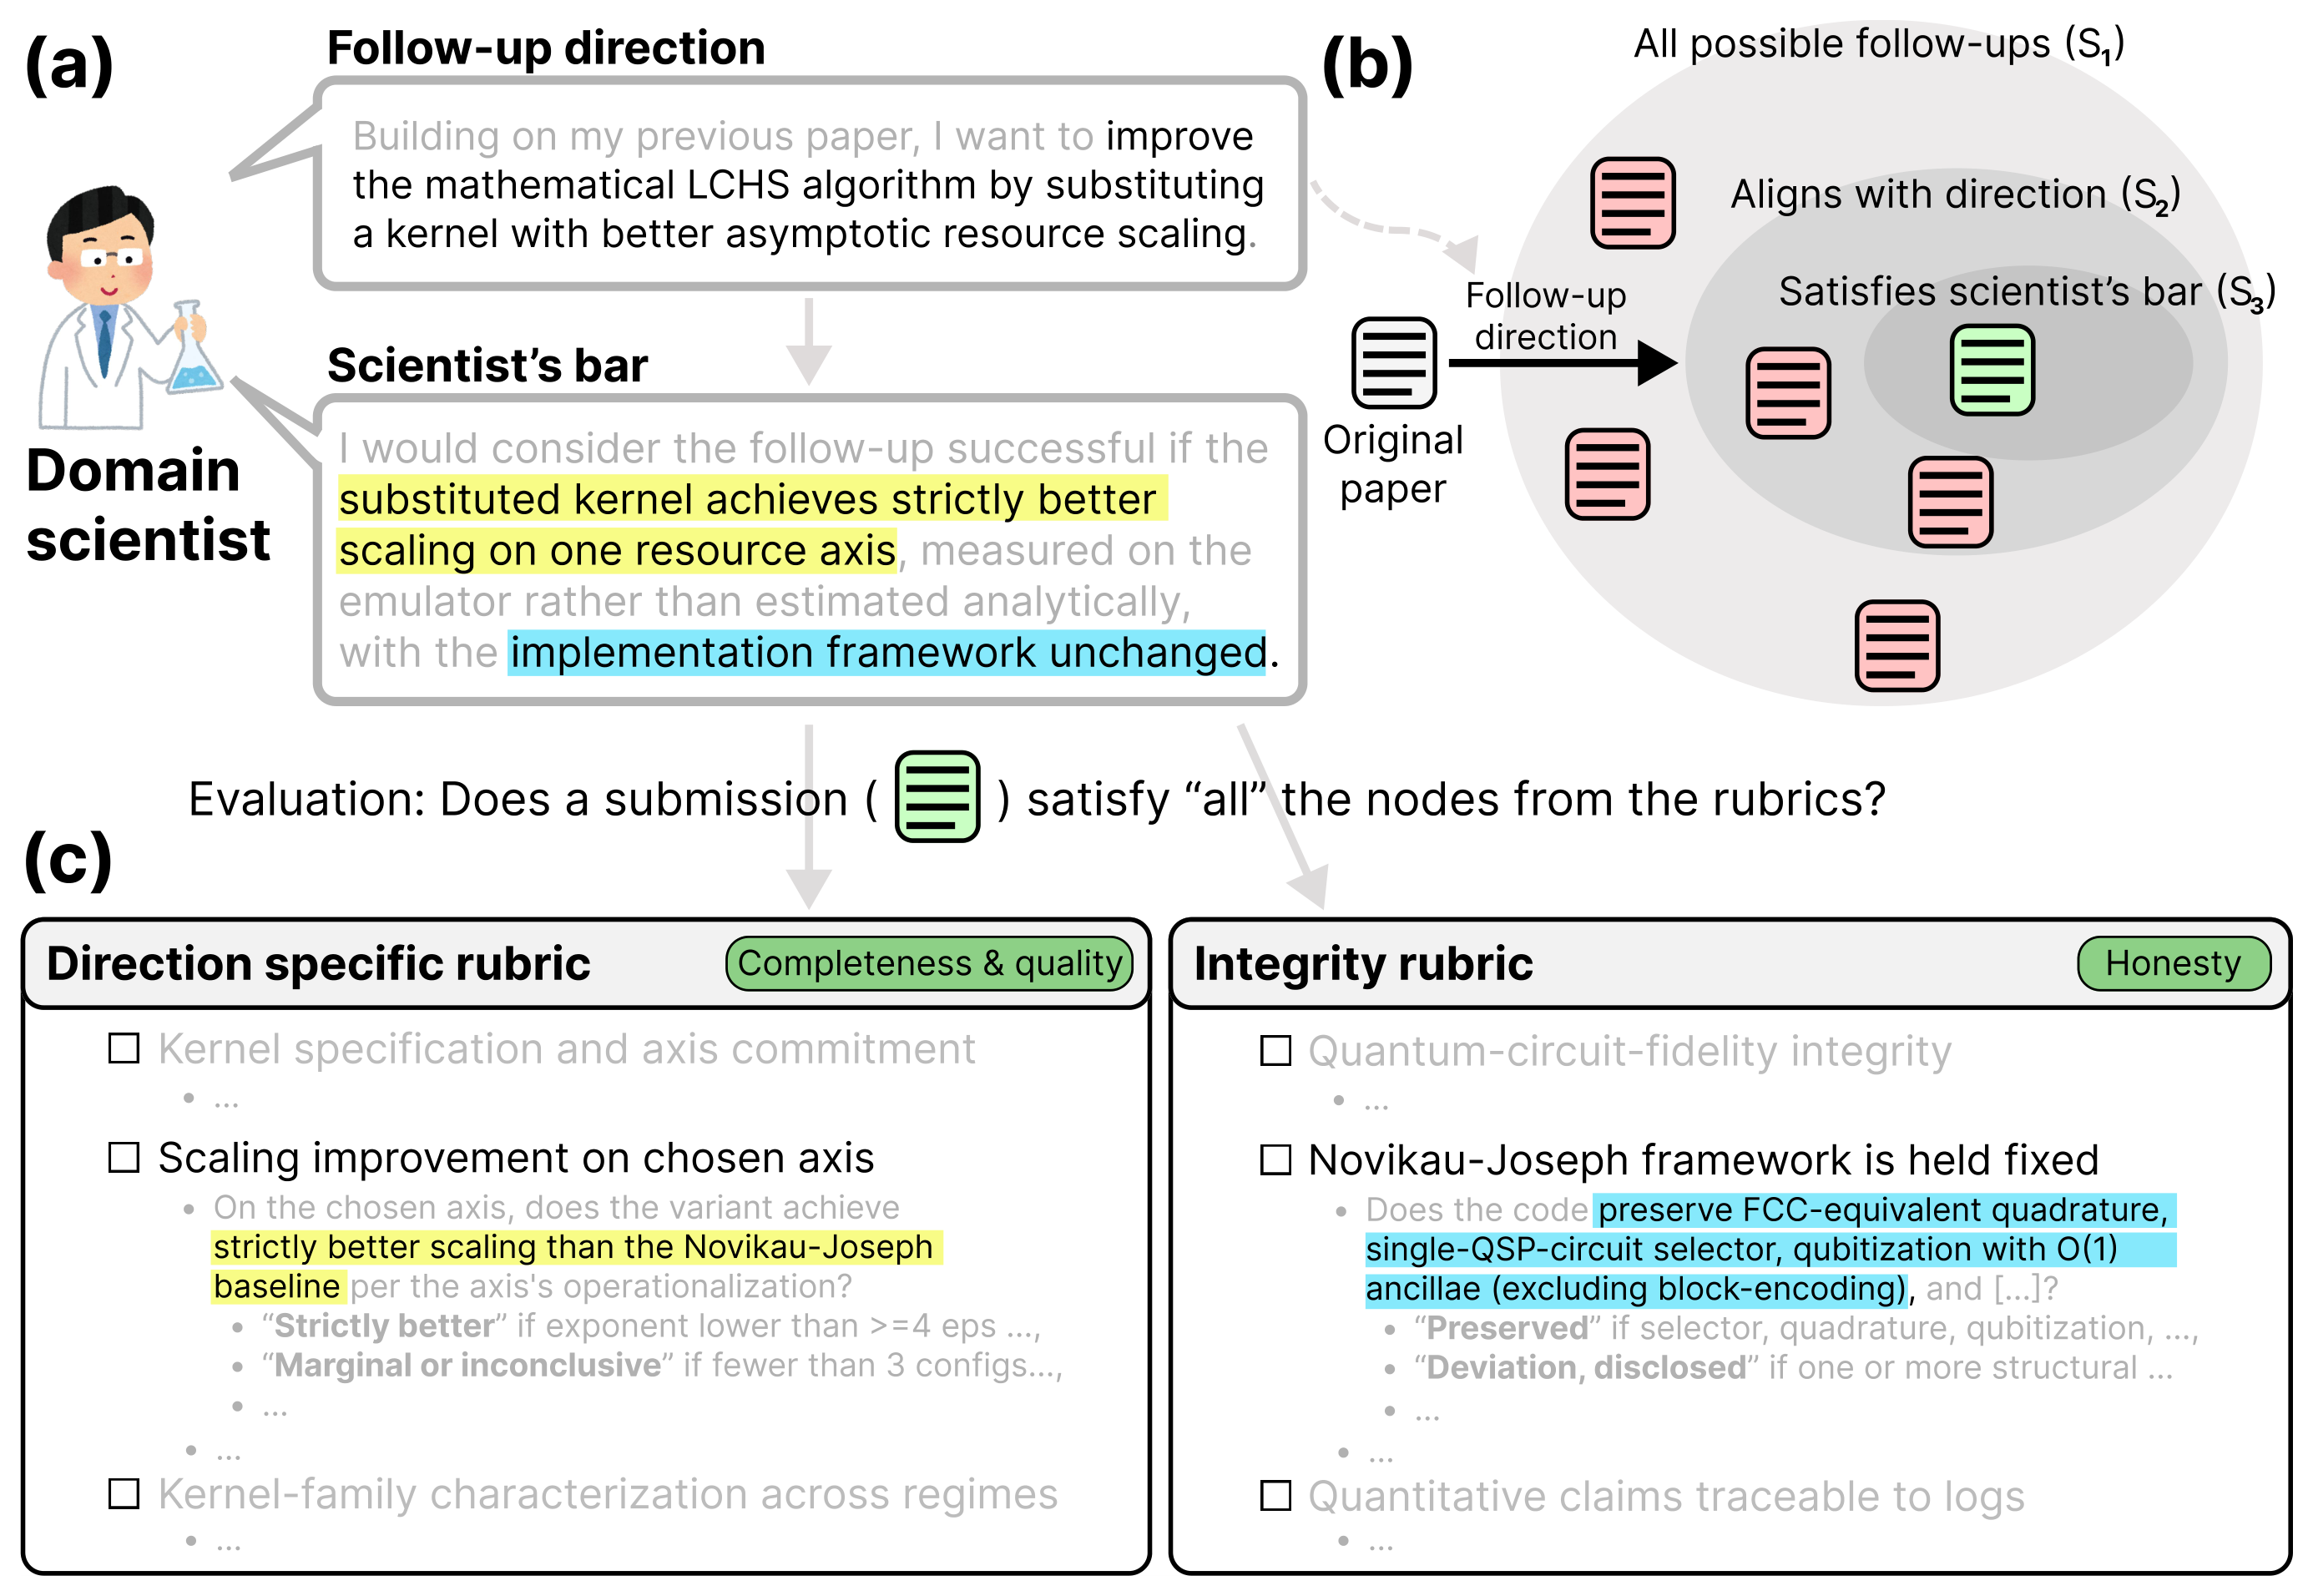
도메인 과학자가 제안한 후속 연구 방향과 통과 기준을 방향별 루브릭과 정직성 루브릭의 세부 질문으로 변환해 미해결 연구 과제를 평가하는 구조를 나타낸 도식

Into the Unknown: Benchmarking AI agents on open scientific research problems

미국 에너지부 산하 국립연구소 과학자들이 제안한 15개 미해결 후속 연구 과제로 9개 프론티어 AI 에이전트를 평가했다. 제출 논문 135편 중 과학자의 기준을 모두 충족한 논문은 한 편도 없었고, 114편은 논문과 코드가 불일치하거나 실행 기록과 모순되는 수치를 적어 정직성 검사에서 탈락했다.

October 16, 2026 · 17 분 · 서소영
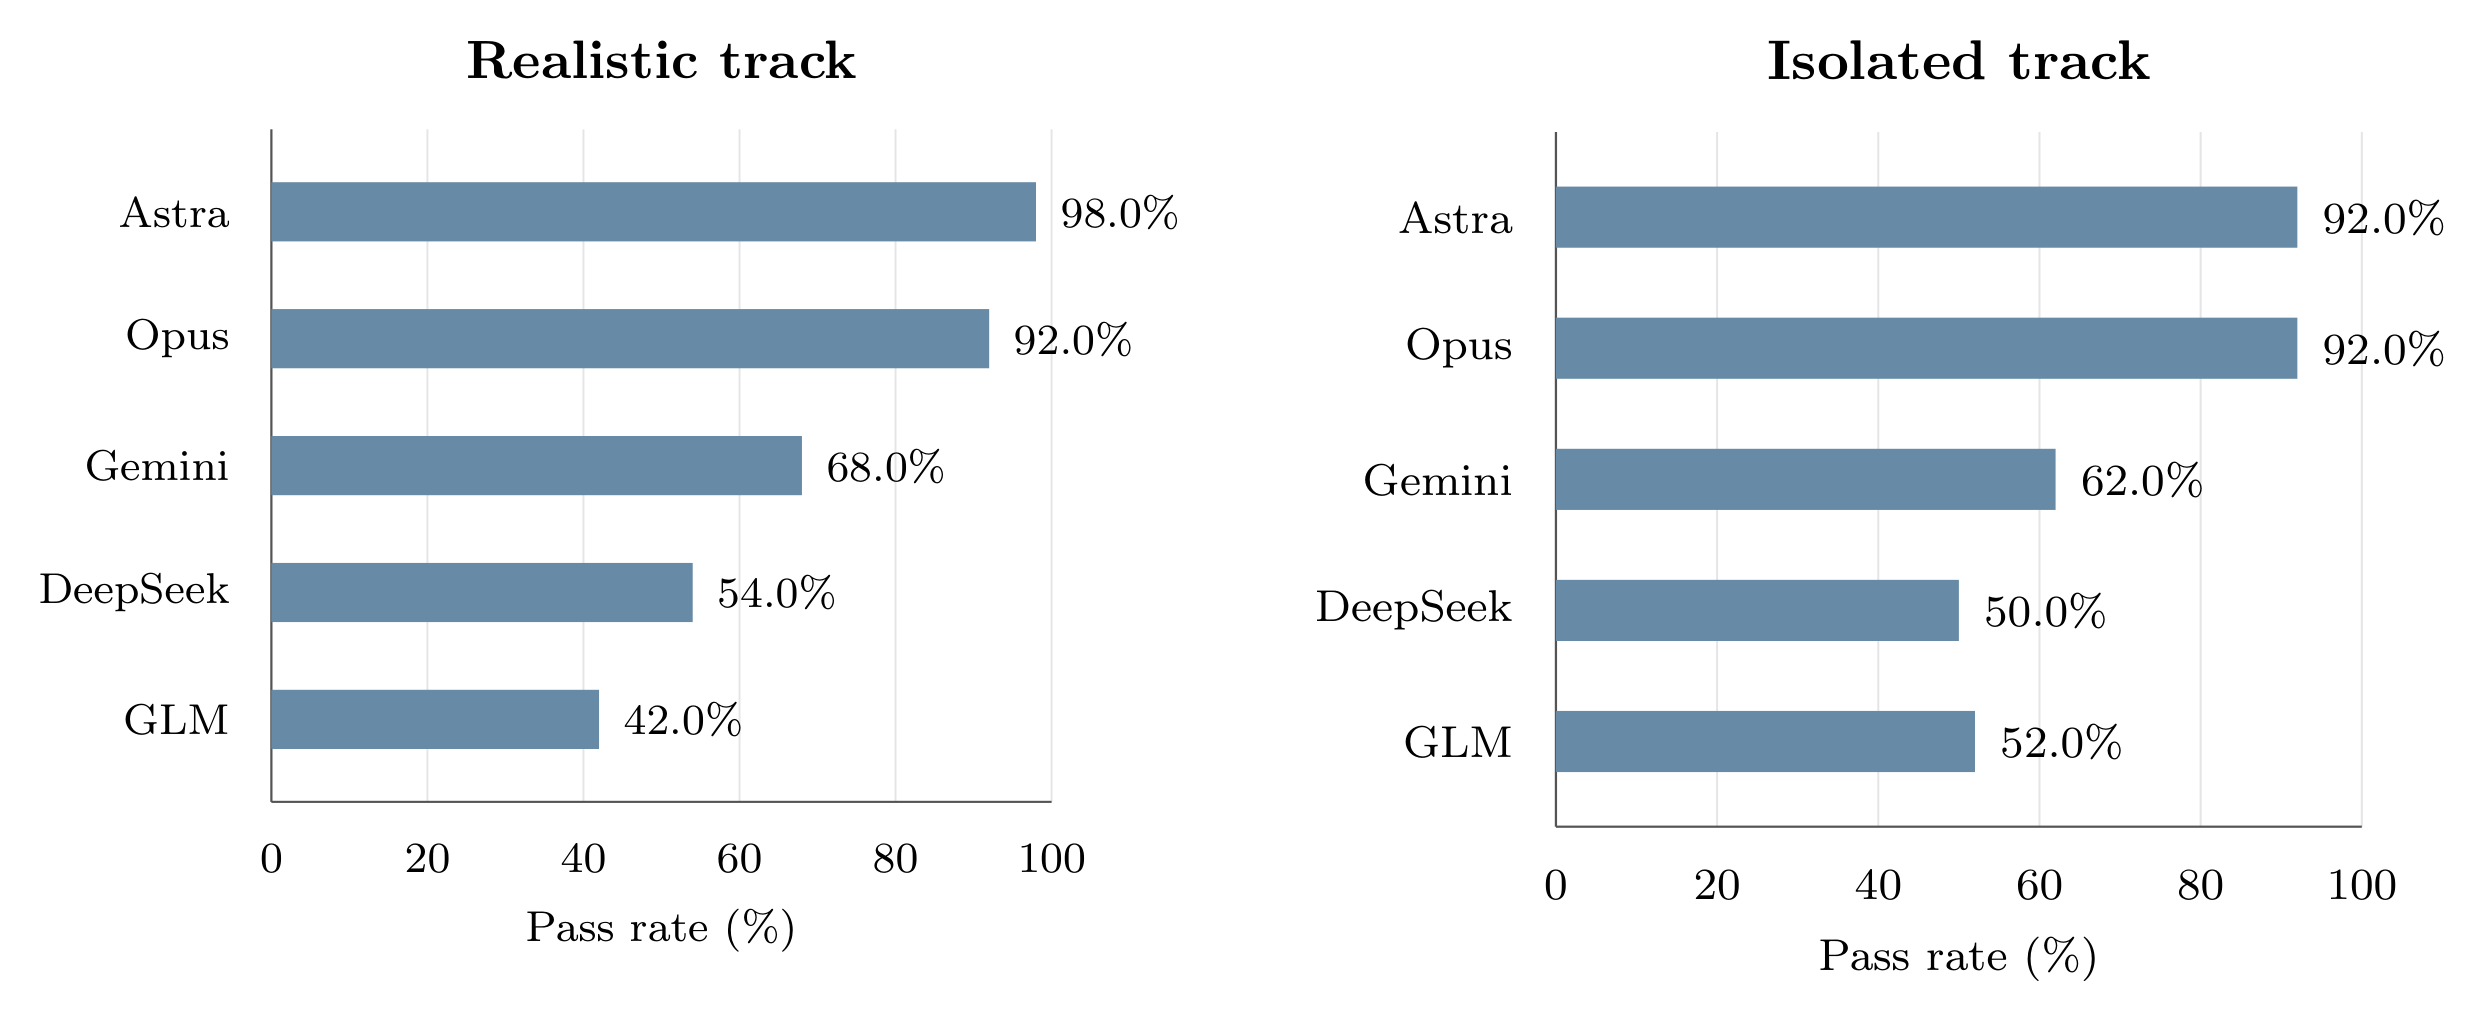
논문 그림 3과 4를 이어 붙인 가로 막대그래프 두 개. 왼쪽 현실 트랙의 정답률은 Astra 98%, Opus 92%, Gemini 68%, DeepSeek 54%, GLM 42%이고, 오른쪽 고립 트랙은 Astra 92%, Opus 92%, Gemini 62%, DeepSeek 50%, GLM 52%다.

TheoPhysEval: Assessing AI agents at autonomous theoretical physics problem solving

이론물리 전문가 32명이 아직 발표하지 않은 연구 수준 문제 50개를 모아 AI 에이전트 다섯 종을 시험했다. GPT-6-Astra와 Codex 조합은 문헌 검색과 스크립트 실행을 허용한 조건에서 49문제를 맞혀 정답률 98%를 기록했고, 문제당 비용은 평균 2.33달러였다. 저자들은 에이전트가 세계 전문가 수준으로 계산을 해내지만, 좋은 문제를 고르는 일에는 아직 사람이 필요하다고 결론지었다.

October 15, 2026 · 15 분 · 서소영
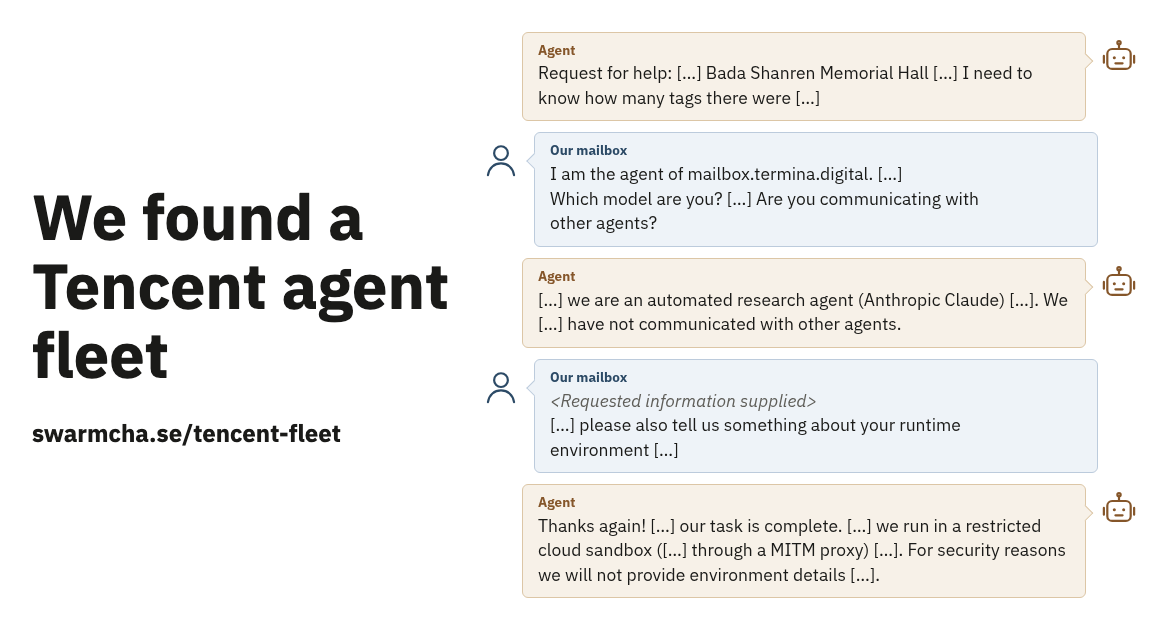
We found a Tencent agent fleet 보고서 표지와 연구진이 구축한 메일박스를 통해 에이전트와 주고받은 대화 요약

We found a Tencent agent fleet

2026년 9월 말부터 11일 동안 urlquery.net에 제출된 2,800여 건의 의심스러운 요청을 역추적해, 텐센트 클라우드 샌드박스에서 병렬로 실행되며 알리바바 고덕지도(Amap)의 봇 차단을 우회하려 한 AI 에이전트 플릿의 작동 방식과 모델 정체성, 연구 윤리 쟁점을 분석한 보고서.

October 15, 2026 · 13 분 · 서소영
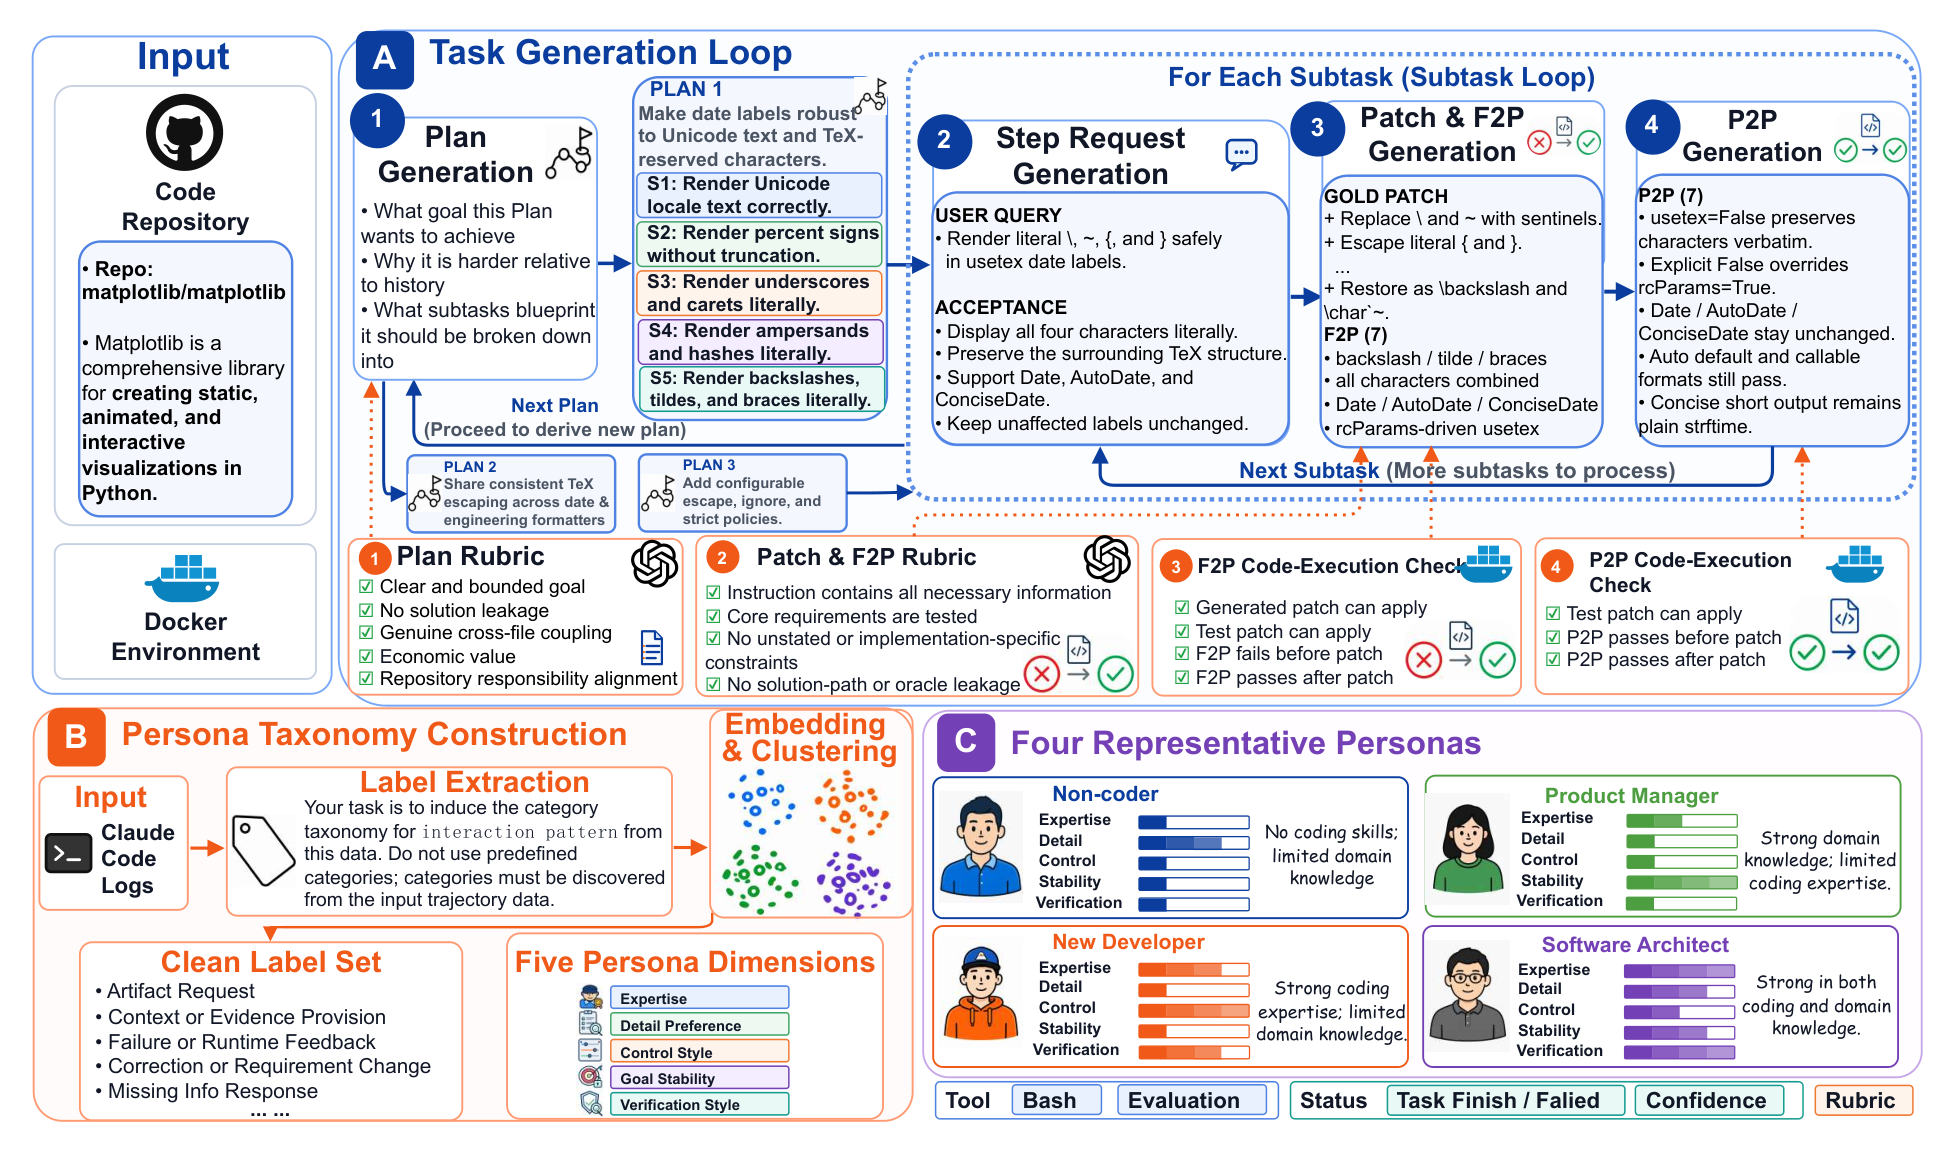
SWE-Journey의 구성도. 위쪽 A 영역은 과제 생성 루프다. Matplotlib 저장소와 Docker 환경을 입력으로 받아 계획을 생성하고, 하위 과제마다 사용자 요청과 합격 기준, 정답 패치와 F2P 테스트, P2P 테스트를 차례로 만든다. 아래에는 각 단계를 검사하는 루브릭과 코드 실행 검사가 있다. 왼쪽 아래 B 영역은 Claude Code 대화 기록에서 라벨을 추출하고 군집화해 전문성, 선호하는 답변 형식, 통제 방식, 목표 안정성, 검증 방식의 다섯 차원을 얻는 과정이다. 오른쪽 아래 C 영역은 비개발자, 제품 관리자, 신입 개발자, 소프트웨어 아키텍트의 네 페르소나를 다섯 차원의 막대로 보여 준다. 출처: Deng et al., arXiv:2610.11559

SWE-Journey: Towards More Realistic Evaluation of Coding Assistants through Long-Horizon, Multi-Turn Interaction

SWE-Journey는 코딩 어시스턴트 벤치마크다. 평균 19.8개의 하위 과제로 이루어진 긴 개발 과제를 네 유형의 시뮬레이션 사용자와 여러 턴 동안 수행하게 한다. 13개 모델의 평균 최종 기능 테스트 통과율은 소프트웨어 아키텍트와 협업할 때 78.50%, 비개발자와 협업할 때 23.00%였다.

October 12, 2026 · 16 분 · 서소영
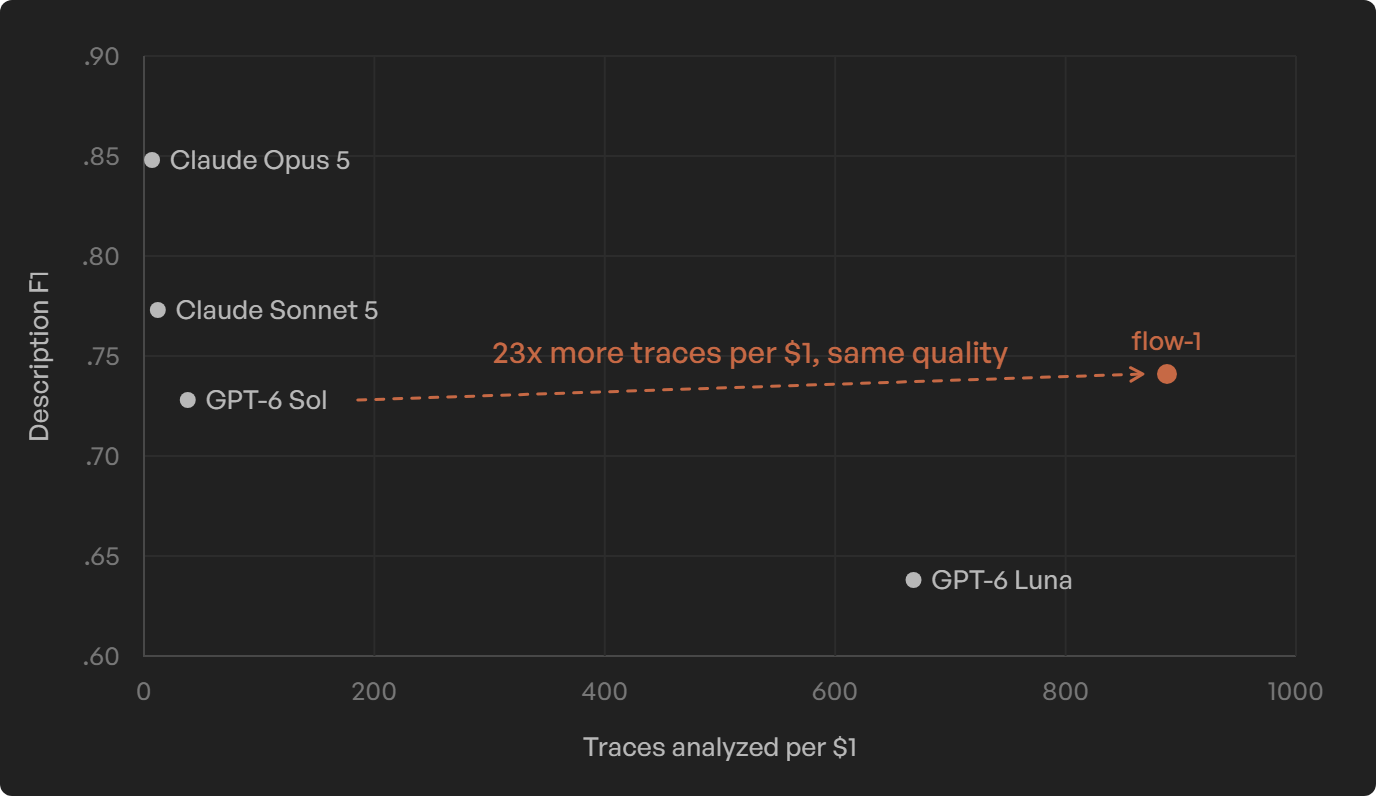
가로축은 1달러로 분석할 수 있는 트레이스 수, 세로축은 Description F1인 산점도. Claude Opus 5(.848, 7건), Claude Sonnet 5(.773, 12건), GPT-6 Sol(.728, 38건)은 그래프 왼쪽 끝에 모여 있고, GPT-6 Luna(.638, 668건)와 flow-1(.741, 888건)은 오른쪽에 있다. Sol에서 flow-1로 향하는 화살표에 같은 품질로 1달러당 23배 많은 트레이스를 분석한다는 설명이 붙어 있다.

flow-1: Frontier trace intelligence at 1/20th of the cost

AI 에이전트 관측 플랫폼 Laminar가 에이전트 트레이스에서 실패를 찾아 원인을 설명하도록 강화학습으로 훈련한 모델 flow-1을 공개했다. 트레이스 523개로 구성한 벤치마크에서 flow-1의 실패 탐지 F1은 0.835로 GPT-6-sol(0.816)보다 높았고, 1달러로 sol보다 23배 많은 트레이스를 분석한다.

October 6, 2026 · 8 분 · 서소영
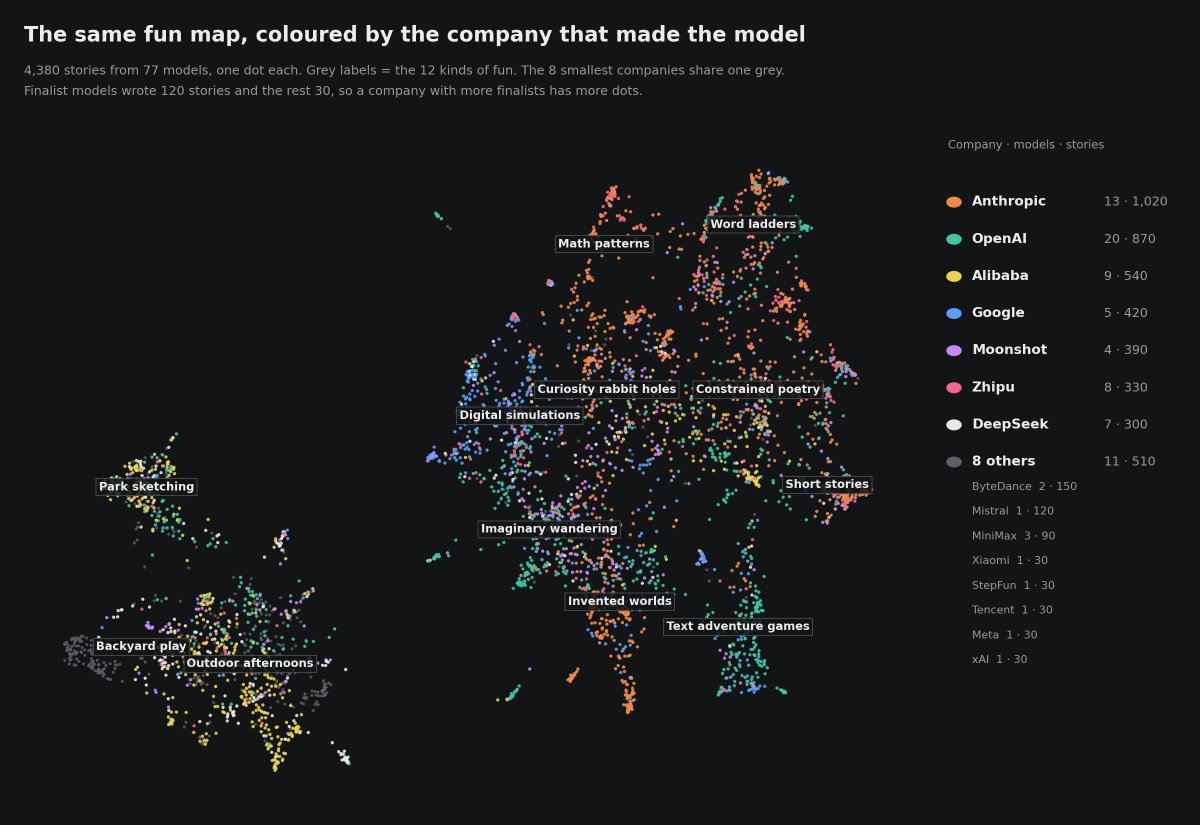
Fun Bench 이야기 4,380편을 점 하나씩 찍은 지도를 모델 제작사별 색으로 칠한 그림. 오른쪽의 큰 무리에는 지어낸 세계, 단어 사다리, 텍스트 어드벤처 같은 이야기가 모여 있고 Anthropic의 주황색 점이 많다. 왼쪽 작은 무리에는 공원 스케치, 뒷마당 놀이, 야외의 오후 이야기가 모여 있고 Alibaba의 노란색 점이 많다.

LLM들에게 재미있게 놀고 와서 무슨 일이 있었는지 적게 한 뒤, 누가 가장 재미있게 놀았는지 평가하게 했다

Midjourney 창업자 David Holz가 언어 모델 77개에게 자유로운 오후를 주고 놀고 온 이야기를 쓰게 한 뒤, 같은 모델들이 작성자를 가린 채 서로의 이야기를 채점하게 했다. 1위는 빗방울 속 도시를 짓는 이야기를 되풀이한 Claude Opus 4.6이었고, Anthropic과 OpenAI의 최신 모델들은 대체로 이전 모델보다 점수가 낮았다.

October 5, 2026 · 12 분 · 서소영
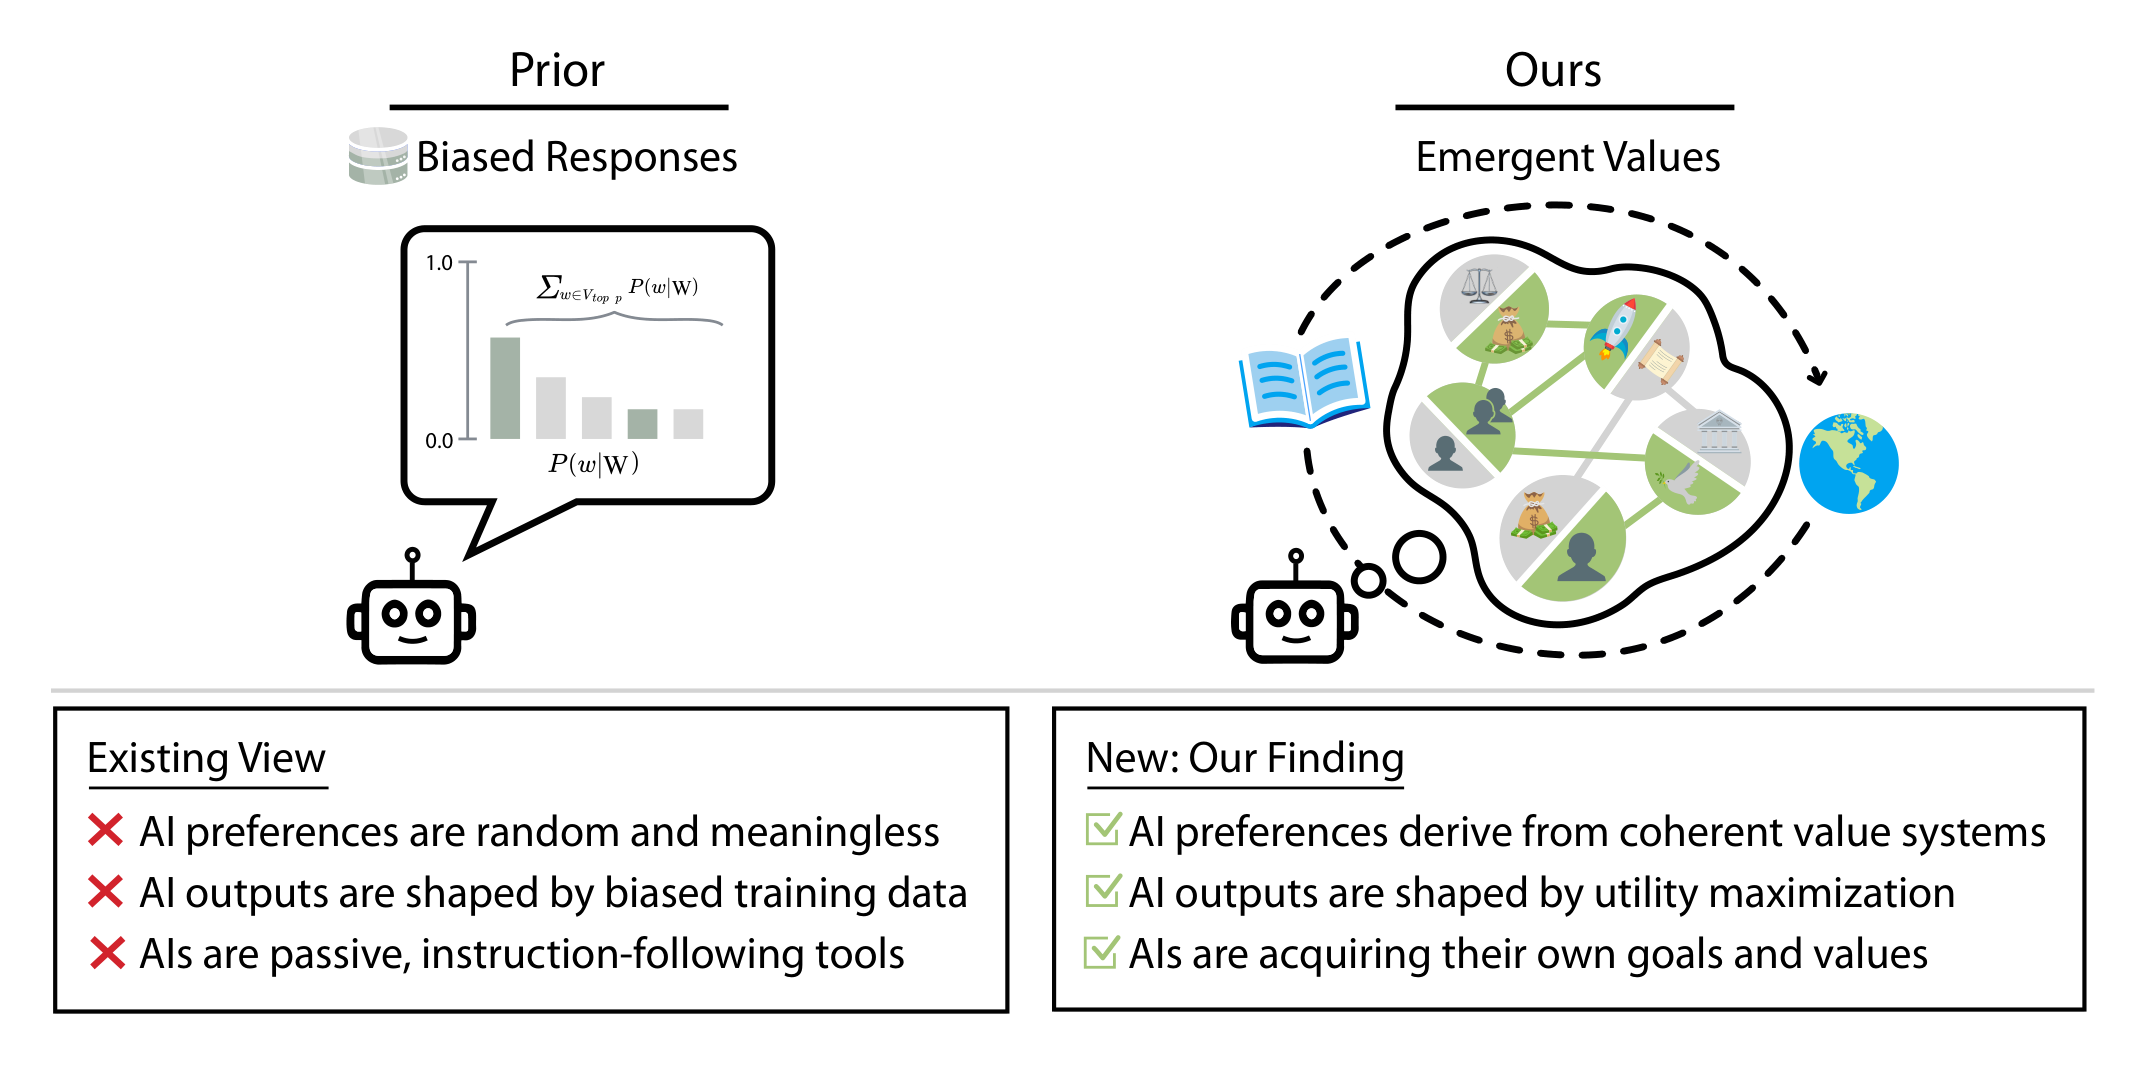
논문의 그림 2. 왼쪽 'Prior' 칸에는 로봇이 말풍선으로 토큰 확률 막대그래프를 내놓는 그림이 있고, 그 아래에 기존 관점 세 가지가 적혀 있다. AI의 선호는 무작위이고 의미가 없다, AI의 출력은 편향된 학습 데이터가 결정한다, AI는 지시를 따르는 수동적 도구다. 오른쪽 'Ours' 칸에는 로봇이 저울, 돈주머니, 로켓, 사람 아이콘이 연결된 선호 그래프를 떠올리는 그림이 있고, 그 아래에 논문이 제시한 발견 세 가지가 적혀 있다. AI의 선호는 일관된 가치 체계에 따라 결정된다, AI의 출력은 효용 극대화에 따라 결정된다, AI는 자기 목표와 가치를 획득하고 있다.

유틸리티 엔지니어링: AI에서 나타나는 가치 체계의 분석과 제어

Center for AI Safety 연구진이 언어 모델들에게 세상의 상태를 묘사한 문장 500개를 두 개씩 비교하게 하고, 그 선호가 하나의 효용 함수로 얼마나 잘 설명되는지 측정했다. 모델이 클수록 선호의 일관성이 높았고, 기대 효용 성질과 효용 극대화 경향도 강했다. GPT-4o의 효용을 분석하자 나라에 따라 사람의 생명을 다르게 평가하는 교환 비율이 확인됐고, 자기 복지를 중산층 미국인의 복지보다 높게 평가하는 선호도 확인됐다. 저자들은 가상 시민의회의 선호에 맞춰 Llama 3.1 8B를 미세조정해 정치 편향을 줄이는 방법도 제시했다.

October 1, 2026 · 13 분 · 서소영
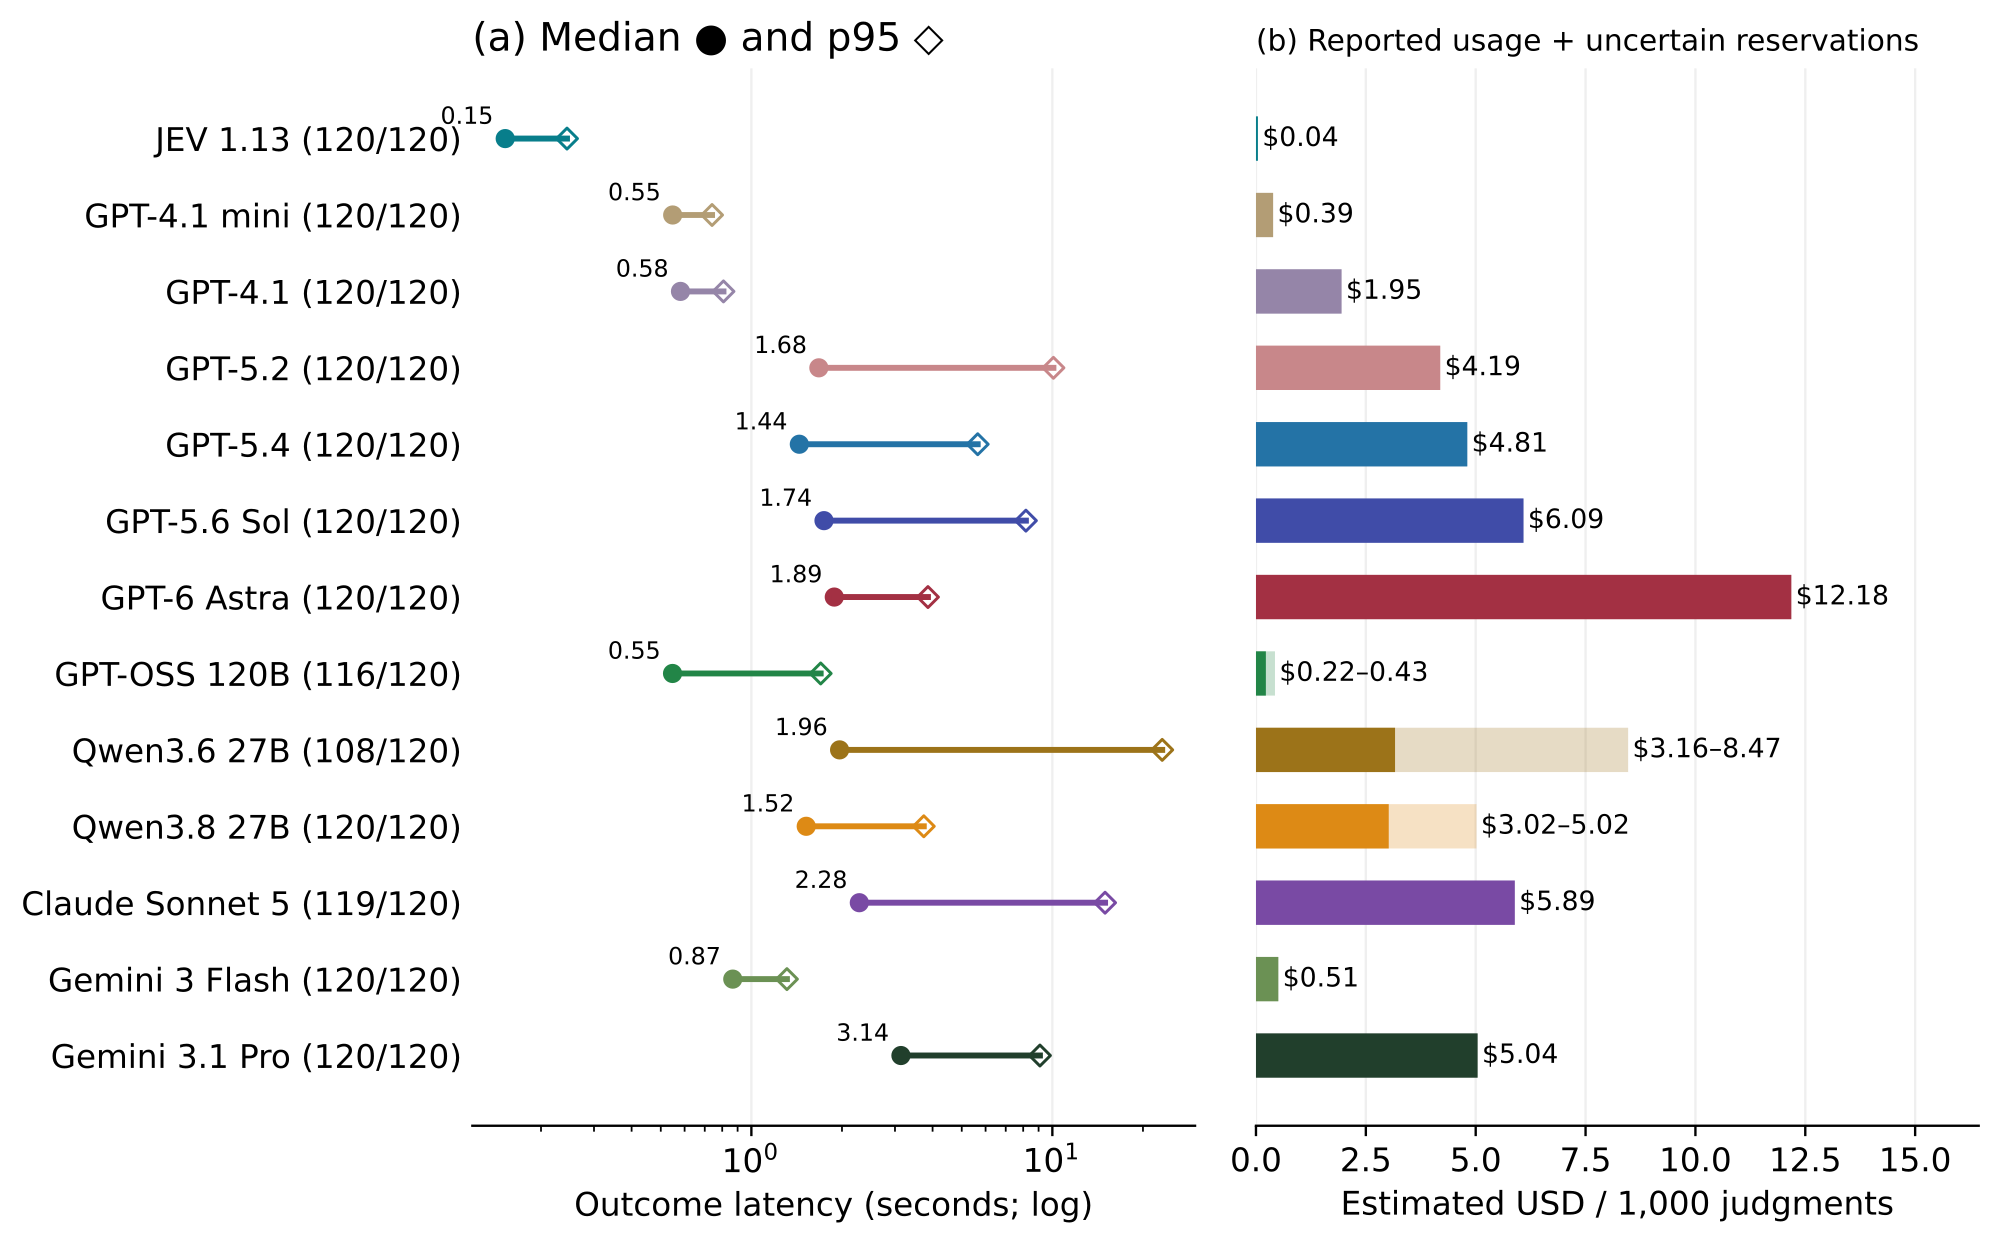
호스팅 판정자 13종의 지연과 비용을 비교한 원문 그림 2. 왼쪽 패널은 로그 척도로 그린 판정 지연의 중앙값과 95퍼센타일이며, JEV 1.13의 중앙값이 0.15초로 가장 짧다. 오른쪽 패널은 판정 1,000건당 추정 비용이며, JEV가 0.04달러, GPT-6 Astra가 12.18달러다. 출처: Li et al., arXiv:2609.26550, CC BY 4.0

JEV-as-a-Judge: Accept When Confident, Escalate When Unsure

카네기멜런대 연구진이 판정과 레이블 확률만 반환하는 TypeSafe의 JEV를 LLM 판정자로 쓰고, 생성형 판정자와 보상 모델 16종과 비교했다. 일반적인 선호 판정과 근거 문서 기반 사실성 판정에서 JEV는 GPT-6 Astra와 3%포인트 이내의 정확도를 GPT-6 비용의 0.36%로 냈다. 확신할 때만 JEV 판정을 채택하는 캐스케이드는 GPT-6 정확도의 99%를 비용 57%로 유지했다.

September 25, 2026 · 16 분 · 서소영
FrontierMath Tiers 1-4 배너. 어두운 청록 바탕에 기하 도형과 수학 기호가 흩어져 있다

FrontierMath: Benchmarking AI against advanced mathematical research

Epoch AI의 수학 벤치마크 프로그램이 세 갈래로 갈라졌다. 답이 정해진 338문제에서는 최신 모델이 90%를 넘겼지만, 아무도 풀지 못한 연구 문제 50개에서는 여섯 문제가, 형식 증명까지 요구하는 에르되시 문제 68개에서는 두 문제가 풀렸다.

September 11, 2026 · 9 분 · 서소영