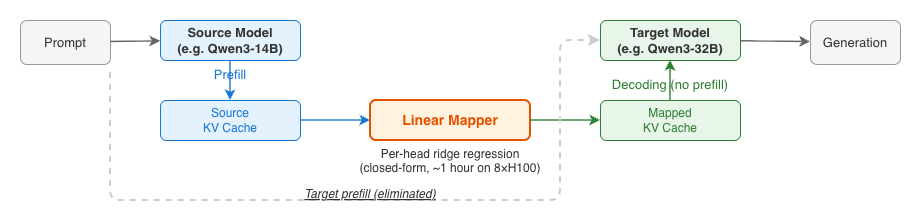
Cross-Model KV Cache Transfer in LLM Families: A Closed-Form Linear Mapping for Prefill Reuse
같은 계열의 작은 모델과 큰 모델 사이에서 KV 캐시를 헤드별 리지 회귀로 변환해, 모델을 바꿀 때 프리필을 다시 하지 않게 하는 NVIDIA 연구진의 논문이다. 세 계열 여섯 쌍 가운데 네 쌍이 타깃 단독 정확도의 73%에서 98%를 유지했고, 변환은 다시 프리필하는 것보다 2.7배에서 25배 빨랐다.