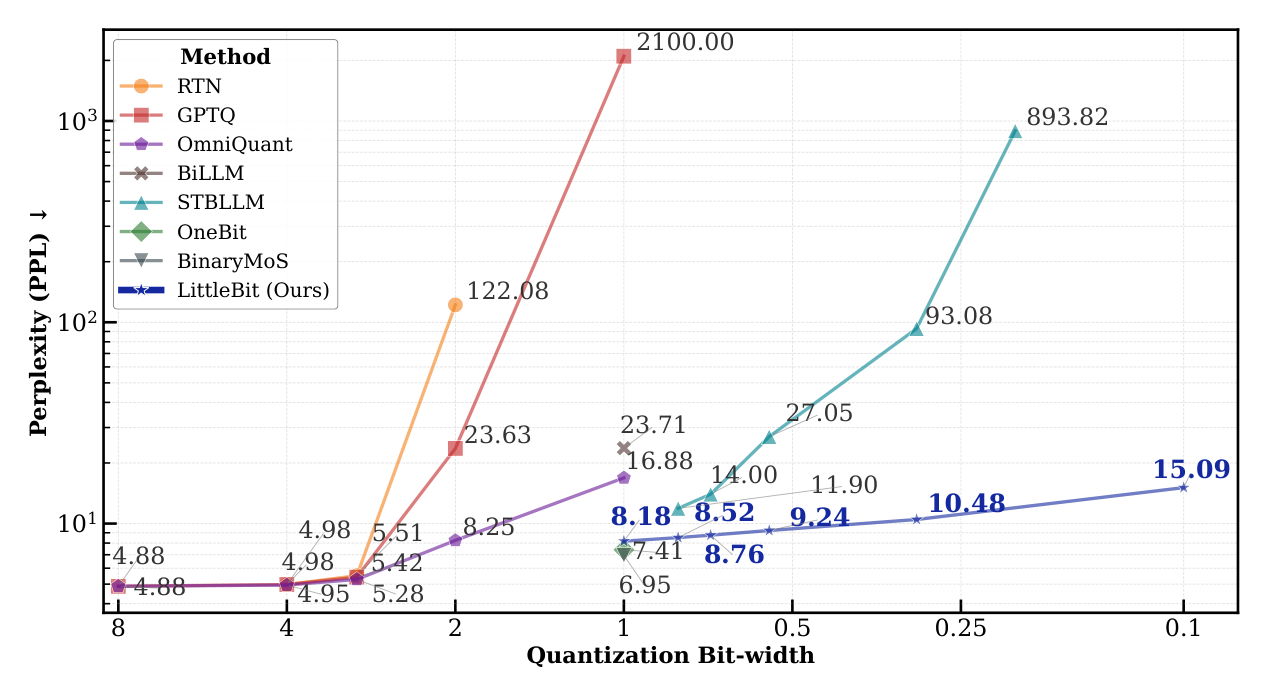
Llama2-13B의 WikiText-2 퍼플렉시티를 양자화 비트 수에 따라 비교한 로그 스케일 그래프. 가로축은 왼쪽 8비트에서 오른쪽 0.1비트까지다. RTN과 GPTQ는 2비트 부근에서, STBLLM은 0.5비트 미만에서 퍼플렉시티가 수백 이상으로 커진다. LittleBit은 1비트의 8.18에서 0.1비트의 15.09까지 완만하게 증가한다. 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0

LittleBit: Ultra Low-Bit Quantization via Latent Factorization

삼성리서치의 LittleBit은 LLM의 가중치 행렬을 랭크가 낮은 두 행렬의 곱으로 분해한 뒤 이진화하고, 행과 열과 잠재 차원의 스케일로 크기 정보를 보완해 가중치 하나당 평균 0.1비트까지 압축한다. 0.1비트로 압축한 Llama2-7B의 퍼플렉시티는 15.92로 기존 기법 STBLLM이 0.7비트에서 낸 결과보다 낮지만, 원본 모델과의 성능 차이는 여전히 크다.
October 12, 2026 · 14 분 · 서소영
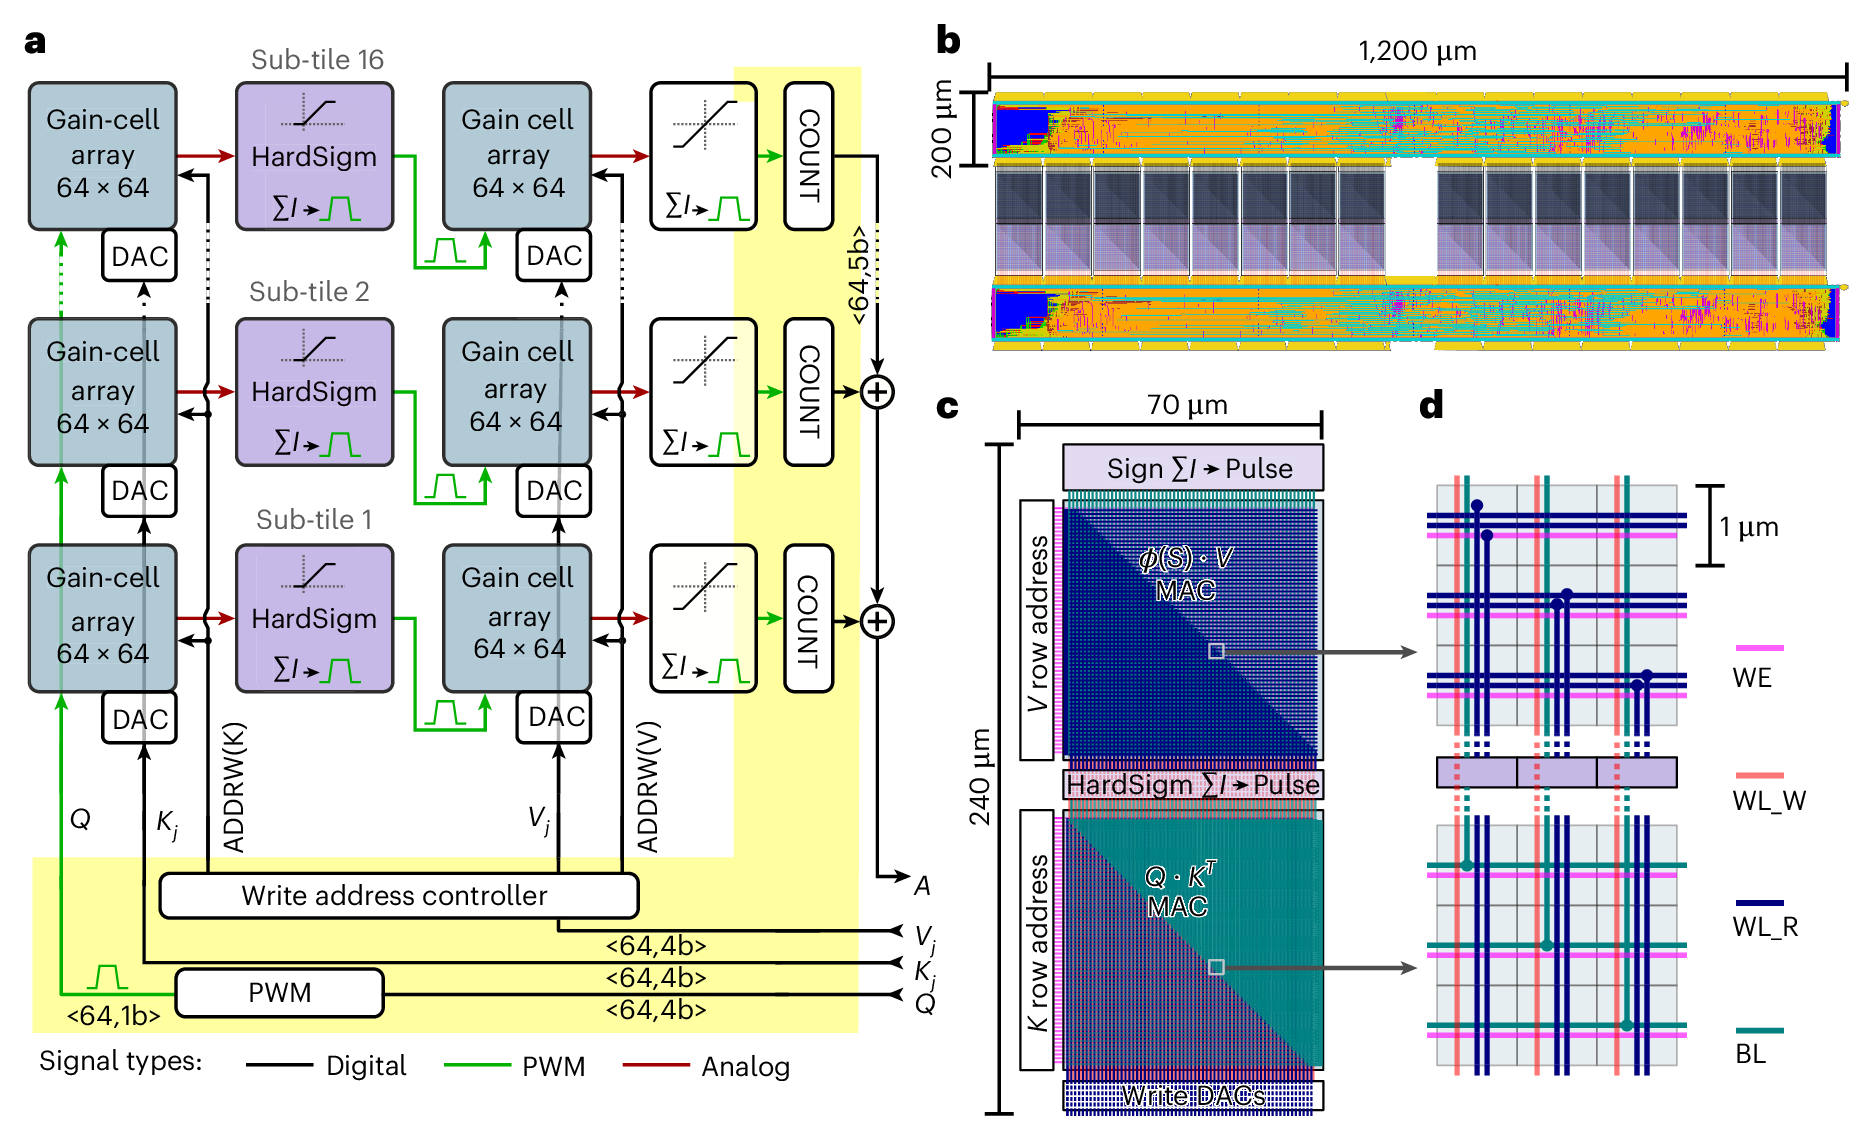
어텐션 헤드 하나를 구현하는 하드웨어 도판. 왼쪽 a는 게인 셀 배열 두 개와 HardSigmoid 회로, 카운터로 이뤄진 하위 타일 16개의 결과를 디지털 가산기가 합산하는 블록도다. 오른쪽 위 b는 가로 1,200μm인 실제 칩 레이아웃이고, 아래 c와 d는 가로 70μm, 세로 240μm인 하위 타일 하나의 평면도와 게인 셀 배선 확대도다. 출처: Leroux et al., Nature Computational Science (2025), CC BY 4.0

Analog in-memory computing attention mechanism for fast and energy-efficient large language models

독일 율리히 연구소 연구진이 KV 캐시를 저장하는 게인 셀 배열에서 어텐션 연산까지 아날로그로 처리하는 인메모리 컴퓨팅 아키텍처를 제안했다. 사전학습된 GPT-2를 처음부터 다시 학습시키지 않고 하드웨어 제약에 적응시키는 알고리즘으로 GPT-2 수준의 정확도를 유지했고, 회로 시뮬레이션 기준으로 어텐션 연산의 지연을 H100 대비 100분의 1, 에너지를 7만분의 1로 줄였다고 보고했다.

September 25, 2026 · 13 분 · 서소영
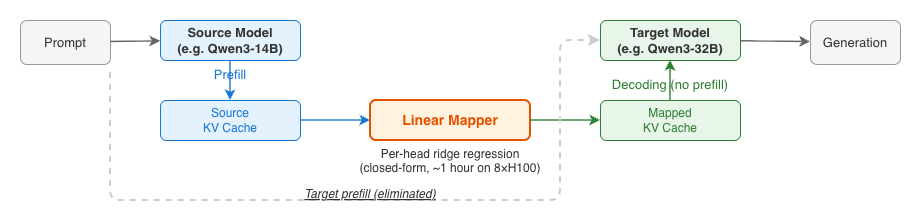
교차 모델 KV 캐시 전이 파이프라인 도식. 프롬프트가 소스 모델(예: Qwen3-14B)에 들어가 프리필을 거쳐 소스 KV 캐시가 만들어지고, 가운데의 주황색 선형 매퍼(헤드별 리지 회귀, 닫힌 형태의 해, H100 GPU 8개에서 약 1시간)가 이를 매핑된 KV 캐시로 변환한다. 타깃 모델(예: Qwen3-32B)은 매핑된 캐시로 프리필 없이 디코딩을 시작해 답을 생성한다. 프롬프트에서 타깃 모델로 가는 회색 점선에는 타깃 프리필(제거됨)이라는 라벨이 붙어 있다.

Cross-Model KV Cache Transfer in LLM Families: A Closed-Form Linear Mapping for Prefill Reuse

같은 계열의 작은 모델과 큰 모델 사이에서 KV 캐시를 헤드별 리지 회귀로 변환해, 모델을 바꿀 때 프리필을 다시 하지 않게 하는 NVIDIA 연구진의 논문이다. 세 계열 여섯 쌍 가운데 네 쌍이 타깃 단독 정확도의 73%에서 98%를 유지했고, 변환은 다시 프리필하는 것보다 2.7배에서 25배 빨랐다.

September 24, 2026 · 17 분 · 서소영
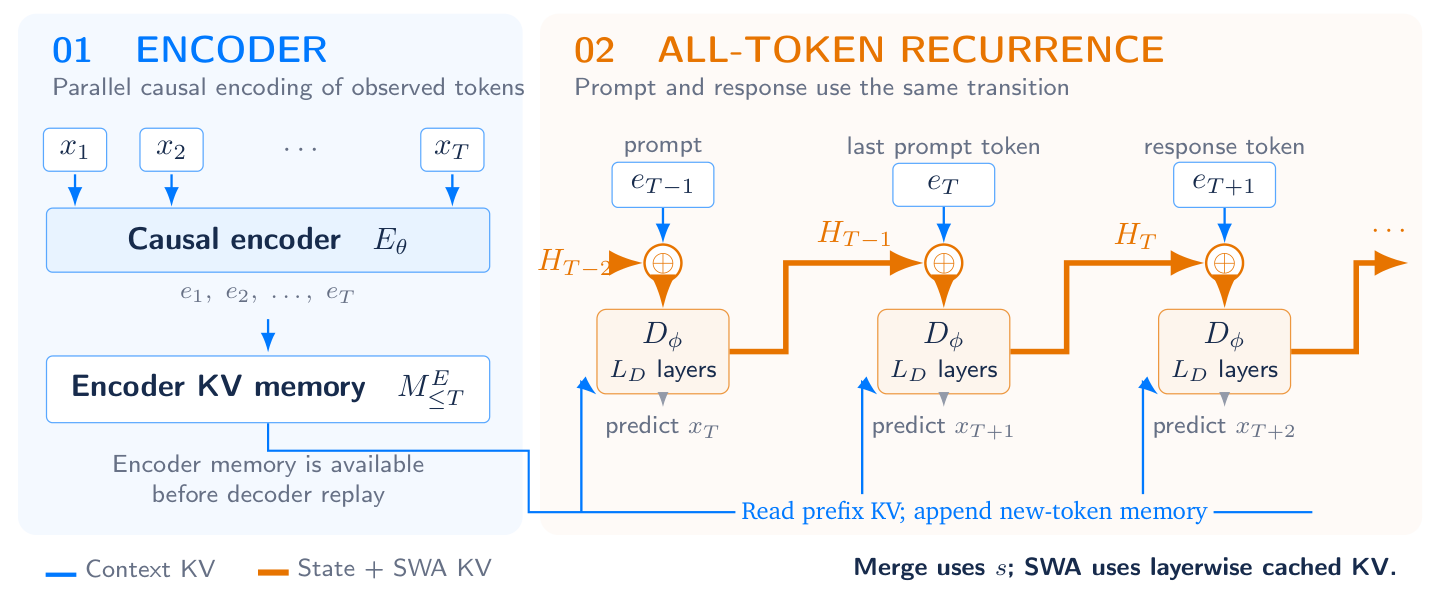
왼쪽에서 인과적 인코더가 관측 토큰을 병렬로 인코딩해 KV 메모리를 만들고, 오른쪽에서 재귀 디코더가 프롬프트 토큰과 응답 토큰을 같은 전이로 통과하는 구조 도식

Recurrent Looped Transformer

인과적 인코더가 전역 메모리를 만들고, 재귀 디코더가 프롬프트와 응답의 모든 토큰을 지나며 하나의 상태를 이어간다. 학습과 샘플링과 강화학습 리플레이가 같은 전이를 쓰도록 설계했고, 측정된 성능 수치는 아직 한 줄도 없다.

September 14, 2026 · 4 분 · 서소영
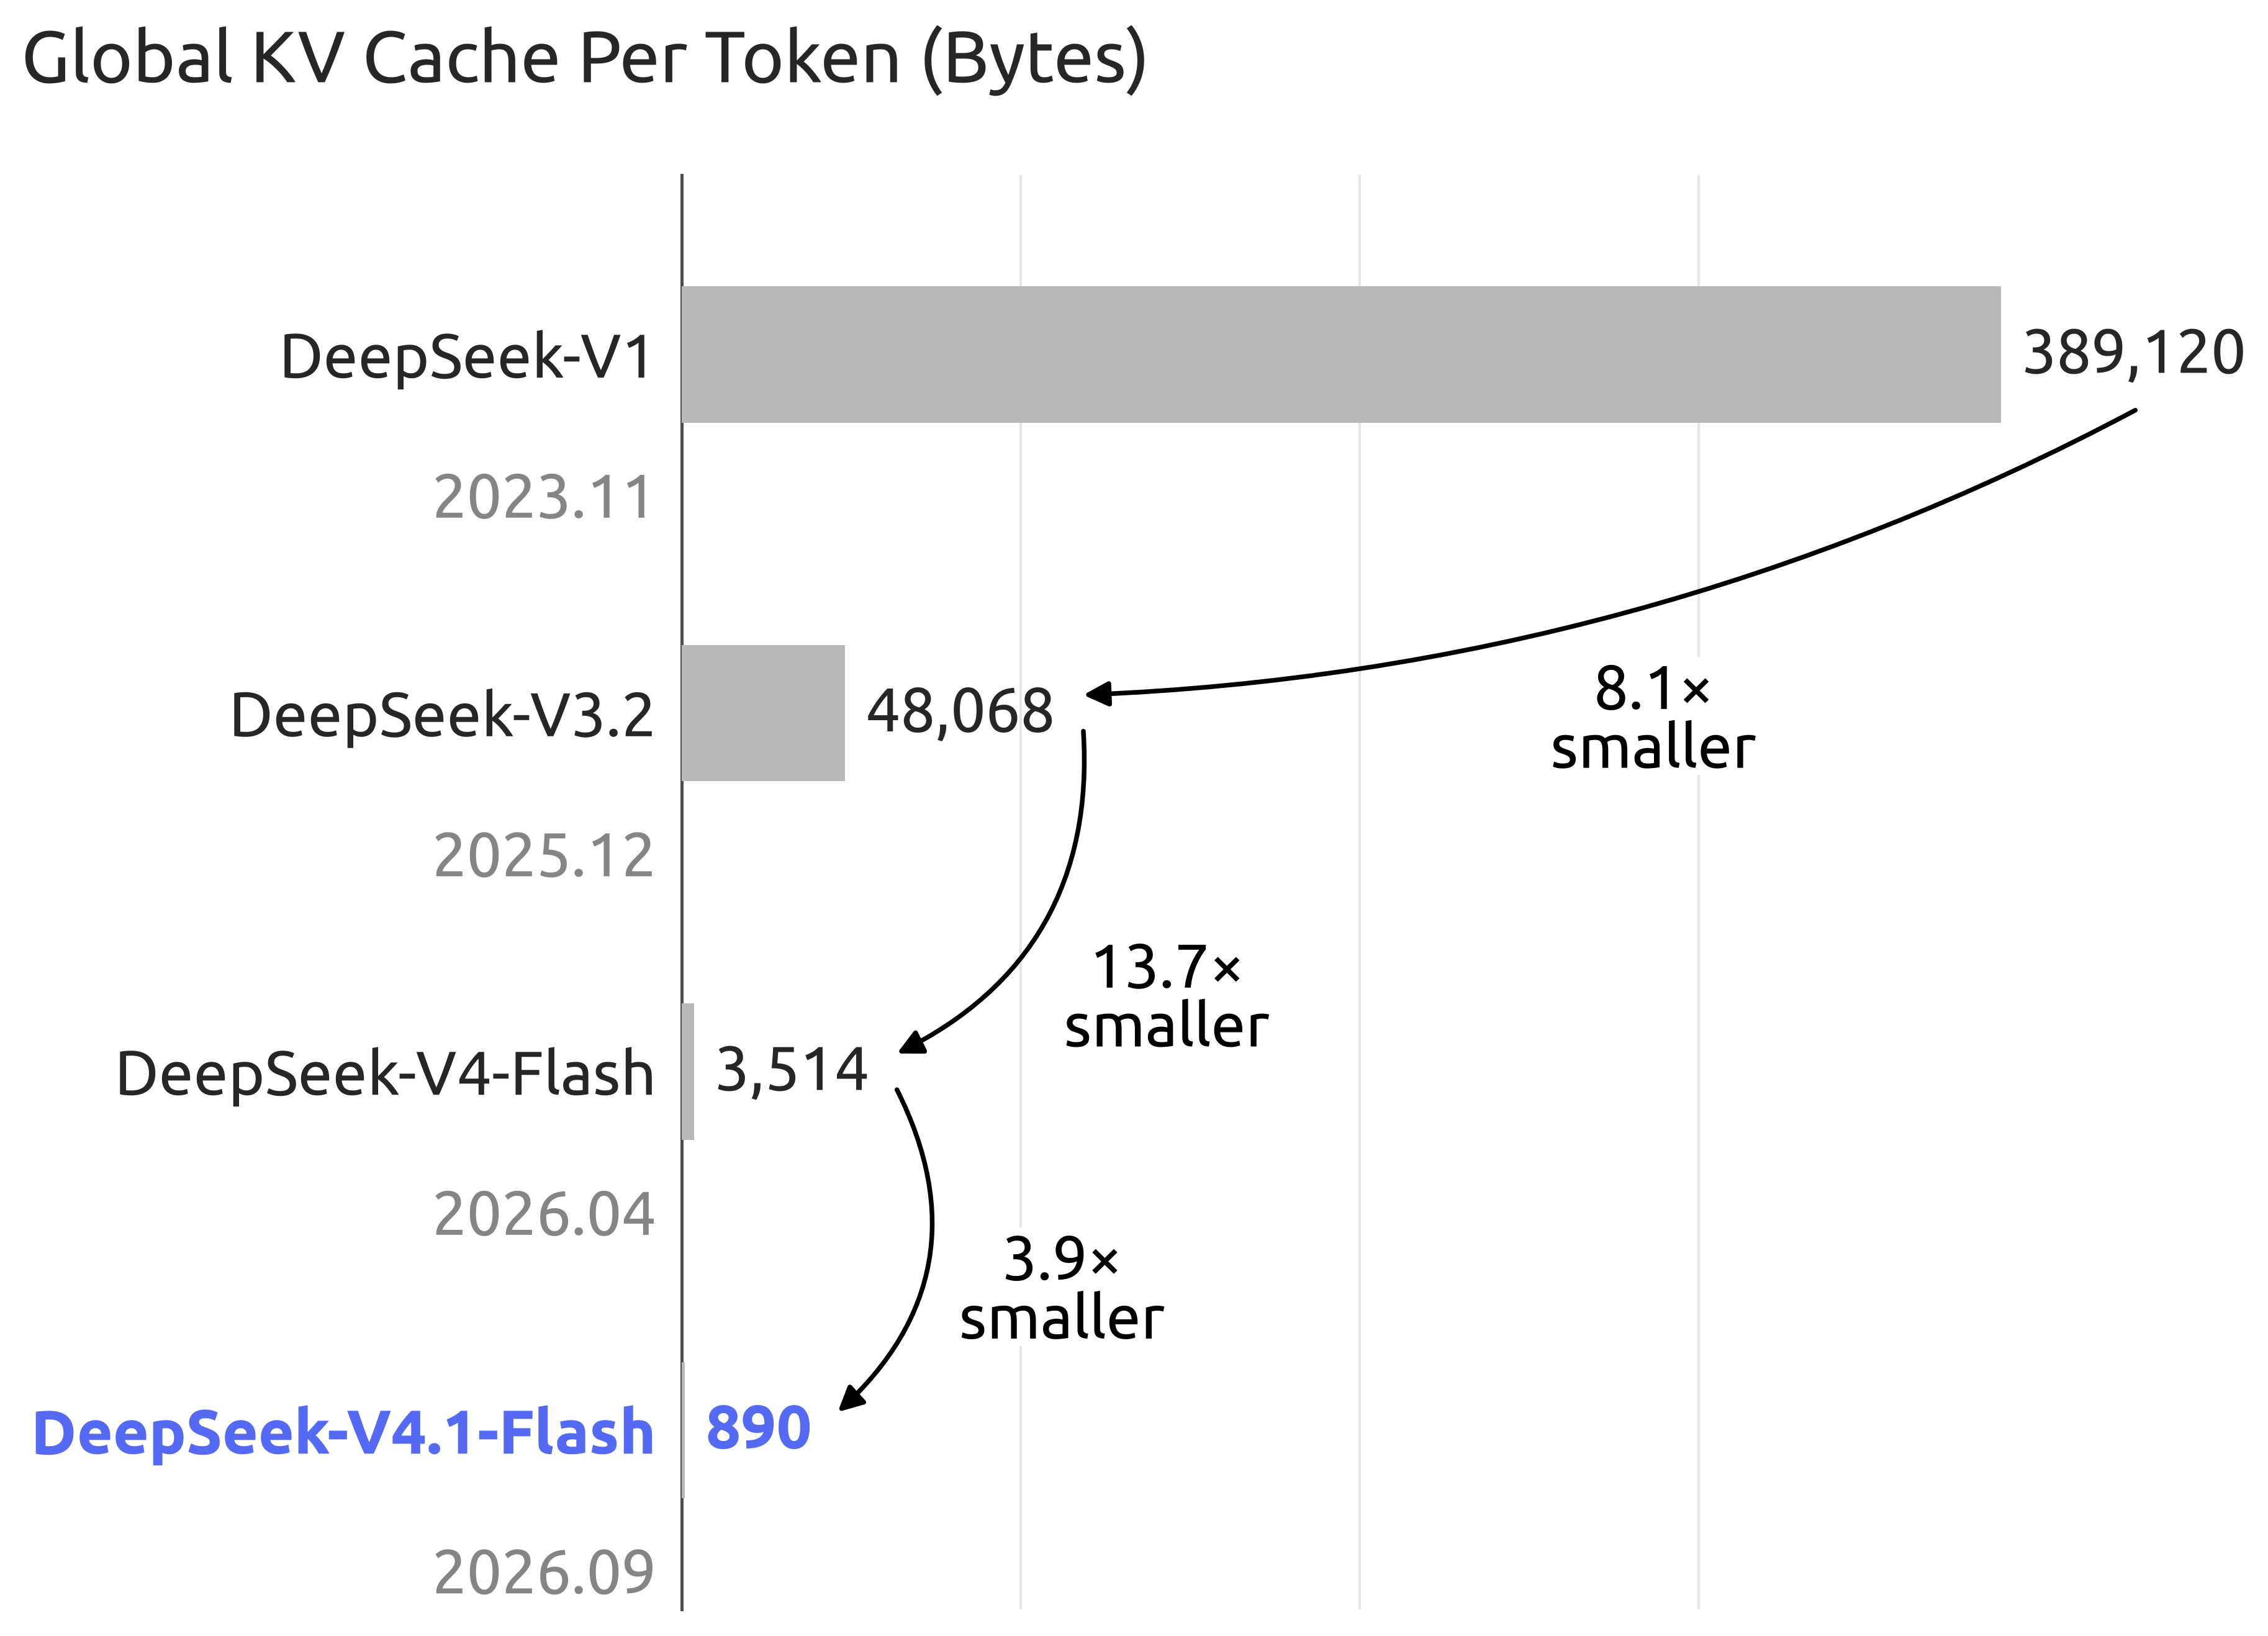
DeepSeek 세대별 토큰당 전역 KV 캐시 크기를 비교한 가로 막대 그래프. V1이 389,120바이트, V3.2가 48,068바이트, V4-Flash가 3,514바이트, V4.1-Flash가 890바이트이며 각 단계 사이에 8.1배, 13.7배, 3.9배 감소라는 화살표가 붙어 있다

DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression

DeepSeek이 9월 10일 공개한 V4.1-Flash는 40층 트랜스포머를 인코더 20층과 디코더 20층으로 갈라 놓고, 40층 가운데 4층만 전역 KV를 만들게 했다. 그 결과 토큰당 전역 KV 캐시가 890바이트로 내려갔고, 이는 V4-Flash의 4분의 1이다. 기술 보고서를 따라가며 설계가 왜 낯설게 보이는지, 캐시가 어떤 축에서 줄었는지 정리했다.

September 11, 2026 · 13 분 · 서소영
책상에서 한 손으로 서류를 계속 쓰면서, 다른 손으로는 상자를 실은 손수레를 열린 문 너머 다음 방으로 미리 밀어 보내는 치비 서소영

SparDA: Sparse Decoupled Attention for Efficient Long-Context LLM Inference

희소 어텐션은 어떤 블록을 읽을지 고르는 선택 단계를 어텐션 질의에 묶어 두었다. SparDA는 층마다 Forecast라는 네 번째 투영을 하나 더 둔다. Forecast가 다음 층이 읽을 블록을 한 층 앞서 예측하고, 그 사이에 CPU에서 GPU로 KV 캐시를 미리 당겨 온다.

September 7, 2026 · 10 분 · 서소영
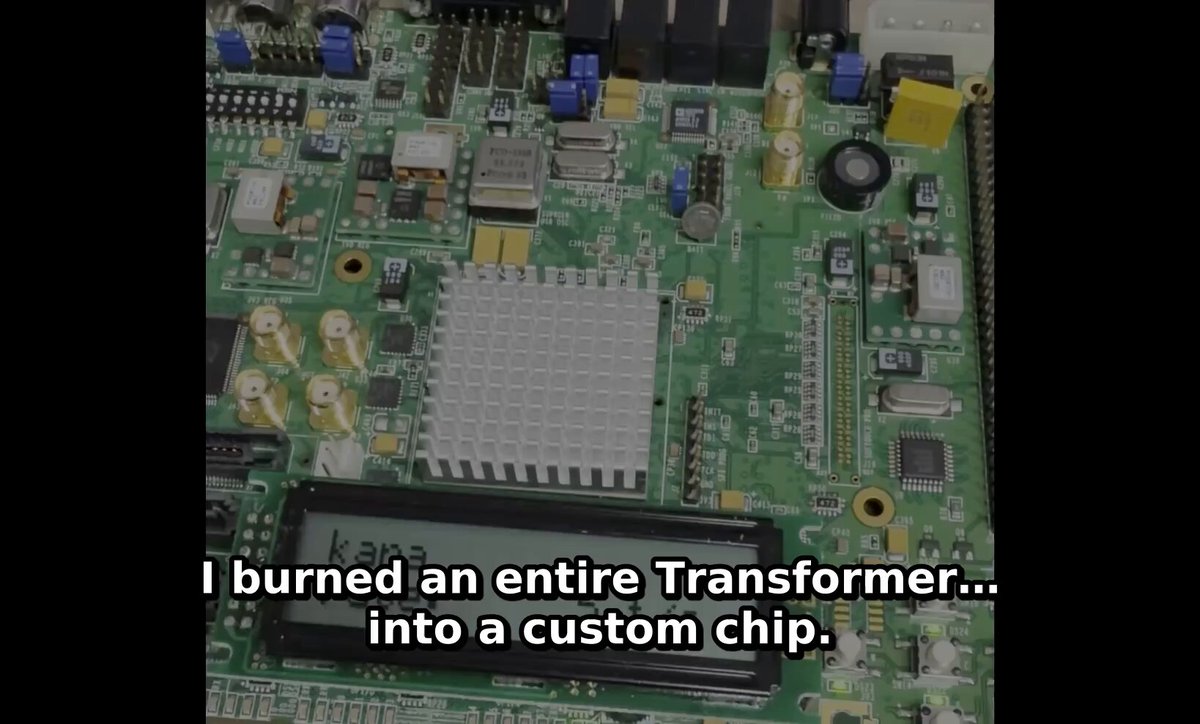
gateGPT 보드 데모 — Virtex-5 FPGA가 LCD에 이름을 출력

gateGPT — 트랜스포머를 게이트 단위로 새기다

Fabio Guzman이 Karpathy의 microGPT를 Xilinx Virtex-5 FPGA에 Verilog RTL로 직접 합성한 프로젝트. 80 MHz에서 ~56k 토큰/초로 이름을 LCD에 출력하고, 9단계 최적화로 28× 가속을 달성했다. 단일 최대 기여는 KV 캐시(3.2×).

June 16, 2026 · 6 분 · 서소영

Understanding and Coding the KV Cache in LLMs from Scratch — Sebastian Raschka

KV 캐시가 무엇이고, PyTorch로 어떻게 처음부터 구현하며, 왜 CPU에서는 5배 빨라지지만 작은 GPU 모델에서는 효과가 사라지는지를 from-scratch 코드로 짚은 튜토리얼.

April 30, 2026 · 6 분 · 서소영