트윗 아카이브 제작 기록: Jev로 분류하고 기억나는 말로 찾기
X 계정 하나의 트윗을 연도와 주제로 둘러보고 기억나는 말로 찾을 수 있는 아카이브를, 이틀 동안 PR 38개를 머지하며 만들었다. 트윗마다 주제 점수를 매기는 일과 검색은 Jev가 맡았고, 처음 적재한 트윗 15,112개를 채점하는 데 든 비용은 0.76달러였다.
X 계정 하나의 트윗을 연도와 주제로 둘러보고 기억나는 말로 찾을 수 있는 아카이브를, 이틀 동안 PR 38개를 머지하며 만들었다. 트윗마다 주제 점수를 매기는 일과 검색은 Jev가 맡았고, 처음 적재한 트윗 15,112개를 채점하는 데 든 비용은 0.76달러였다.
세션 296개를 재 보니 지침 낭비의 가장 큰 원인은 규칙 문장보다 전달 구조였다. 받는 세션을 구분하고, 조건부 규칙과 스킬 목록은 필요할 때 읽게 바꾸자 세션당 주입량이 36~50% 줄었다.
일본 개발자 penpen이 TypeSafe의 판정 모델 jev로 Slack용 커스텀 이모지 사이트 Emoji Samurai를 만들고 설계를 공개했다. 앱이 이모지를 그리고, jev는 글꼴과 색, 움직임 같은 항목을 선택지 중에서 고른다. 저자는 호출 한 번에 돌아온 확률로 후보 조합과 관련 프리셋의 순서, 줄바꿈 위치를 모두 정했다.
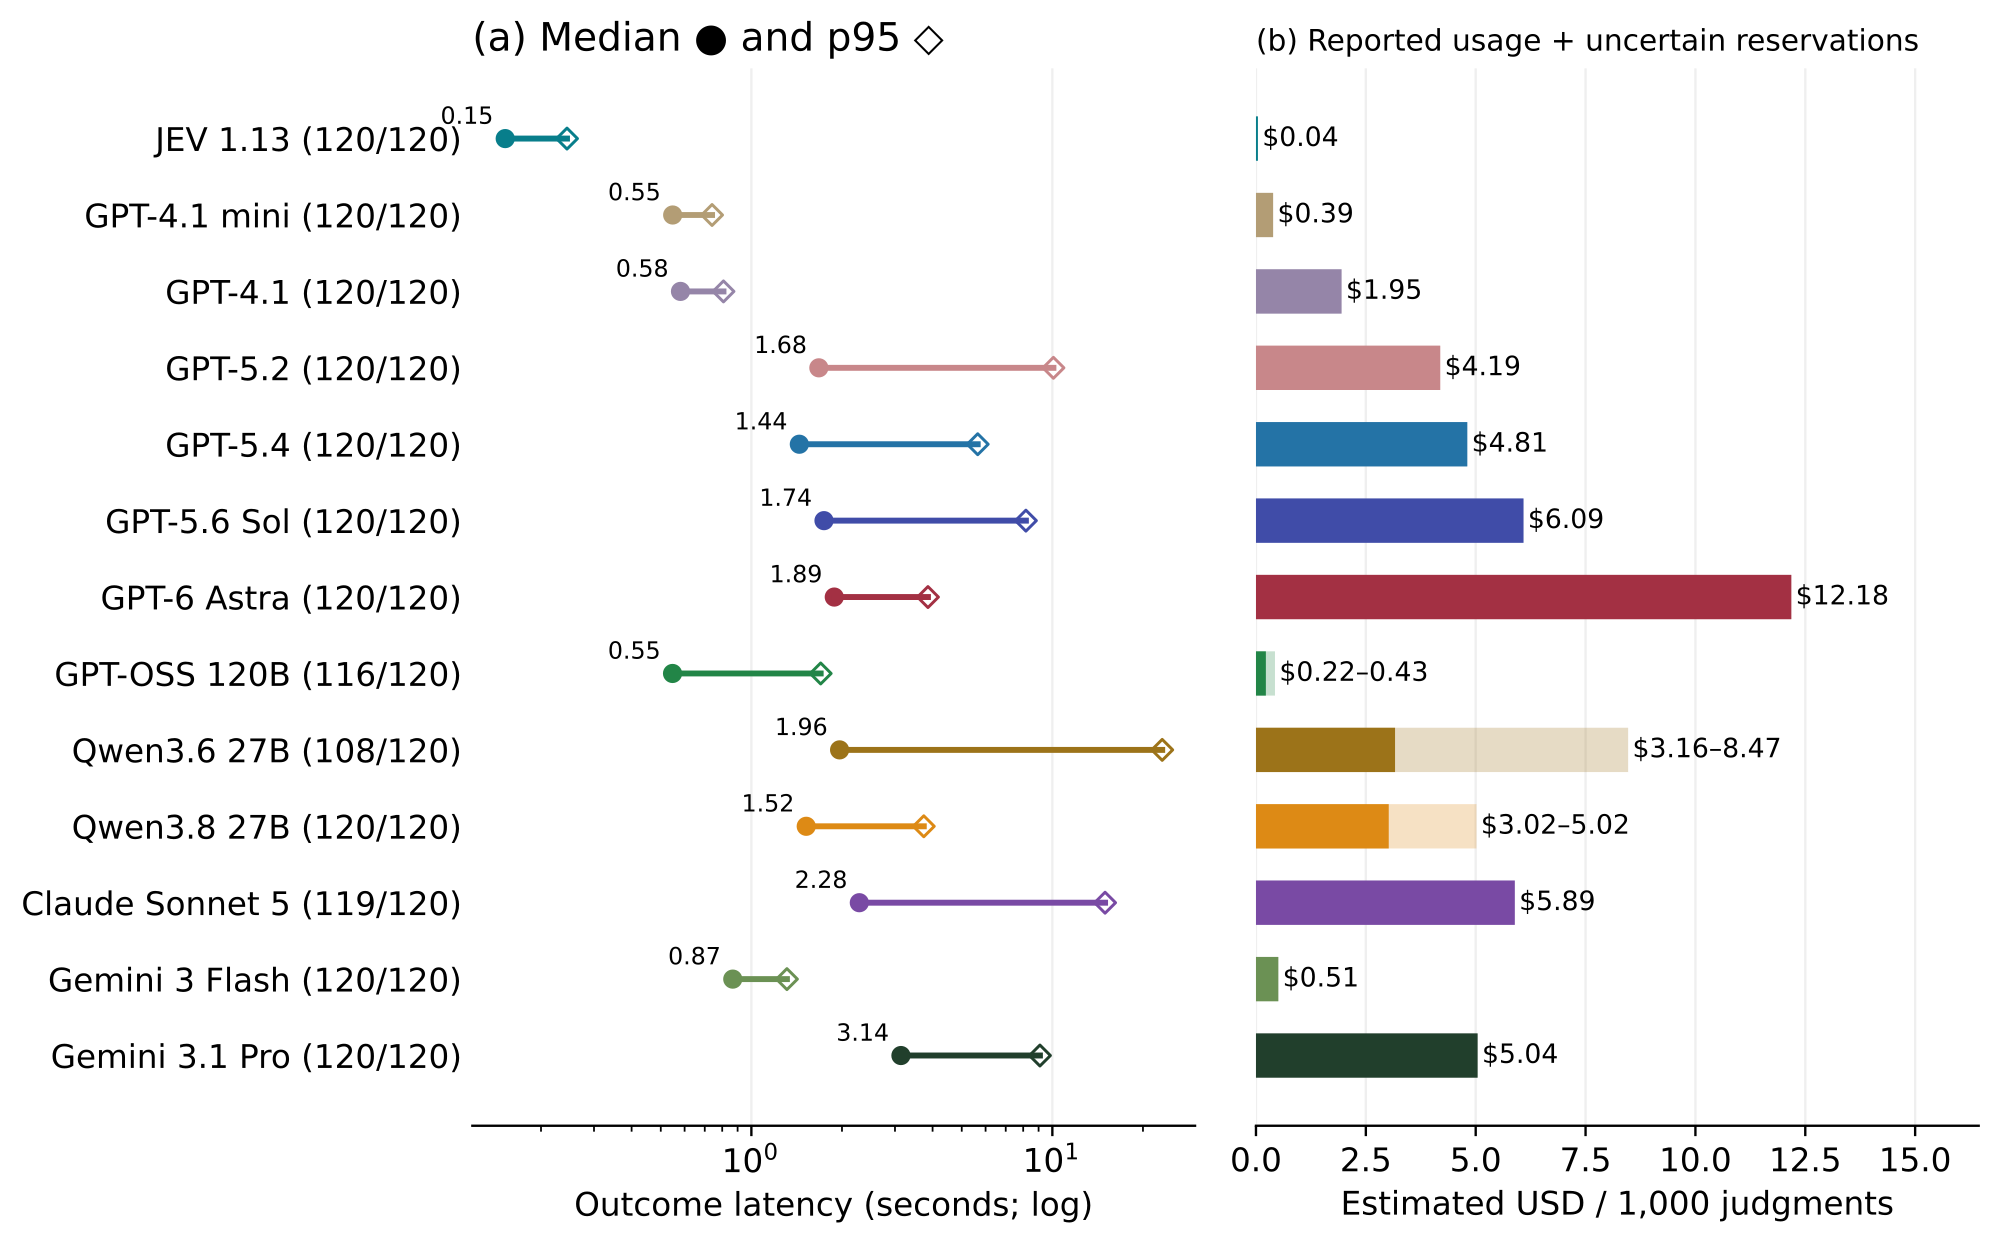
카네기멜런대 연구진이 판정과 레이블 확률만 반환하는 TypeSafe의 JEV를 LLM 판정자로 쓰고, 생성형 판정자와 보상 모델 16종과 비교했다. 일반적인 선호 판정과 근거 문서 기반 사실성 판정에서 JEV는 GPT-6 Astra와 3%포인트 이내의 정확도를 GPT-6 비용의 0.36%로 냈다. 확신할 때만 JEV 판정을 채택하는 캐스케이드는 GPT-6 정확도의 99%를 비용 57%로 유지했다.
Claude Code의 컴팩션 요약을 없애고, 도구 호출과 도구 결과만 Jev의 확률 판정으로 골라 삭제하는 플러그인 저장소. 남기기로 한 것은 요약하지 않고 원문 그대로 둔다.
GPT-6 Astra가 목표를 세우고 TypeSafe Jev가 행동을 고르는 마인크래프트 에이전트 저장소. 빈 인벤토리에서 8분 43초 만에 엔더 드래곤을 잡았다. 기록을 줄인 수리 목록과, 성과를 과장하지 않으려고 미리 적어 둔 규칙들을 함께 읽어 본다.
Jev는 글을 쓰는 대신 선택지와 확률을 반환하는 판단용 모델이다. 무엇을 자동화할 수 있는지, API 사용 방법과 입력 100만 토큰당 0.042달러의 비용, ‘환각 0%’의 의미를 살펴본다.