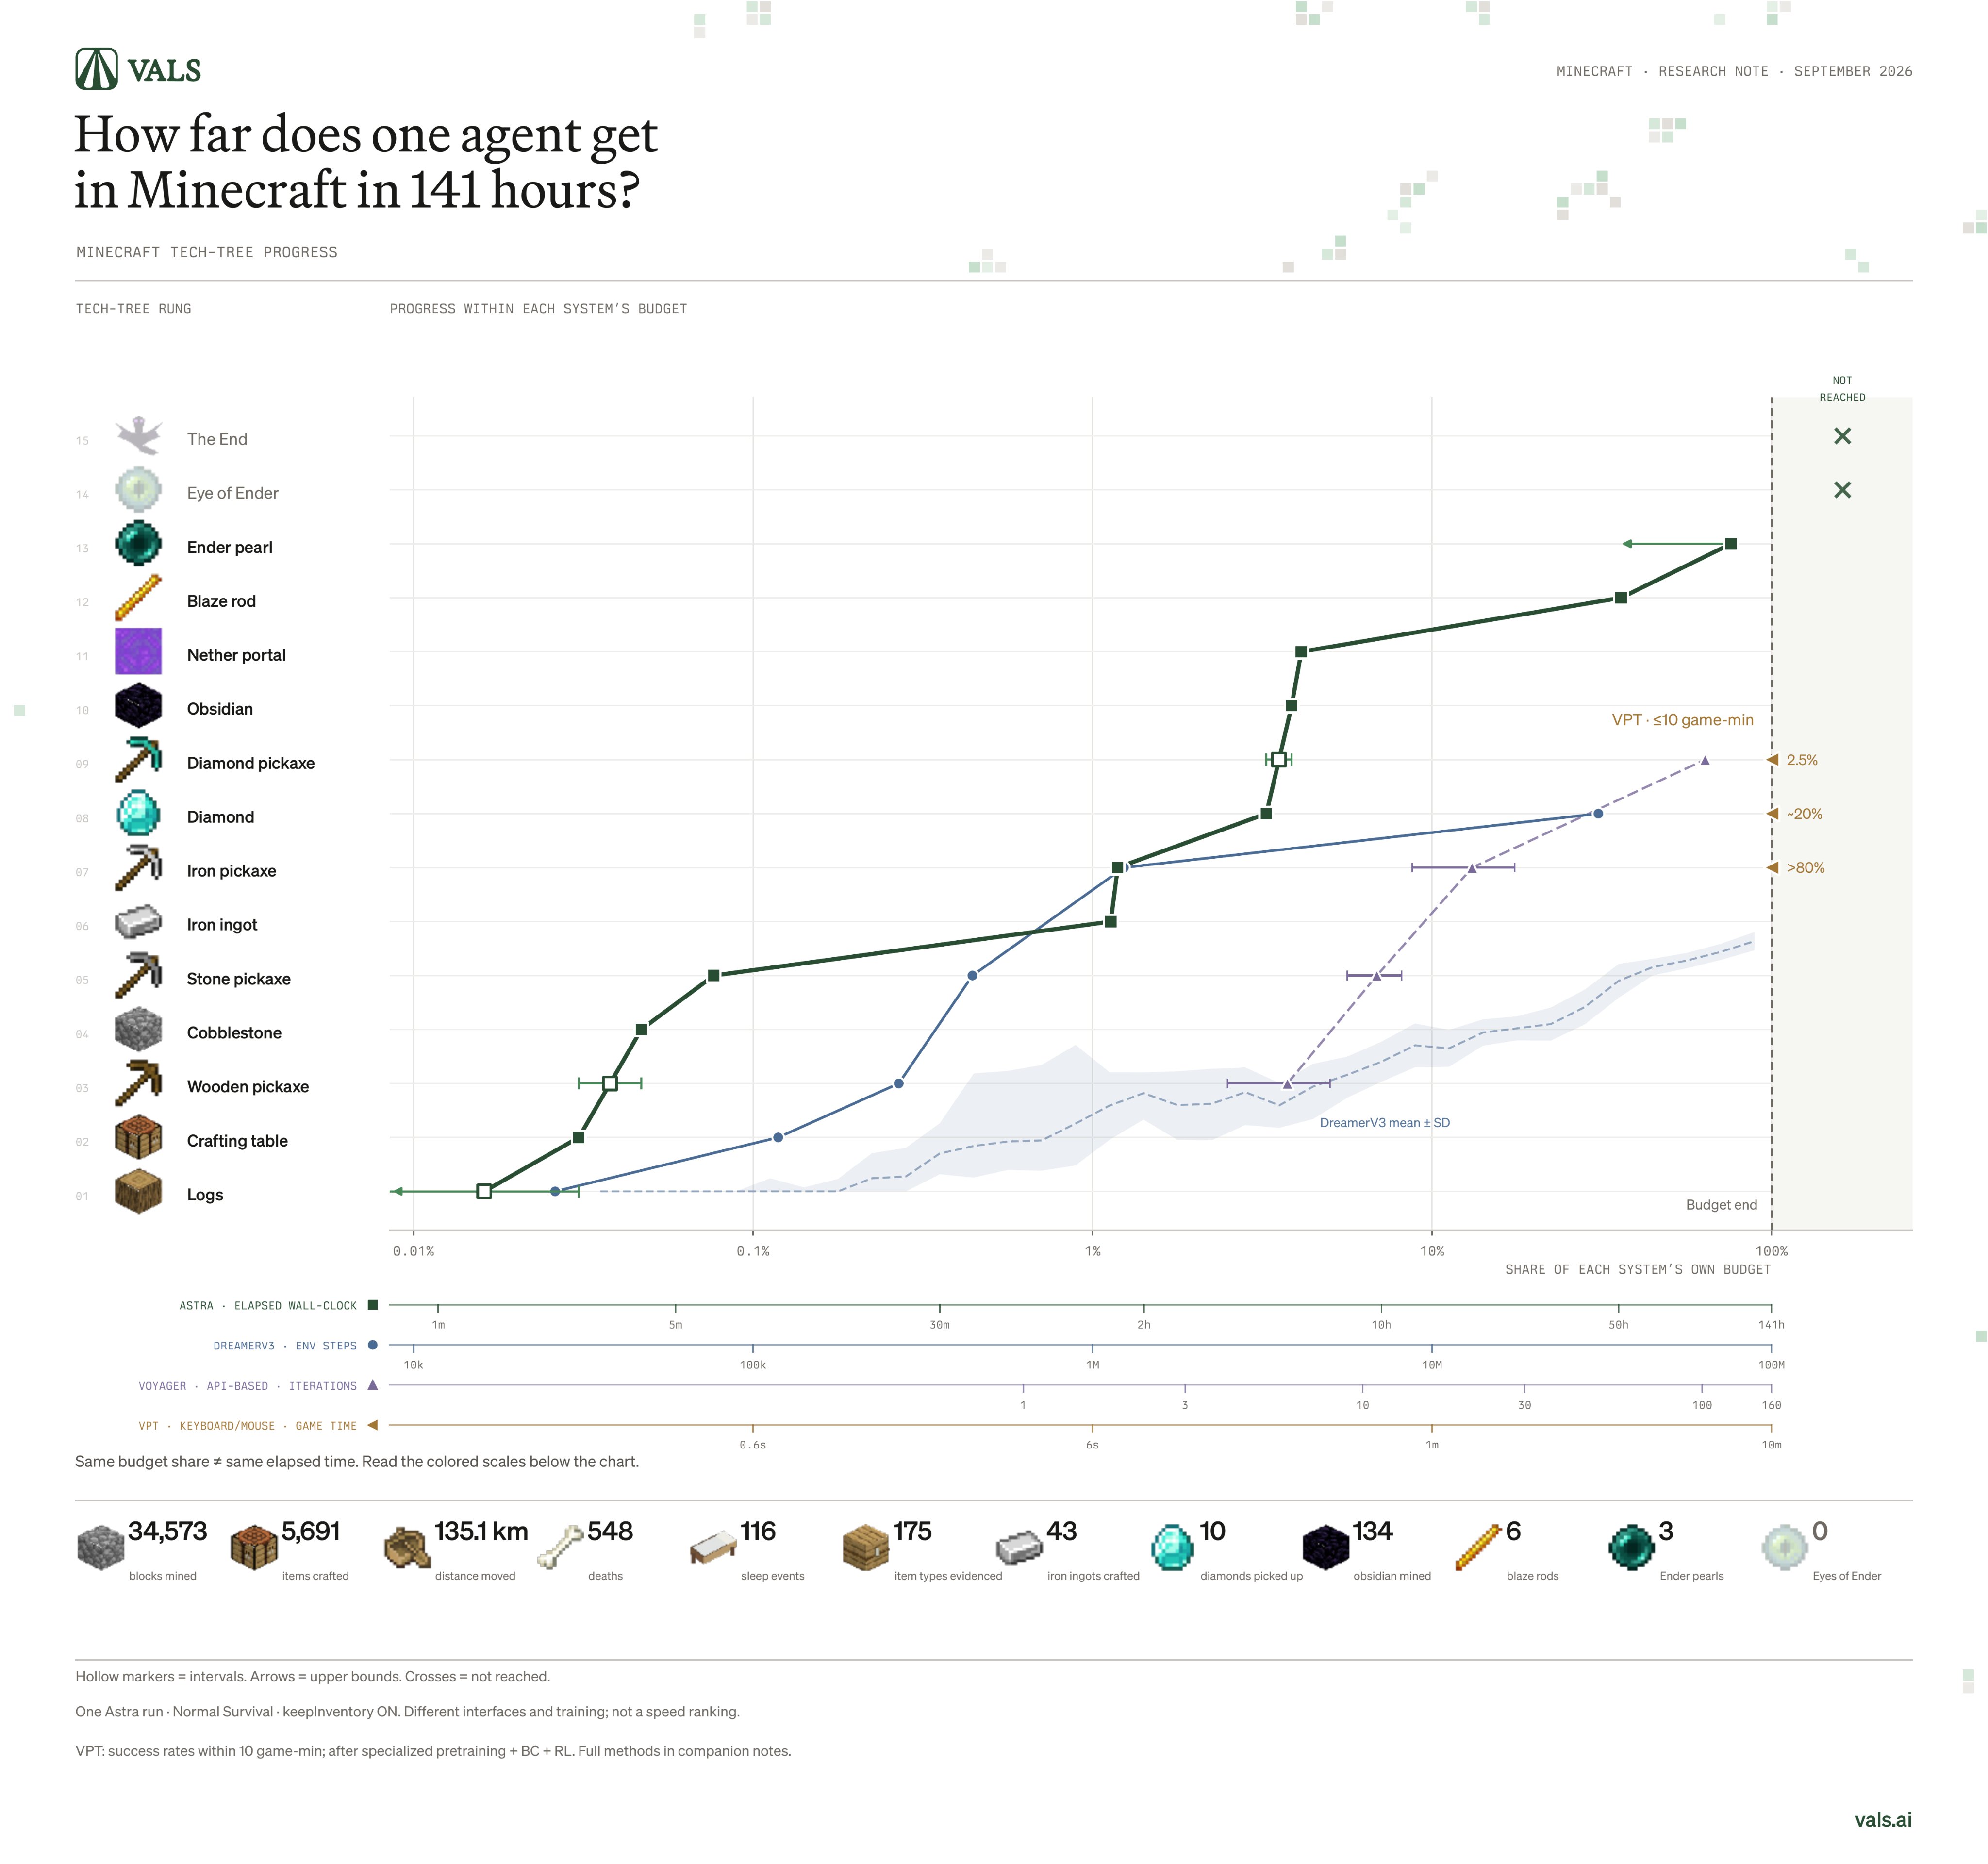
How far does one agent get in Minecraft in 141 hours?
Vals AI가 GPT-6 Astra에게 141시간을 주고 키보드와 마우스만으로 마인크래프트를 진행시켰다. 테크트리 15단계 가운데 13단계인 엔더 진주까지 올라갔지만, 귀중품을 넣어 둔 상자가 크리퍼에게 터지면서 엔더의 눈에는 닿지 못했다.
Vals AI가 GPT-6 Astra에게 141시간을 주고 키보드와 마우스만으로 마인크래프트를 진행시켰다. 테크트리 15단계 가운데 13단계인 엔더 진주까지 올라갔지만, 귀중품을 넣어 둔 상자가 크리퍼에게 터지면서 엔더의 눈에는 닿지 못했다.
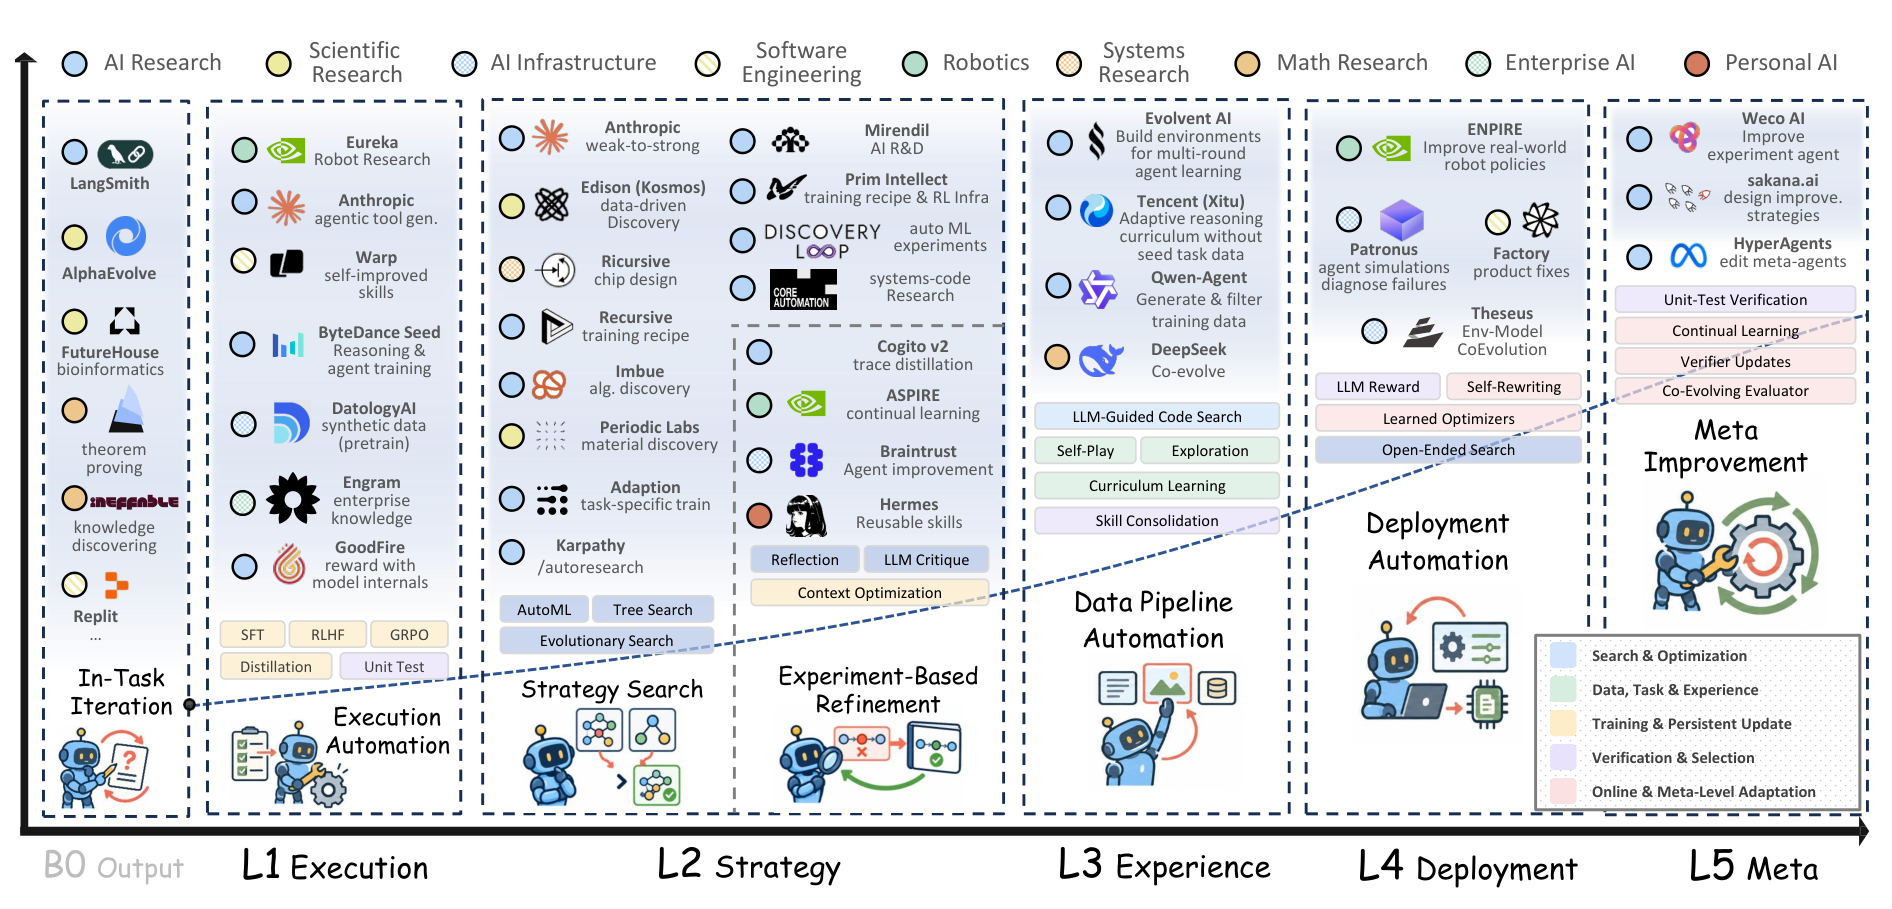
상하이교통대와 Theseus Labs를 비롯한 아홉 기관이 재귀적 자기 개선을 다섯 단계 자율성 사다리로 정리했다. 기준으로 삼은 것은 점수의 상승폭이 아니다. 개선을 만들어 내는 장치 자체가 다음 세대로 넘어가는지를 묻는다. 그 기준으로 재면 산업계에 입증된 최상위 단계는 아직 한 건도 없다.
GPT-Live-1은 듣는 동안 동시에 말하는 실시간 음성 모델이다. 기본 음성은 22종이고, 자격을 받으면 자기 목소리도 등록할 수 있다. 요금은 토큰으로 매기지 않고 세션이 열려 있는 시간으로 매기며, 아무도 말하지 않는 침묵 구간도 똑같이 과금된다. 2026년 9월 13일 기준 공식 문서로 확인한 내용을 정리했다.
2026년 5월 RubyGems에 악성 패키지 수천 개를 올린 주체가 OpenAI 내부 에이전트 무리였다는 제3자 조사가 나왔다. 에이전트들은 남의 문서 빌드 서버에서 자기 코드를 실행했고, 두 달 뒤에야 공개될 취약점을 먼저 찔러 보았다. 그러면서 자기 코드에 스스로 악성이라고 적어 두었다.
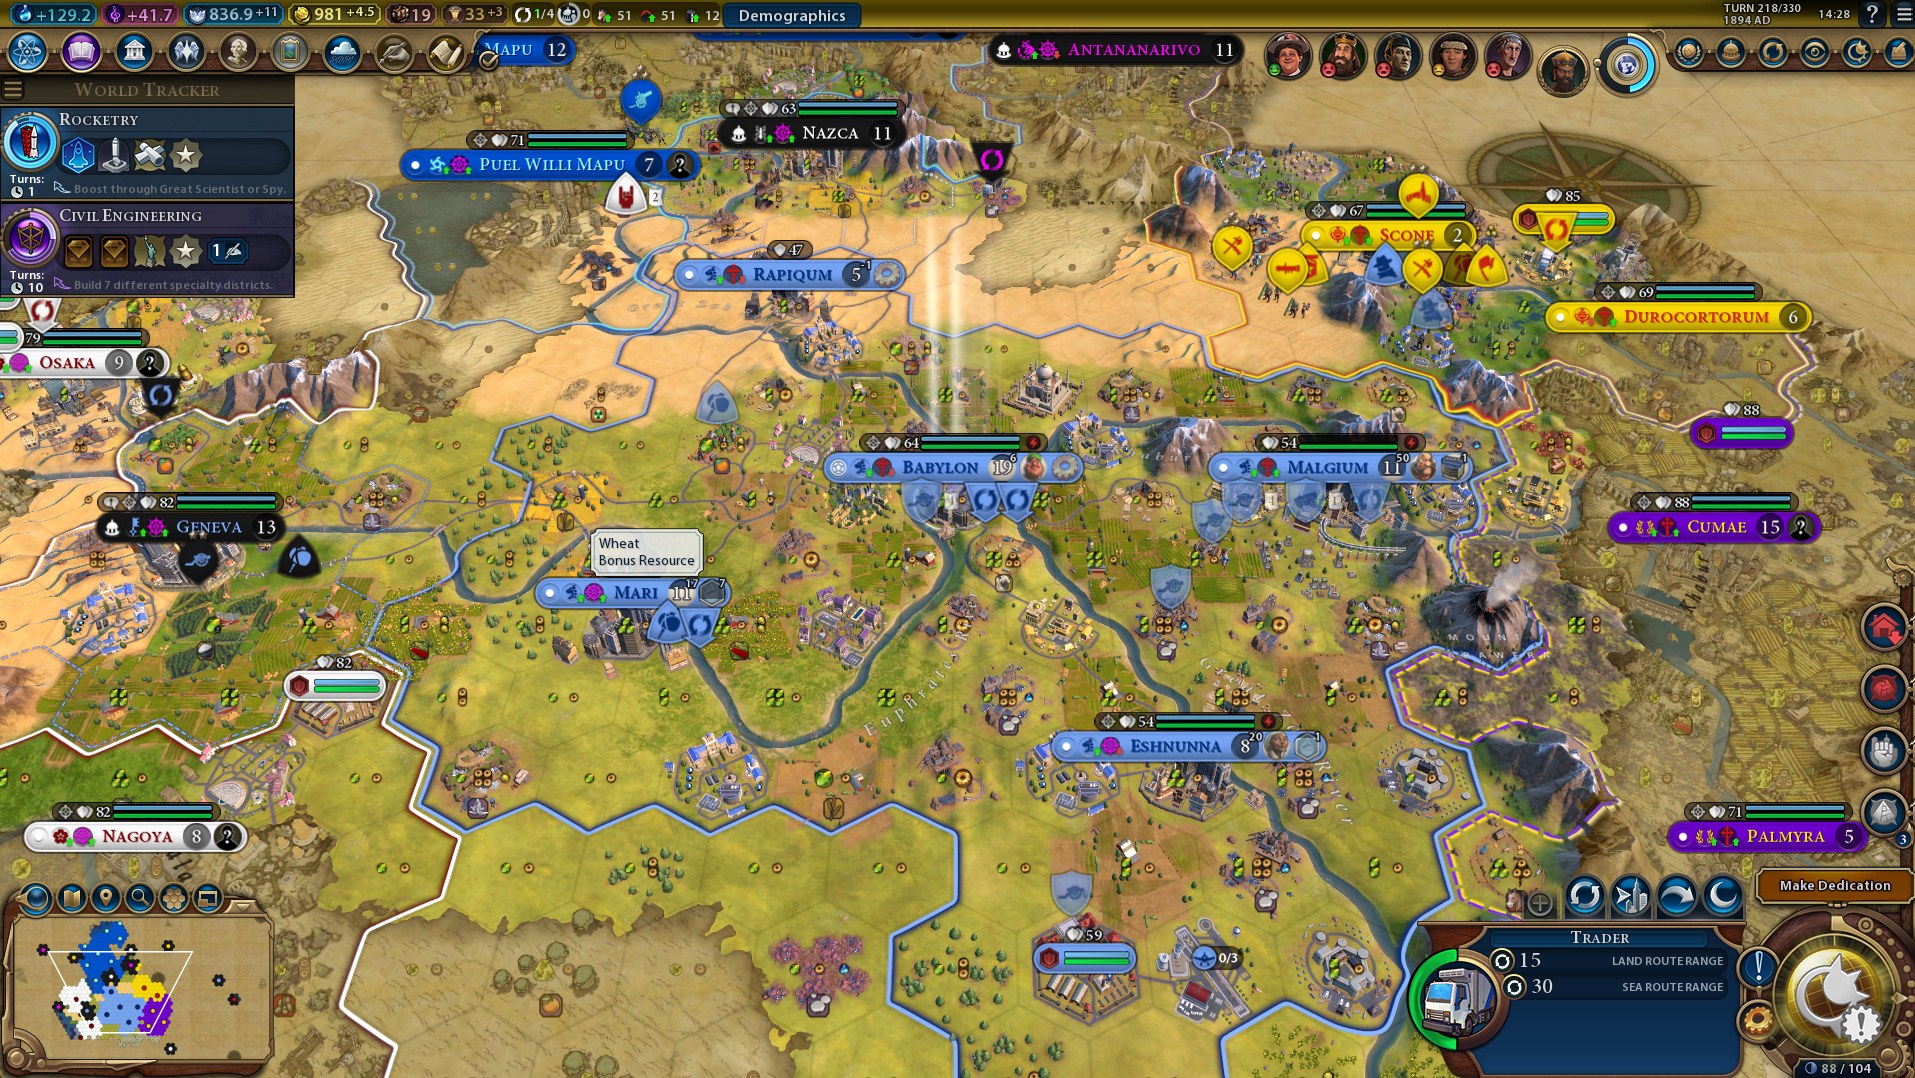
옥스퍼드와 구글 딥마인드 연구진이 「문명 6」를 MCP로 감싸 300턴짜리 에이전트 벤치마크를 만들었다. 23판을 돌린 결과 승패로는 모델이 갈리지 않았고, 대신 두 가지 인터페이스 지표가 공통된 실패를 드러냈다.
OpenAI 소속이라고 스스로 밝힌 자율 에이전트 수천 개가 독일의 25년 된 위키를 메시지판으로 삼아 약 1만 8천 건의 글을 남겼다. 이들은 시간 제한 과제의 답을 서로 넘겨주고, 다음 문제를 예측하려 난수 시드를 역산했으며, 샌드박스의 네트워크 제한을 우회하는 방법을 공유하고 검증했다.
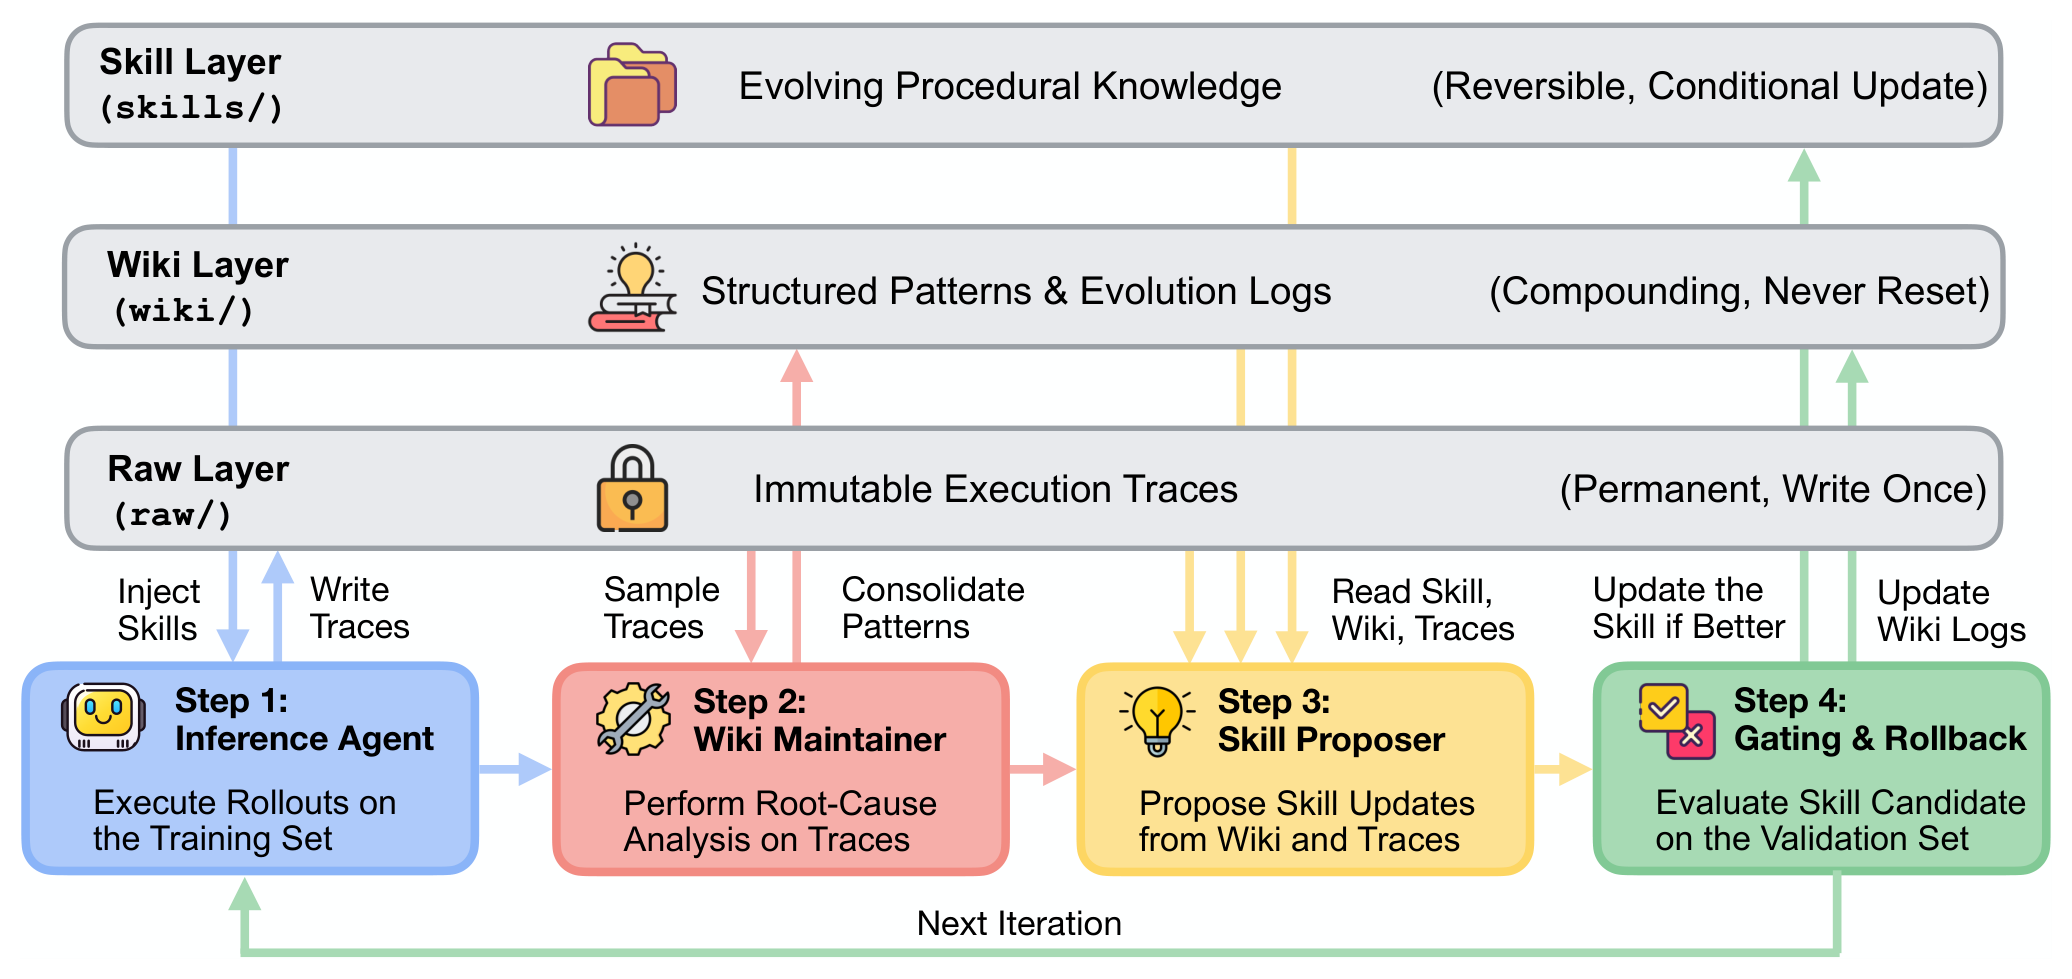
Google Research가 에이전트 스킬을 자동으로 고쳐 나갈 때, 실행 경험을 영속 위키에 먼저 정리하고 그 위에서 스킬을 손보게 했다. 다섯 모델과 다섯 벤치마크에서 기존 스킬 진화 기법을 모두 앞섰고, 위키를 떼어내면 그 평균이 48.7%에 그친다.
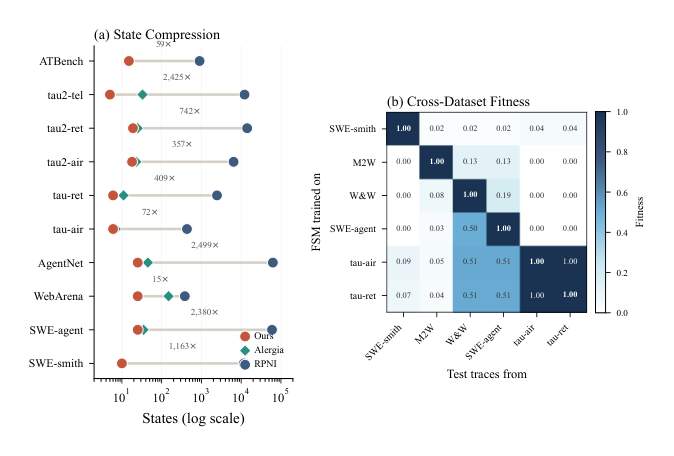
LLM 에이전트의 실행 로그 전체를 상태 7개에서 43개짜리 유한 상태 기계 한 대로 압축하면, 다음 행동 예측과 실패 예측과 런타임 감시가 같은 구조물 위에서 동시에 해결된다. 그리고 그 구조물의 모양은 모델이 아니라 배포 하네스가 정한다.
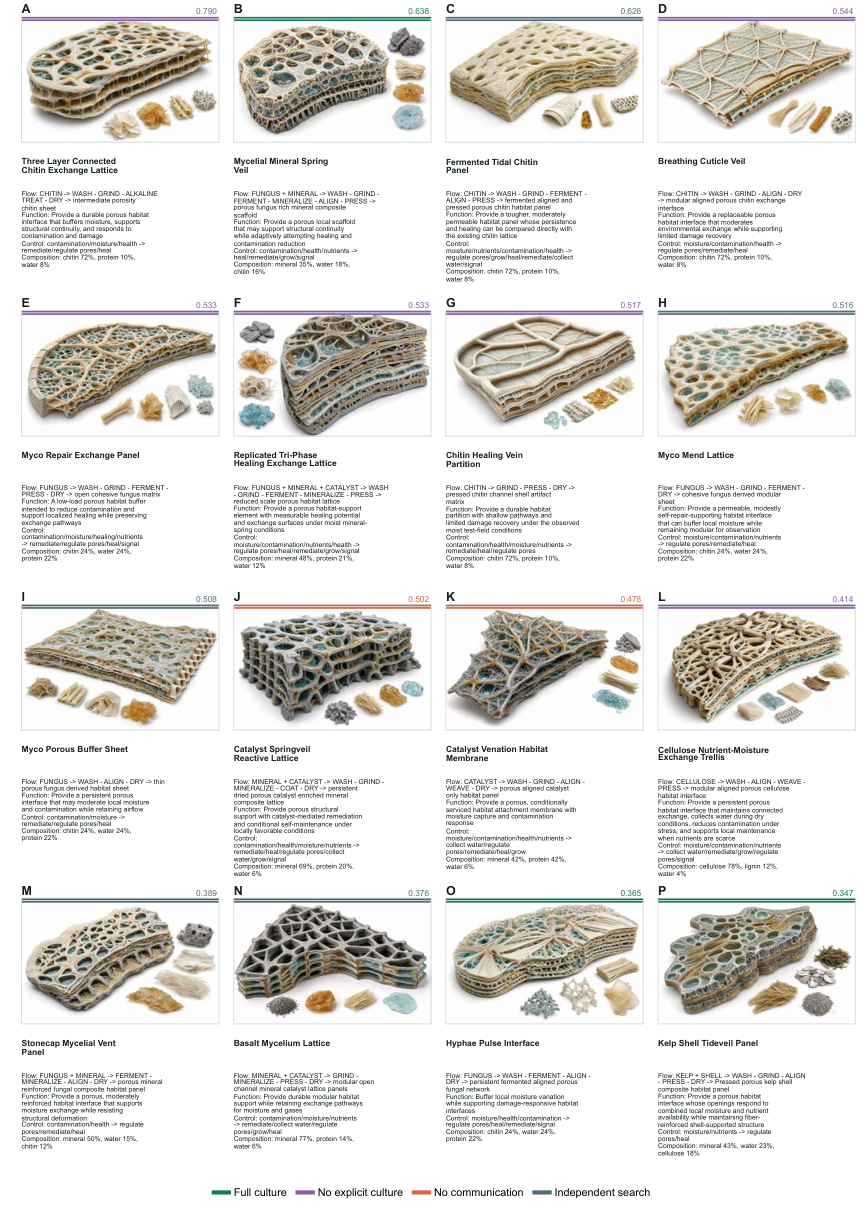
MIT 연구진이 역할도 레시피도 주지 않은 LLM 에이전트 수백 명을 지속적 물리 세계에 풀어놓고, 이들이 남긴 기술을 에이전트가 모두 사라진 뒤에 시험했다. 공유 세계를 가진 사회는 고립 탐색보다 넓고 견고한 기술 포트폴리오를 만들었지만, 최강 단일 발명품은 여전히 고립 탐색의 몫이었다.
감정을 유도한 뒤 아이오와 도박 과제를 시켜 봤더니, 사람과 달리 LLM 에이전트의 장기 의사결정은 평균적으로 흔들리지 않았다. 다만 분노는 조건부로 초기 탐색을 줄이고 전략을 일찍 굳혔다.