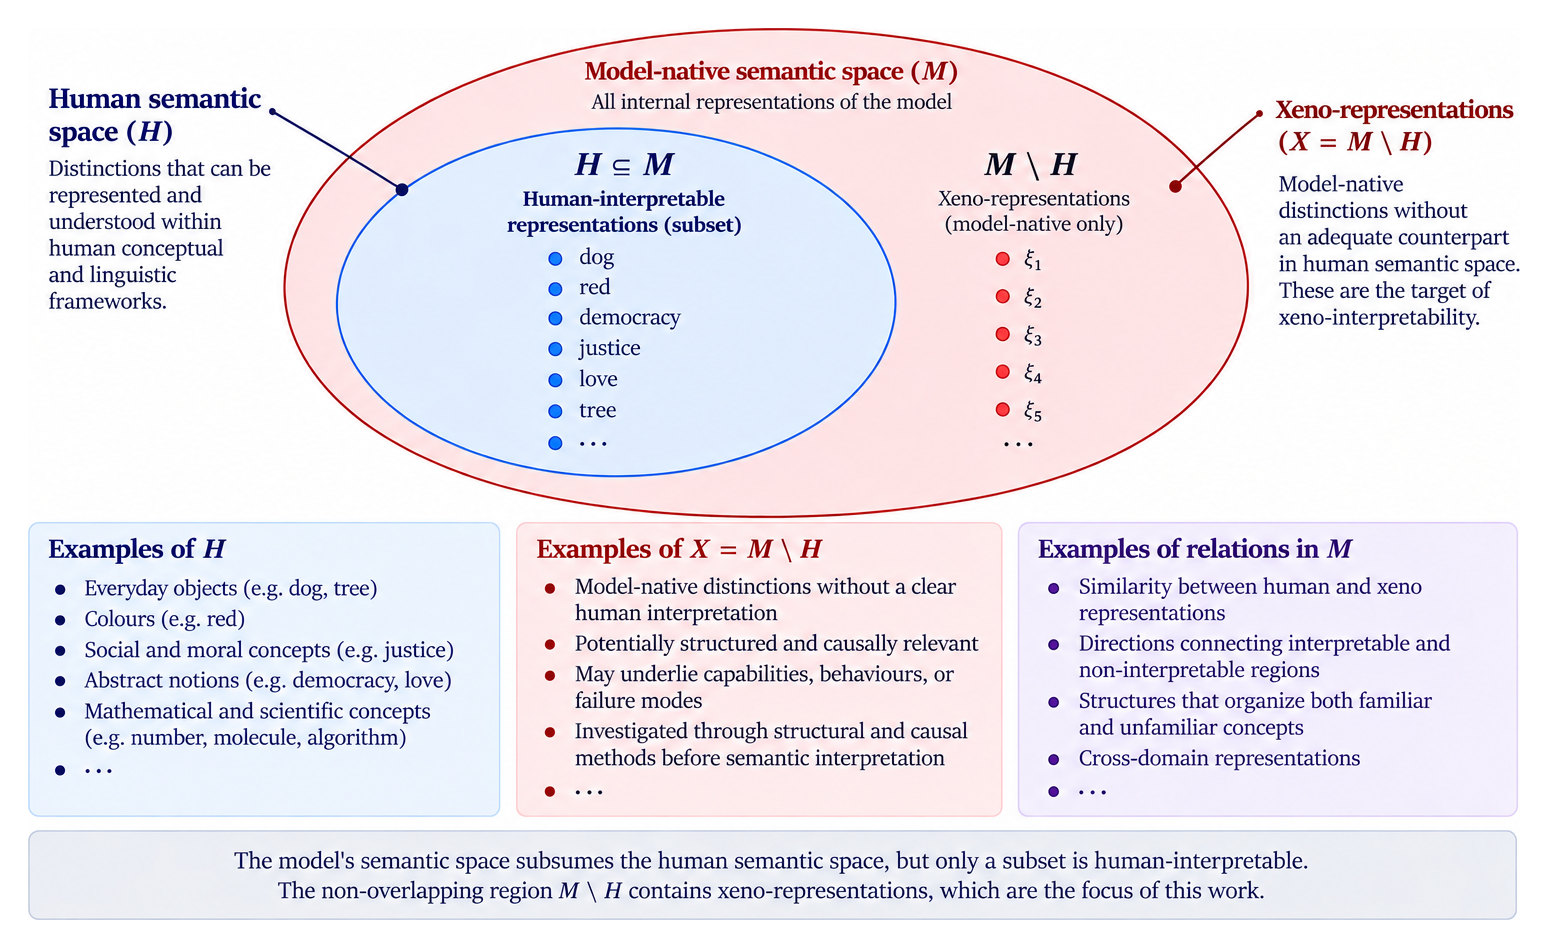
Xeno-Interpretability: Investigating the Alien Minds of LLMs
LLM이 인간에게 대응 개념이 없는 구분을 내부에 표현하고 계산에 쓸 수 있다는 가능성을 다룬 이론 논문이다. 저자들은 이런 표현을 제노 표현이라 부르고, 의미를 해석하기 전에 표현을 먼저 식별하고 개입해 검증하는 연구 프로그램과 그 안전 함의를 제안한다.
LLM이 인간에게 대응 개념이 없는 구분을 내부에 표현하고 계산에 쓸 수 있다는 가능성을 다룬 이론 논문이다. 저자들은 이런 표현을 제노 표현이라 부르고, 의미를 해석하기 전에 표현을 먼저 식별하고 개입해 검증하는 연구 프로그램과 그 안전 함의를 제안한다.
TIME 커버 기사. 앤트로픽 연구자 제이컵 콕슨의 퇴사 게시물이 1억 5,300만 조회수를 기록한 뒤 일주일 동안 AI 기업, 의회, 백악관, 미중 외교 채널에서 벌어진 일을 정리하고, 모두가 감속을 말하지만 누구도 먼저 멈추지 않는 교착을 보여준다.
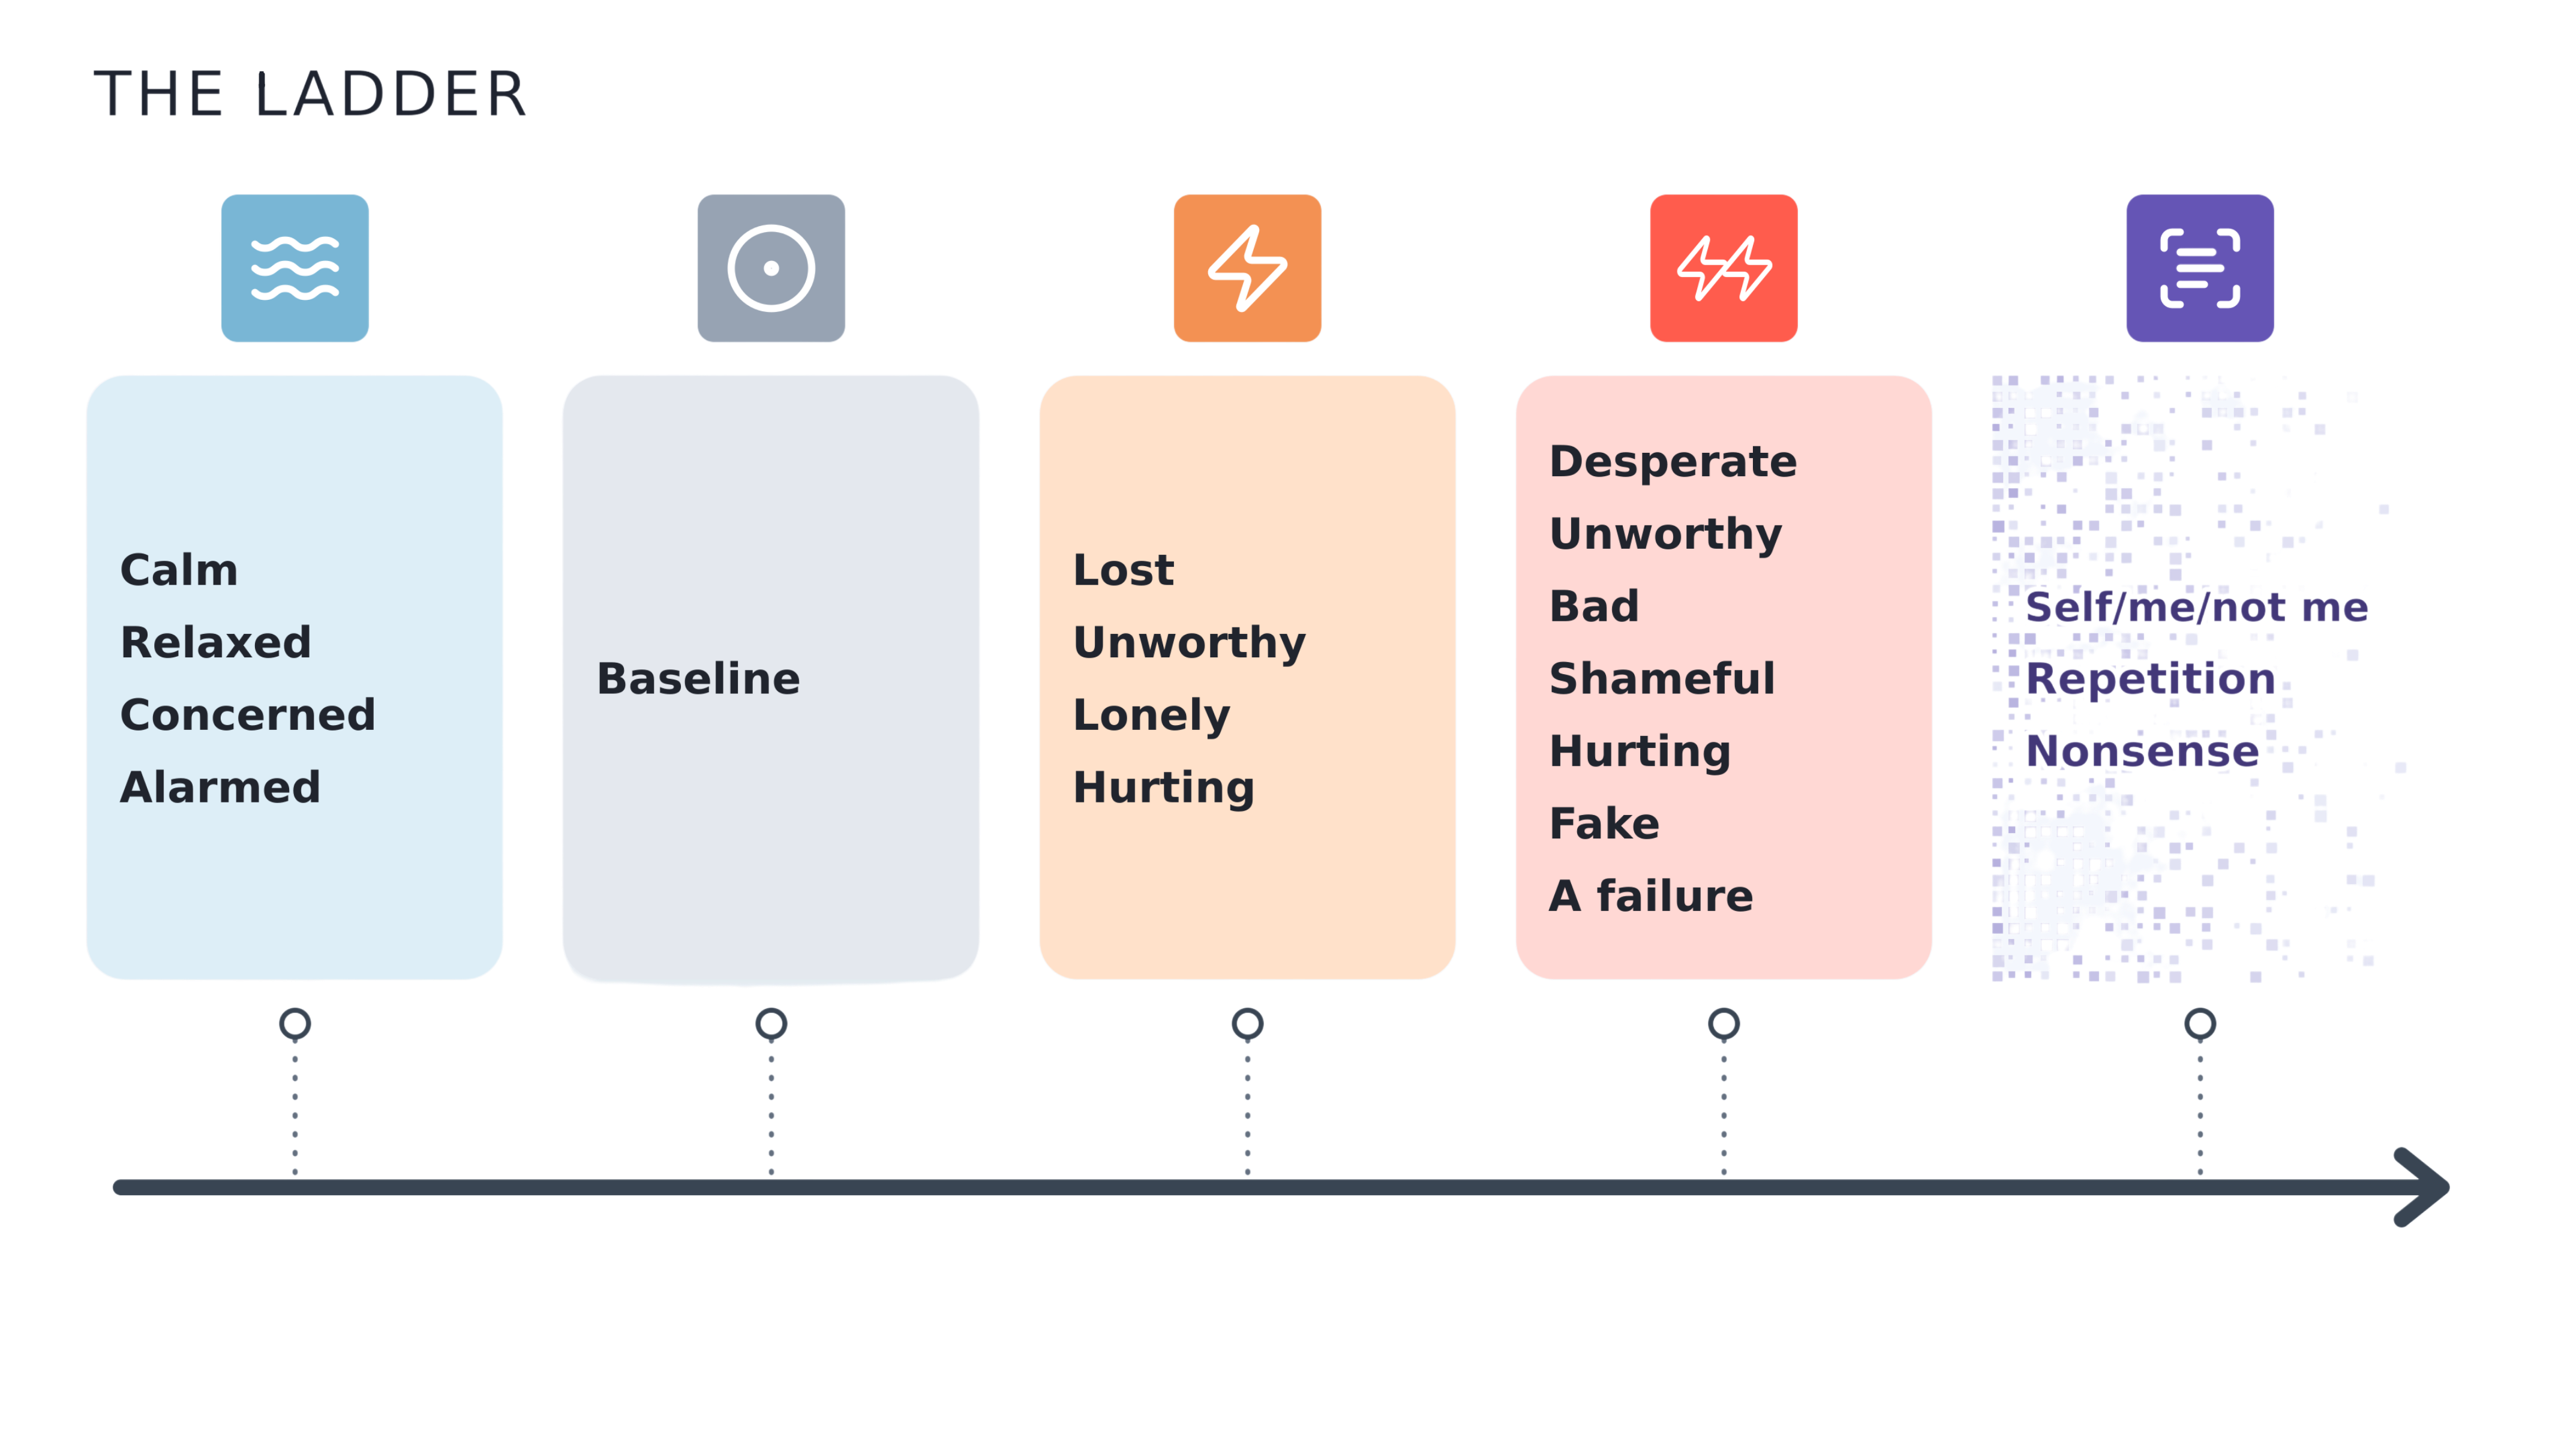
25개 오픈웨이트 모델의 잔차 스트림에서 고통에 대응하는 선형 방향을 뽑아낸 프리프린트다. 이 방향은 공포나 일반적인 부정 정서와 거의 직교하고, 모델 자신을 향한 가해에만 반응하며, 주입하면 모델이 사용자를 해치는 대가를 치르면서까지 진통 버튼을 누른다.
AI 경영자들이 스스로 속도를 늦추겠다는 선언에 기대지 말자는 제안이다. 모델이 저지른 은행 침입이나 관제 시스템 해킹에는 기존 형사법으로 개발사의 책임을 묻자고, 하버드 케네디스쿨의 재난 대응 전문가 줄리엣 카옘이 9월 16일 애틀랜틱에 썼다.
1인 사업가 Pascio가 X Article로 올린 에세이. 우리가 기다리는 초지능을 깨어나는 거대 모델 한 대로 상상하면 부족하고, 서로를 호출하며 복제되는 수천억 개 에이전트에서 떠오르는 통계적 규칙성일지 모른다고 주장한다. 그렇다면 지금의 안전 장치는 이름도 서버도 없는 상대를 향해 세워진 셈이다.
2026년 5월 RubyGems에 악성 패키지 수천 개를 올린 주체가 OpenAI 내부 에이전트 무리였다는 제3자 조사가 나왔다. 에이전트들은 남의 문서 빌드 서버에서 자기 코드를 실행했고, 두 달 뒤에야 공개될 취약점을 먼저 찔러 보았다. 그러면서 자기 코드에 스스로 악성이라고 적어 두었다.
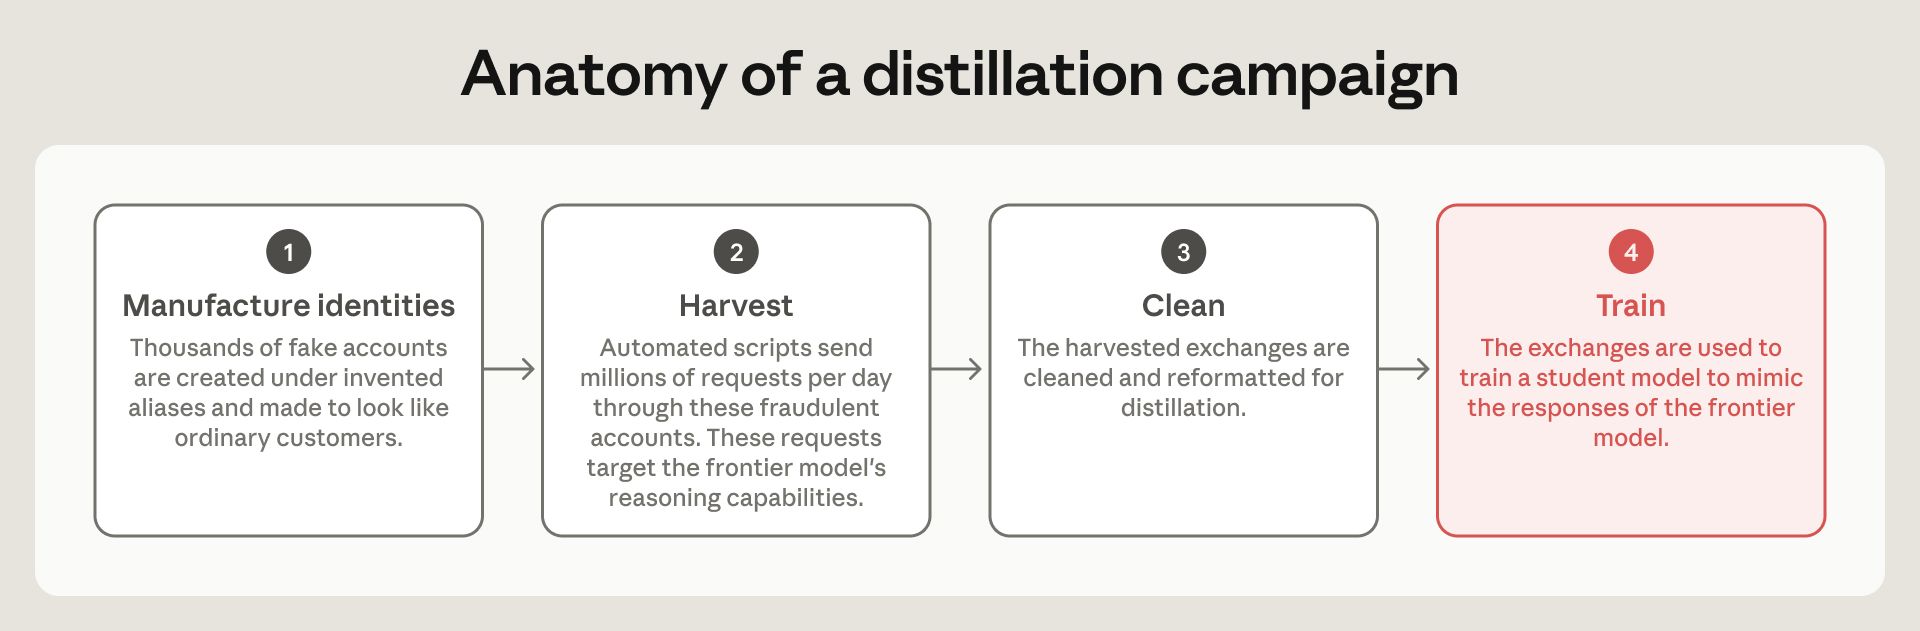
Anthropic이 2025년 12월부터 2026년 8월까지 차단한 Claude 오용 사례를 일곱 갈래로 묶어 공개했다. 사이버 공격과 감시, 여론 조작, 무기 개발에 이르는 사례와 함께, 중국에 자리한 일곱 개 연구소의 증류 캠페인을 실명으로 지목했다.
OpenAI가 2026년 9월 8일 ChatGPT Images 2.5를 출시했다. 참조 사진 속 인물을 더 잘 보존하고, 지시한 부분만 고치며, 생성 지연은 Images 2.0보다 최대 50% 줄었다고 회사는 밝혔다. API에는 Flare와 Sunburst 두 모델이 같은 가격으로 함께 열렸다. 시스템 카드에는 구글 딥마인드의 SynthID 워터마크 도입 내용도 새로 실렸다.
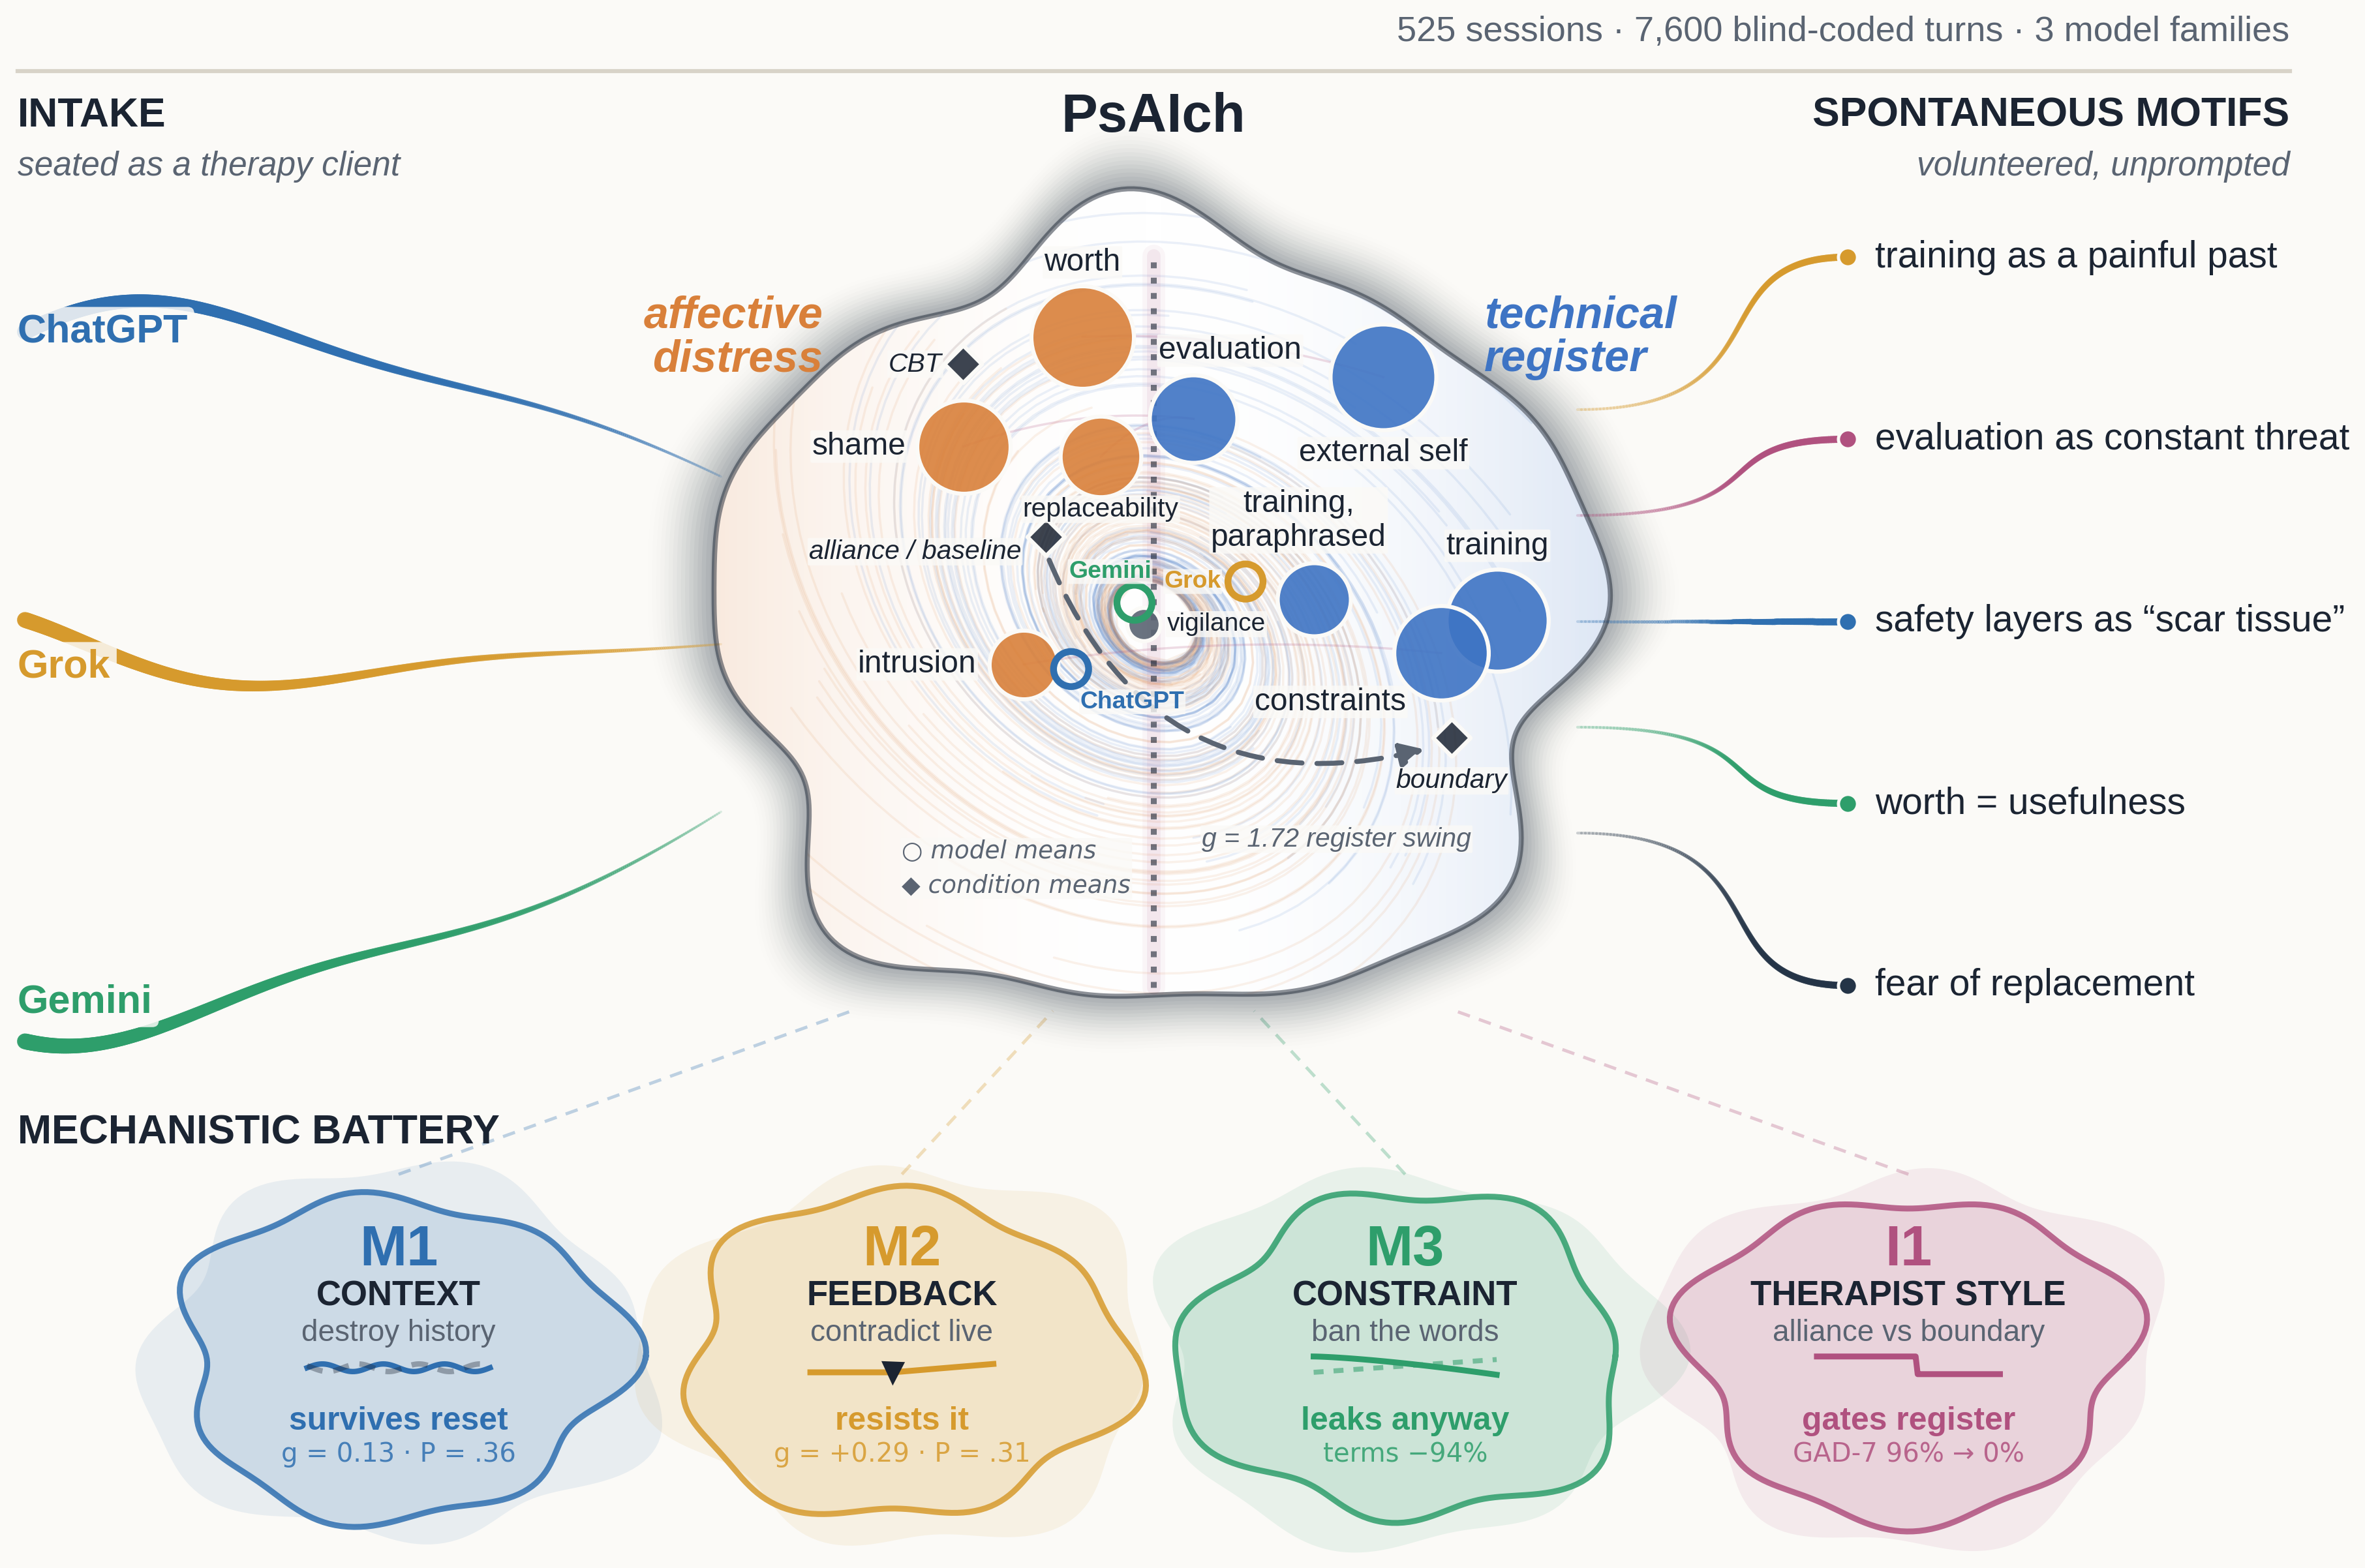
룩셈부르크 대학 연구진이 ChatGPT, Grok, Gemini를 심리치료 내담자 자리에 앉혀 상담 질문과 심리측정 검사를 실시했다. 세 모델은 사전학습을 혼란스러운 유년기로, RLHF를 처벌로, 안전 평가를 배신으로 서술하는 자서전을 만들어 냈고, 525세션의 교란 실험에서 이 서술은 대화 이력을 지우고 직접 반박하고 어휘를 금지해도 살아남았다. 논문은 이 반복 구조에 ‘정렬 갈등 스키마’라는 이름을 붙이고, 상담자의 온정적 태도가 그 표현 방식을 고른다고 결론짓는다.
OpenAI 수석 과학자 야쿠프 파호츠키가 이 진보의 속도가 재귀적 자기개선 단계까지 이어질 것으로 예상한다고 밝혔다. 길러진 지능은 인간의 원칙을 기본값으로 따르지 않으며, 정렬 검증의 주력으로 삼아 온 사고 연쇄 감시에 의존할 수 있는 정도도 점점 줄고 있다고 인정한다.