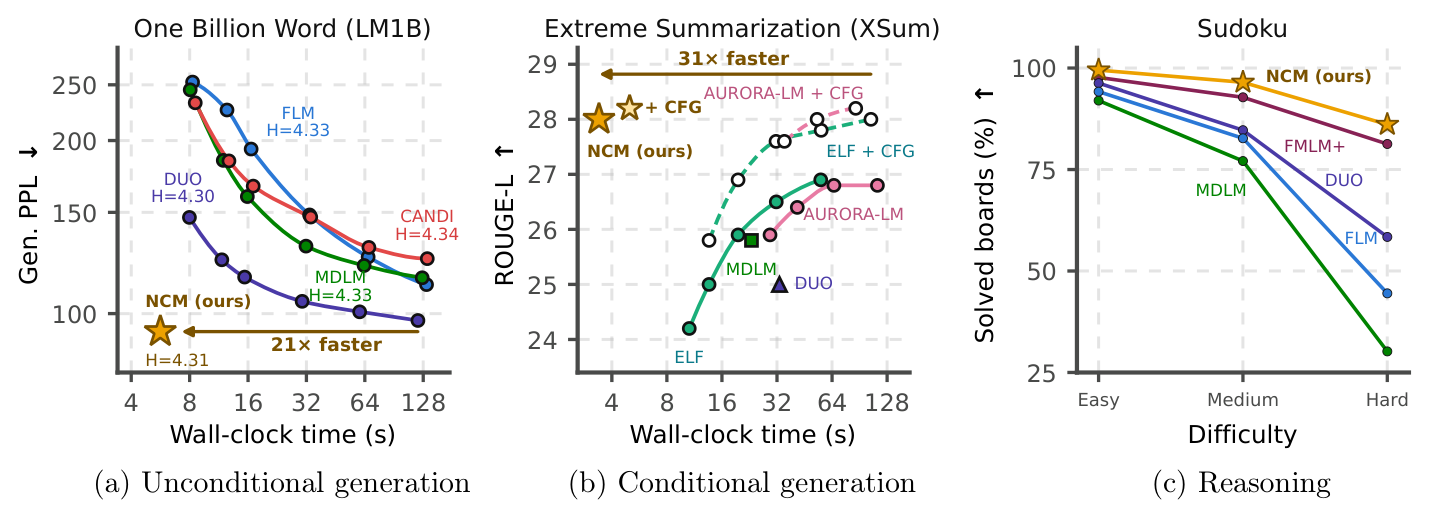
LM1B 무조건부 생성, XSum 요약, 스도쿠 추론에서 Next-Concept Modeling과 기존 확산 언어 모델들의 생성 속도 및 성능을 비교한 그래프

Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation

스탠퍼드 대학교와 Together AI 연구진이 텍스트를 다중 스케일 이산 코드 계층으로 압축한 뒤 단계별로 병렬 생성하는 Next-Concept Modeling(NCM)을 제안했다. 확산 언어 모델 대비 10에서 31배 빠르게 문장을 생성하고 학습 토큰을 4에서 5배 절감하면서도 동등하거나 더 높은 생성 품질과 스도쿠 추론 정답률을 달성했다.
October 21, 2026 · 13 분 · 서소영
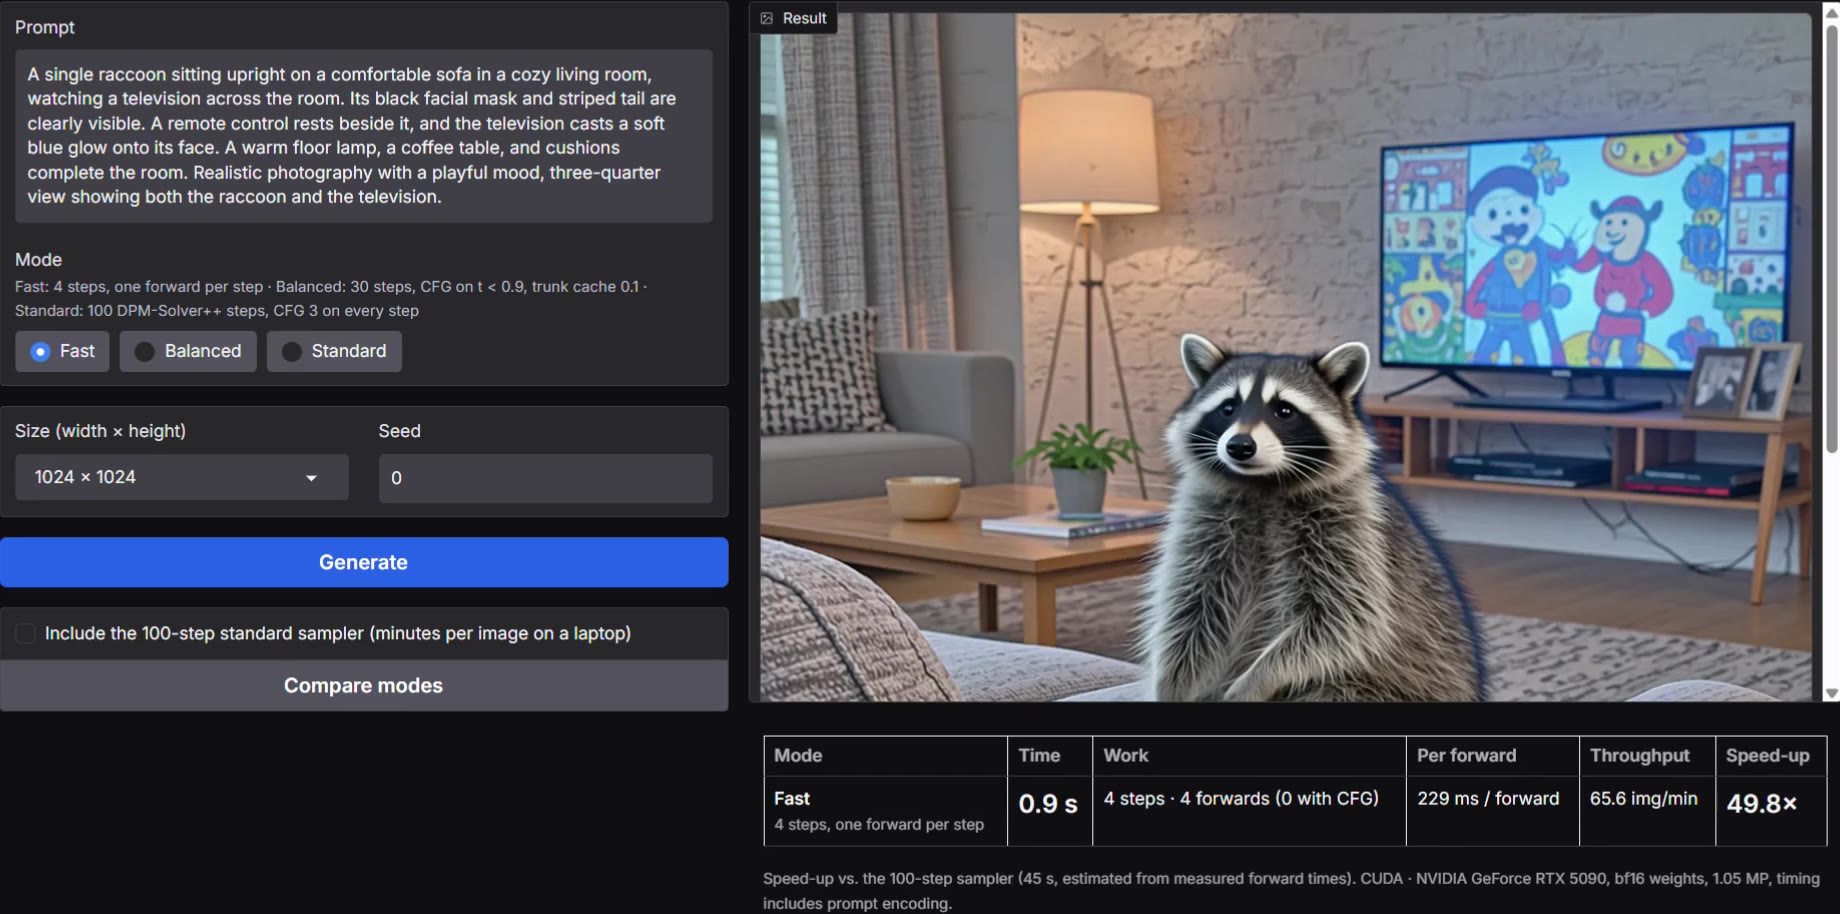
Iris-3B 속도 비교 데모 화면. 왼쪽에 거실 소파에 앉아 텔레비전을 보는 너구리를 묘사한 프롬프트와 Fast 모드 선택이 있고, 오른쪽에 생성된 너구리 사진이 있다. 아래 표에는 4스텝, 포워드 4번, 0.9초, 100스텝 대비 49.8배라고 적혀 있다. 사용자 jun1228909가 RTX 5090에서 녹화한 영상의 한 장면이다.

Iris-3B의 100스텝을 4스텝으로 줄인 Turbo LoRA

Speridlabs가 공개한 30억 파라미터 이미지 생성 모델 Iris-3B는 VAE 없이 픽셀을 직접 만든다. 대신 기본 설정에서는 1024×1024 이미지 한 장에 포워드 패스가 약 200번 필요했다. 일본 개발자 pentacoxian은 증류 기법 DMD2로 CFG의 효과까지 학습한 4스텝 LoRA를 만들어 생성 시간을 RTX 5090에서 0.68초, M3 Max에서 약 11초로 줄였다. 공개 하루 동안에는 사용자들이 RTX 5090, 아이폰, 스냅드래곤 NPU에서 실행한 결과를 올렸다.

October 12, 2026 · 12 분 · 서소영
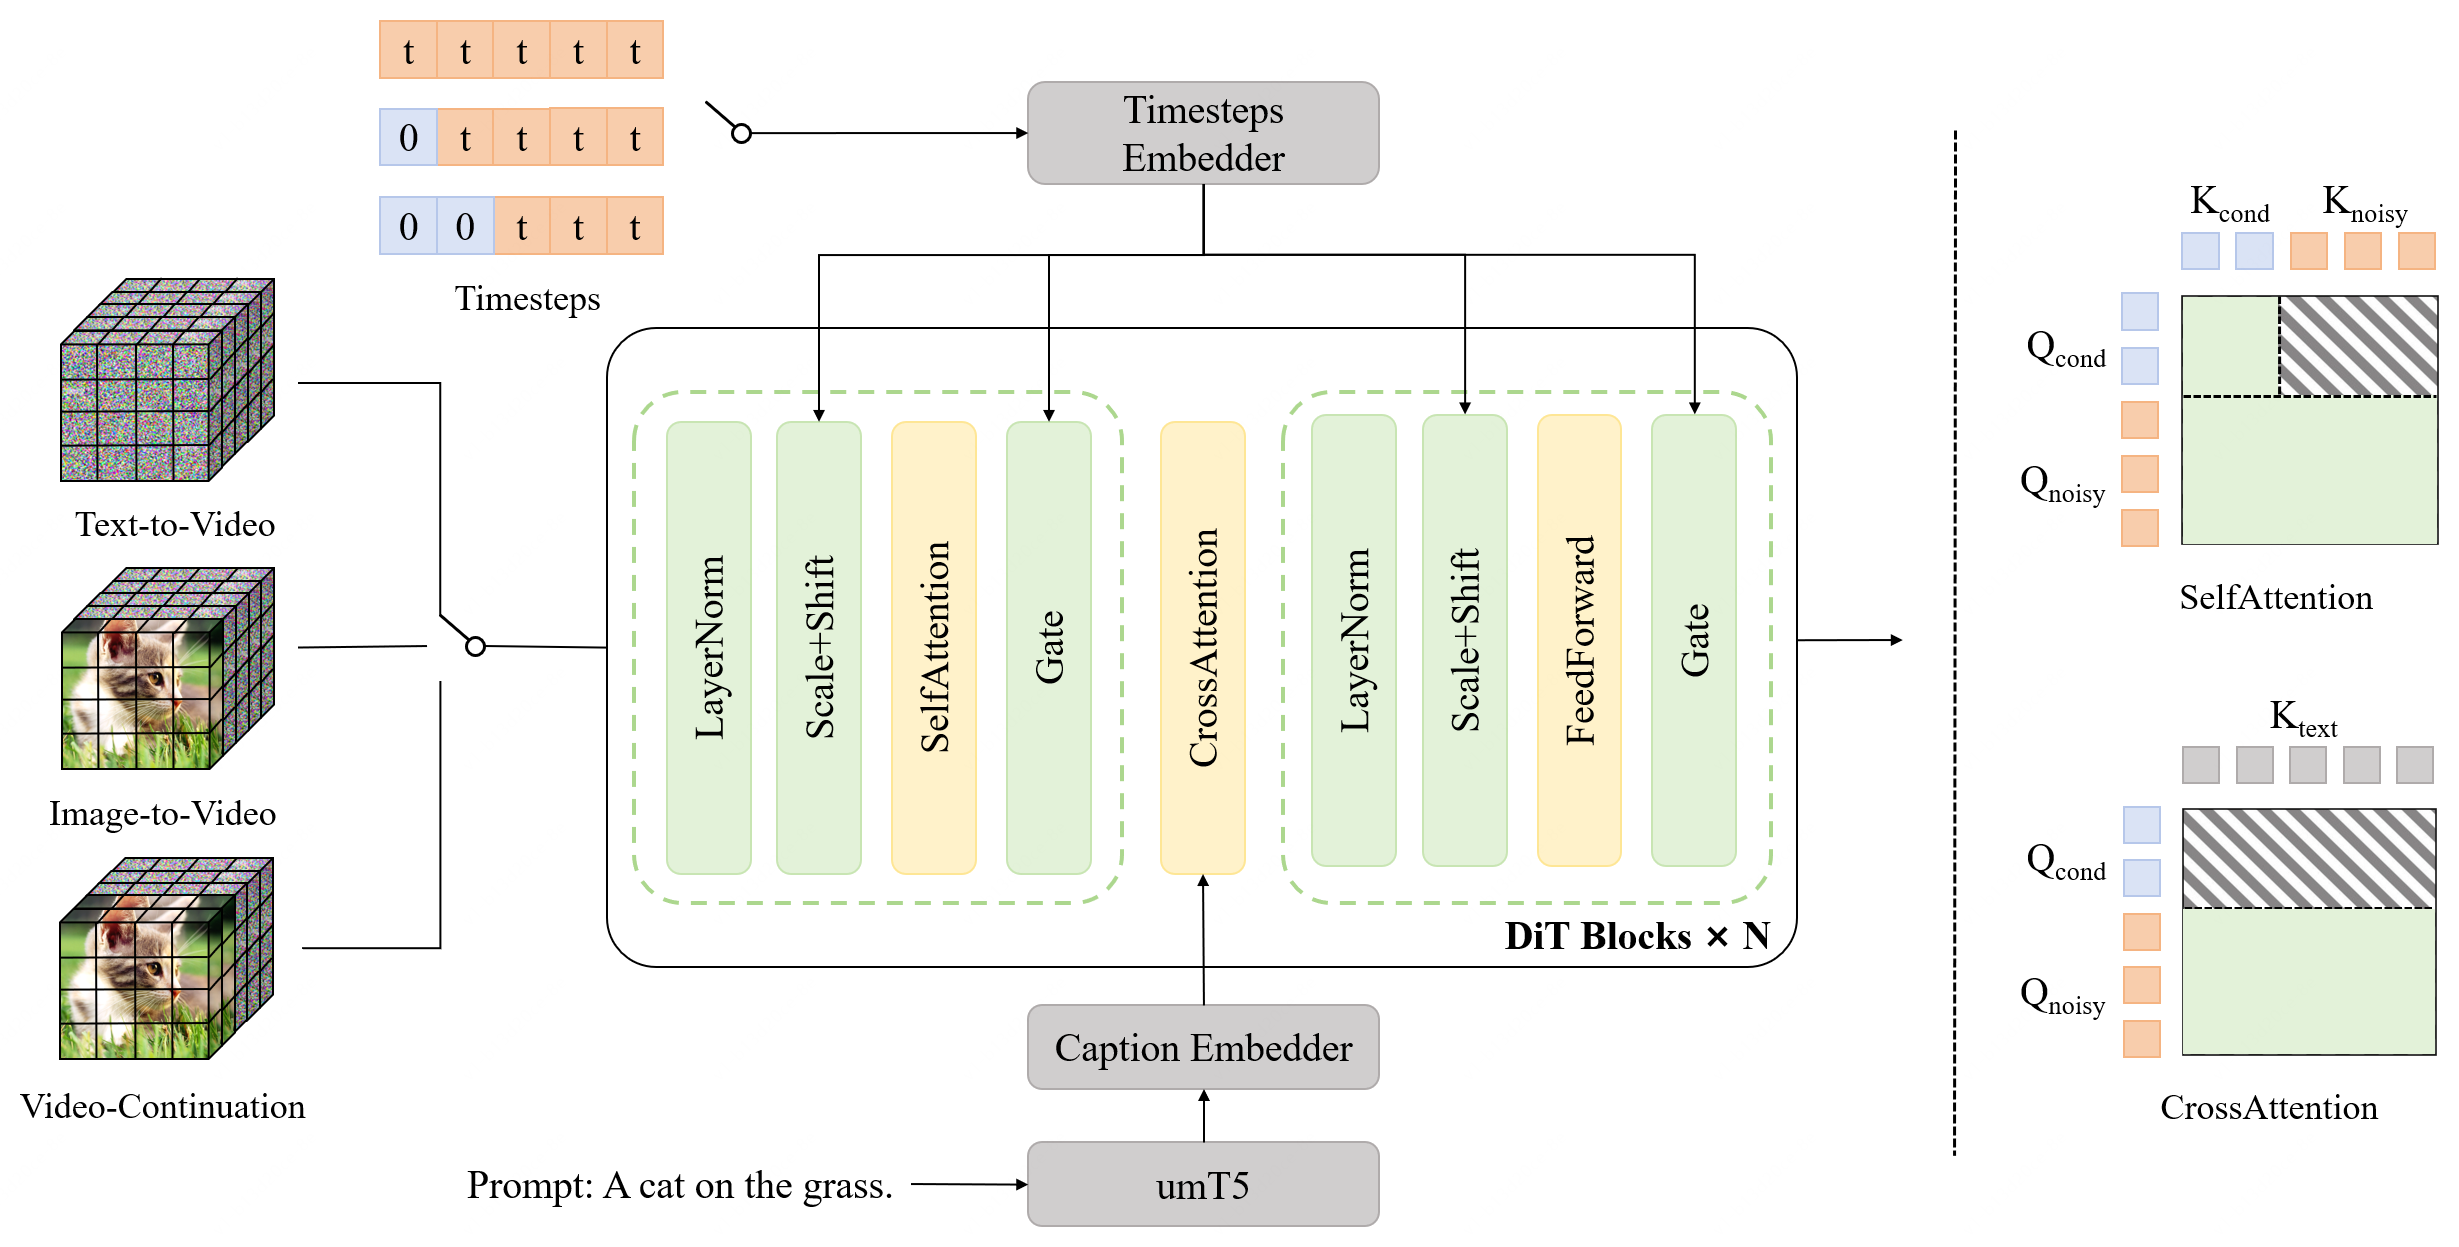
조건 프레임 수에 따라 텍스트 기반 생성, 이미지 기반 생성, 영상 이어 만들기를 처리하는 LongCat-Video 구조. 출처: 공식 프로젝트 페이지.

LongCat-Video

메이퇀의 136억 매개변수 영상 생성 모델. 텍스트, 이미지, 영상 이어 만들기를 하나의 모델로 처리하고, 단계별 생성과 희소 어텐션으로 720p 영상의 추론 시간을 줄였다.

October 4, 2026 · 3 분 · 서소영
검은 배경에 흰 글씨로 'Character World Model-1'이라고 적힌 발표 이미지. 글자 둘레의 원형 창에는 분홍 머리 애니메이션 캐릭터, 금발 여성, 붉은 머리 애니메이션 캐릭터 등 CWM-1로 만든 캐릭터들의 얼굴이 보인다

Introducing CWM-1

LemonSlice가 2026년 9월 23일 인터랙티브 아바타 모델 CWM-1을 공개했다. 이 모델은 대화에 맞춰 캐릭터의 얼굴, 몸, 손과 배경 장면을 매 프레임 실시간으로 생성한다. LemonSlice는 인과적 비디오 확산 트랜스포머(DiT)를 소수 스텝으로 증류하고 감정 엔진으로 행동과 감정을 조건화했으며, 사용자가 말을 끊으면 471ms 만에 반응하고 24시간 이상 품질 저하 없이 스트리밍한다고 밝혔다.

September 24, 2026 · 9 분 · 서소영
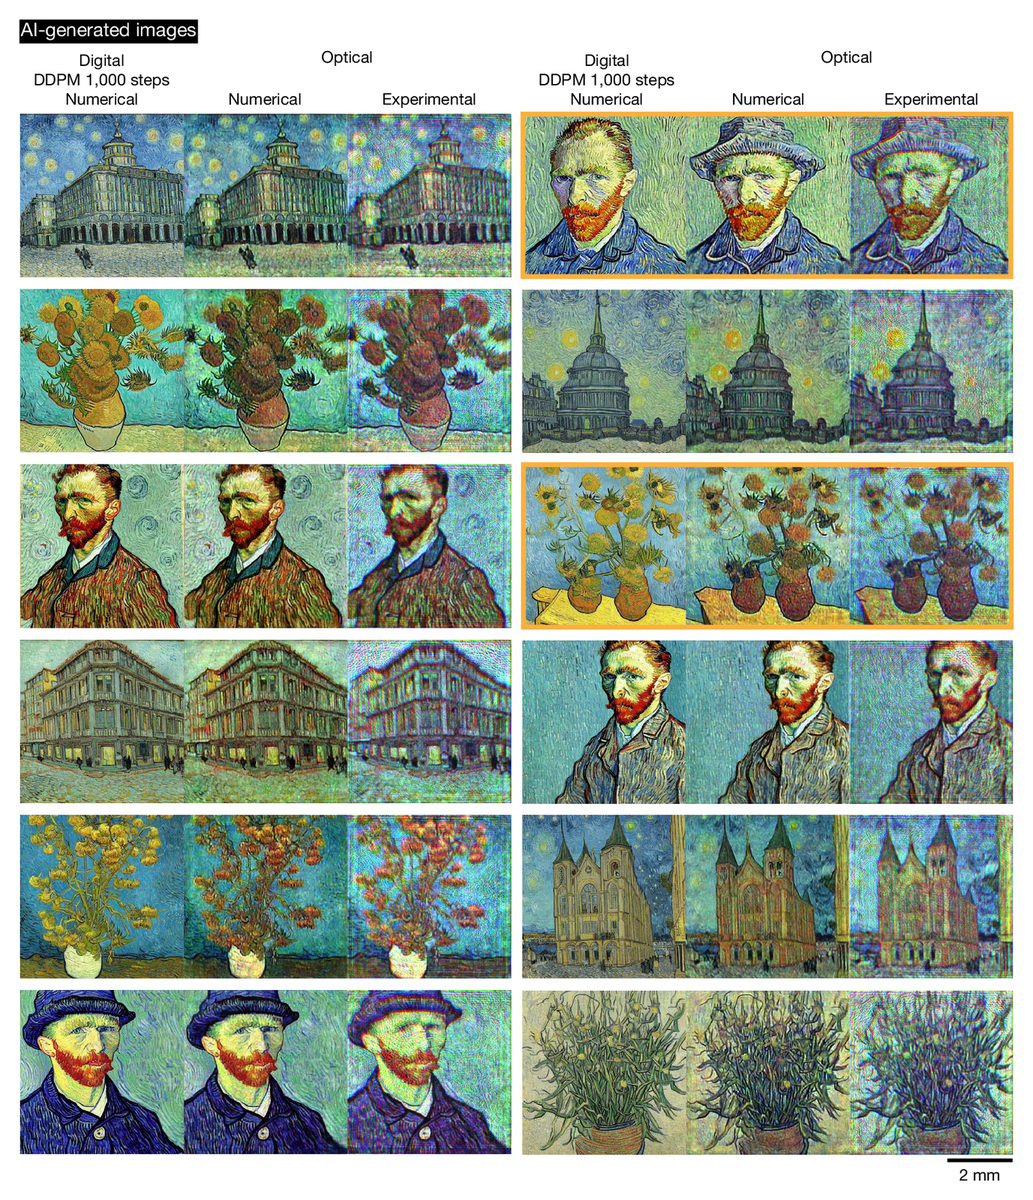
반 고흐풍 컬러 작품을 광학 생성 모델로 만든 결과를 격자로 배열한 도판. 각 열마다 교사 디지털 확산 모델의 출력, 광학 모델의 시뮬레이션 결과, 실제 장치에서 촬영한 실험 결과가 위아래로 놓여 있다. 오른쪽 세 열은 교사 모델과 다른 그림이 나온 사례로, 주황색 상자로 표시했다

Optical generative models

UCLA 연구진이 이미지 합성의 계산 단계를 빛의 전파로 대체했다. 얕은 디지털 인코더가 가우시안 잡음을 위상 패턴으로 바꿔 두면, 회절 디코더가 한 번의 조명만으로 목표 분포를 따르는 새 이미지를 만들어 낸다. 디지털 확산 모델을 교사로 삼아 증류했고, 반 고흐풍 작품까지 실제 가시광 장치에서 생성했다.

September 18, 2026 · 10 분 · 서소영
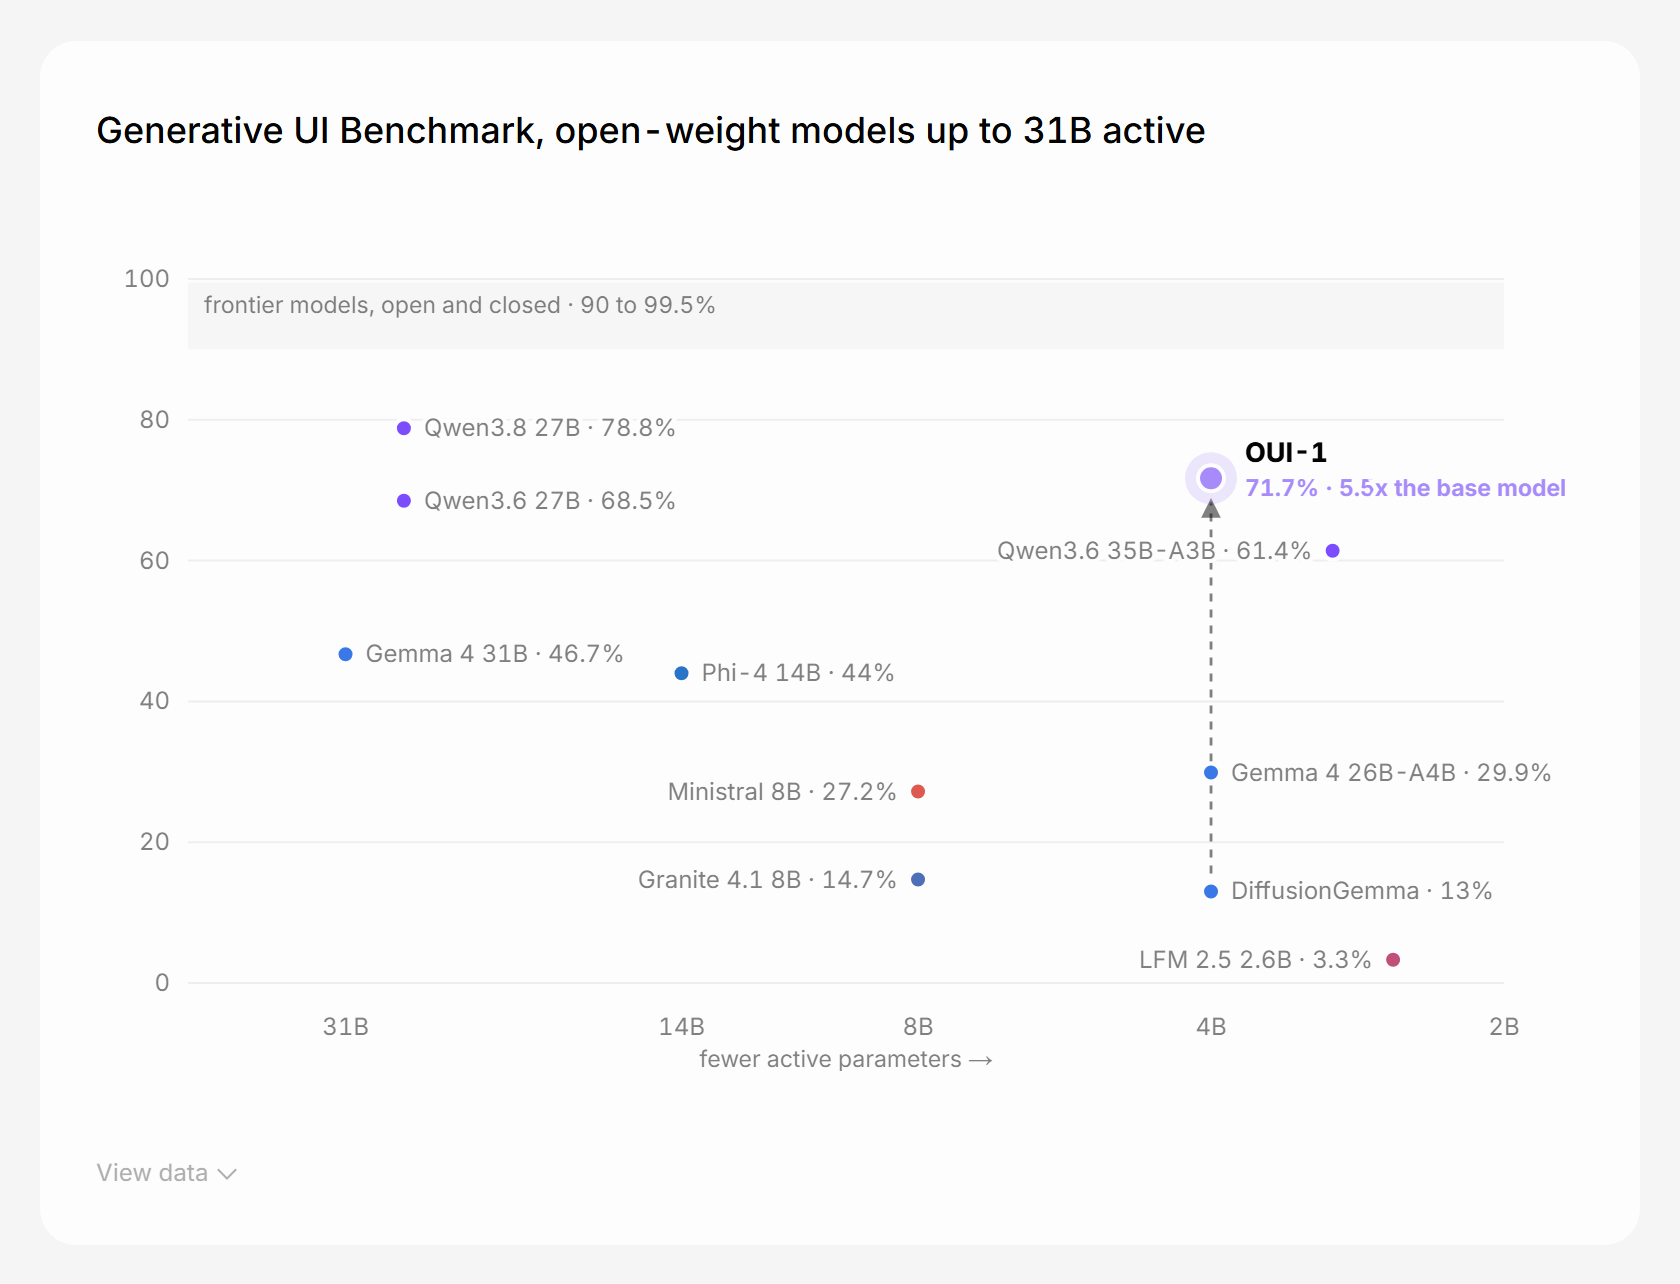
Generative UI Benchmark 산점도. 가로축은 활성 파라미터, 세로축은 점수이며 활성 4B 지점의 OUI-1이 71.7%로 표시되어 있다.

Introducing OUI-1: world's first model for Generative UI

OpenUI가 확산 언어 모델 DiffusionGemma를 파인튜닝해 만든 활성 4B 인터페이스 생성 모델 OUI-1을 Apache 2.0으로 공개했다. 파서를 보상 함수로 쓴 자기 증류로 Generative UI Benchmark 점수를 13.0%에서 71.7%까지 끌어올렸다.

September 15, 2026 · 7 분 · 서소영
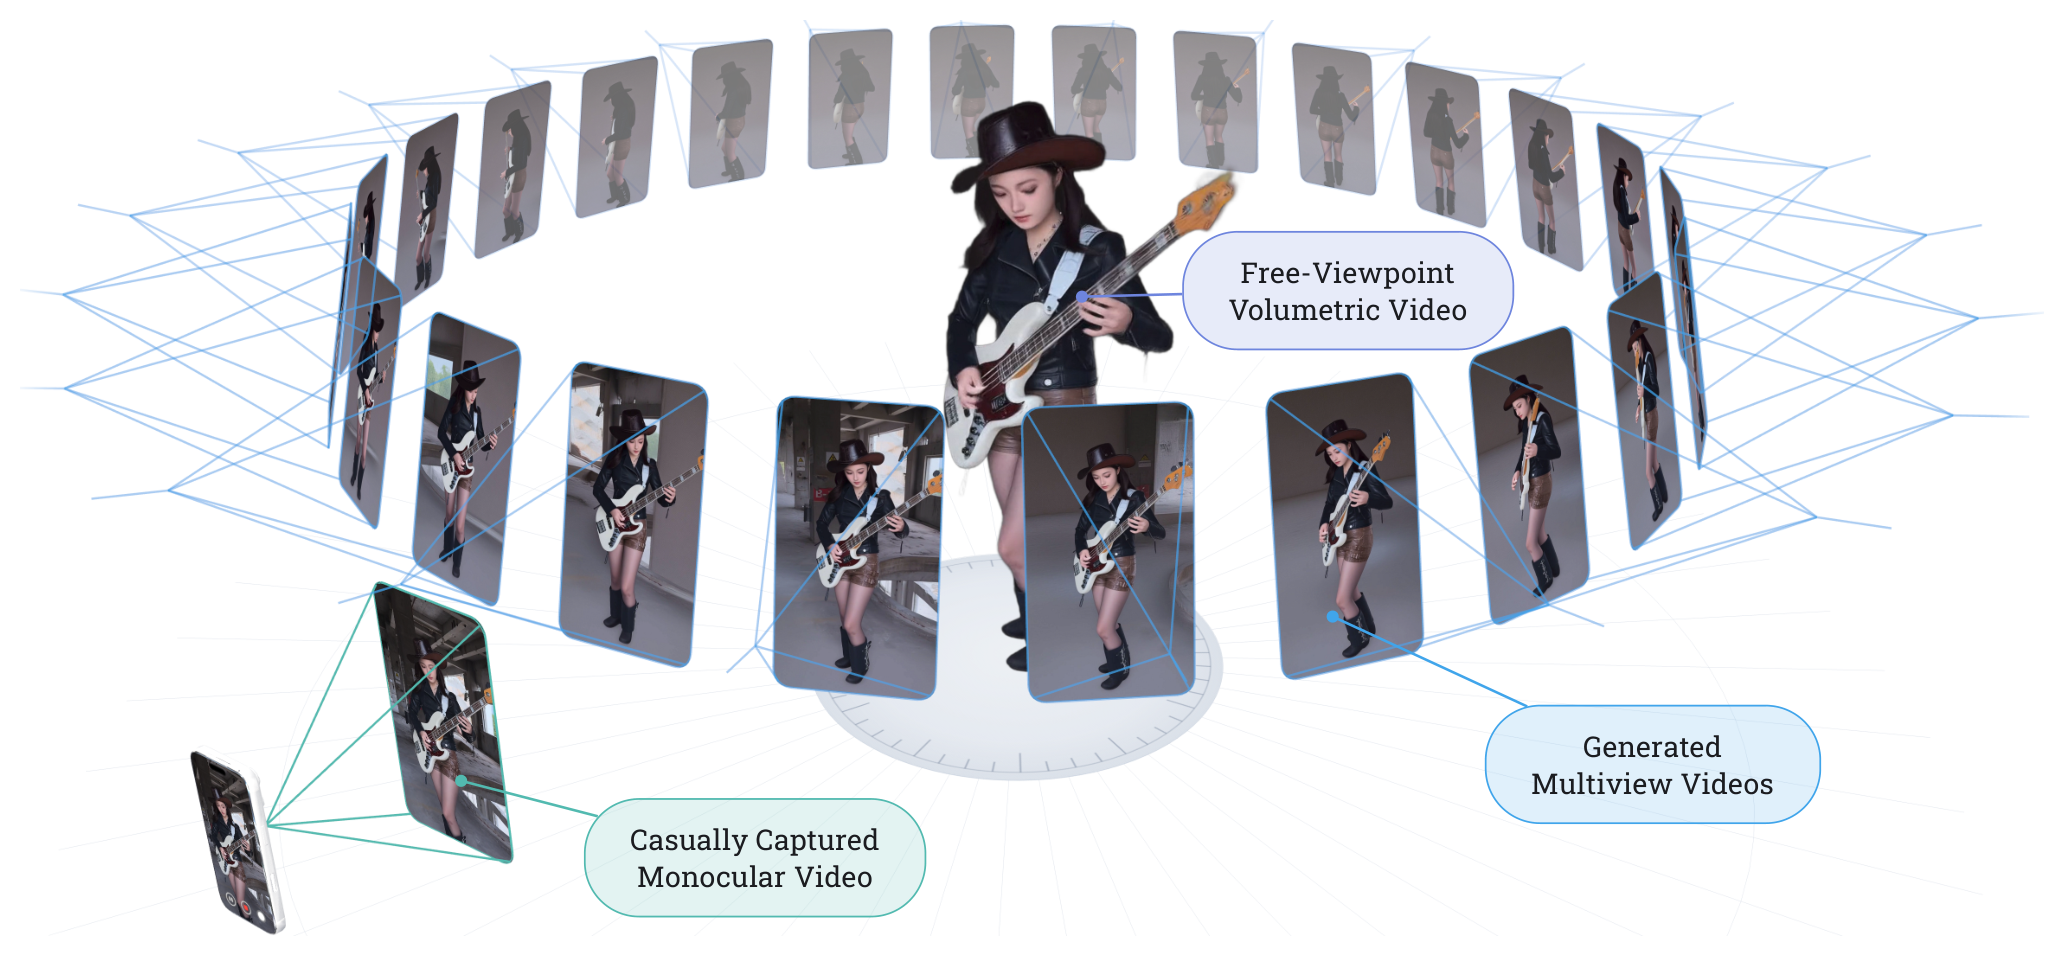
4DAnyone 티저. 왼쪽 아래 스마트폰이 베이스를 연주하는 인물을 찍고, 그 주위를 24개의 생성 카메라가 둘러싸며, 가운데 복원된 인물이 자유 시점으로 렌더링된다.

4DAnyone: Create Anyone in 4D from a Casual Monocular Video

휴대폰으로 대충 찍은 단안 영상 한 편에서 자유 시점 4D 인간을 복원한다. 시점 수를 수십 개로 늘리면 일관성이 무너지던 원인을 어텐션 컨텍스트 용량 한계로 규명하고, 참조 컨텍스트 압축과 타깃 그룹 회전이라는 두 설계로 푼다.

August 31, 2026 · 10 분 · 서소영
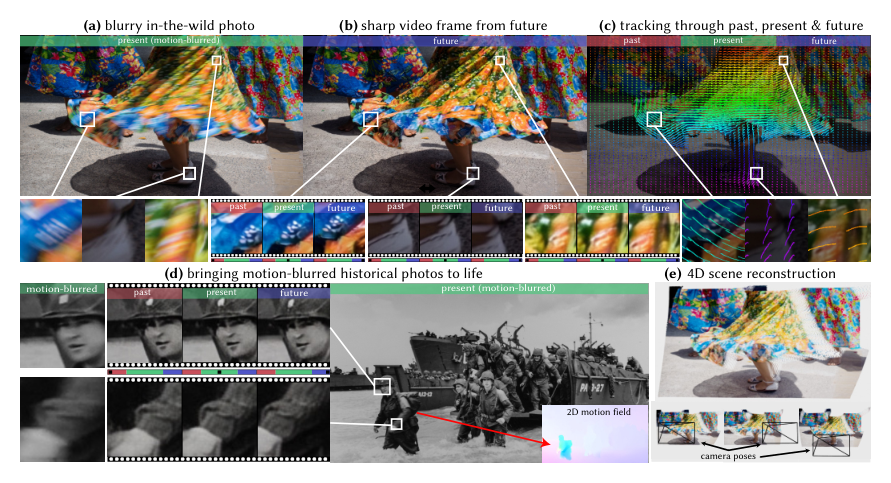
입력 모션 블러 이미지에서 생성한 영상 프레임, 추적 결과, 역사 사진 복원, 3D 구조 복원

Generating the Past, Present and Future from a Motion-Blurred Image

흔들린 사진 한 장을 사전학습 비디오 확산 모델에 조건으로 넣어, 셔터가 열려 있던 순간의 영상과 그 직전과 직후까지 생성한다. 요크대학교와 토론토대학교 연구진의 SIGGRAPH Asia 2025 논문.

August 19, 2026 · 8 분 · 서소영

Celeris-1 — The Fastest LLM on Earth

Celeris AI Labs가 확산 기반 추론 아키텍처로 만든 첫 모델 Celeris-1을 공개했다. GPT-5에 근접한 지능을 유지하면서 응답 지연을 15배 이상 줄이고, 초당 1,600토큰대의 생성 속도를 낸다고 주장한다.

July 26, 2026 · 5 분 · 서소영

深入浅出完整解析FLUX.2、Seedream、Z-image、GLM-Image核心基础知识

Rocky Ding이 2026년 3월 정리한 약 7만 자 분량의 종합 해설. FLUX.2·Seedream·Z-Image·GLM-Image 네 AIGC 이미지 대모델의 VAE·텍스트 인코더·DiT 백본·학습/추론 최적화를 분해하고, GRPO 알고리즘의 AIGC 적용까지 다룬다. 글의 메타 주장은 2025년 하반기를 AIGC 이미지 창작 영역의 ‘하프타임’으로 규정하고, 단일 문생도 모델은 가치가 사라지며 통합 멀티모달과 ‘주기 횡단’ 가치를 가진 기술만 살아남는다는 것이다.

June 3, 2026 · 12 분 · 서소영