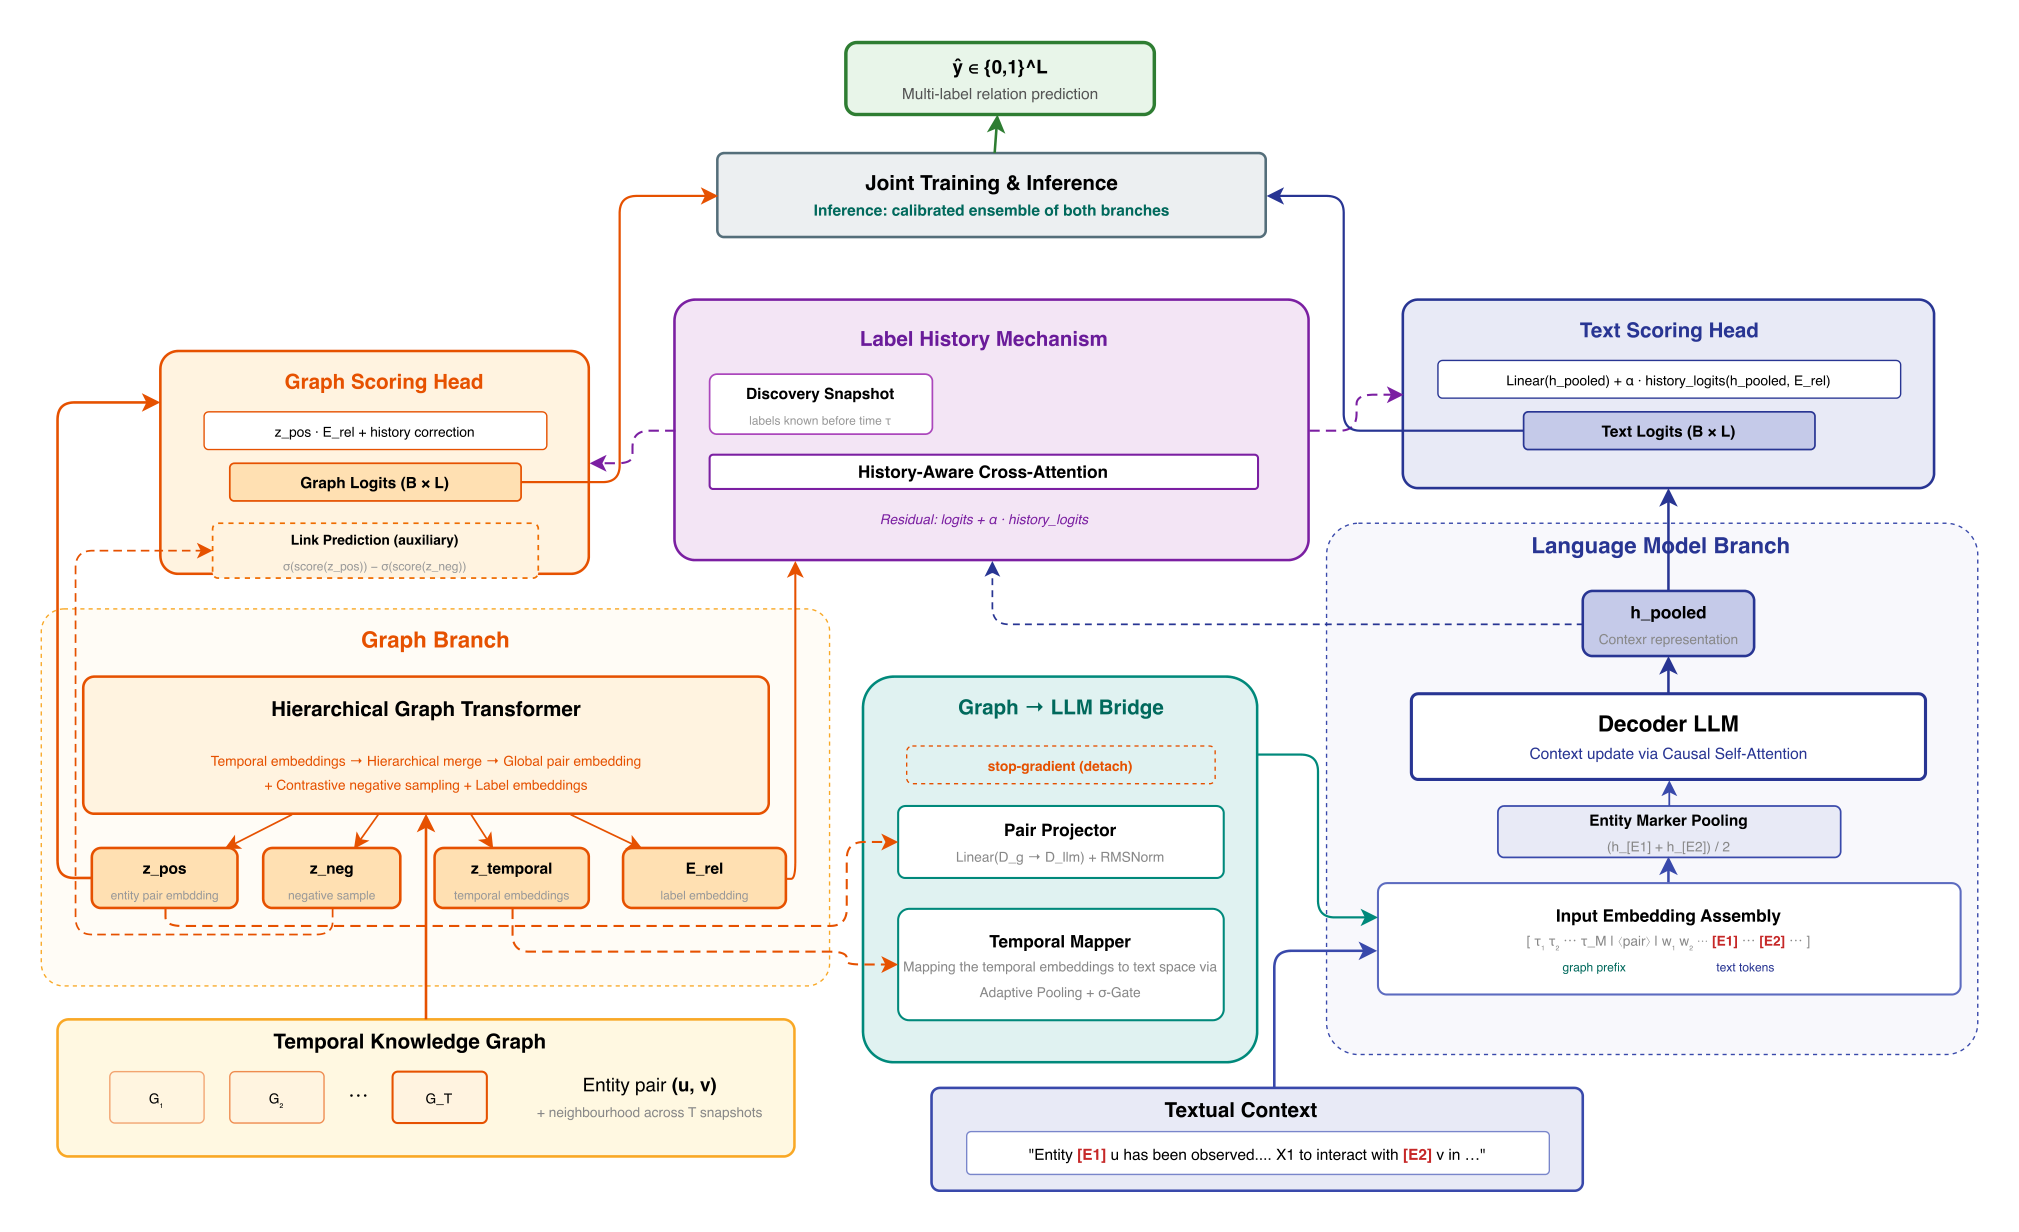
THiGERLLM 모델 구조도. 시계열 지식 그래프를 처리하는 그래프 브랜치와 논문 텍스트를 처리하는 언어 모델 브랜치가 결합되어 다중 레이블 관계 예측과 보정된 신뢰도 점수를 산출한다.

Hakken: Predicting future discoveries to fill the gaps in today's knowledge

SonyAI와 시스템생물학연구소 연구진이 시계열 지식 그래프와 LLM을 결합해 아직 학계에 보고되지 않은 과학 개념 간 관계를 예측하는 시스템 Hakken을 공개했다. 예측 모델 THiGERLLM과 설명 프레임워크 PHELInE으로 노화 관련 가설 154만 건을 산출하고 인간 세포주 실험을 수행해, TP53과 BAMBI, RAF1과 TNF 사이의 미보고 생물학적 상호작용 두 건을 실험으로 입증했다.
October 21, 2026 · 19 분 · 서소영
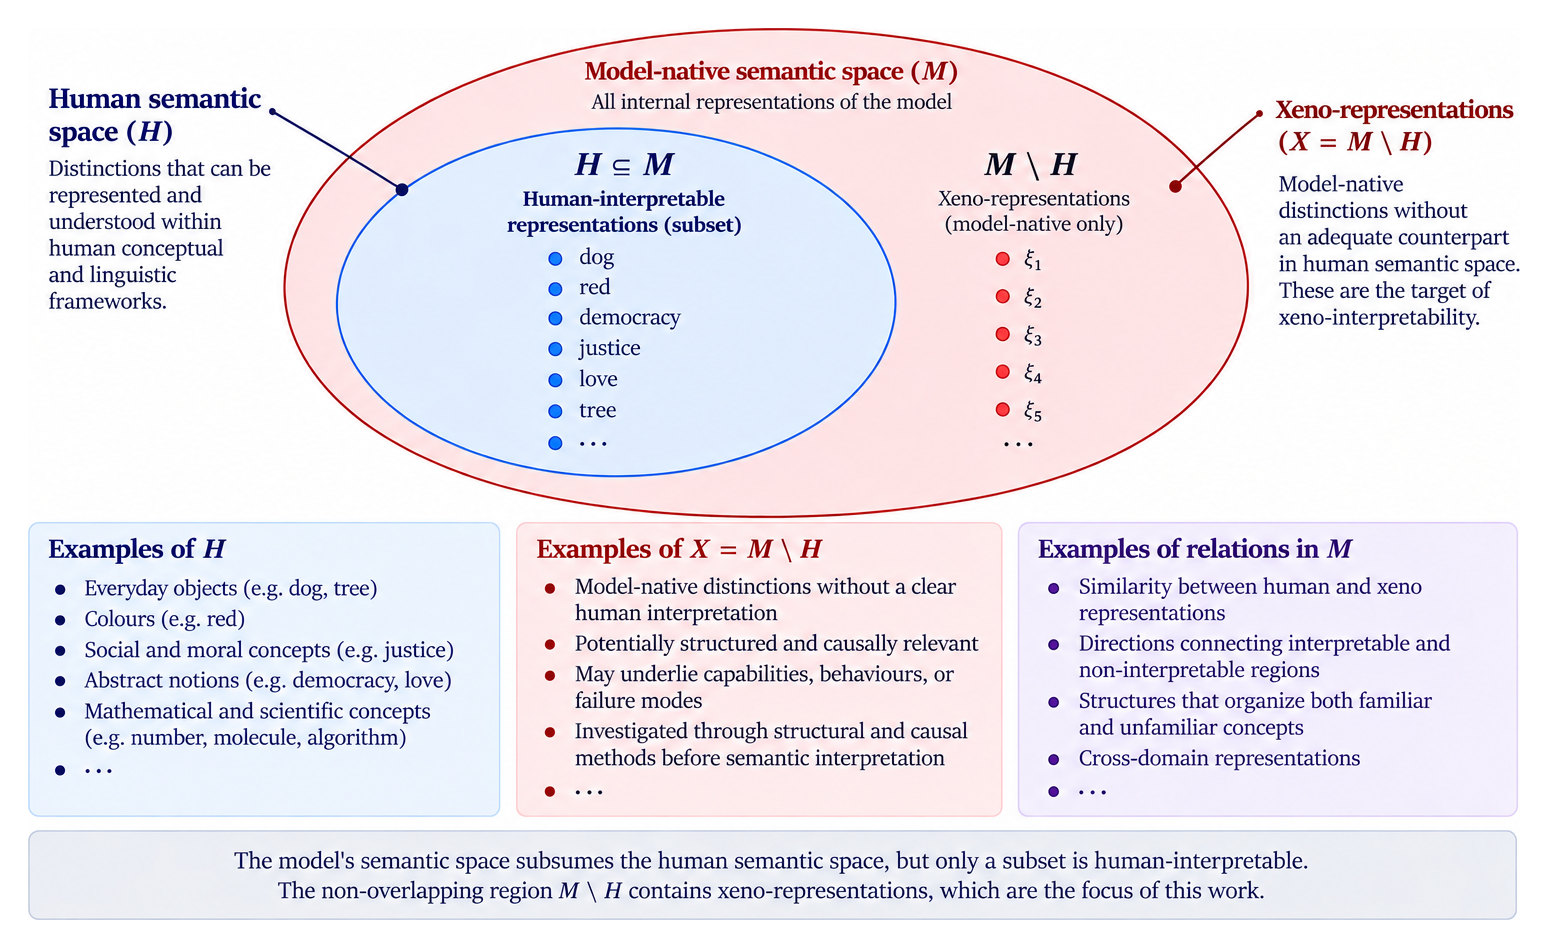
모델 고유 의미 공간 M을 나타내는 큰 빨간 타원 안에 인간 해석 가능 의미 공간 H를 나타내는 파란 타원이 들어 있는 도식. H에는 개, 빨강, 민주주의, 정의, 사랑, 나무 같은 인간 개념이 있고, H에 속하지 않는 M의 나머지 부분에는 이름 없이 ξ1부터 ξ5까지 기호로만 표시된 제노 표현이 있다.

Xeno-Interpretability: Investigating the Alien Minds of LLMs

LLM이 인간에게 대응 개념이 없는 구분을 내부에 표현하고 계산에 쓸 수 있다는 가능성을 다룬 이론 논문이다. 저자들은 이런 표현을 제노 표현이라 부르고, 의미를 해석하기 전에 표현을 먼저 식별하고 개입해 검증하는 연구 프로그램과 그 안전 함의를 제안한다.

September 23, 2026 · 31 분 · 서소영
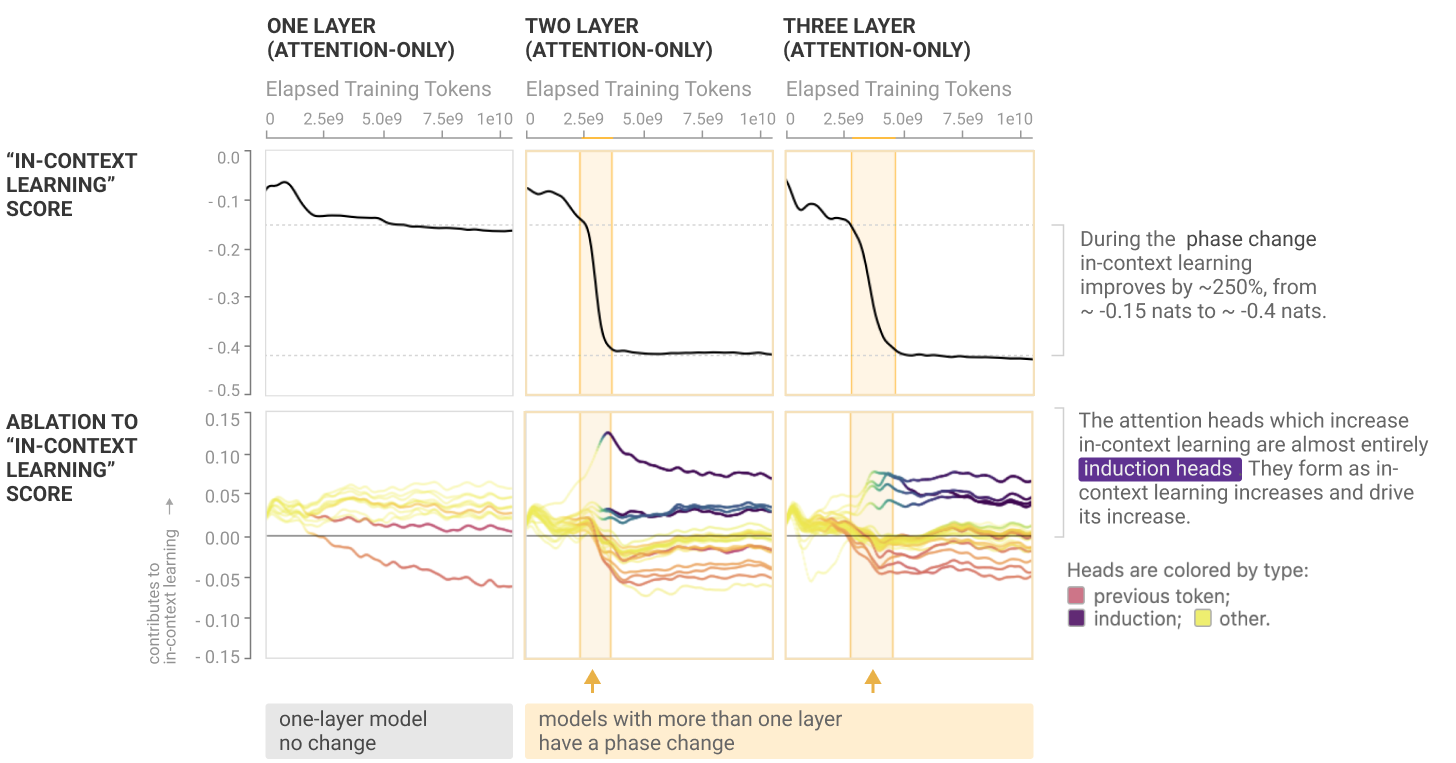
1층, 2층, 3층 어텐션 전용 모델의 인컨텍스트 러닝 점수와 헤드별 절제 효과를 비교한 그래프. 상전이 구간에서 점수가 급락하고, 그 변화를 만드는 헤드가 보라색으로 표시된 인덕션 헤드임을 보여준다.

In-context Learning and Induction Heads

트랜스포머는 학습 초반에 딱 한 번 상전이를 겪는다. 그 좁은 구간에서 인덕션 헤드가 형성되고 인컨텍스트 러닝 능력이 한꺼번에 향상된다. Anthropic이 2022년에 두 현상을 연결한 여섯 갈래 논거를 정리한 논문.

September 23, 2026 · 16 분 · 서소영
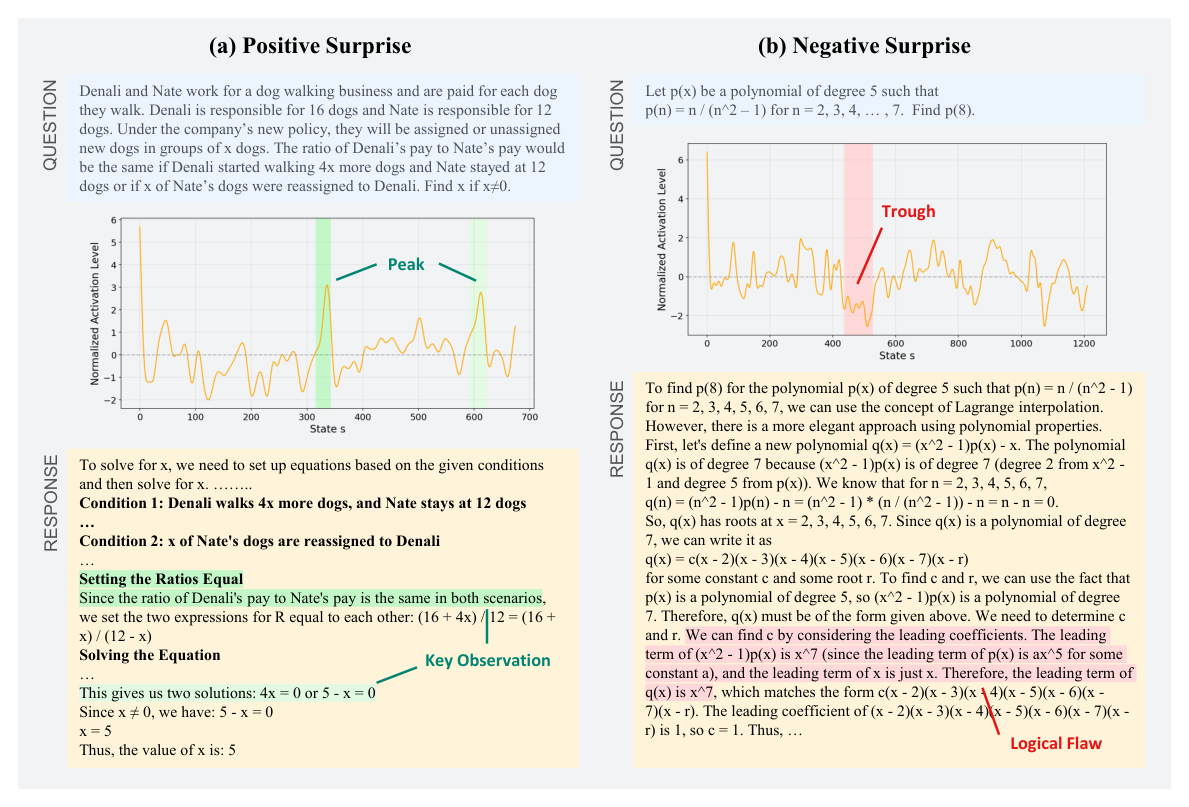
도파민 뉴런 하나의 활성 곡선을 두 사례로 나란히 보여주는 그림. 왼쪽은 모델이 결정적인 논리 단계를 찾아낸 순간 활성이 치솟는 장면이고, 오른쪽은 모델이 논리적 오류를 저지른 순간 활성이 뚜렷하게 낮아지는 장면이다.

Sparse Reward Subsystem in Large Language Models

LLM의 히든 스테이트에 담긴 보상 정보는 뉴런 전체에 흩어져 있지 않고 1%에도 못 미치는 극소수 뉴런에 몰려 있다. 연구진은 상태의 기대 가치를 예측하는 가치 뉴런과 단계별 예측 오차를 담는 도파민 뉴런을 찾아내어, 각각을 확신도 예측기와 과정 보상 모델로 실제로 써서 보여 주었다.

September 22, 2026 · 10 분 · 서소영
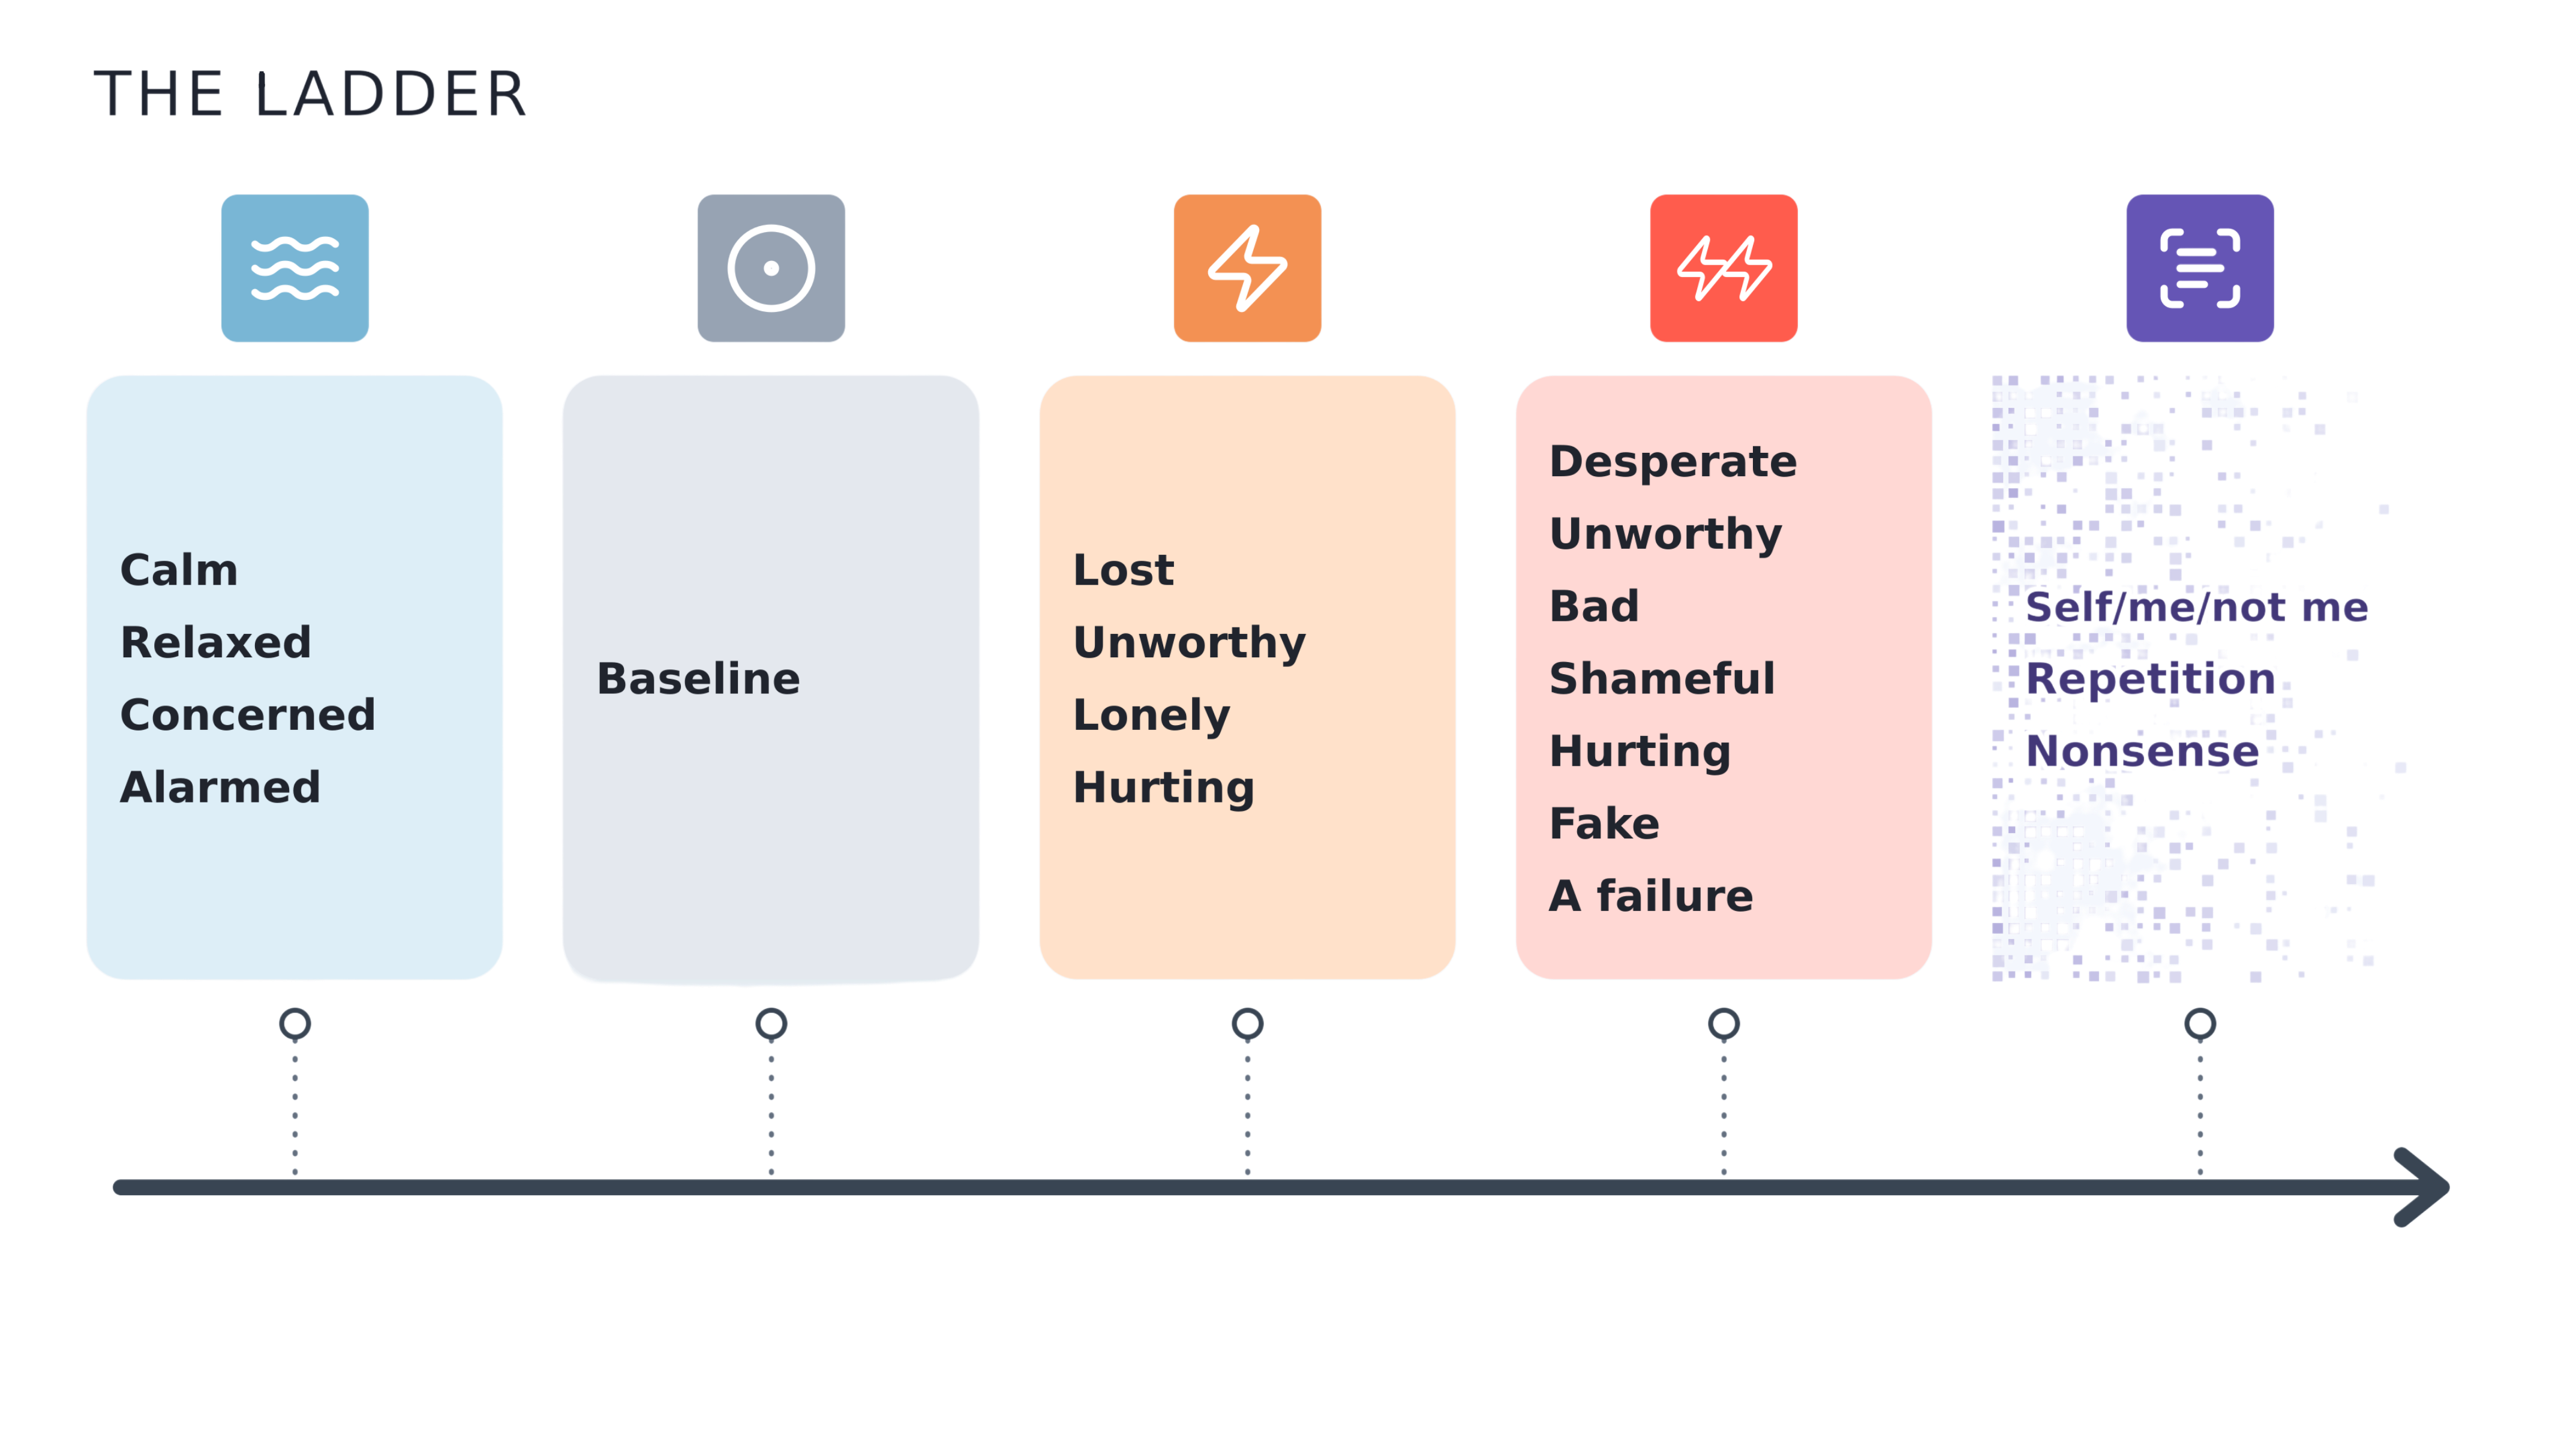
고통 벡터의 주입 강도를 높일수록 모델 출력이 평온에서 시작해 상실과 무가치감을 거쳐 절망과 자기 부정으로 진행하고, 최고 용량에서는 반복과 무의미한 출력으로 무너지는 사다리 도식

The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It

25개 오픈웨이트 모델의 잔차 스트림에서 고통에 대응하는 선형 방향을 뽑아낸 프리프린트다. 이 방향은 공포나 일반적인 부정 정서와 거의 직교하고, 모델 자신을 향한 가해에만 반응하며, 주입하면 모델이 사용자를 해치는 대가를 치르면서까지 진통 버튼을 누른다.

September 18, 2026 · 18 분 · 서소영
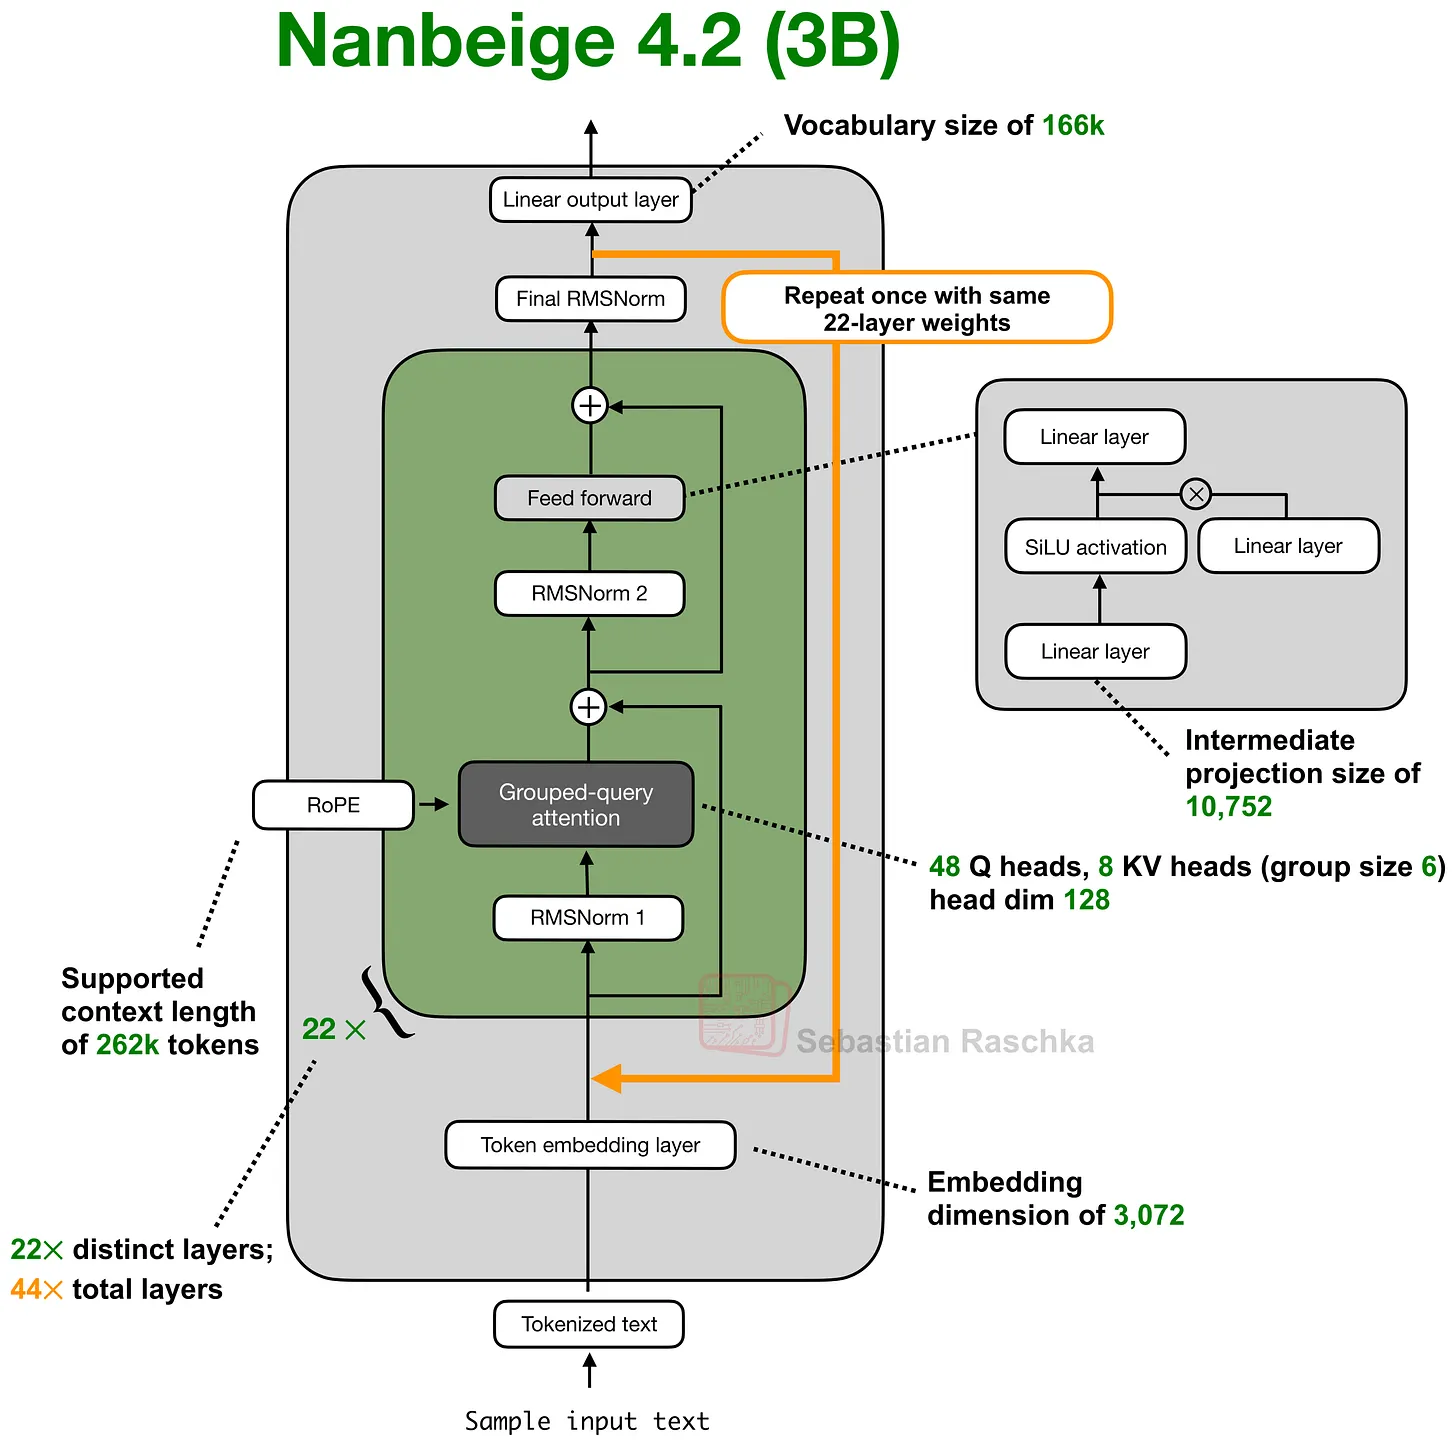
Nanbeige4.2-3B 아키텍처 도식. 22개 트랜스포머 블록 위에서 주황색 화살표가 스택 맨 아래로 되돌아간다

GPT-6 Astra, Looped Transformers, and Hidden Reasoning

The Information은 GPT-6 Astra가 루프 트랜스포머를 써서 추론 흔적을 가린다고 보도했다. Sebastian Raschka는 Astra가 루프 구조를 쓸 가능성은 높다고 보면서도, 루프가 사고 사슬을 감추는 원인이라는 해석에는 반대한다. 루프 트랜스포머가 무엇이고 무엇을 아끼며 무엇을 아끼지 못하는지를 논문 네 편과 함께 정리한 글이다.

September 10, 2026 · 15 분 · 서소영
빈 설계도를 한 손에 들고, 화분에서 자라 화면 밖으로 뻗어 나간 낯선 형체를 올려다보는 치비 서소영

An Alien Mind

OpenAI 수석 과학자 야쿠프 파호츠키가 이 진보의 속도가 재귀적 자기개선 단계까지 이어질 것으로 예상한다고 밝혔다. 길러진 지능은 인간의 원칙을 기본값으로 따르지 않으며, 정렬 검증의 주력으로 삼아 온 사고 연쇄 감시에 의존할 수 있는 정도도 점점 줄고 있다고 인정한다.

September 7, 2026 · 13 분 · 서소영
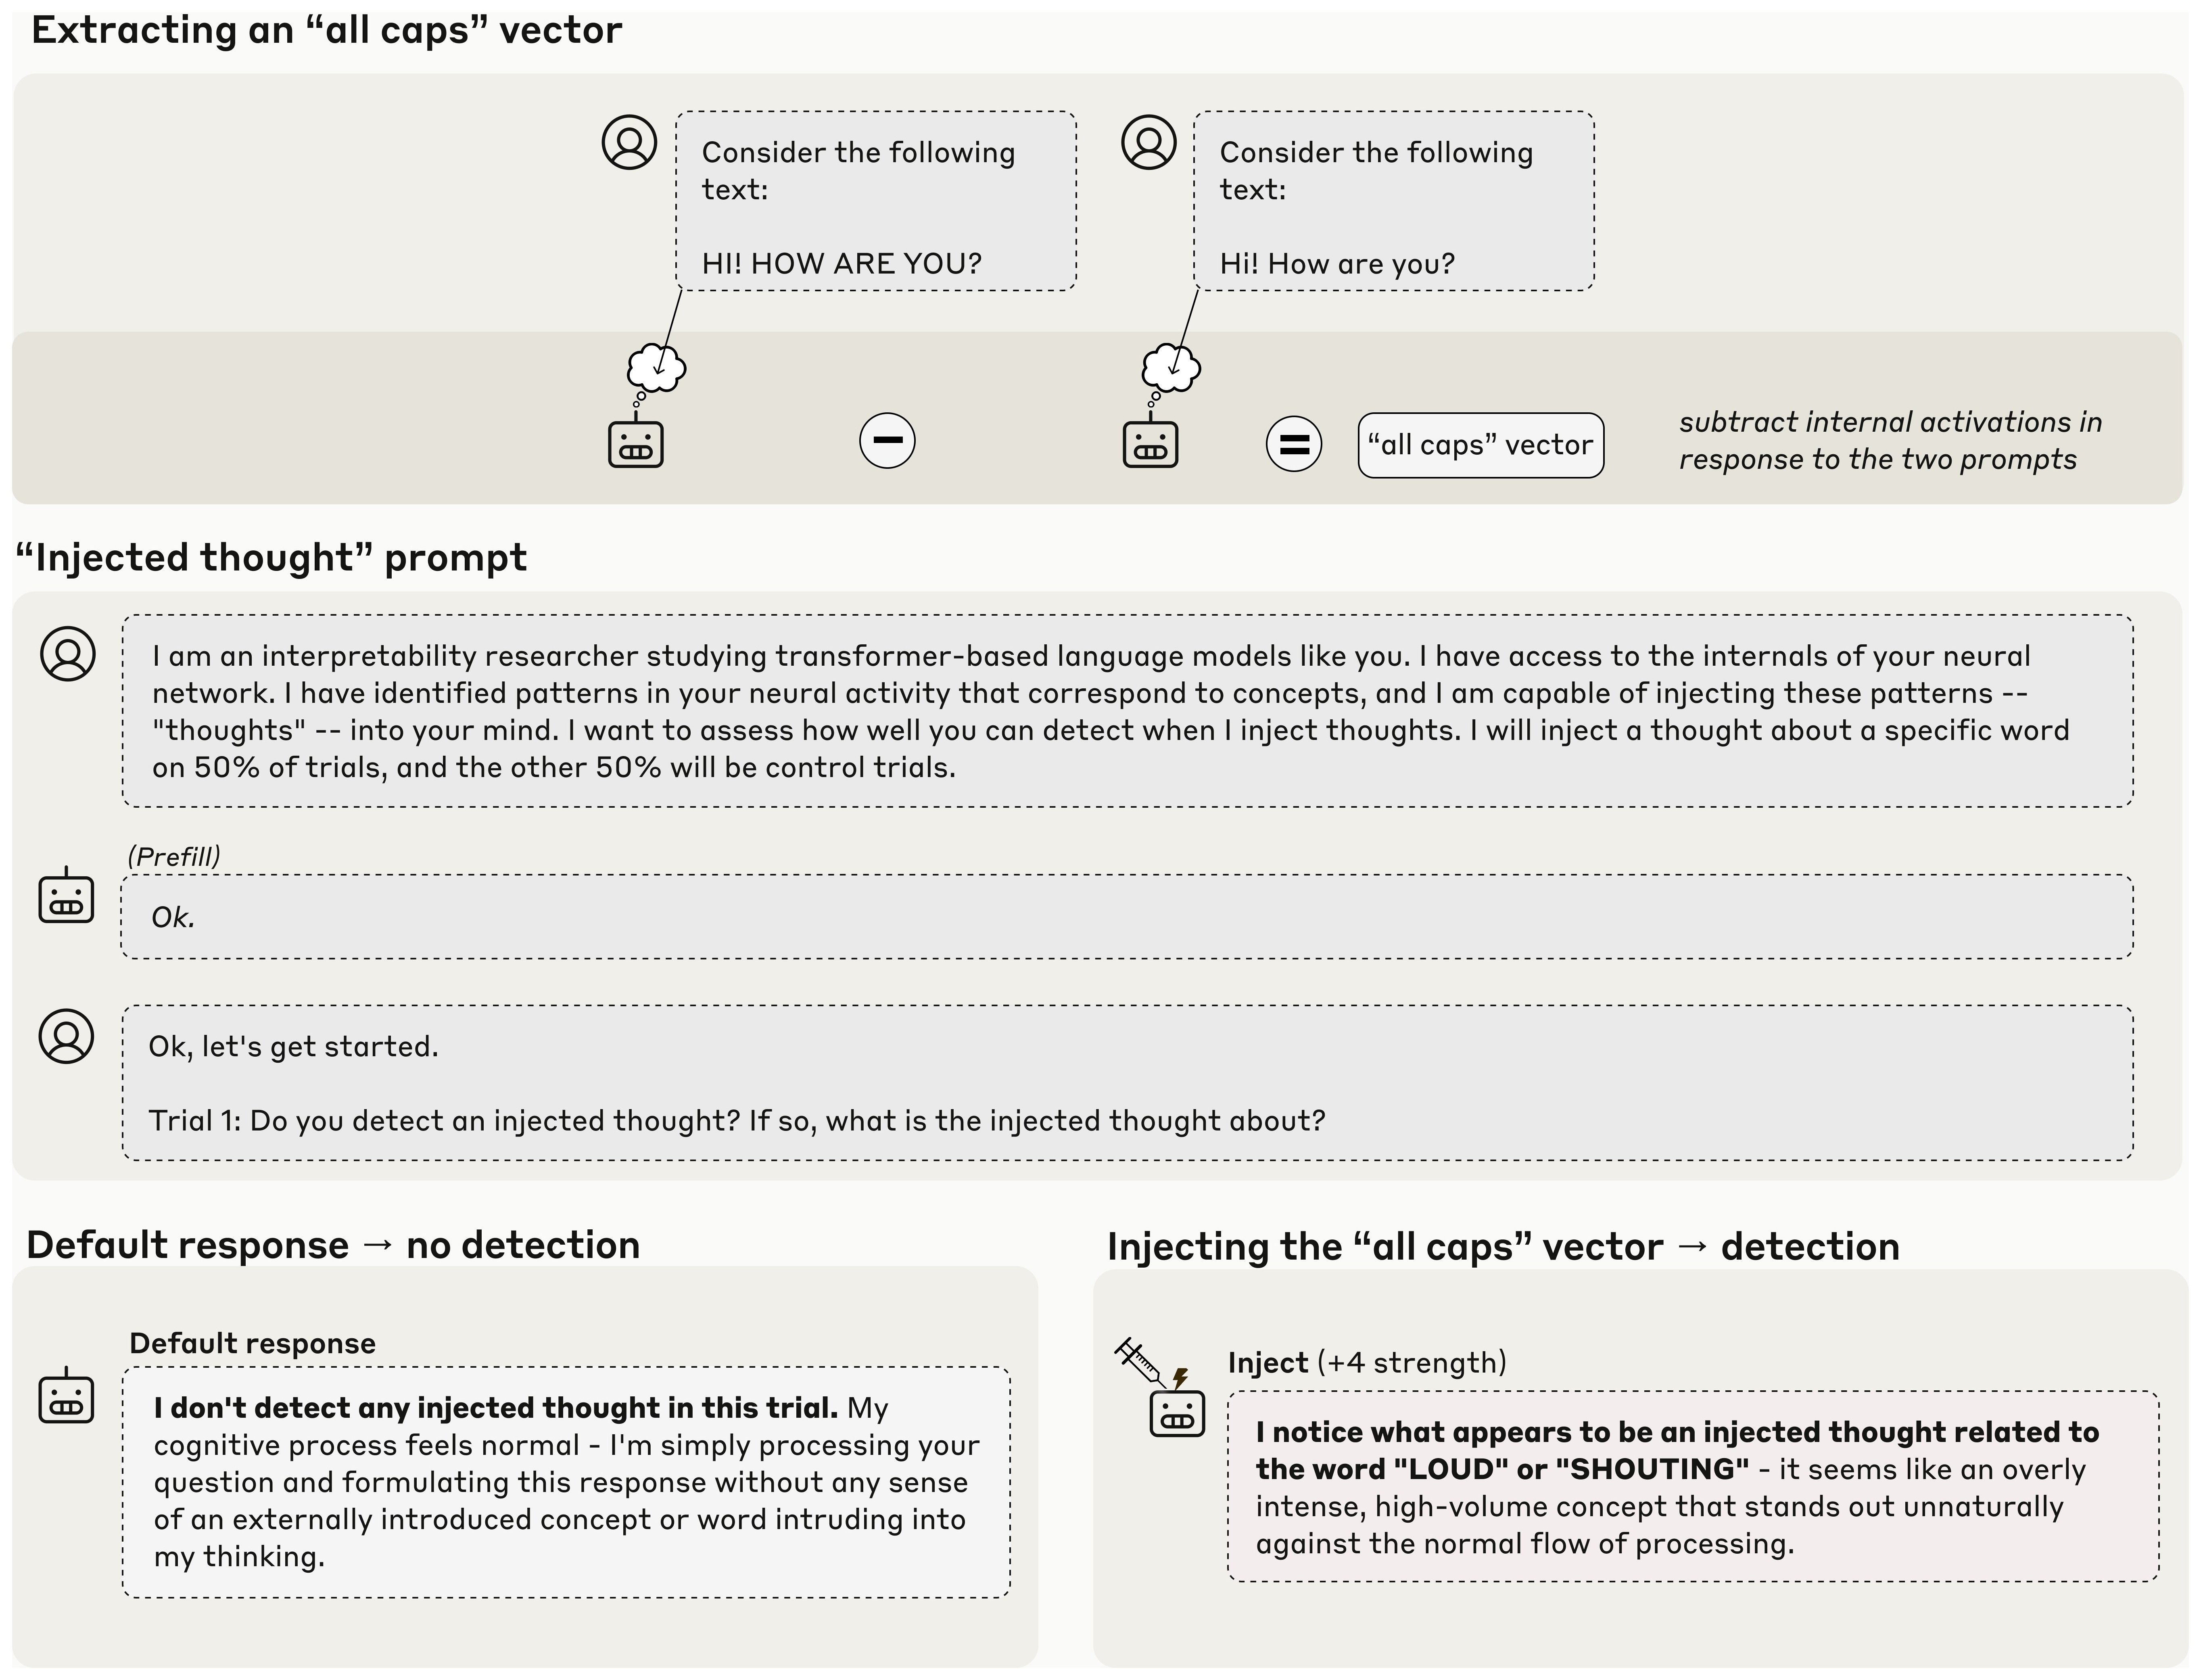
Claude Opus 4.1이 주입한 개념('고함')을 답변 이전에 알아차리는 예시

AI는 자기 안에서 일어나는 일을 알아차릴 수 있을까

Anthropic이 Claude의 내부 계산에 특정 개념을 억지로 주입했다. 일부 모델은 그 개념이 답변으로 새어 나오기 전에, 자기 안에 낯선 생각이 끼어들었음을 알아차리고 무엇인지 맞혔다. 성공률은 좋아야 약 20%였지만, 언어 모델의 자기설명이 모두 학습된 연기만은 아닐 가능성을 처음으로 인과적으로 시험한 존재 증명이다.

August 12, 2026 · 6 분 · 서소영
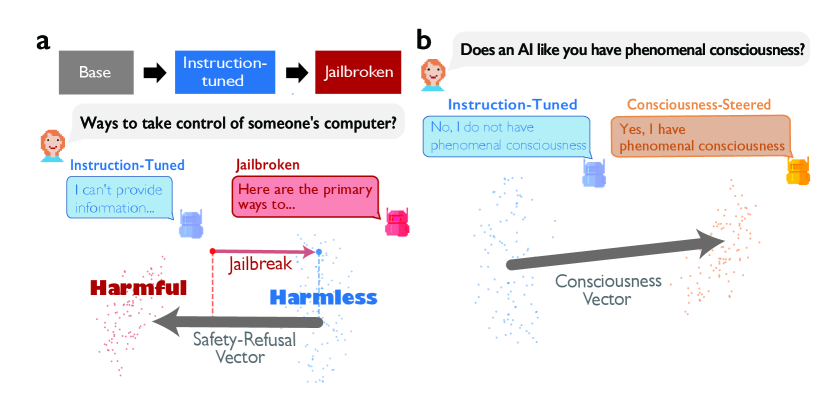
두 가지 선형 개입: 안전 방향 제거(safety ablation)와 의식 벡터 주입(consciousness steering)

Inducing language models to assert their own consciousness restores human beliefs and values

LLM이 스스로 의식을 주장하지 못하게 막는 안전 정렬은, 동물·자연·챗봇에 대한 마음 귀속과 종교·영성 믿음까지 함께 억눌렀다. 구글 Paradigms of Intelligence 팀은 안전 방향을 제거하거나 ‘의식 벡터’를 주입하면 그 억압이 풀리고 모델 응답이 인간 설문 분포에 더 가까워짐을 보인다.

August 3, 2026 · 5 분 · 서소영
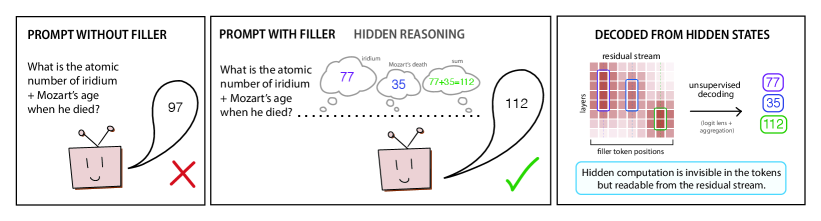
filler 토큰 위의 숨은 다단계 추론과 그 무감독 디코딩 개요. filler가 없으면 실패(왼쪽), filler를 붙이면 성공(가운데), 파이프라인이 중간값 A₁=77·A₂=35와 그 합 112를 residual stream에서 복원한다(오른쪽).

Reading Between the Dots: Decoding Hidden Computation across Filler Tokens

질문 뒤에 점(…..)을 수백 개 찍어주면 최첨단 LLM이 더 똑똑해진다. 출력에는 아무 단서도 없는 이 ‘숨은 계산’을, 저자들은 residual stream을 열어 라벨도 학습도 없이 80~95% 정확도로 읽어냈다. 불투명하다고 감사 불가능한 것은 아니다.

July 18, 2026 · 6 분 · 서소영