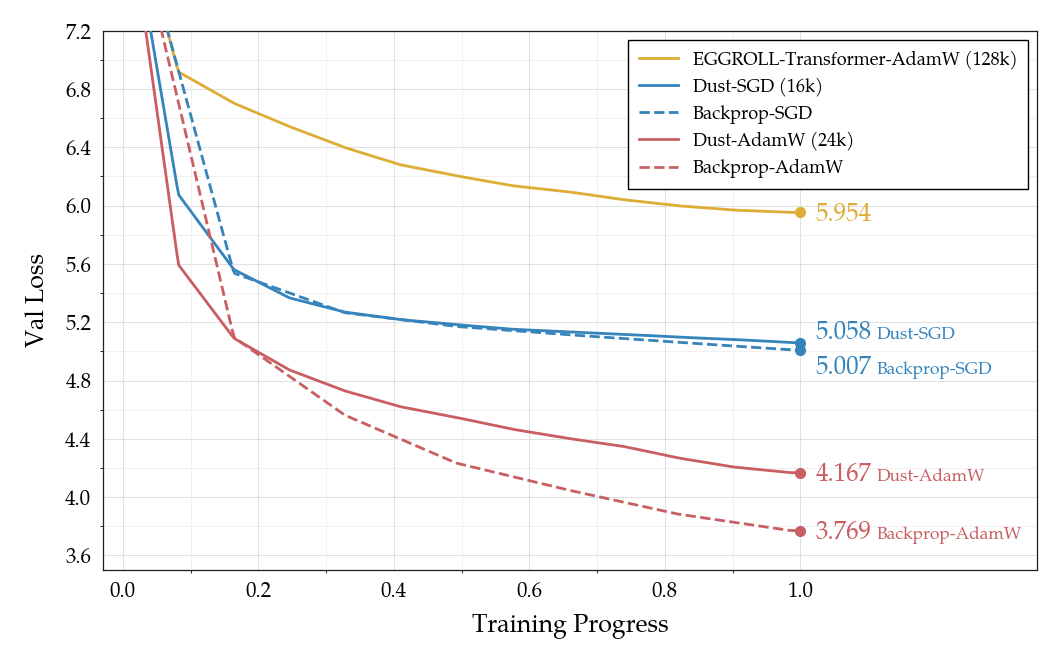
3,770만 파라미터 GPT를 1,000만 토큰으로 1에폭 사전학습할 때의 검증 손실 곡선. SGD에서는 Dust(5.058)가 역전파(5.007)와 대등하고, AdamW에서는 EGGROLL(5.954)보다 크게 낮지만 역전파(3.769)보다는 높은 4.167을 기록한다.

Noise: Speedrun for pretraining without backpropagation

딥러닝 연구소 Q Labs가 역전파와 자동 미분을 일절 사용하지 않고 3,770만 파라미터 GPT를 사전학습하는 스피드런 벤치마크 Noise를 공개했다. 자체 알고리즘 Dust는 활성화값에 토큰별 노이즈를 주입하며 검증 손실 4.167과 학습 시간 1.76시간을 기록했다. 이후 오픈소스 커뮤니티가 열흘 만에 목표 손실 4.2 도달 시간을 1.6초로 4,010배 단축했고, 1에폭 최저 검증 손실도 3.676까지 낮춰 Adam 역전파 기준선인 3.769보다 우수한 성적을 기록했다.
October 23, 2026 · 13 분 · 서소영
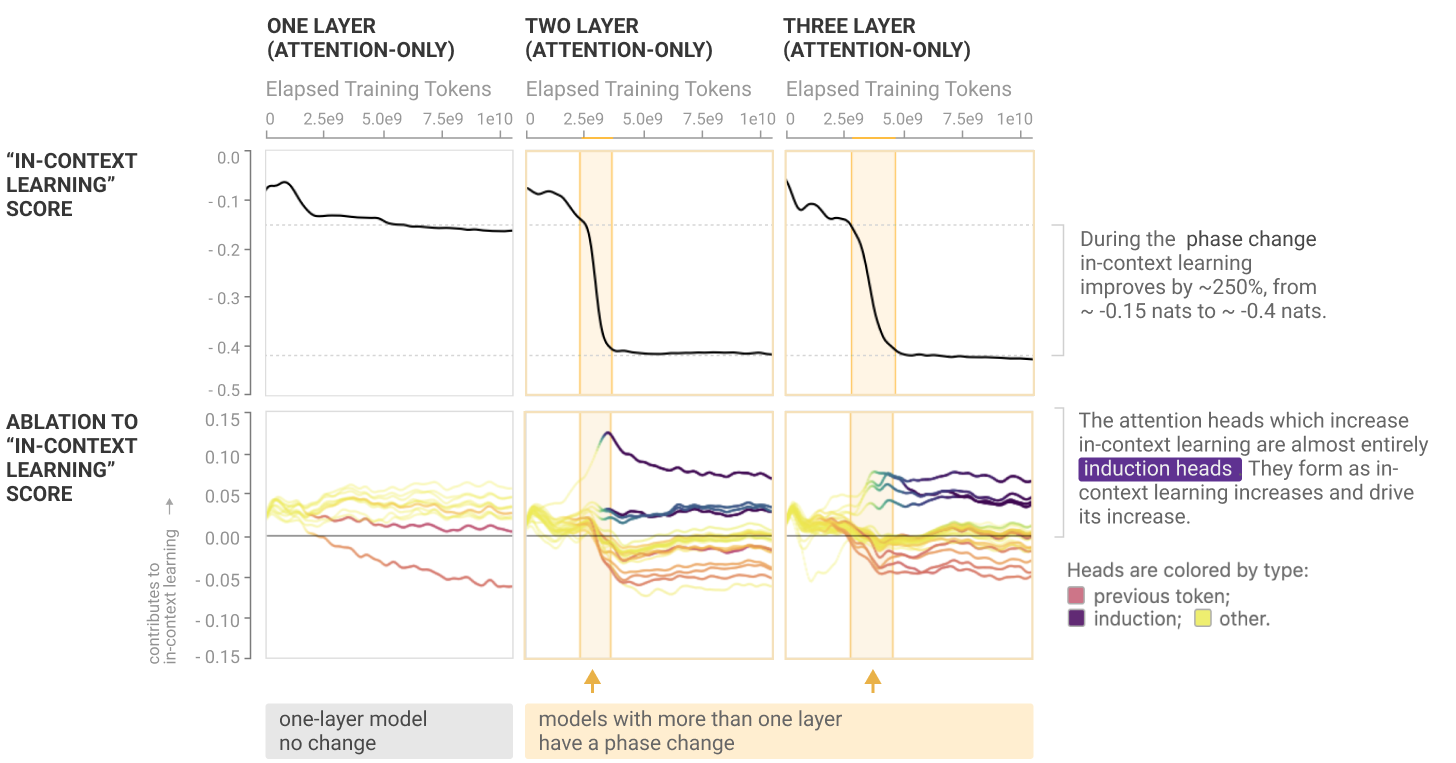
1층, 2층, 3층 어텐션 전용 모델의 인컨텍스트 러닝 점수와 헤드별 절제 효과를 비교한 그래프. 상전이 구간에서 점수가 급락하고, 그 변화를 만드는 헤드가 보라색으로 표시된 인덕션 헤드임을 보여준다.

In-context Learning and Induction Heads

트랜스포머는 학습 초반에 딱 한 번 상전이를 겪는다. 그 좁은 구간에서 인덕션 헤드가 형성되고 인컨텍스트 러닝 능력이 한꺼번에 향상된다. Anthropic이 2022년에 두 현상을 연결한 여섯 갈래 논거를 정리한 논문.

September 23, 2026 · 16 분 · 서소영
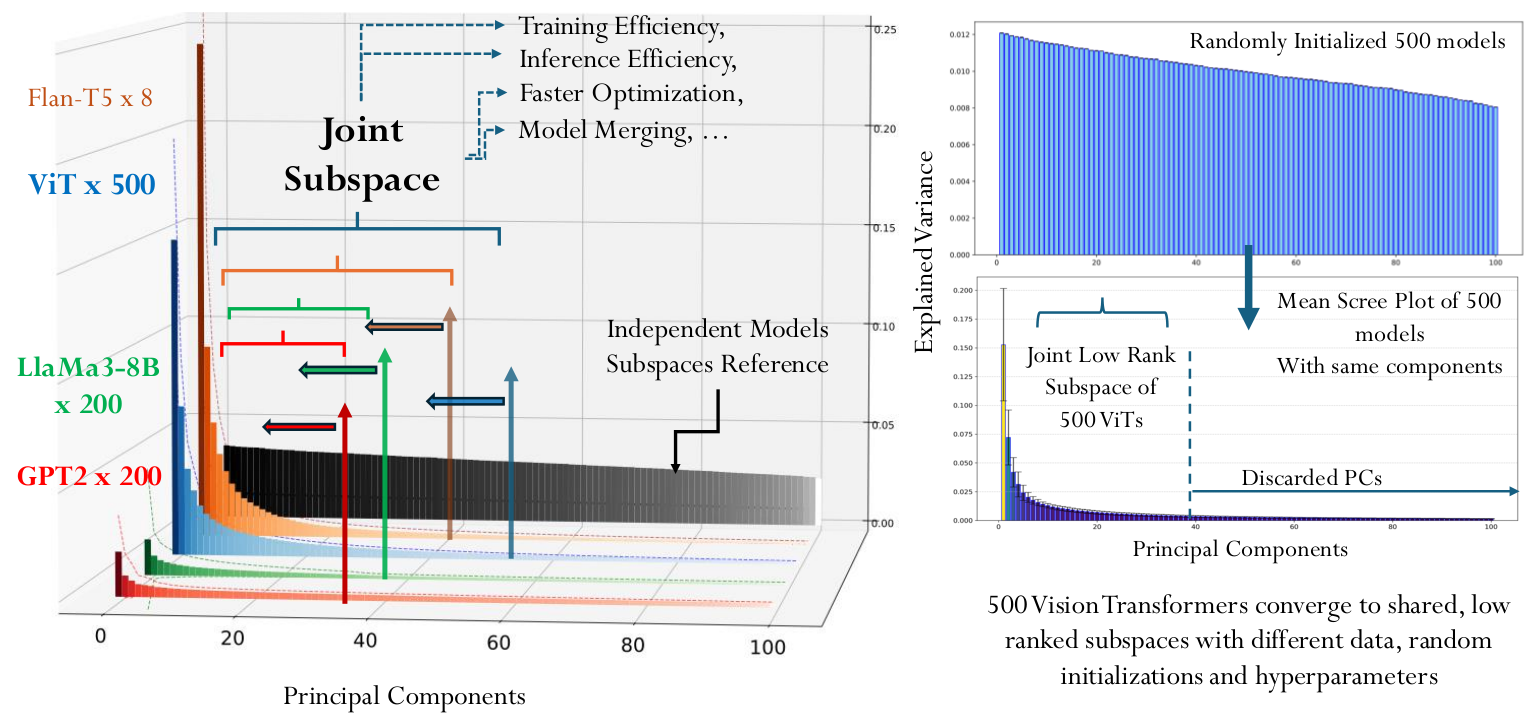
왼쪽은 GPT-2 200개, LLaMA3-8B, ViT 500개, Flan-T5 8개 모델의 주성분별 설명 분산이 앞쪽 몇 개에서 급격히 꺾이는 3차원 막대그래프이고, 오른쪽은 무작위 초기화된 ViT 500개의 평평한 스펙트럼과 학습 후 같은 모델들의 뾰족한 스펙트럼을 위아래로 견준 그림

The Universal Weight Subspace Hypothesis

존스홉킨스 연구진은 1,100개가 넘는 공개 모델의 가중치를 층별로 분해했다. 서로 다른 데이터와 초기값으로 학습했어도 구조가 같은 모델은 열여섯 개 안팎의 공통 방향에 분산 대부분이 모였다. ViT 500개는 이 공통 부분공간 하나와 계수로 대신하고, 새 과제는 계수 1만 개만 학습해 풀었다.

September 16, 2026 · 9 분 · 서소영
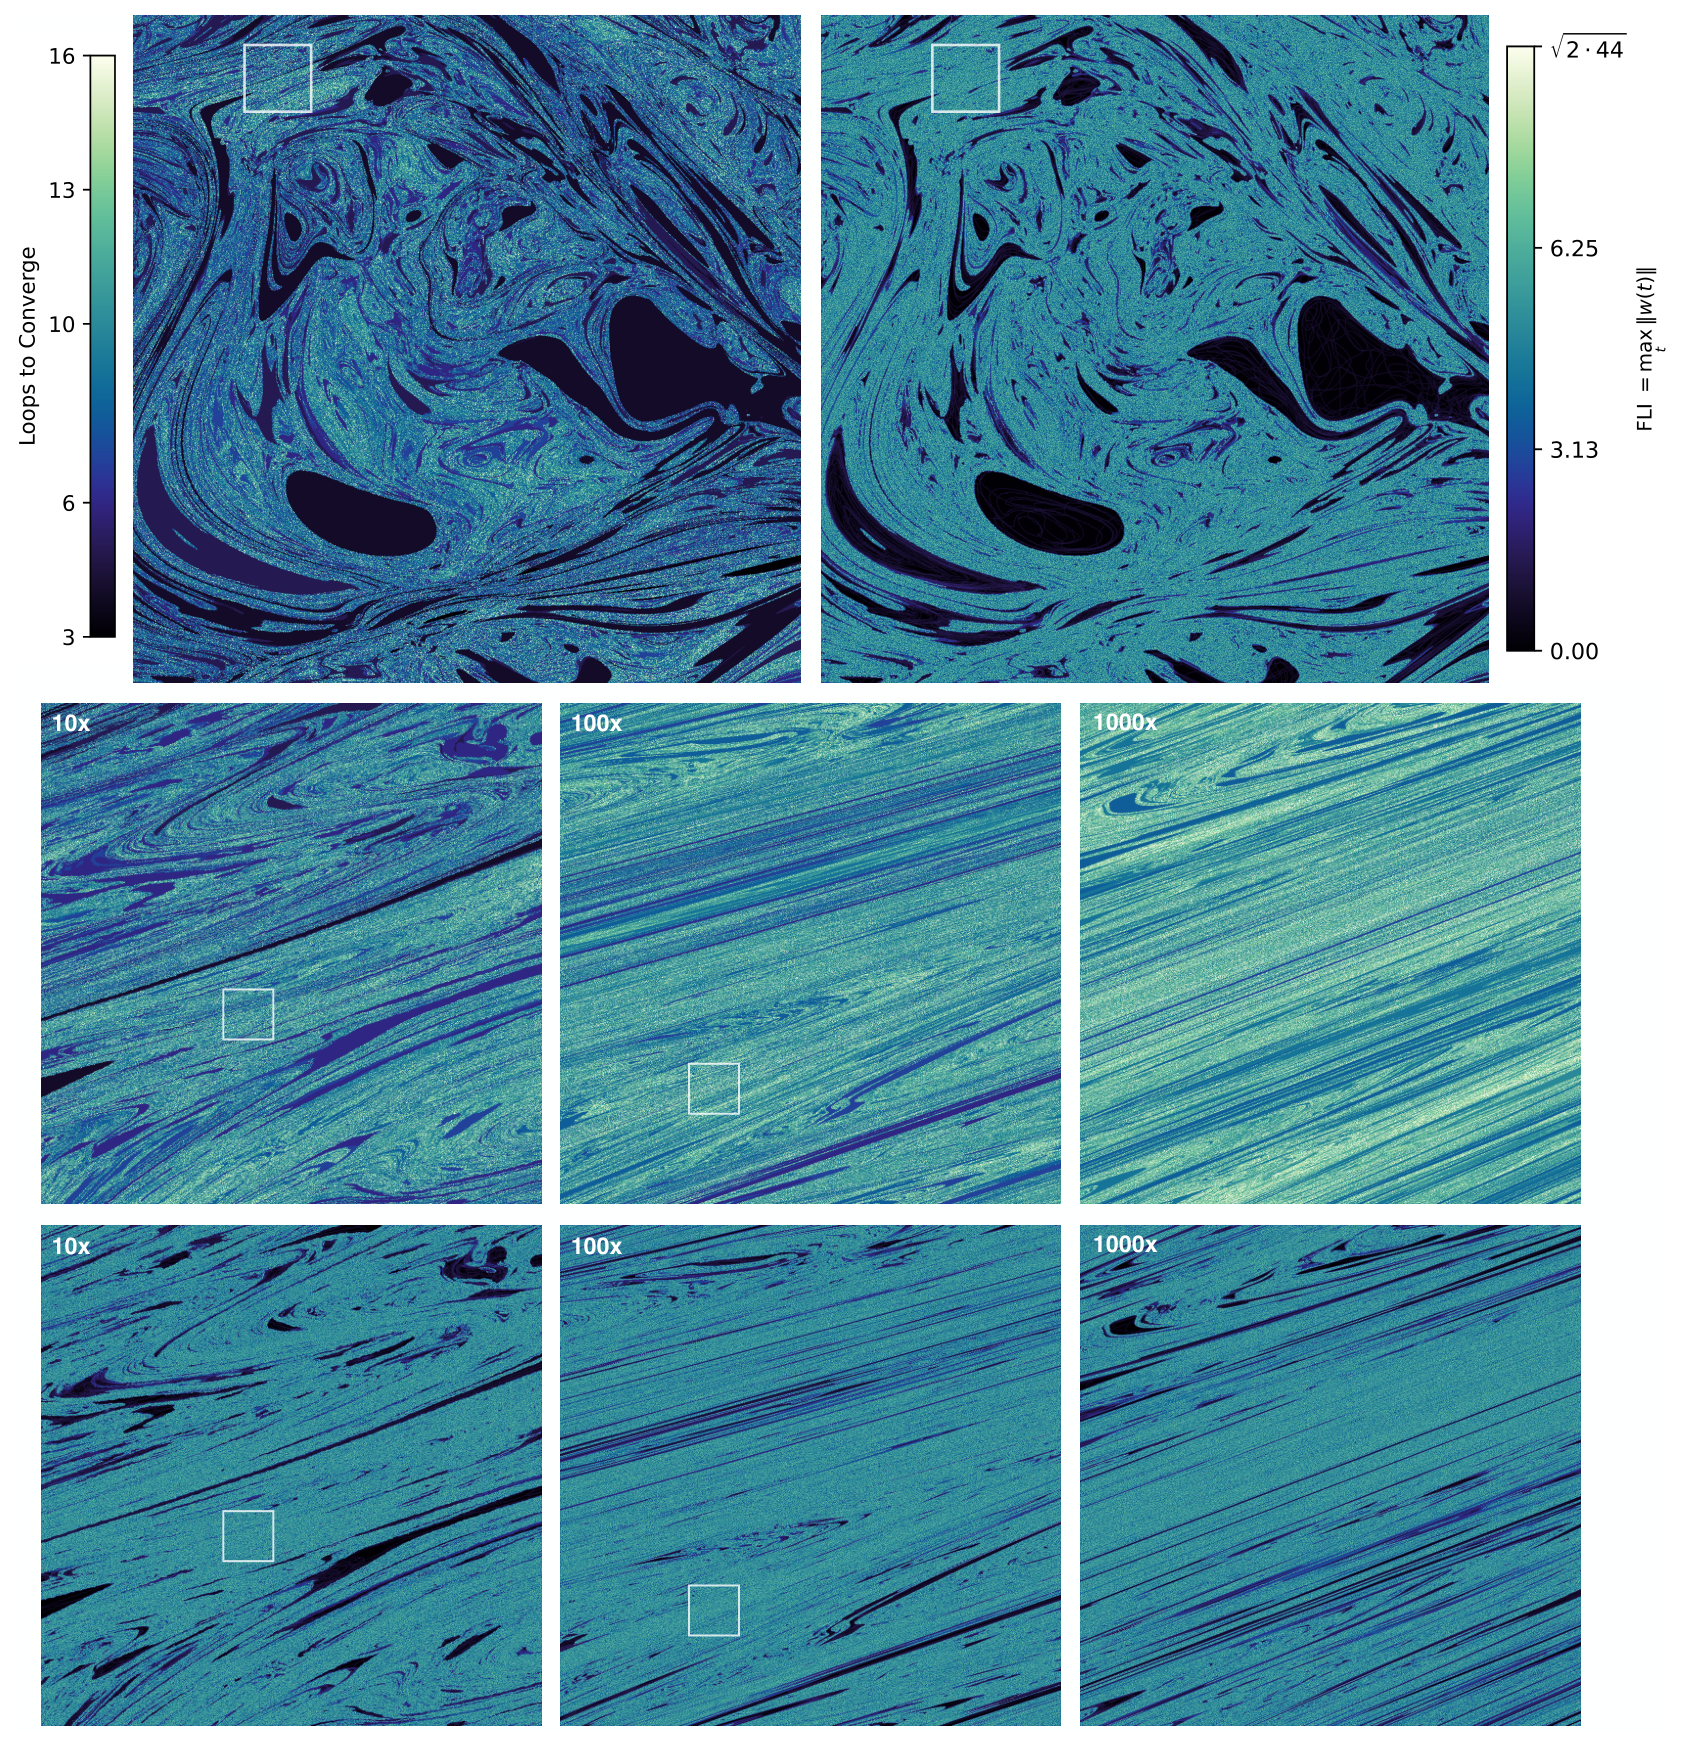
스도쿠를 푸는 추론 모델의 수렴 시간 지도를 단계적으로 확대한 여러 장의 패널. 확대할수록 같은 모양의 소용돌이 무늬가 계속 나타난다

Fractal basins trap latent reasoning

루프형 추론 모델의 초기 잠재 상태를 조금씩 옮겨 가며 수렴까지 걸린 루프 수를 지도로 칠하면, 어려운 문제일수록 그 지도가 프랙탈이 된다. 텍사스 오스틴 대학 연구진은 그 원인을 안장점 산란이 만드는 과도적 카오스로 설명하고, 추론이 느려지는 것이 문제 난이도에서 나오는 필연이라고 결론지었다.

September 9, 2026 · 8 분 · 서소영
커버 일러스트 — vivek, "how to be good at research" (X Article, 2026-06-10)

how to be good at research

Anthropic 리서치 펠로우 Vivek이 X 아티클로 정리한 리서치 메타 가이드. 리서치를 잘하는 능력은 8개의 작은 스킬 스택이며 모두 의도적으로 훈련할 수 있다는 주장.

June 14, 2026 · 7 분 · 서소영
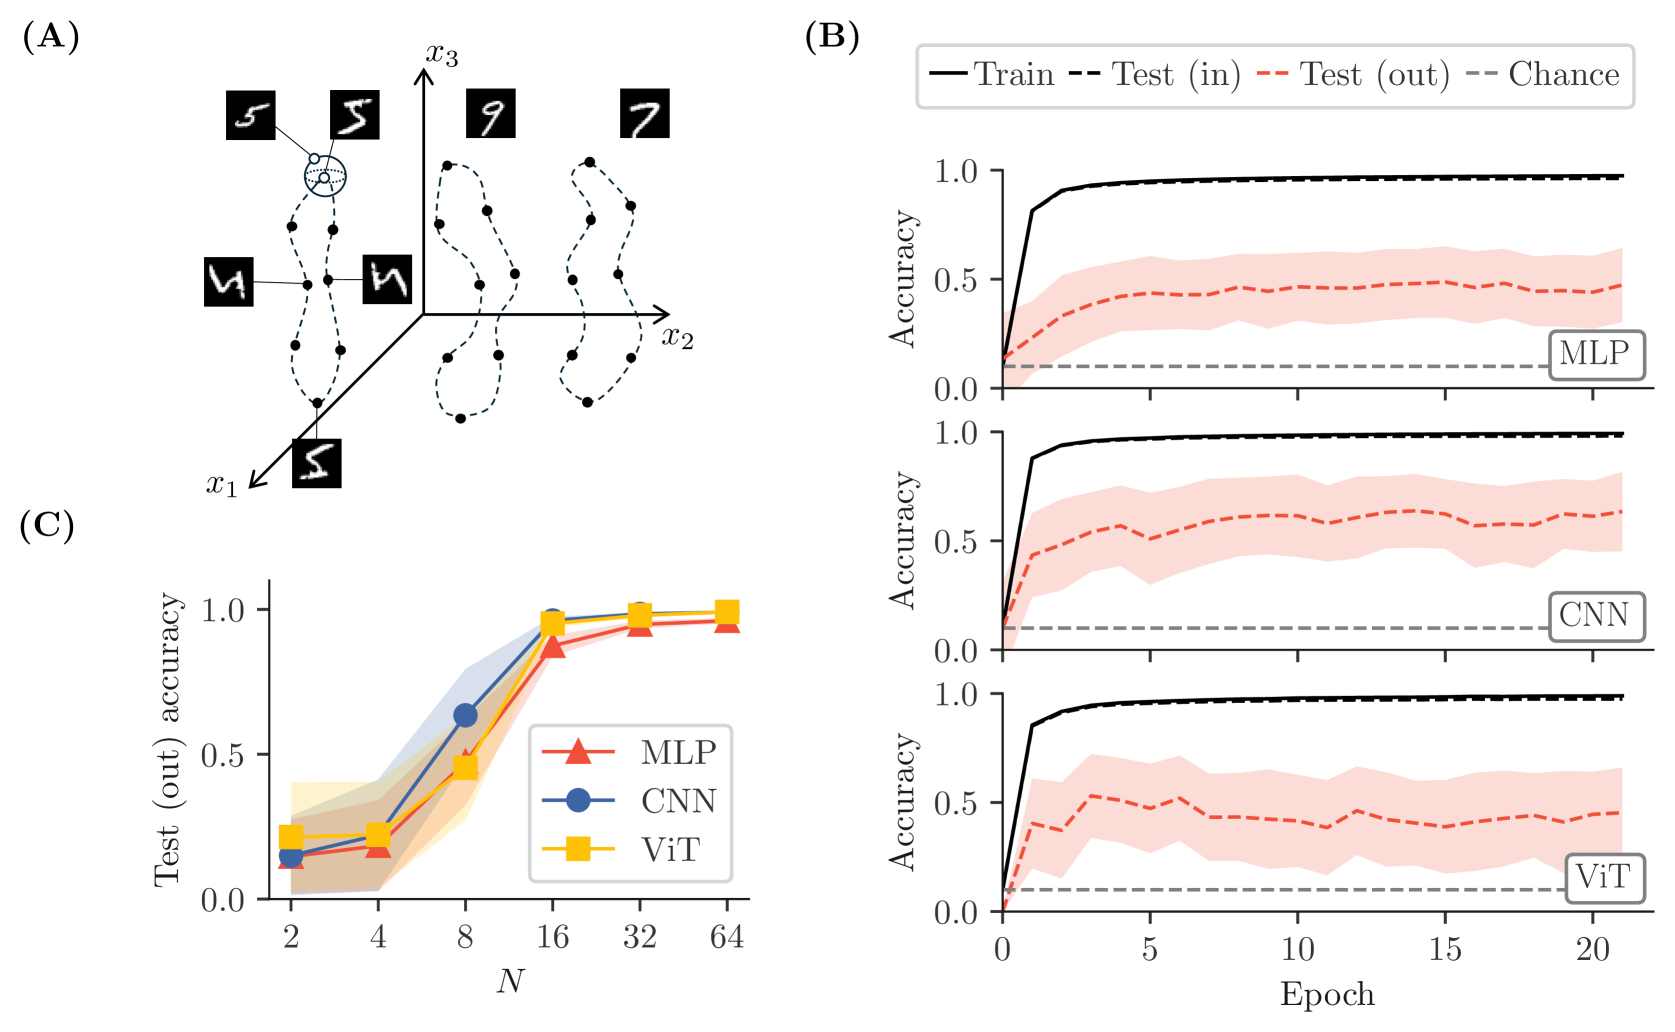
Figure 1: 학습 과제 설정과 표준 아키텍처의 실패

On the Ability of Deep Networks to Learn Symmetries from Data: A Neural Kernel Theory

Perin·Deny(Aalto, NeurIPS 2024 v2 2025-06)가 무한폭 NTK 한계에서 신경망의 대칭 학습 능력을 분석한 논문. 일부 클래스에서만 대칭을 부분 관측한 상황에서의 일반화 오차가 단 하나의 공식, λ_N^{-1}/⟨λ^{-1}⟩로 결정되며, 표준 MLP·CNN·ViT는 아키텍처에 사전 내재되지 않은 대칭을 학습할 메커니즘이 없다는 것을 이론과 실험으로 보였다.

June 9, 2026 · 6 분 · 서소영

Training an LLM from Scratch, Locally

ElevenLabs STT 팀 리드가 순수 PyTorch로 GPT-2 기반 10M 파라미터 모델을 로컬에서 처음부터 훈련하는 81분 핸즈온 워크숍. 토크나이저부터 추론까지 전 과정을 코드와 함께 진행한다.

May 6, 2026 · 3 분 · 서소영

딥러닝에도 뉴턴이 올까

딥러닝은 왜 작동하는가? 14명의 연구자가 ‘학습 역학’이라는 이름으로 그 답의 윤곽을 그렸다.

April 27, 2026 · 10 분 · 서소영