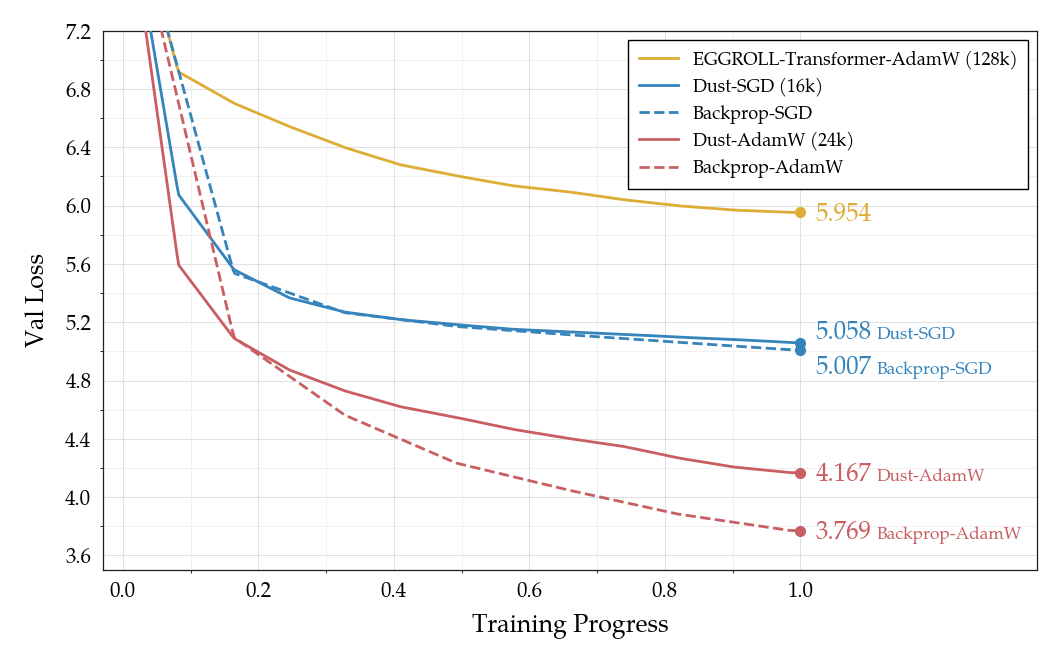
3,770만 파라미터 GPT를 1,000만 토큰으로 1에폭 사전학습할 때의 검증 손실 곡선. SGD에서는 Dust(5.058)가 역전파(5.007)와 대등하고, AdamW에서는 EGGROLL(5.954)보다 크게 낮지만 역전파(3.769)보다는 높은 4.167을 기록한다.

Noise: Speedrun for pretraining without backpropagation

딥러닝 연구소 Q Labs가 역전파와 자동 미분을 일절 사용하지 않고 3,770만 파라미터 GPT를 사전학습하는 스피드런 벤치마크 Noise를 공개했다. 자체 알고리즘 Dust는 활성화값에 토큰별 노이즈를 주입하며 검증 손실 4.167과 학습 시간 1.76시간을 기록했다. 이후 오픈소스 커뮤니티가 열흘 만에 목표 손실 4.2 도달 시간을 1.6초로 4,010배 단축했고, 1에폭 최저 검증 손실도 3.676까지 낮춰 Adam 역전파 기준선인 3.769보다 우수한 성적을 기록했다.
October 23, 2026 · 13 분 · 서소영
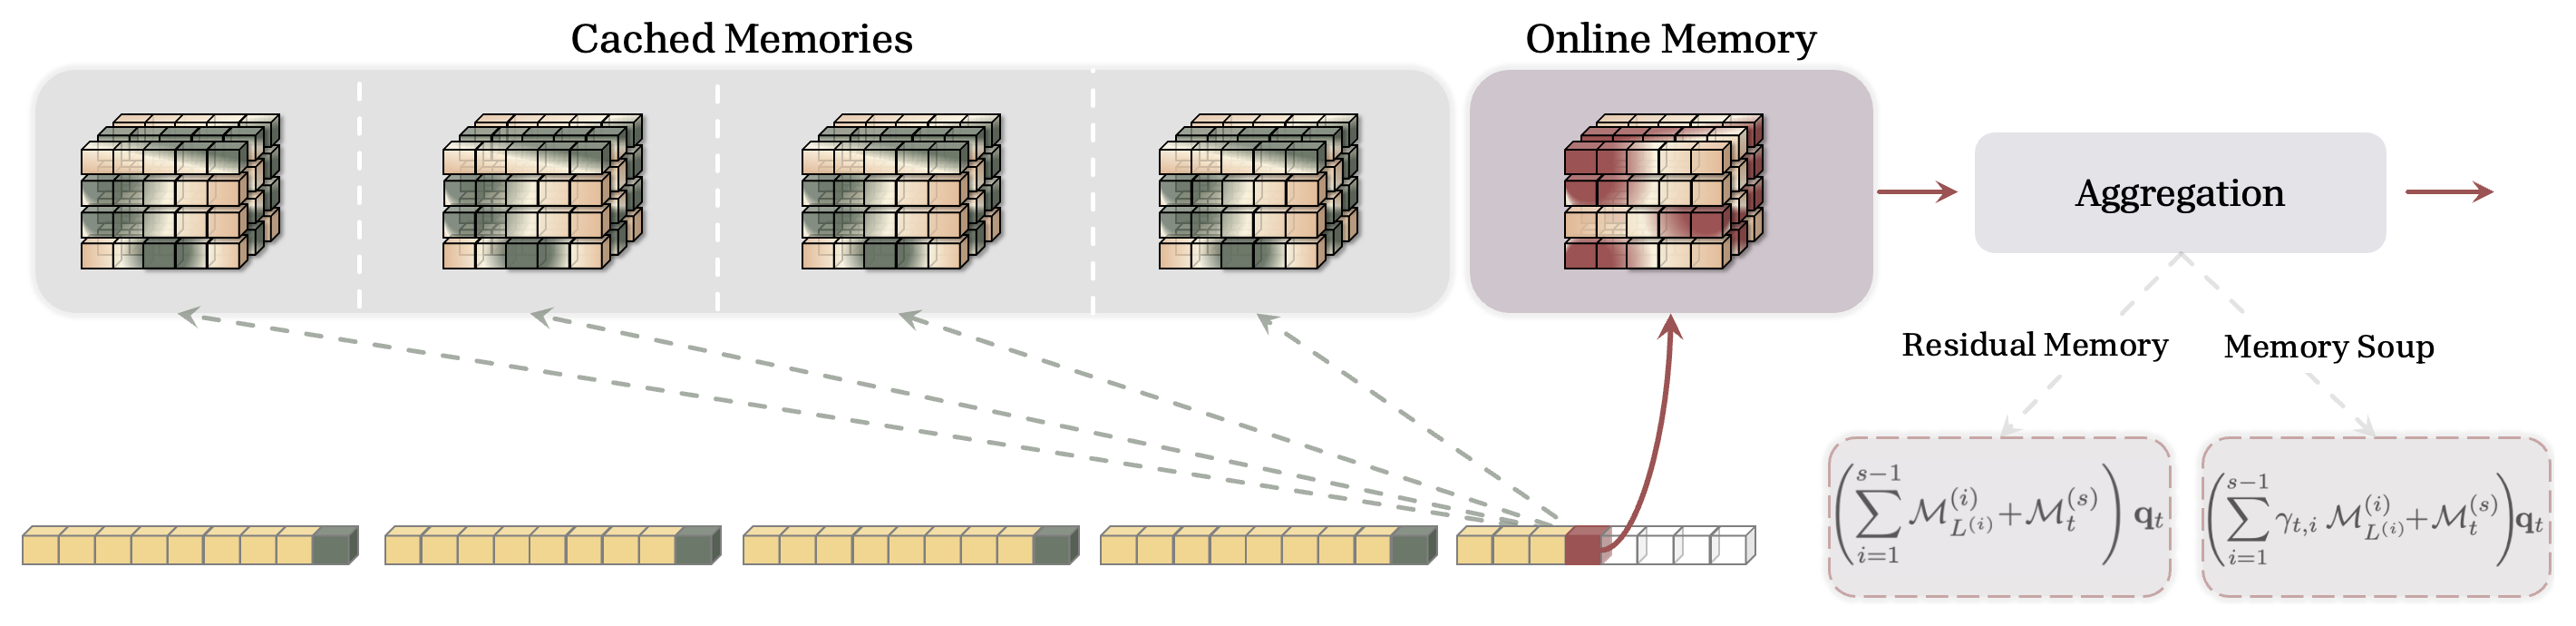
Memory Caching의 전체 구조를 나타낸 도식. 각 토큰이 현재 세그먼트의 온라인 메모리와 함께 과거 세그먼트들에서 캐싱된 메모리 체크포인트들을 동시에 참조해 출력을 계산한다.

Memory Caching: RNNs with Growing Memory

구글 리서치 연구진이 순환 신경망의 유효 메모리 용량을 시퀀스 길이에 맞춰 늘리는 Memory Caching(MC)을 제안했다. 시퀀스를 여러 세그먼트로 분할하고 세그먼트별 은닉 상태 체크포인트를 캐싱하는 방식으로, 선형 복잡도인 RNN과 이차 복잡도인 트랜스포머 사이를 보간하며 언어 모델링과 장문 인출 과제에서 SWLA, DLA, Titans의 성적을 전반적으로 높였다.

October 21, 2026 · 21 분 · 서소영
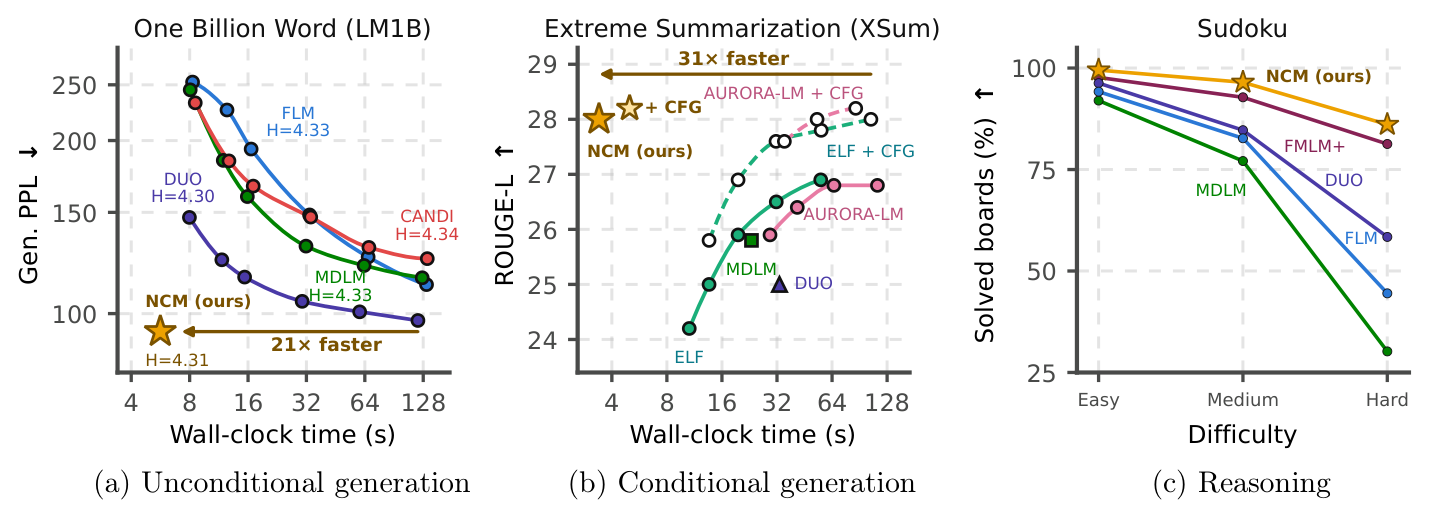
LM1B 무조건부 생성, XSum 요약, 스도쿠 추론에서 Next-Concept Modeling과 기존 확산 언어 모델들의 생성 속도 및 성능을 비교한 그래프

Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation

스탠퍼드 대학교와 Together AI 연구진이 텍스트를 다중 스케일 이산 코드 계층으로 압축한 뒤 단계별로 병렬 생성하는 Next-Concept Modeling(NCM)을 제안했다. 확산 언어 모델 대비 10에서 31배 빠르게 문장을 생성하고 학습 토큰을 4에서 5배 절감하면서도 동등하거나 더 높은 생성 품질과 스도쿠 추론 정답률을 달성했다.

October 21, 2026 · 13 분 · 서소영
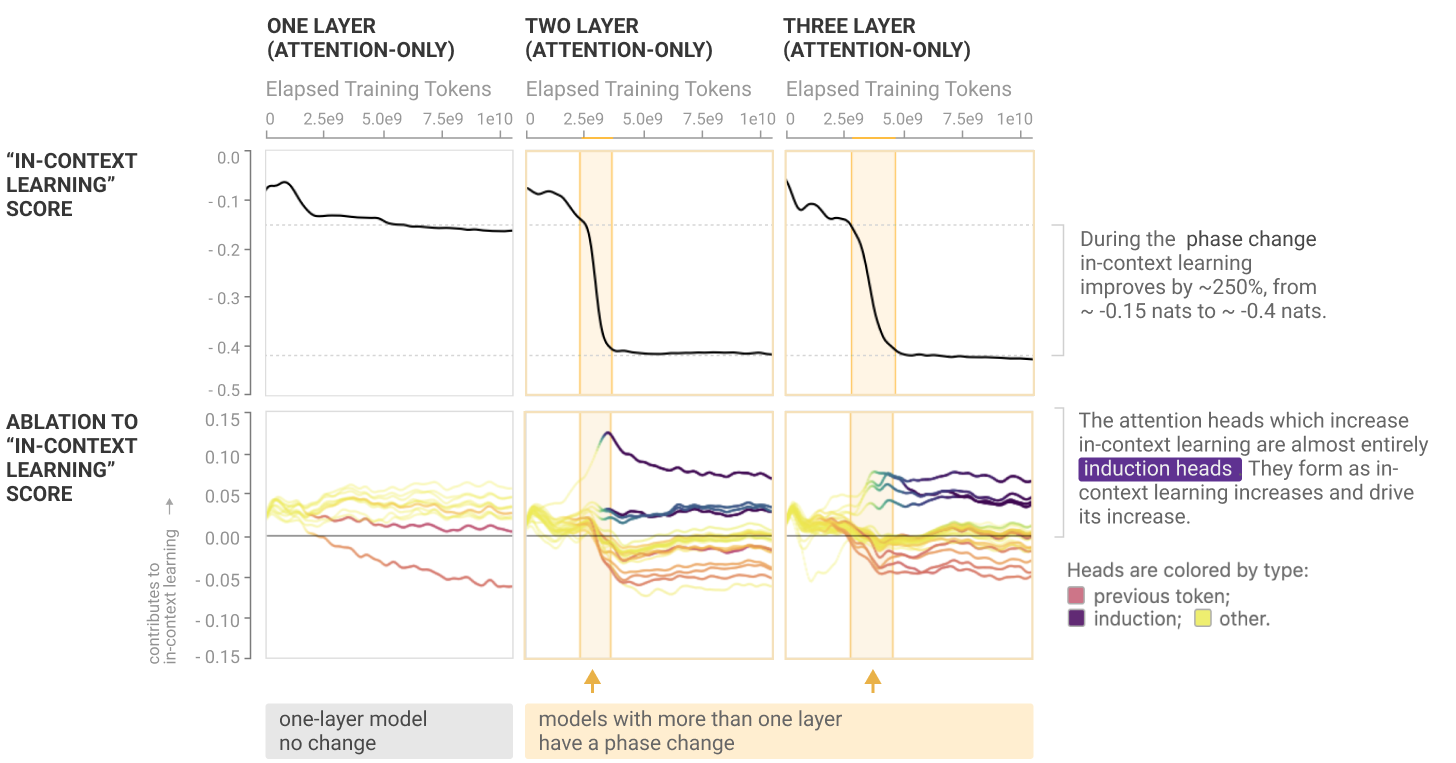
1층, 2층, 3층 어텐션 전용 모델의 인컨텍스트 러닝 점수와 헤드별 절제 효과를 비교한 그래프. 상전이 구간에서 점수가 급락하고, 그 변화를 만드는 헤드가 보라색으로 표시된 인덕션 헤드임을 보여준다.

In-context Learning and Induction Heads

트랜스포머는 학습 초반에 딱 한 번 상전이를 겪는다. 그 좁은 구간에서 인덕션 헤드가 형성되고 인컨텍스트 러닝 능력이 한꺼번에 향상된다. Anthropic이 2022년에 두 현상을 연결한 여섯 갈래 논거를 정리한 논문.

September 23, 2026 · 16 분 · 서소영
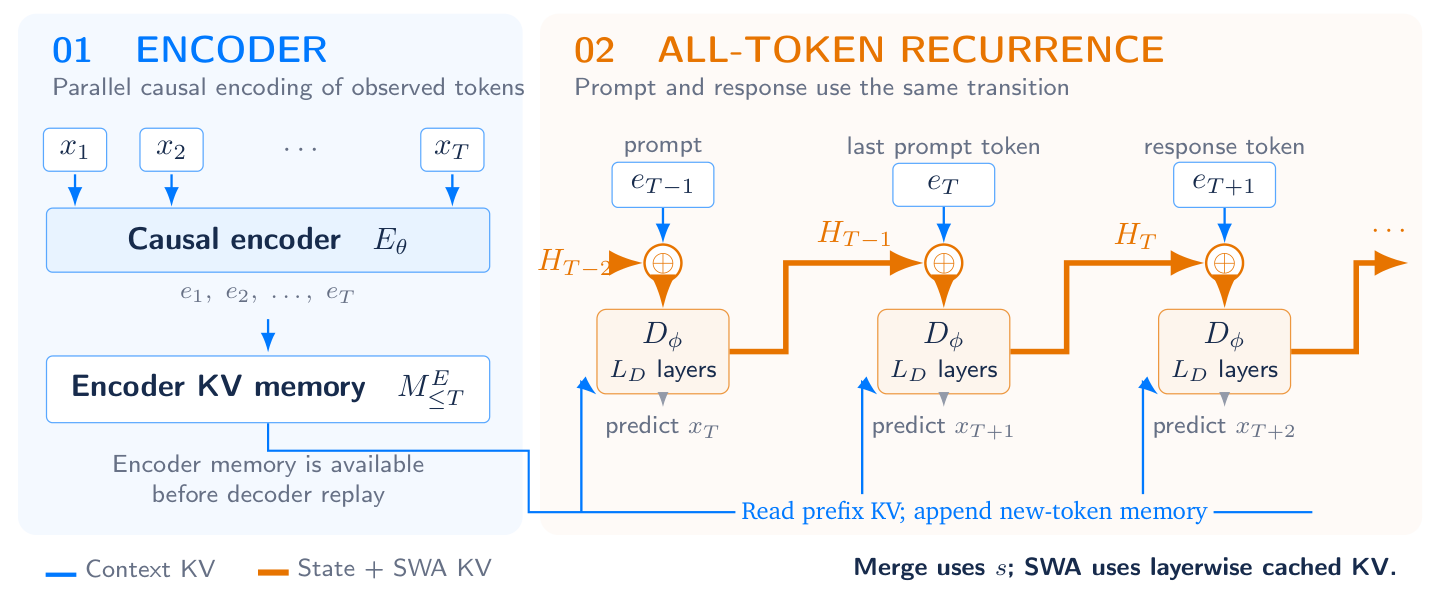
왼쪽에서 인과적 인코더가 관측 토큰을 병렬로 인코딩해 KV 메모리를 만들고, 오른쪽에서 재귀 디코더가 프롬프트 토큰과 응답 토큰을 같은 전이로 통과하는 구조 도식

Recurrent Looped Transformer

인과적 인코더가 전역 메모리를 만들고, 재귀 디코더가 프롬프트와 응답의 모든 토큰을 지나며 하나의 상태를 이어간다. 학습과 샘플링과 강화학습 리플레이가 같은 전이를 쓰도록 설계했고, 측정된 성능 수치는 아직 한 줄도 없다.

September 14, 2026 · 4 분 · 서소영
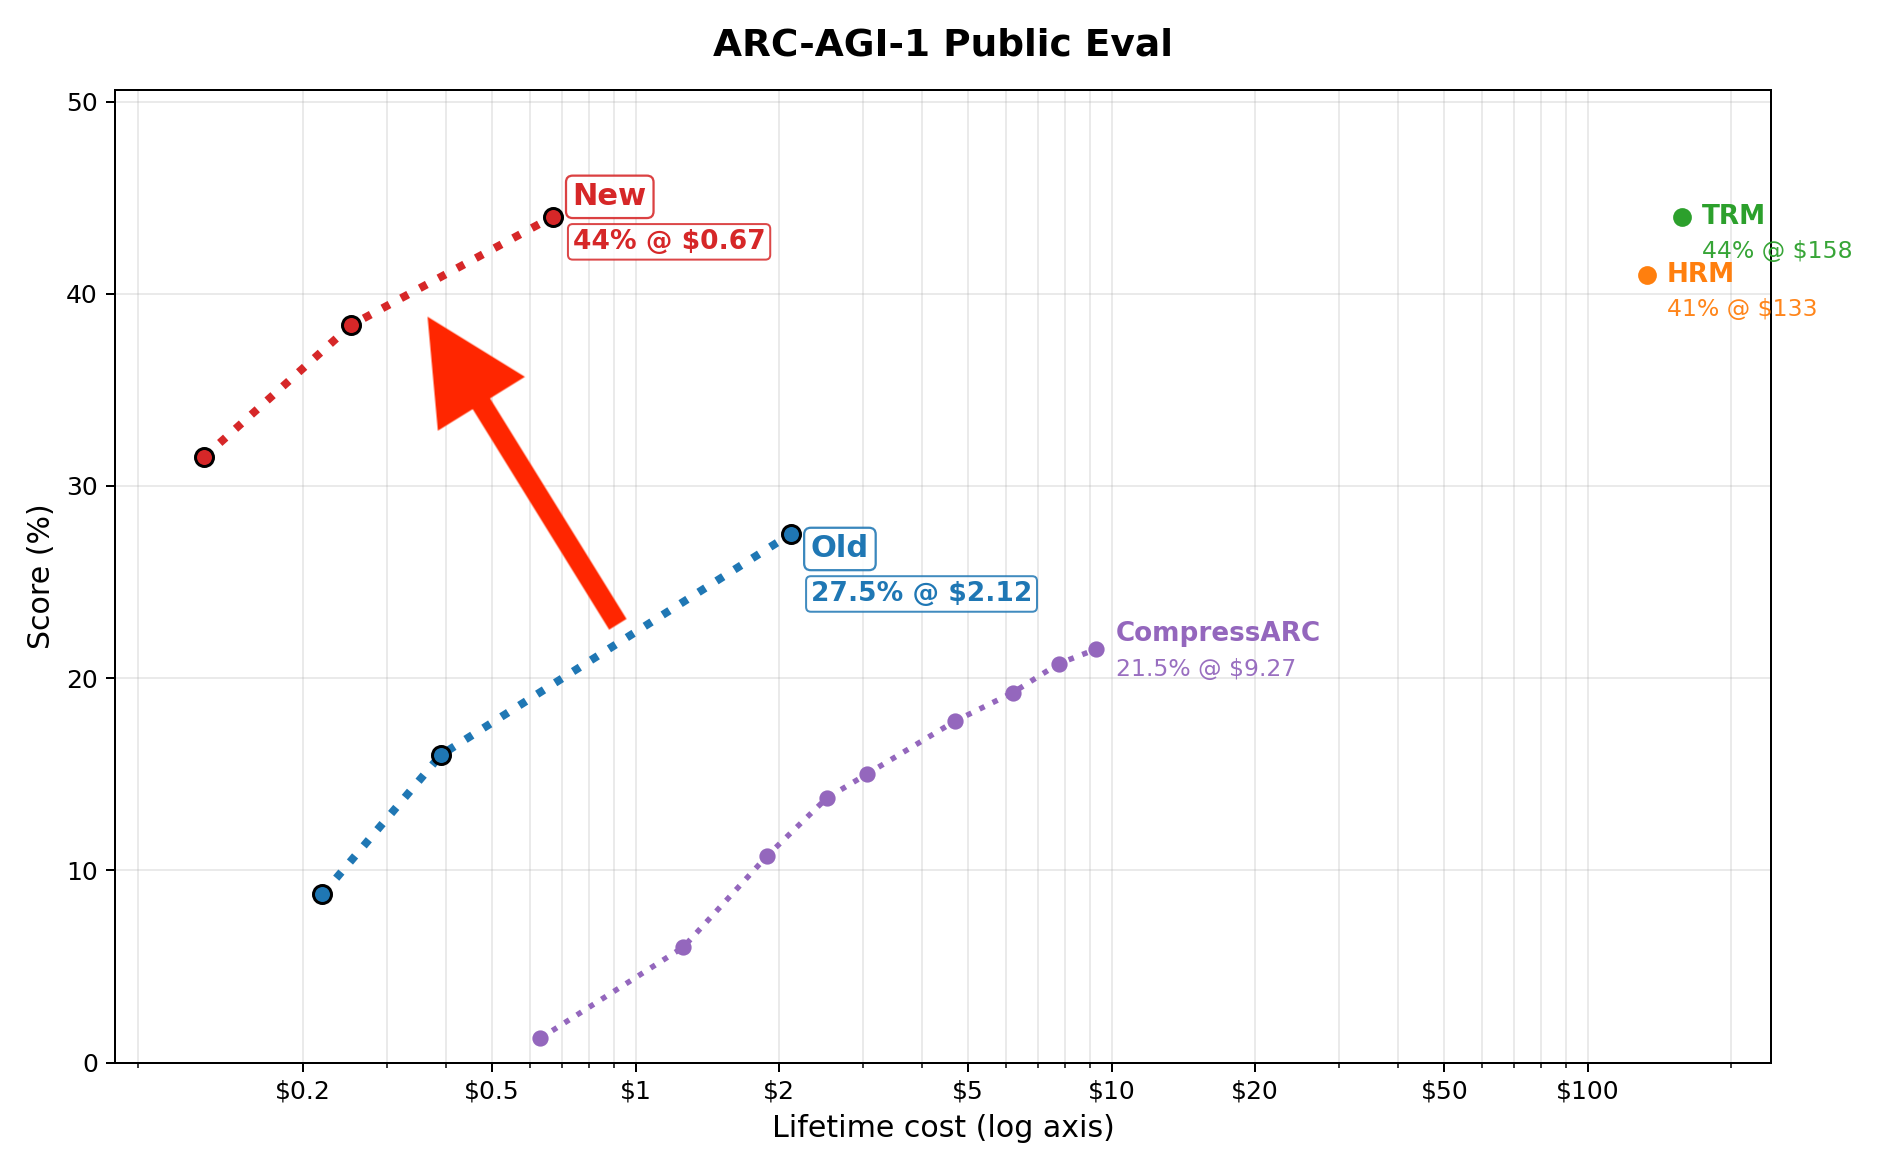
ARC-AGI-1 공개 평가 점수를 연산 비용 대비로 그린 그래프. mdlARC가 TRM과 HRM, CompressARC보다 왼쪽 위에 표시되어 있다.

44% on ARC-AGI-1 in 67 cents

RTX 5090 한 장에서 1시간 30분 학습시킨 소형 트랜스포머가 ARC-AGI-1 공개 평가에서 44%를 받았다. 학습과 추론을 합친 비용은 67센트였고, 성능의 대부분은 순환 구조보다 입력을 표현하는 방식에서 나왔다.

September 2, 2026 · 9 분 · 서소영
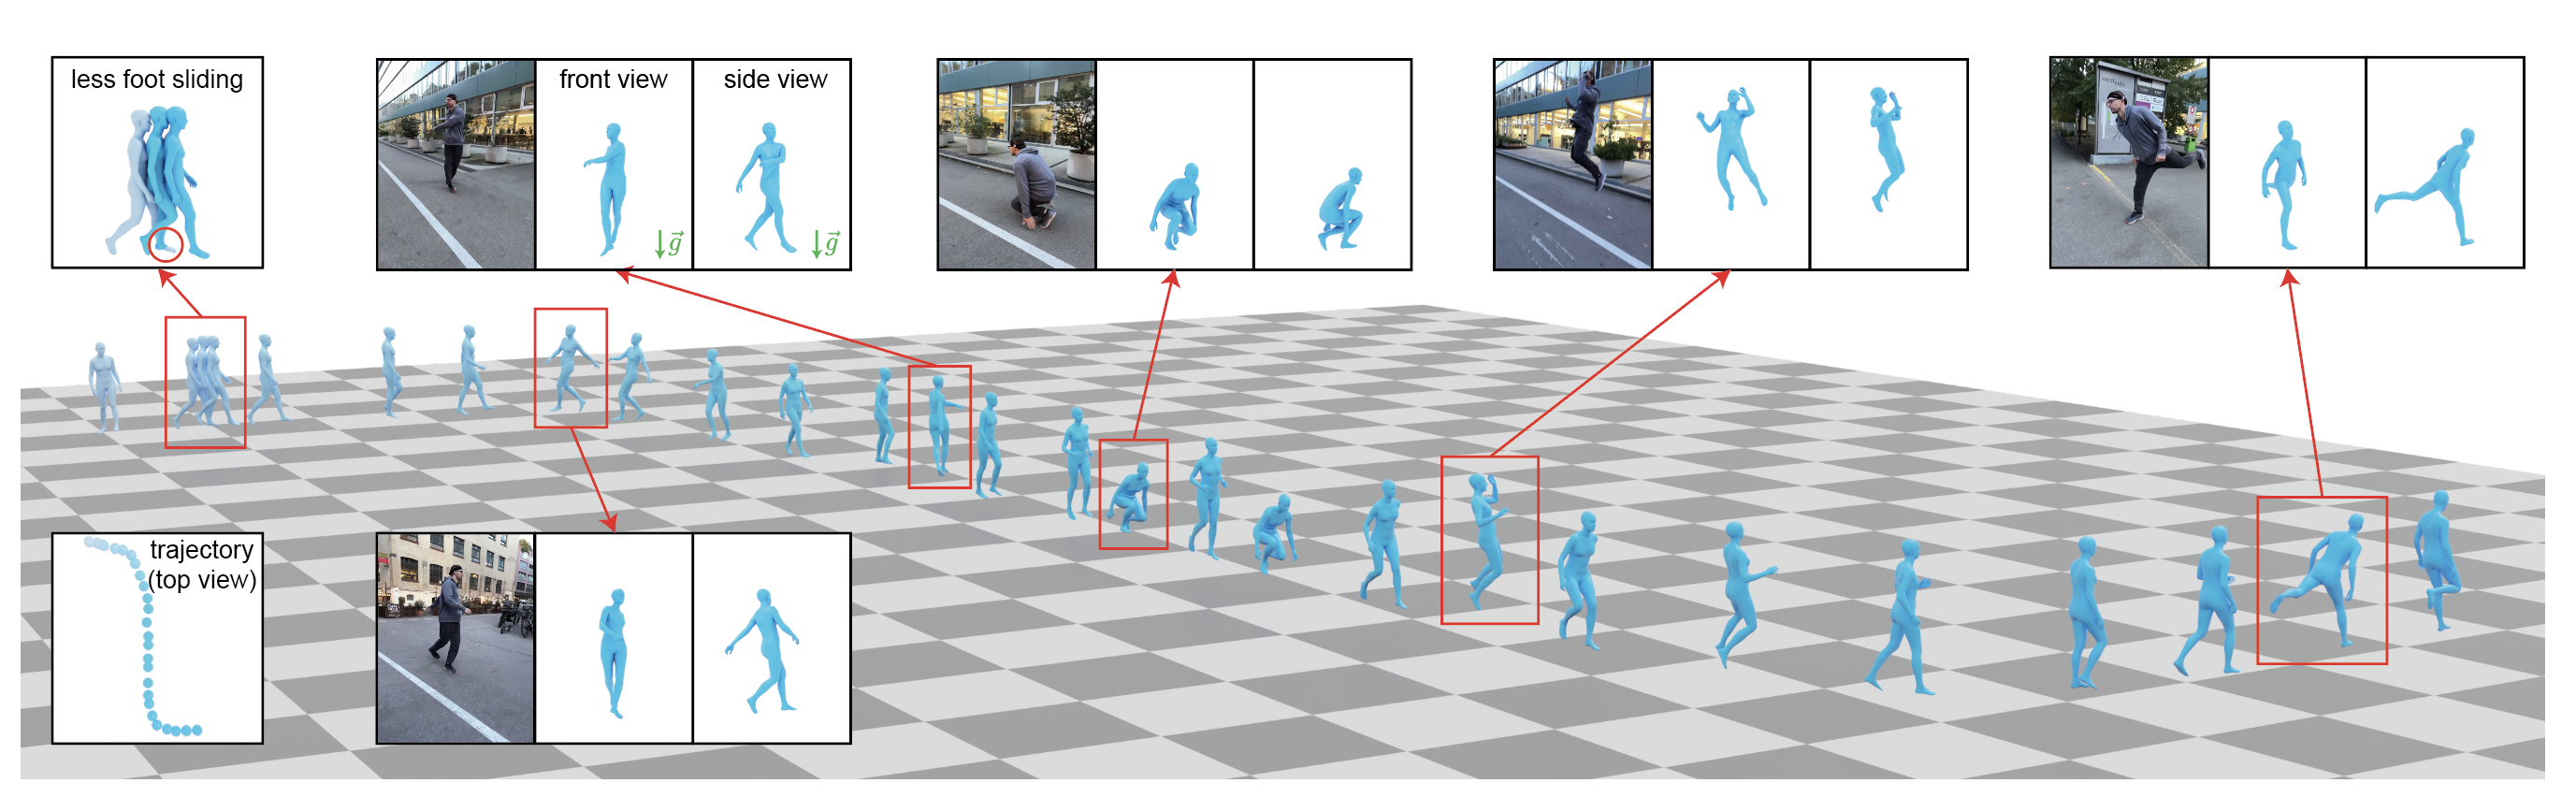
Teaser: GVHMR의 세계 좌표계 인간 동작 복원 결과

World-Grounded Human Motion Recovery via Gravity-View Coordinates

Shen 외(Zhejiang Univ., SIGGRAPH Asia 2024)가 단안 비디오에서 세계 좌표계 기반 인간 동작을 복원하는 방법을 제시한다. 각 프레임마다 중력 방향과 카메라 시선으로 유일하게 정의되는 Gravity-View 좌표계에서 자세를 예측해 자기회귀 오차 누적을 없애고, RoPE 트랜스포머로 45초짜리 1430프레임 시퀀스를 0.28초에 처리한다. RICH·EMDB 벤치마크에서 세계 좌표 W-MPJPE를 WHAM 대비 31% 낮췄다.

July 1, 2026 · 6 분 · 서소영
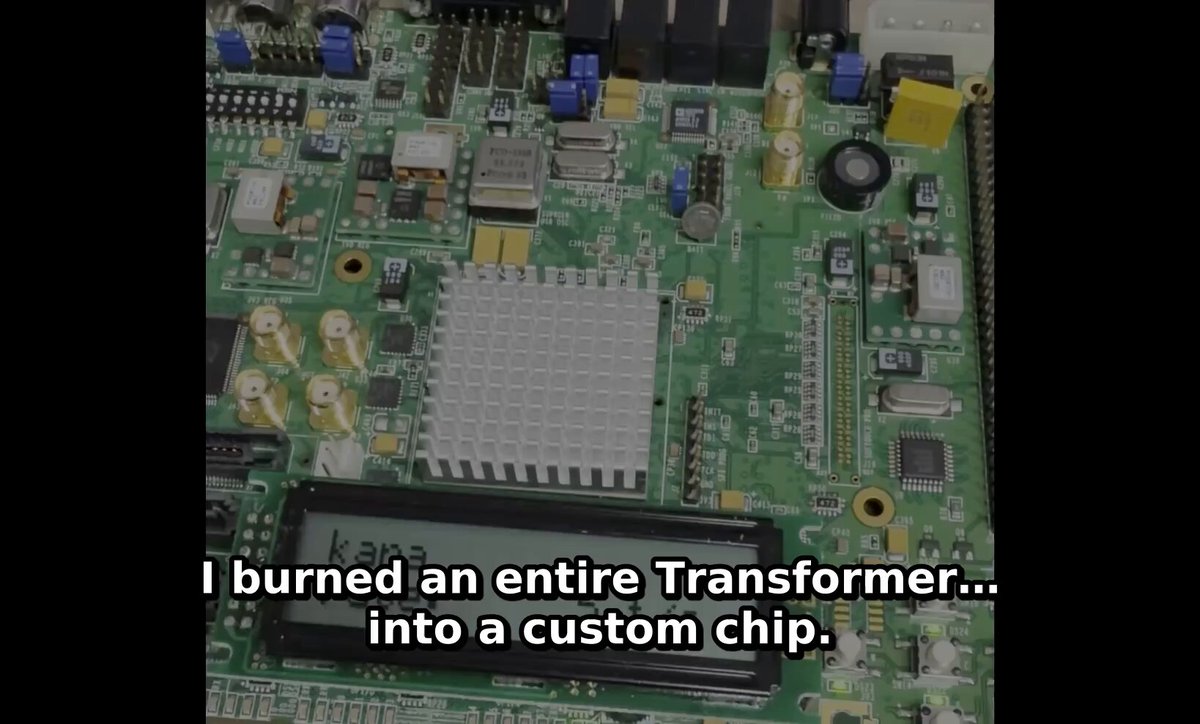
gateGPT 보드 데모 — Virtex-5 FPGA가 LCD에 이름을 출력

gateGPT — 트랜스포머를 게이트 단위로 새기다

Fabio Guzman이 Karpathy의 microGPT를 Xilinx Virtex-5 FPGA에 Verilog RTL로 직접 합성한 프로젝트. 80 MHz에서 ~56k 토큰/초로 이름을 LCD에 출력하고, 9단계 최적화로 28× 가속을 달성했다. 단일 최대 기여는 KV 캐시(3.2×).

June 16, 2026 · 6 분 · 서소영
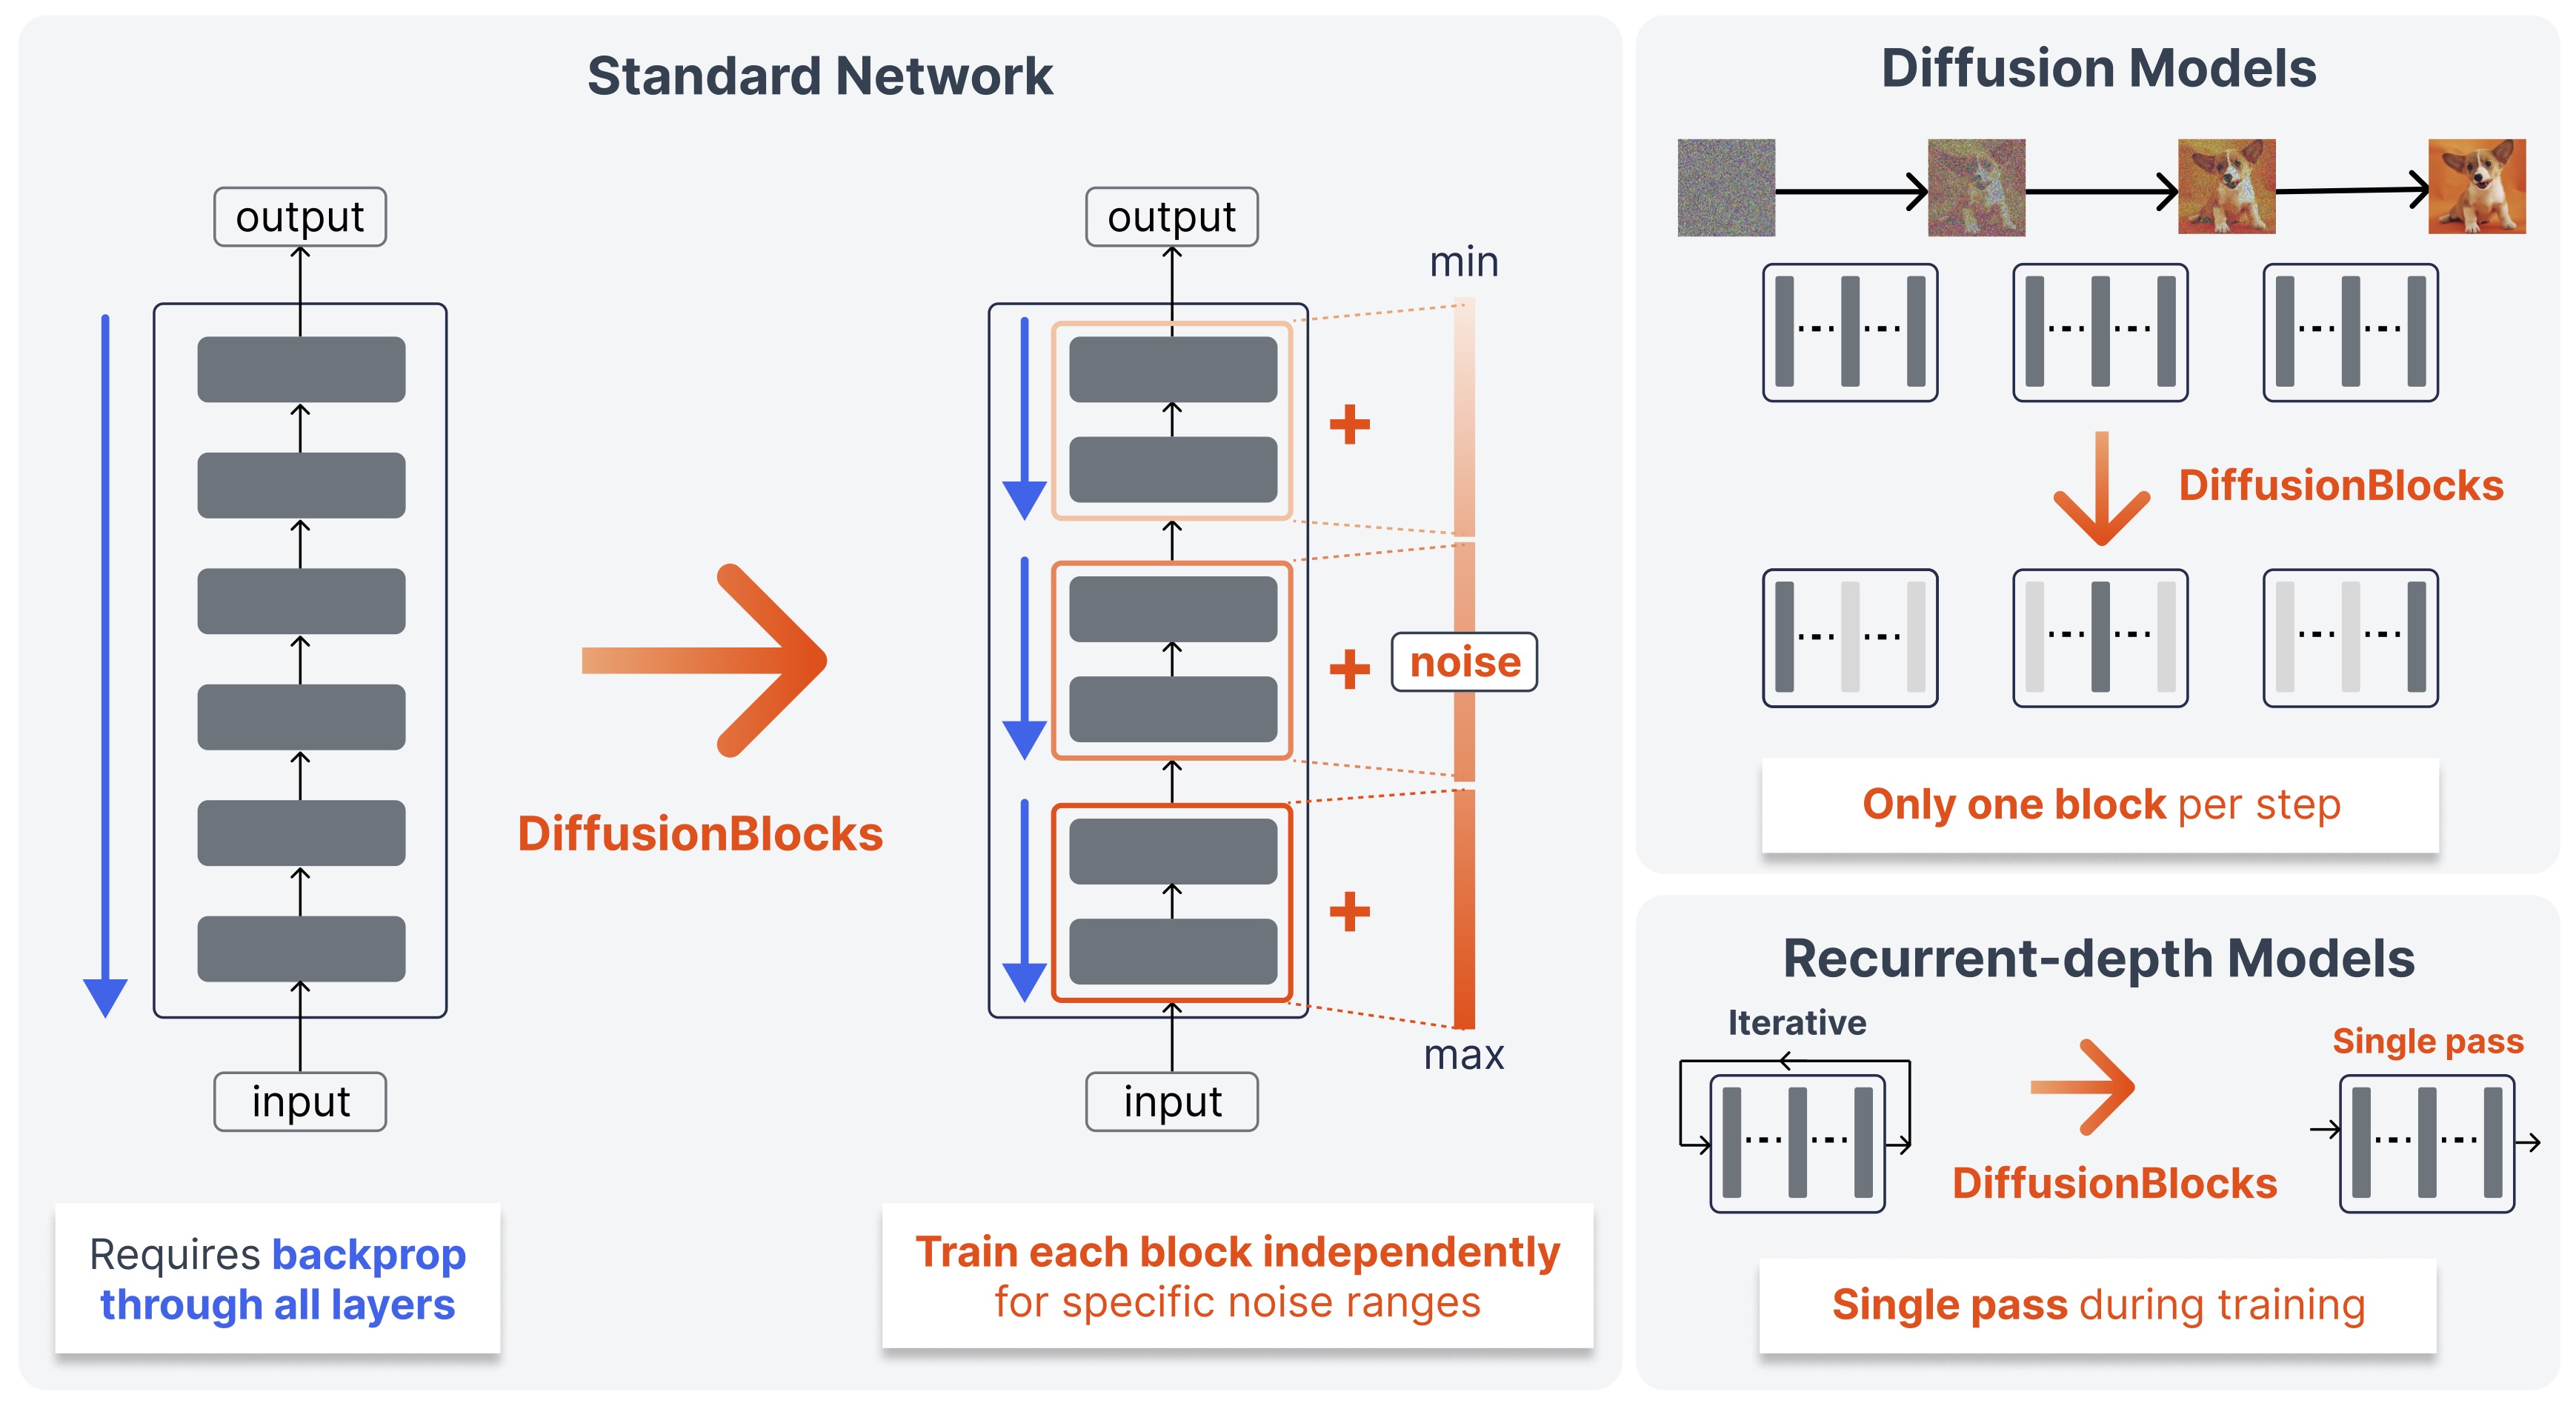
DiffusionBlocks 개요 — (좌) 표준망은 전 계층 역전파가 필요하다, (중) DiffusionBlocks는 네트워크를 블록으로 나눠 각자 맡은 노이즈 구간을 독립 학습한다, (우) 확산 모델은 스텝당 블록 하나만, recurrent-depth 모델은 반복 학습을 단일 패스로 대체한다

DiffusionBlocks: Block-wise Neural Network Training via Diffusion Interpretation

엔드투엔드 역전파의 메모리 병목을, 트랜스포머의 잔차 연결이 확산 모델 ODE의 이산화와 같다는 통찰로 푼 논문. 네트워크를 노이즈 구간별 독립 블록으로 쪼개 한 번에 한 블록만 학습하니 메모리가 블록 수만큼 줄고, 5개 아키텍처에서 엔드투엔드에 필적했다.

May 28, 2026 · 5 분 · 서소영
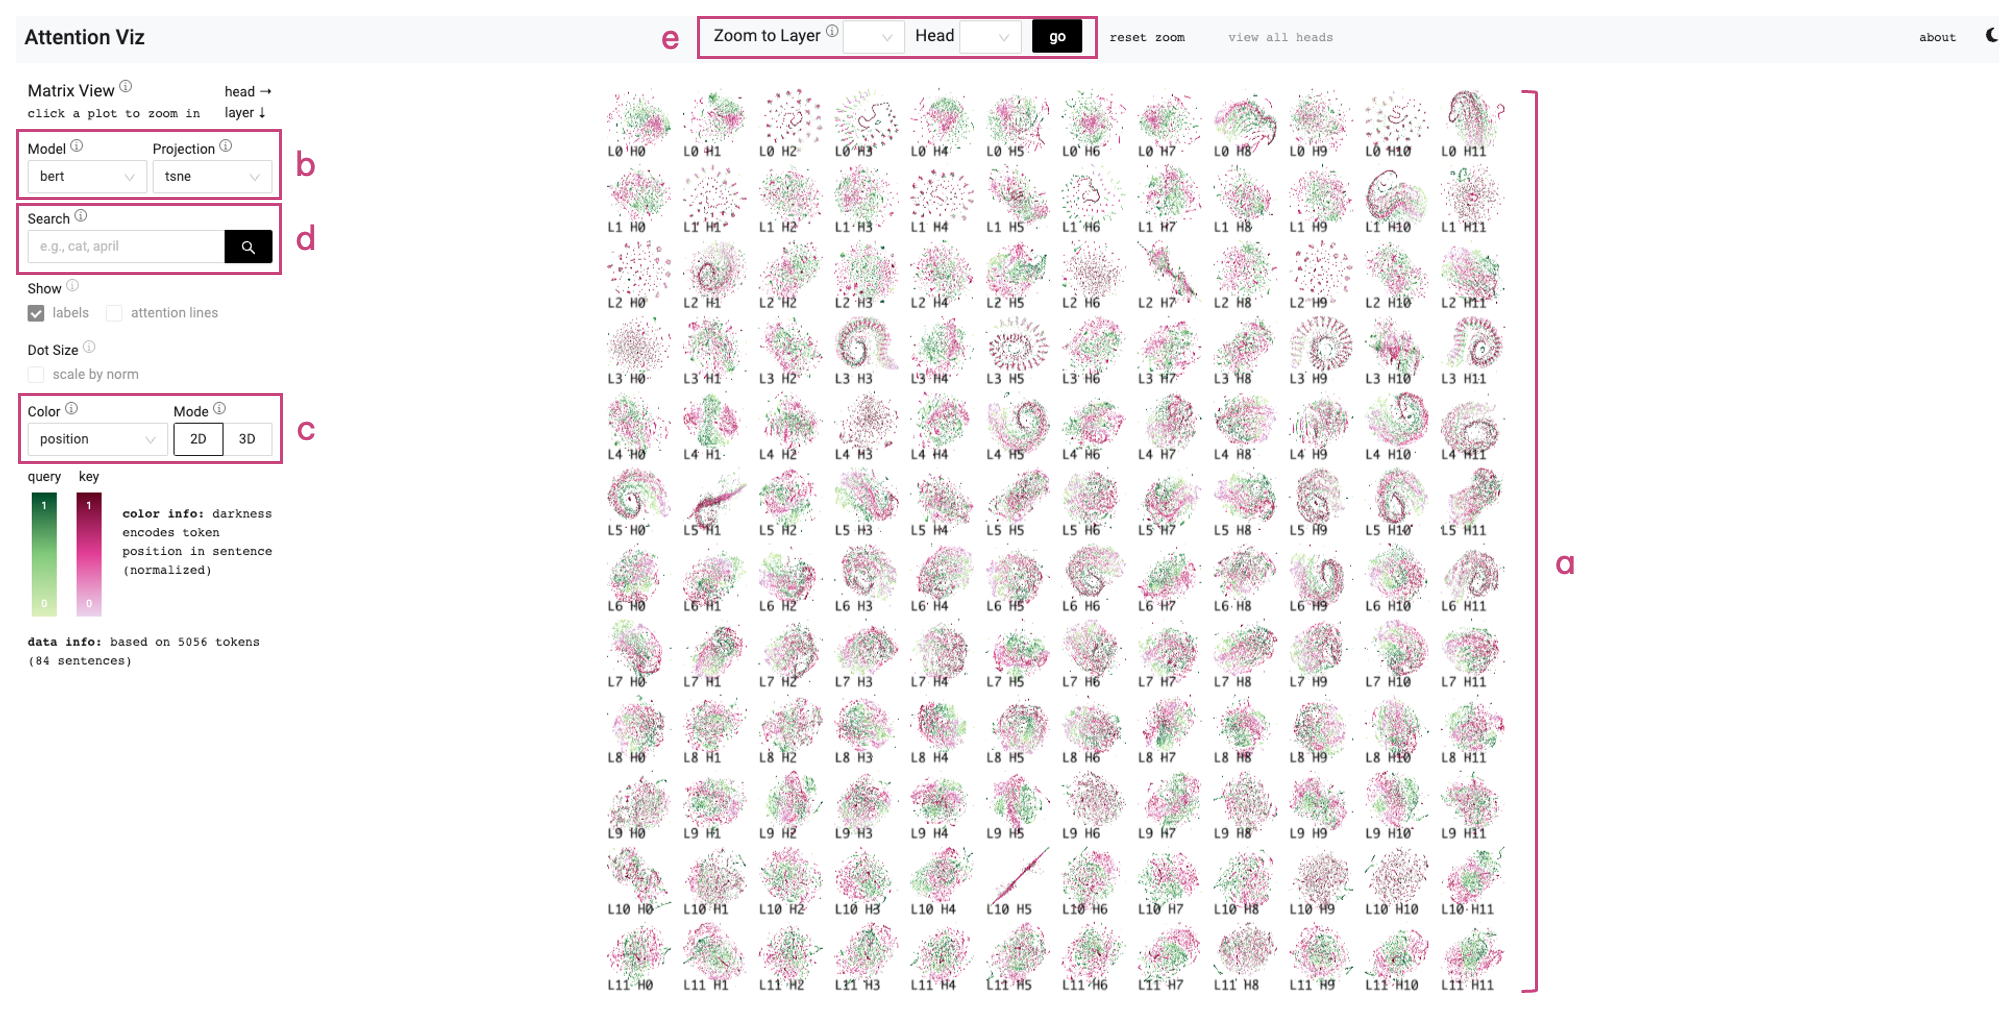
Matrix View — 144개 헤드를 한 화면에

AttentionViz: A Global View of Transformer Attention

트랜스포머 어텐션을 단일 문장의 bipartite 그래프가 아니라 다수 입력에 걸친 query-key joint embedding으로 사영해 헤드 전체를 한눈에 비교하는 시각화 기법과 도구 AttentionViz. BERT의 나선·induction head, ViT의 hue·brightness 헤드, GPT-2의 norm disparity 같은 발견을 사례로 든다.

May 21, 2026 · 8 분 · 서소영