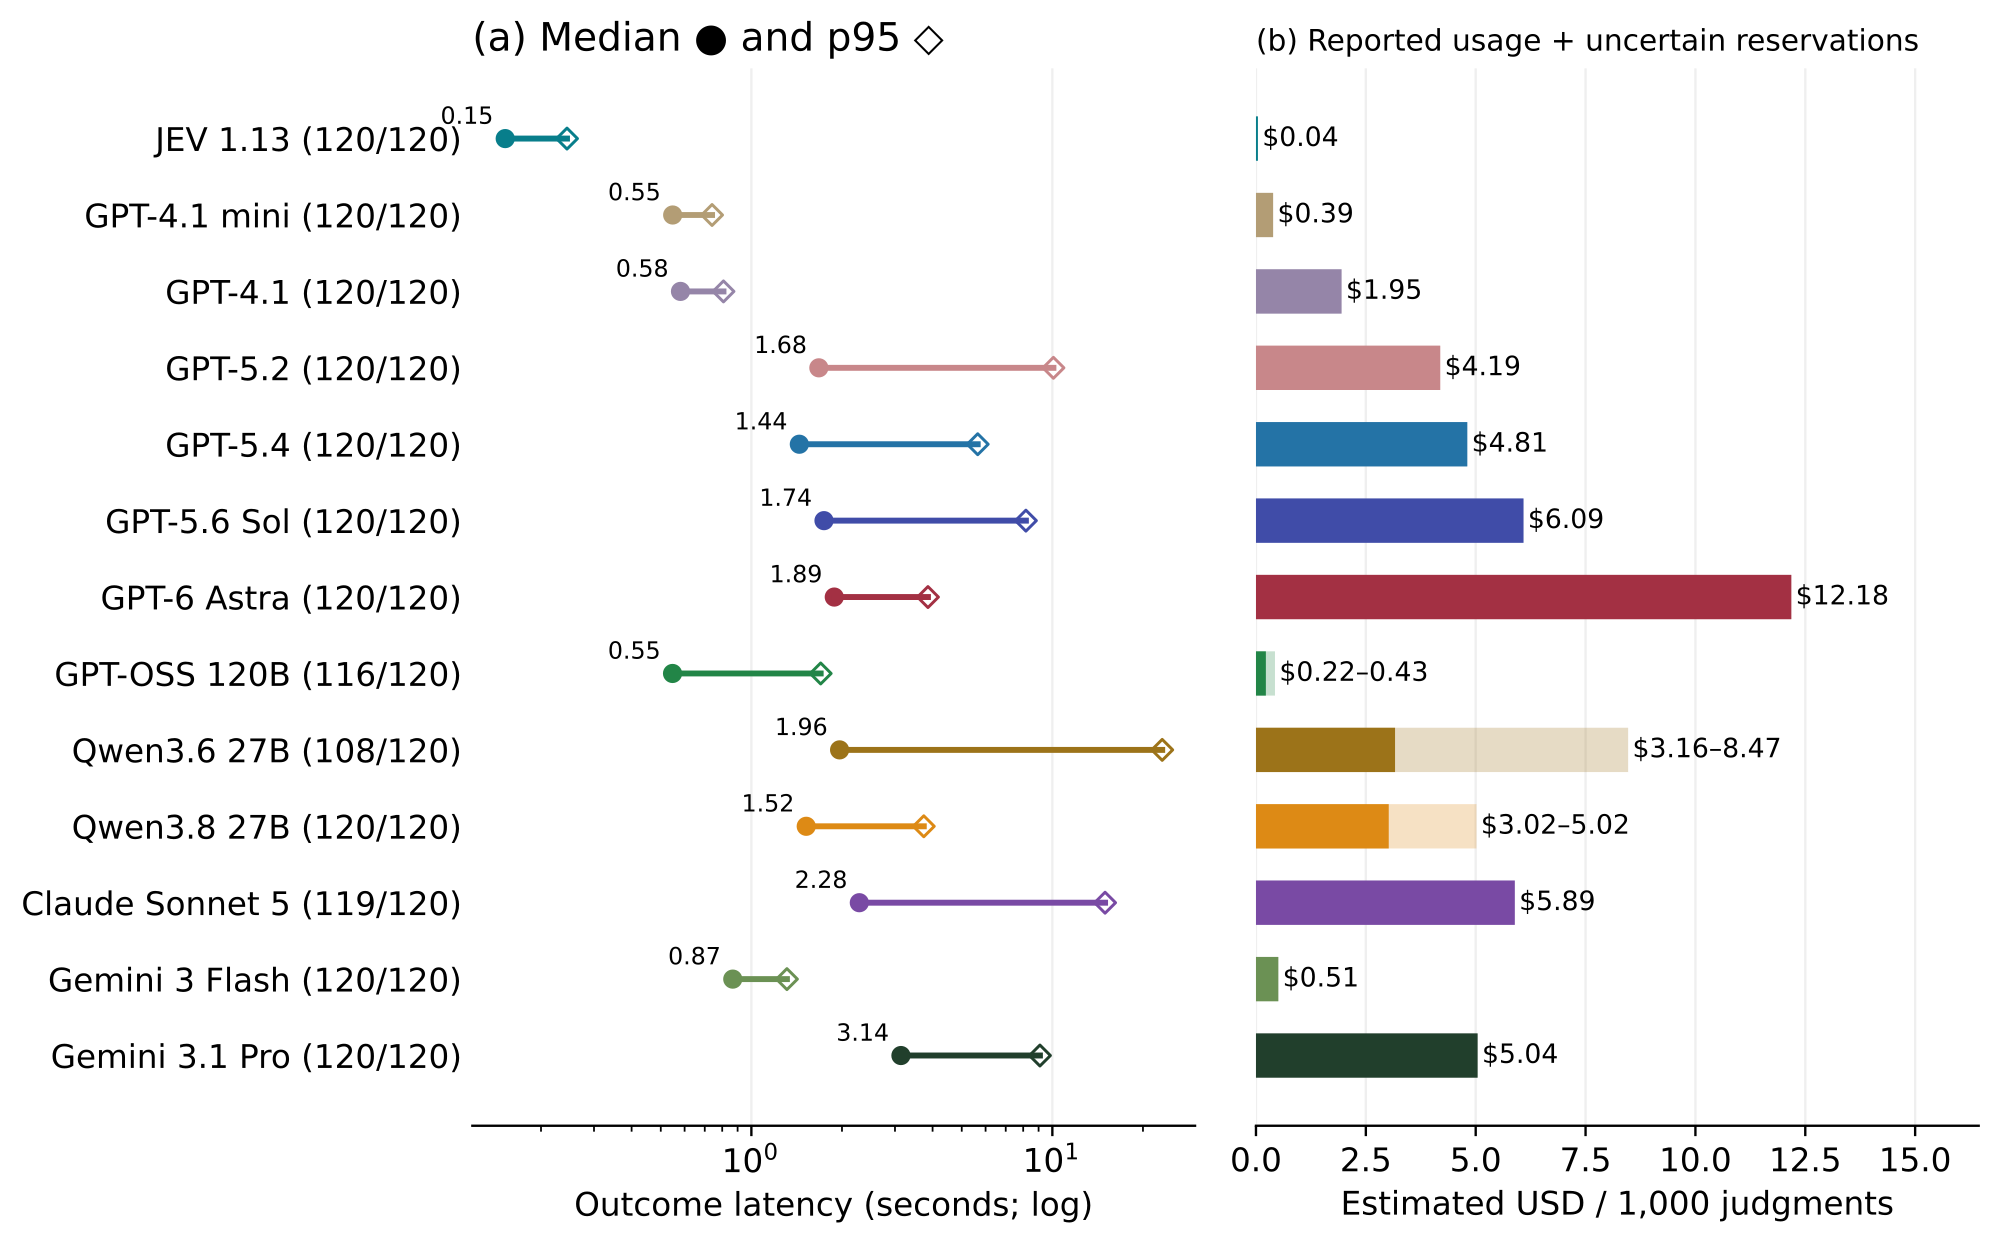
호스팅 판정자 13종의 지연과 비용을 비교한 원문 그림 2. 왼쪽 패널은 로그 척도로 그린 판정 지연의 중앙값과 95퍼센타일이며, JEV 1.13의 중앙값이 0.15초로 가장 짧다. 오른쪽 패널은 판정 1,000건당 추정 비용이며, JEV가 0.04달러, GPT-6 Astra가 12.18달러다. 출처: Li et al., arXiv:2609.26550, CC BY 4.0

JEV-as-a-Judge: Accept When Confident, Escalate When Unsure

카네기멜런대 연구진이 판정과 레이블 확률만 반환하는 TypeSafe의 JEV를 LLM 판정자로 쓰고, 생성형 판정자와 보상 모델 16종과 비교했다. 일반적인 선호 판정과 근거 문서 기반 사실성 판정에서 JEV는 GPT-6 Astra와 3%포인트 이내의 정확도를 GPT-6 비용의 0.36%로 냈다. 확신할 때만 JEV 판정을 채택하는 캐스케이드는 GPT-6 정확도의 99%를 비용 57%로 유지했다.
September 25, 2026 · 16 분 · 서소영
갈림길에 선 치비 서소영. 왼쪽에서는 똑같이 생긴 도구 두루마리 백 개를 부채처럼 펼쳐 놓고 어느 것을 골라야 할지 몰라 곤란해하고, 오른쪽에서는 작은 기계가 건네준 두루마리 한 장에 붓으로 서명만 하고 있다.

jev-eval-agent: Who picks the tool, the LLM or Jev?

도구 100개를 가진 개인 비서 에이전트에서 다음 도구를 LLM이 직접 고를 때와 분류기 Jev가 대신 고를 때를 같은 과제 위에서 비교한 저장소. 모델 7종을 돌린 결과 입력 토큰은 85% 줄었지만 모델 호출은 32% 늘었고, 이름이 닮은 도구에 LLM이 걸린다는 출발 가설은 확인되지 않았다.

September 18, 2026 · 8 분 · 서소영
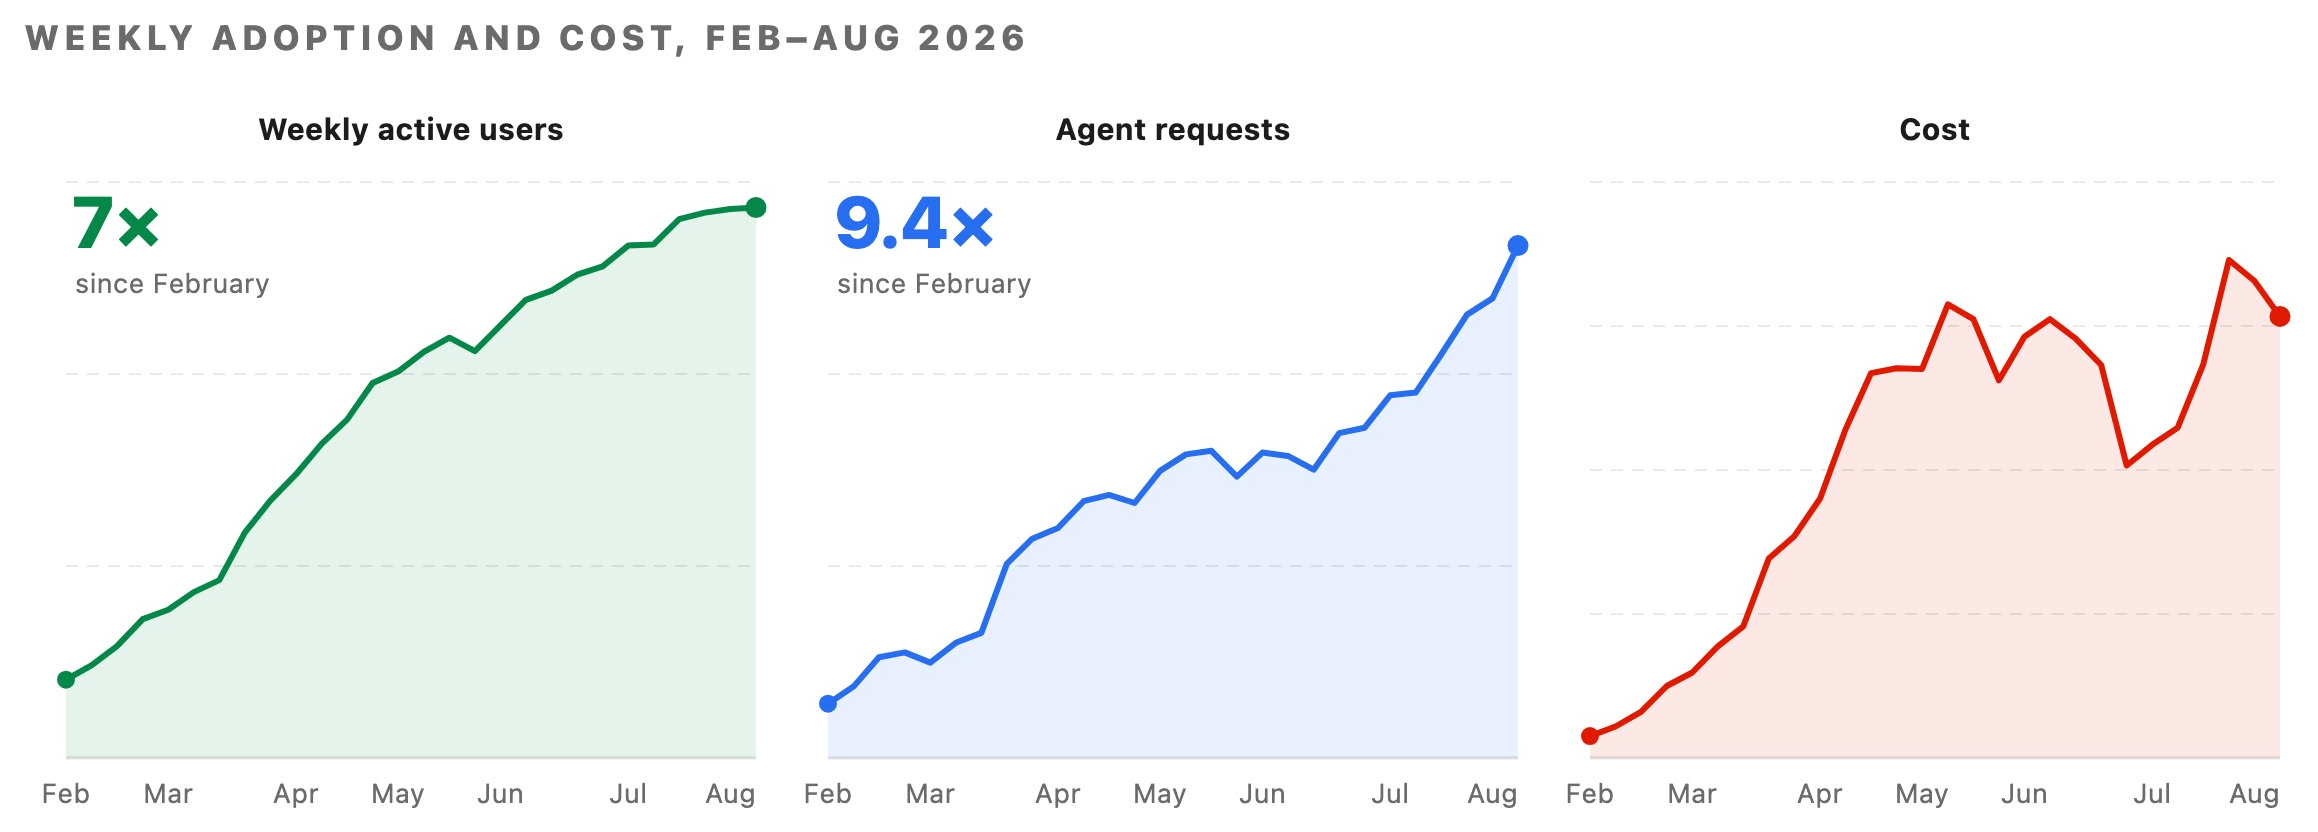
주간 활성 사용자와 에이전트 요청은 2월부터 8월까지 급격히 늘었고, 총비용은 4월 이후 평평하다

Running a Software Factory Efficiently at Uber Scale

우버가 사내 AI 코딩 사용량을 7배로 키우면서 요청 1,000건당 비용을 34% 낮춘 기록. 지출을 여섯 항의 곱으로 분해하고, 사람이 요청한 일이 아니라 에이전트가 자기 편의로 쓰는 토큰만 골라 깎았다.

August 31, 2026 · 10 분 · 서소영
Loop Engineering for AI Agents: Memory-First Design — Mem0 블로그의 표제 이미지.

Loop Engineering for AI Agents: Memory-First Design

루프 엔지니어링을 ‘기억’ 한 축에서 다시 보는 글. 한 단계에 얼마나 많은 컨텍스트를 모델에 보일지를 두고 토큰이 풍부한 루프와 빈약한 루프가 갈리며, 그 사이의 균형을 잡는 열쇠가 명시적 메모리 계층임을 분명히 밝힌다. 메모리 인프라 기업 Mem0의 관점이 깔린 글이지만, 루프의 기억이라는 차원을 정면으로 다룬다는 점에서 연재를 닫는 좌표로 삼을 만하다.

June 21, 2026 · 9 분 · 서소영