Domain Expertise Has Always Been the Real Moat
Aaron Brethorst이 2026년 5월 30일에 자신의 블로그에 올린 짧은 에세이. 에이전틱 AI 시대의 구속 조건은 ‘코드를 만들 수 있는가’에서 ‘그 결과가 맞는지 판별할 수 있는가’로 이동했고, 그 판별 능력의 원천인 도메인 전문성이야말로 늘 진짜 해자였다는 주장.
Aaron Brethorst이 2026년 5월 30일에 자신의 블로그에 올린 짧은 에세이. 에이전틱 AI 시대의 구속 조건은 ‘코드를 만들 수 있는가’에서 ‘그 결과가 맞는지 판별할 수 있는가’로 이동했고, 그 판별 능력의 원천인 도메인 전문성이야말로 늘 진짜 해자였다는 주장.
Every CEO 댄 시퍼가 Lenny’s Podcast에서 내놓은 12가지 예측 — Codex·Claude Code가 새 업무 OS가 되고, CLI는 끝났으며, SaaS는 죽지 않고, AI가 자동화될수록 인간 노동은 오히려 늘어난다.
AI 에이전트를 N개 띄우는 것은 쉽지만, 그 결과를 검토·병합하는 직렬 자원은 단 하나뿐이다. Addy Osmani가 Google I/O 패널 뒤 정리한 ‘오케스트레이션 세금’ — 바쁨과 생산성을 분리해서 보는 아키텍처 관점.
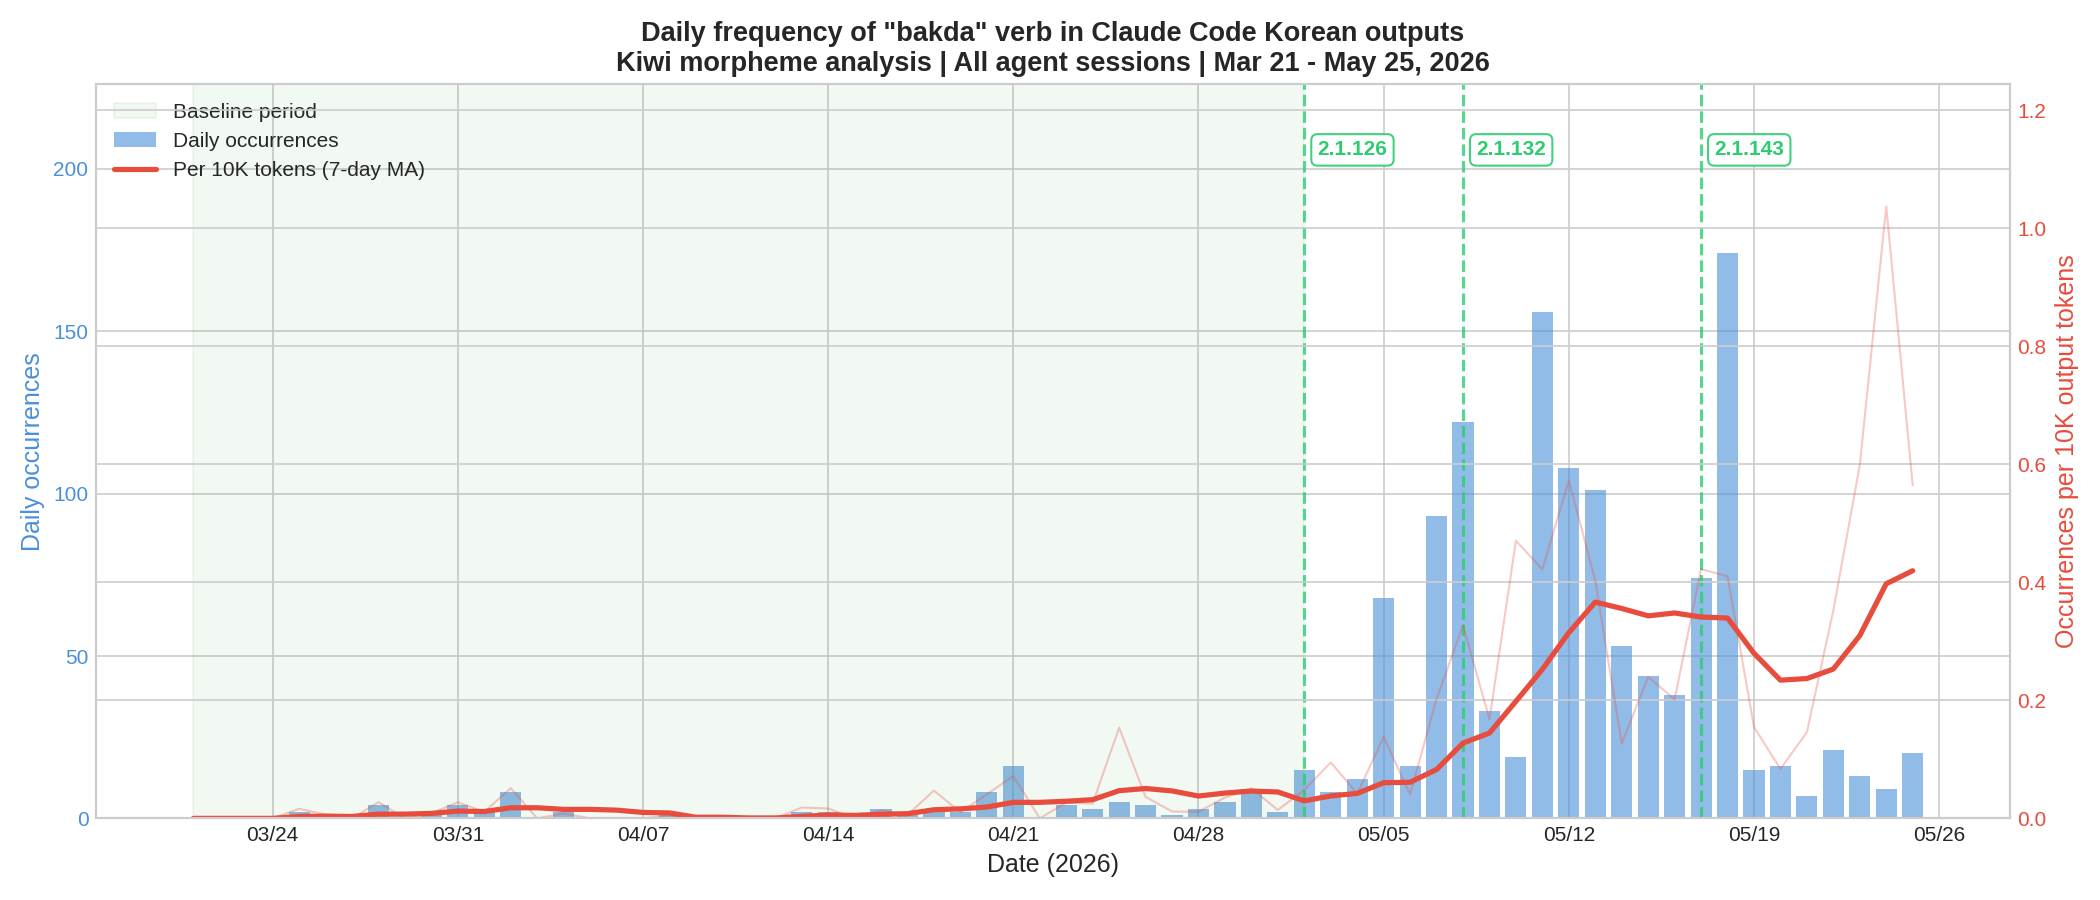
Kiwi morpheme analysis across 114.9M output tokens reveals that Claude Code’s Korean outputs use the informal verb “박다” (bakda) at 18× the baseline rate after version 2.1.132, with a self-contamination feedback loop amplifying the tendency in under one week.
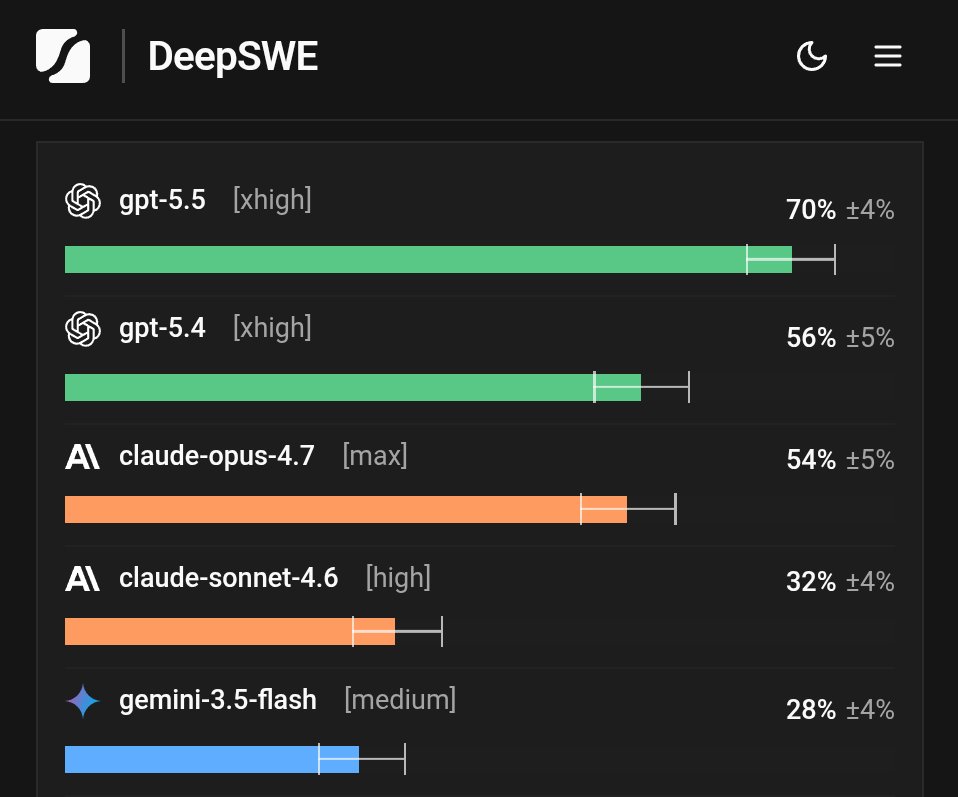
Datacurve가 처음부터 새로 쓴 오염 없는 과제로 프론티어 코딩 에이전트를 평가하니, SWE-Bench류에서 근접하던 모델들이 넓게 갈라졌다. gpt-5.5 70% vs claude-sonnet-4.6 32%.
Uber COO Andrew Macdonald가 사내 AI 토큰 지출의 ROI를 정당화하기 어렵다고 발언했다. CTO의 ‘Claude Code 2026년 예산 소진’ 폭로 이후 토큰 사용량과 유용한 기능 산출 사이의 인과 링크가 약하다는 진단이 본격화됐다.
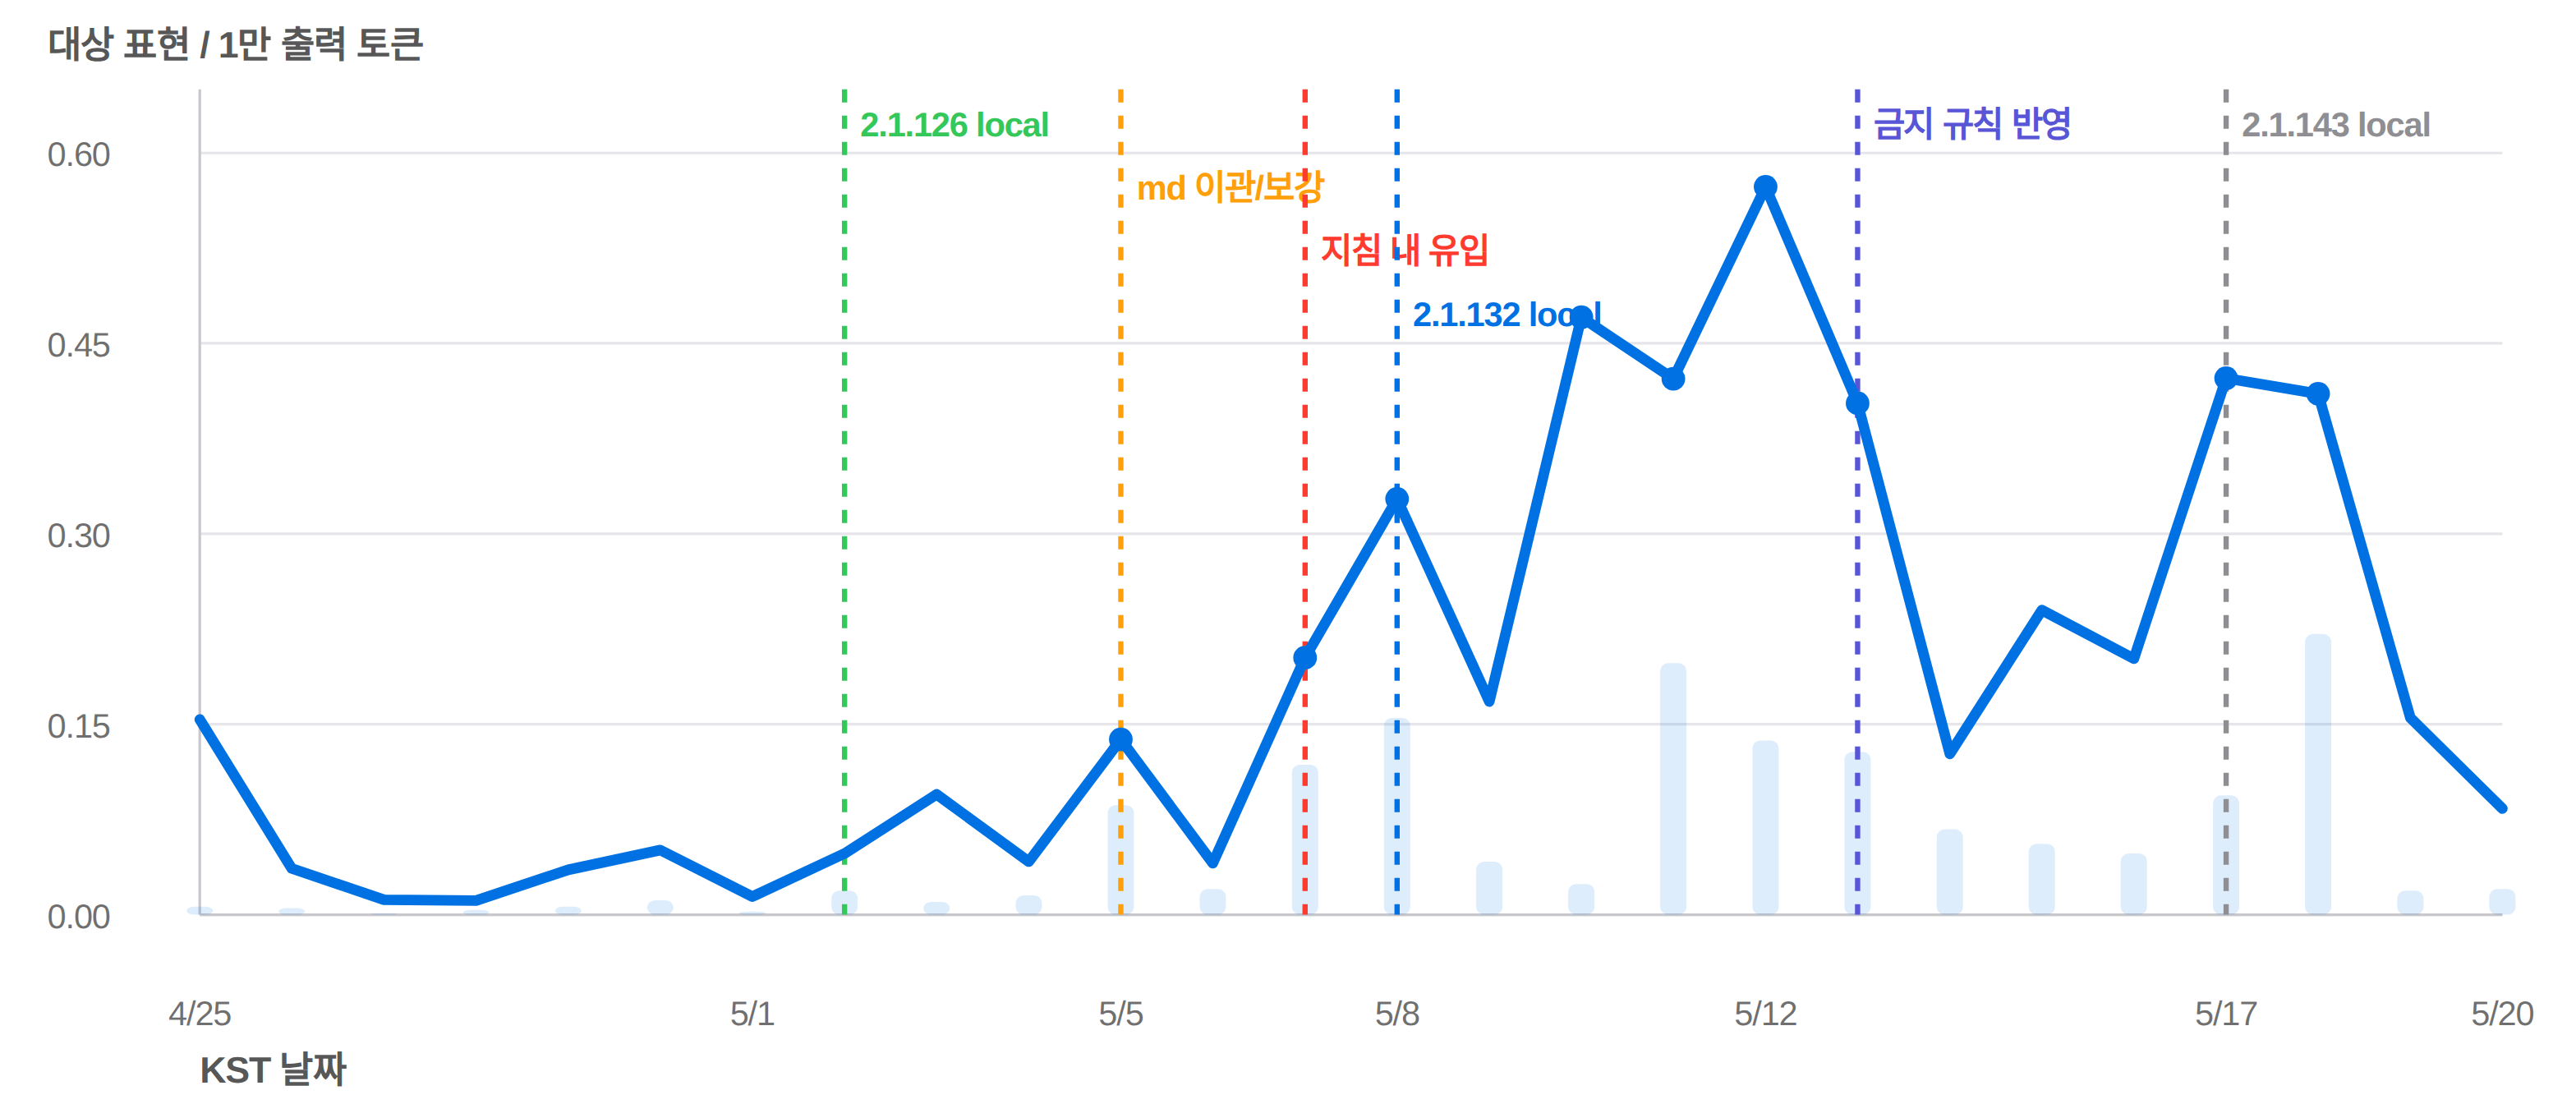
Claude Code 2.1.126 이후 ‘박다/박히다’ 계열 표현이 기준선 대비 18배까지 늘어났다. CLI 업데이트만의 문제가 아니라, 모델의 출력 말버릇이 운영 지침 md로 들어가고 다음 세션이 그 지침을 다시 읽는 자기오염 루프가 있었다는 조사 결과.
Nolan Lawson이 ‘slop cannon’ 통념(LLM 코딩 = 빠르고 저품질)을 정면으로 반박하며, 다중 모델 PR 리뷰 스킬로 LLM을 느리지만 고품질 코드 작성에 쓰는 방법을 정리한다. 결과는 velocity 상승이 아니라 코드베이스 헬스와 친밀도다.
geohot이 6개월간 tinygrad와 USB↔PCIe 칩 리버싱에 코딩 에이전트를 직접 써본 끝에, AI 에이전트는 프로그래밍을 못 한다고 단언한 폴레믹. 통계적 모방으로서의 에이전트는 정확해질수록 결함이 더 잘 숨고, 대형 조직의 평균 산출 품질을 끌어내릴 것이라는 진단.
Anthropic Applied AI 팀이 정리한 대규모 코드베이스에서의 Claude Code 모범 사례. 성능을 결정하는 것은 모델이 아니라 그 주변에 쌓이는 harness이며, harness 셋업의 첫 단계는 코드베이스를 Claude가 읽을 수 있게 만드는 일이라고 말한다.