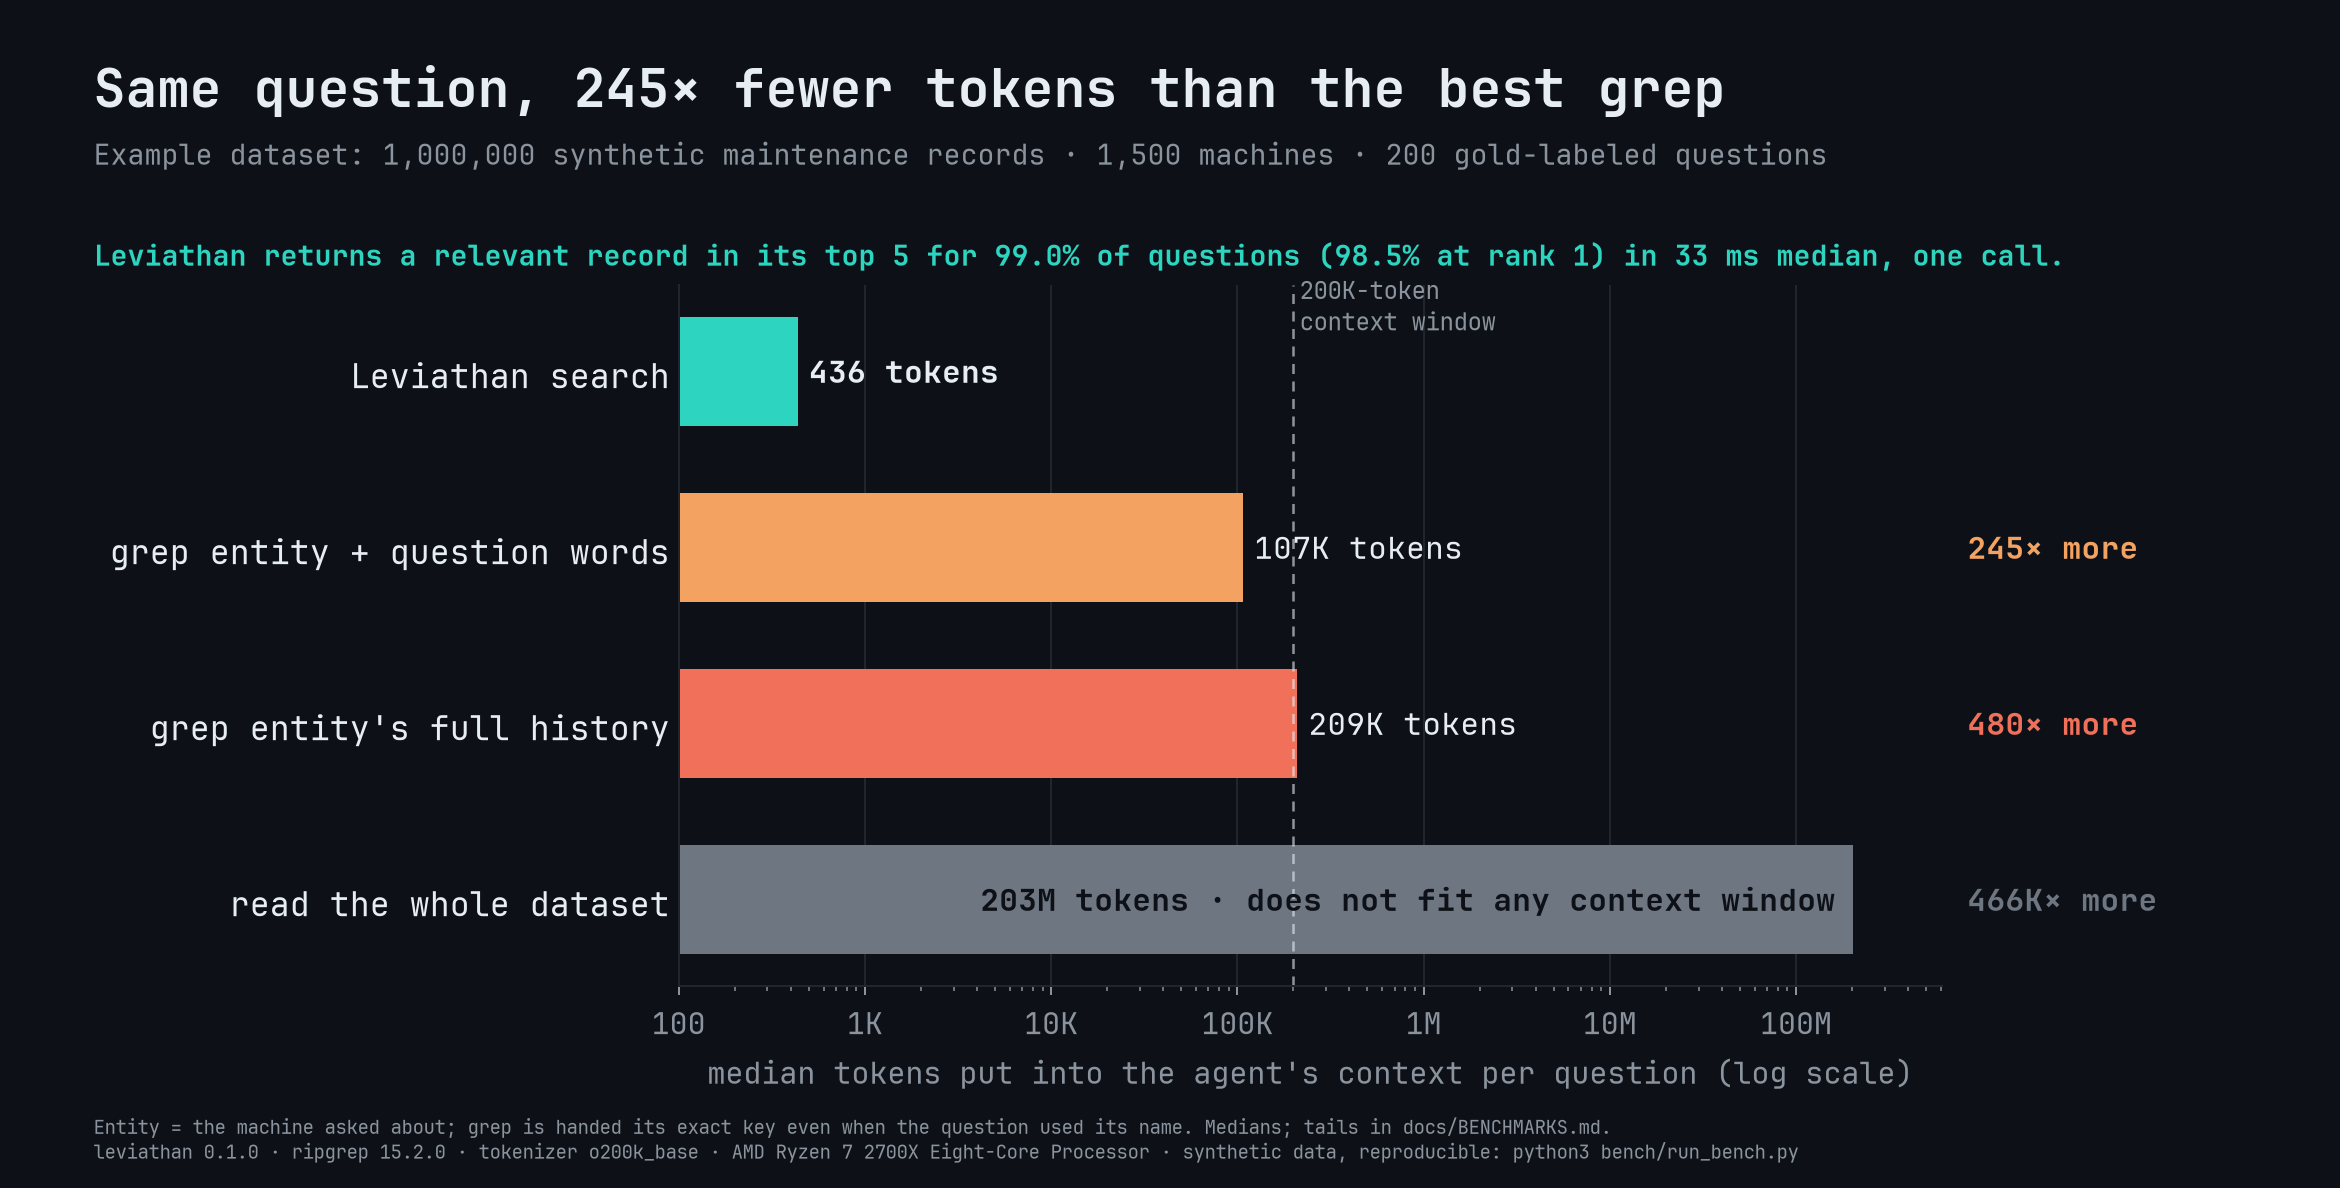
레코드 100만 건에서 질문 하나에 컨텍스트로 들어가는 토큰 중앙값을 로그 눈금 막대그래프로 비교한 그림. Leviathan 검색 436토큰, 단어 필터 grep 107K토큰(245배), 이력 전체 grep 209K토큰(480배), 데이터셋 전체 읽기 203M토큰(46만 6천 배)이고, 20만 토큰 컨텍스트 창 경계가 점선으로 표시되어 있다.

Leviathan: Deep memory for agents over large datasets

Joshua Baker가 2026년 10월 5일 공개한 Rust 프로그램 Leviathan은 JSONL, CSV, SQLite 같은 형식의 레코드를 SQLite 전문 검색 인덱스 하나로 만들어 둔다. 에이전트가 질문하면 순위를 매긴 레코드 몇 건을 약 450토큰 분량으로 돌려준다. 합성 정비 기록 100만 건 벤치마크에서 grep 방식보다 245배 적은 토큰을 쓰면서, 질문의 99.0%에서 정답 레코드를 상위 5건에 포함했다.
October 6, 2026 · 13 분 · 서소영
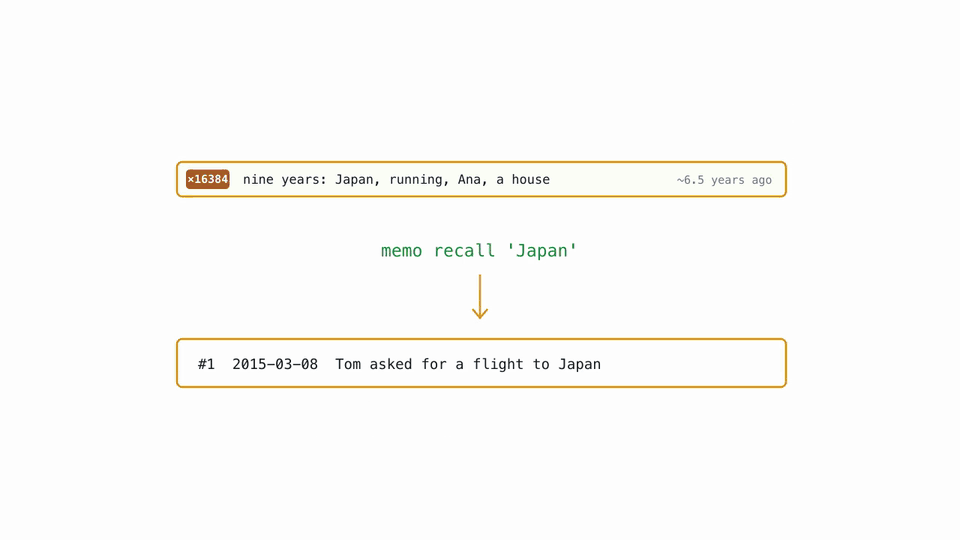
OptMem 공식 애니메이션에서 오래된 요약과 Japan 원문 검색 결과를 함께 보여주는 장면

OptMem: Permanent memory for AI agents. A 426-token prompt, a script, plug and play.

OptMem은 원문 기록을 보존하고 오래된 기록을 이진 트리로 요약하는 에이전트 메모리 도구다. Python 스크립트 하나와 짧은 지시문으로 기록, 요약, 검색을 사용할 수 있다.

October 5, 2026 · 3 분 · 서소영
치비 서소영이 두루마리 더미를 옆에 둔 채 쪽지 한 장만 전령 참새에게 건네고, 다른 손으로는 색인 카드 서랍을 연다

에이전트 지침을 줄일 때 문장보다 먼저 본 것

세션 296개를 재 보니 지침 낭비의 가장 큰 원인은 규칙 문장보다 전달 구조였다. 받는 세션을 구분하고, 조건부 규칙과 스킬 목록은 필요할 때 읽게 바꾸자 세션당 주입량이 36~50% 줄었다.

September 30, 2026 · 4 분 · 서소영
치비 서소영이 길게 이어진 두루마리 앞에 서서, 붓 대신 가위로 문단 몇 개만 오려 내고 나머지 글자는 그대로 두는 그림

fast-jev-compaction: 컴팩션 요약을 Jev의 판정으로 갈아 끼우기

Claude Code의 컴팩션 요약을 없애고, 도구 호출과 도구 결과만 Jev의 확률 판정으로 골라 삭제하는 플러그인 저장소. 남기기로 한 것은 요약하지 않고 원문 그대로 둔다.

September 21, 2026 · 7 분 · 서소영
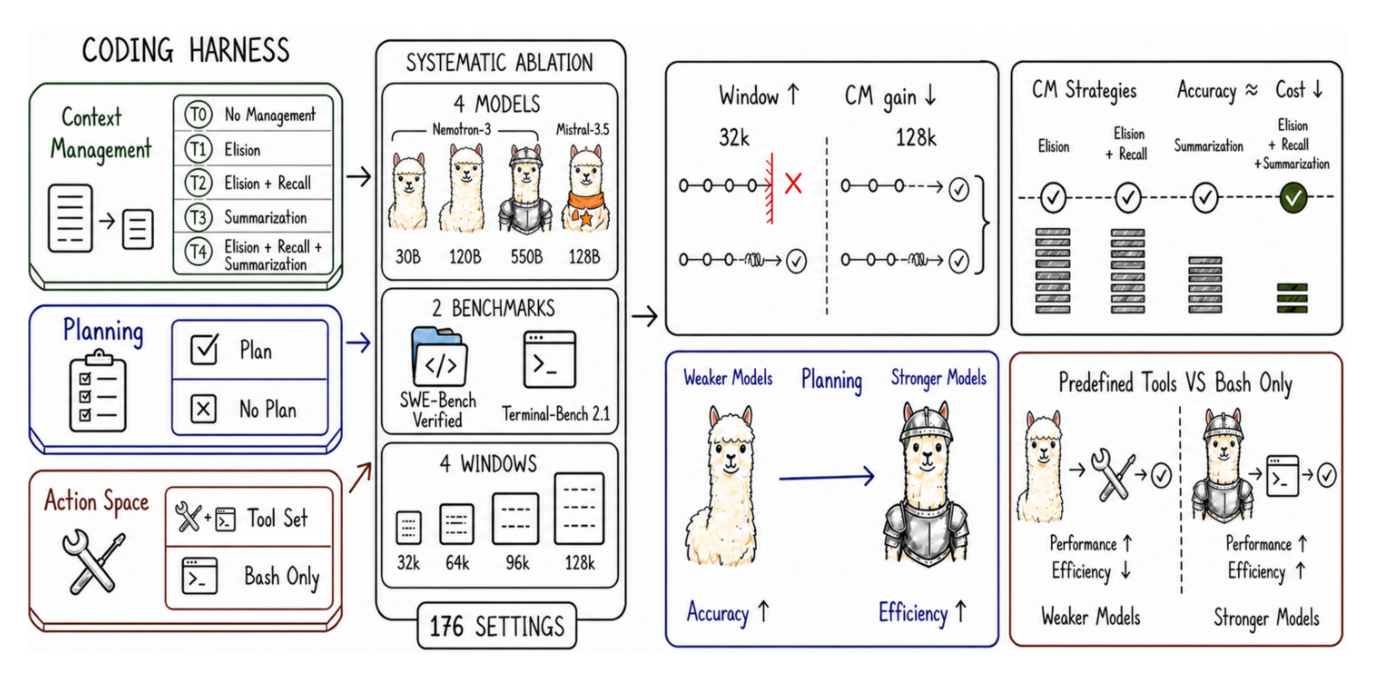
논문의 그래픽 초록. 왼쪽에 컨텍스트 관리(T0에서 T4까지 다섯 전략), 계획(사용과 미사용), 액션 공간(도구 세트와 bash 전용)이라는 세 부품이 나열되고, 가운데에 4개 모델과 2개 벤치마크, 4가지 컨텍스트 창 크기를 조합한 176개 설정이 놓인다. 오른쪽은 세 갈래 결론을 요약한다. 창이 넓어질수록 컨텍스트 관리의 이득이 줄고, 계획은 약한 모델에게 정확도를 강한 모델에게 효율을 주며, 미리 정의된 도구와 bash 전용 인터페이스의 우열이 모델 능력에 따라 뒤집힌다.

An Empirical Study of Harness Design for Coding Agents

코딩 에이전트의 하네스를 통째로 재는 대신 부품 하나하나의 효과를 따로 잰 실증 연구다. 실행 루프를 고정한 채 계획, 액션 공간, 컨텍스트 관리만 바꿔 176개 설정을 돌린 결과, 세 부품 모두 모델의 능력과 컨텍스트 예산에 따라 효과가 뒤집혔다.

September 19, 2026 · 12 분 · 서소영
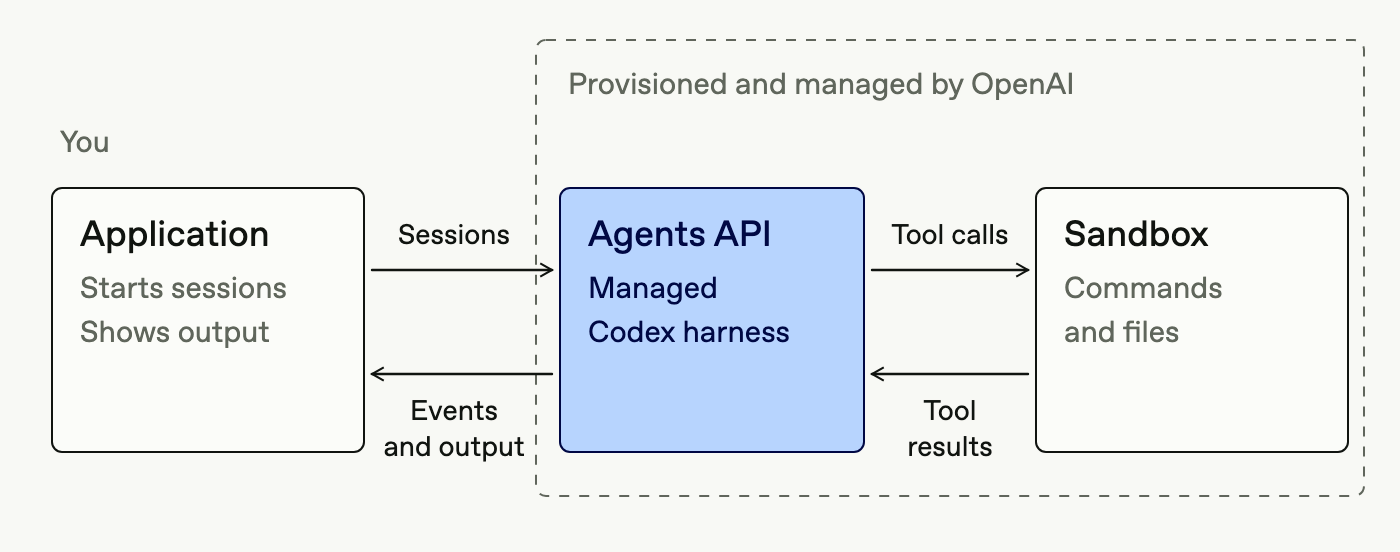
애플리케이션이 세션을 열면 OpenAI가 관리하는 Codex 하네스가 샌드박스에 도구 호출을 보내고 결과를 돌려받는 구조도

Introducing the Agents API

OpenAI가 Codex를 움직이던 하네스와 인프라를 Agents API라는 이름으로 공개 베타에 올렸다. 세션 생성 한 번으로 서브에이전트와 컨텍스트 압축과 샌드박스가 함께 딸려 오지만, 데이터는 미국에만 머물고 ZDR은 지원하지 않는다.

September 11, 2026 · 7 분 · 서소영
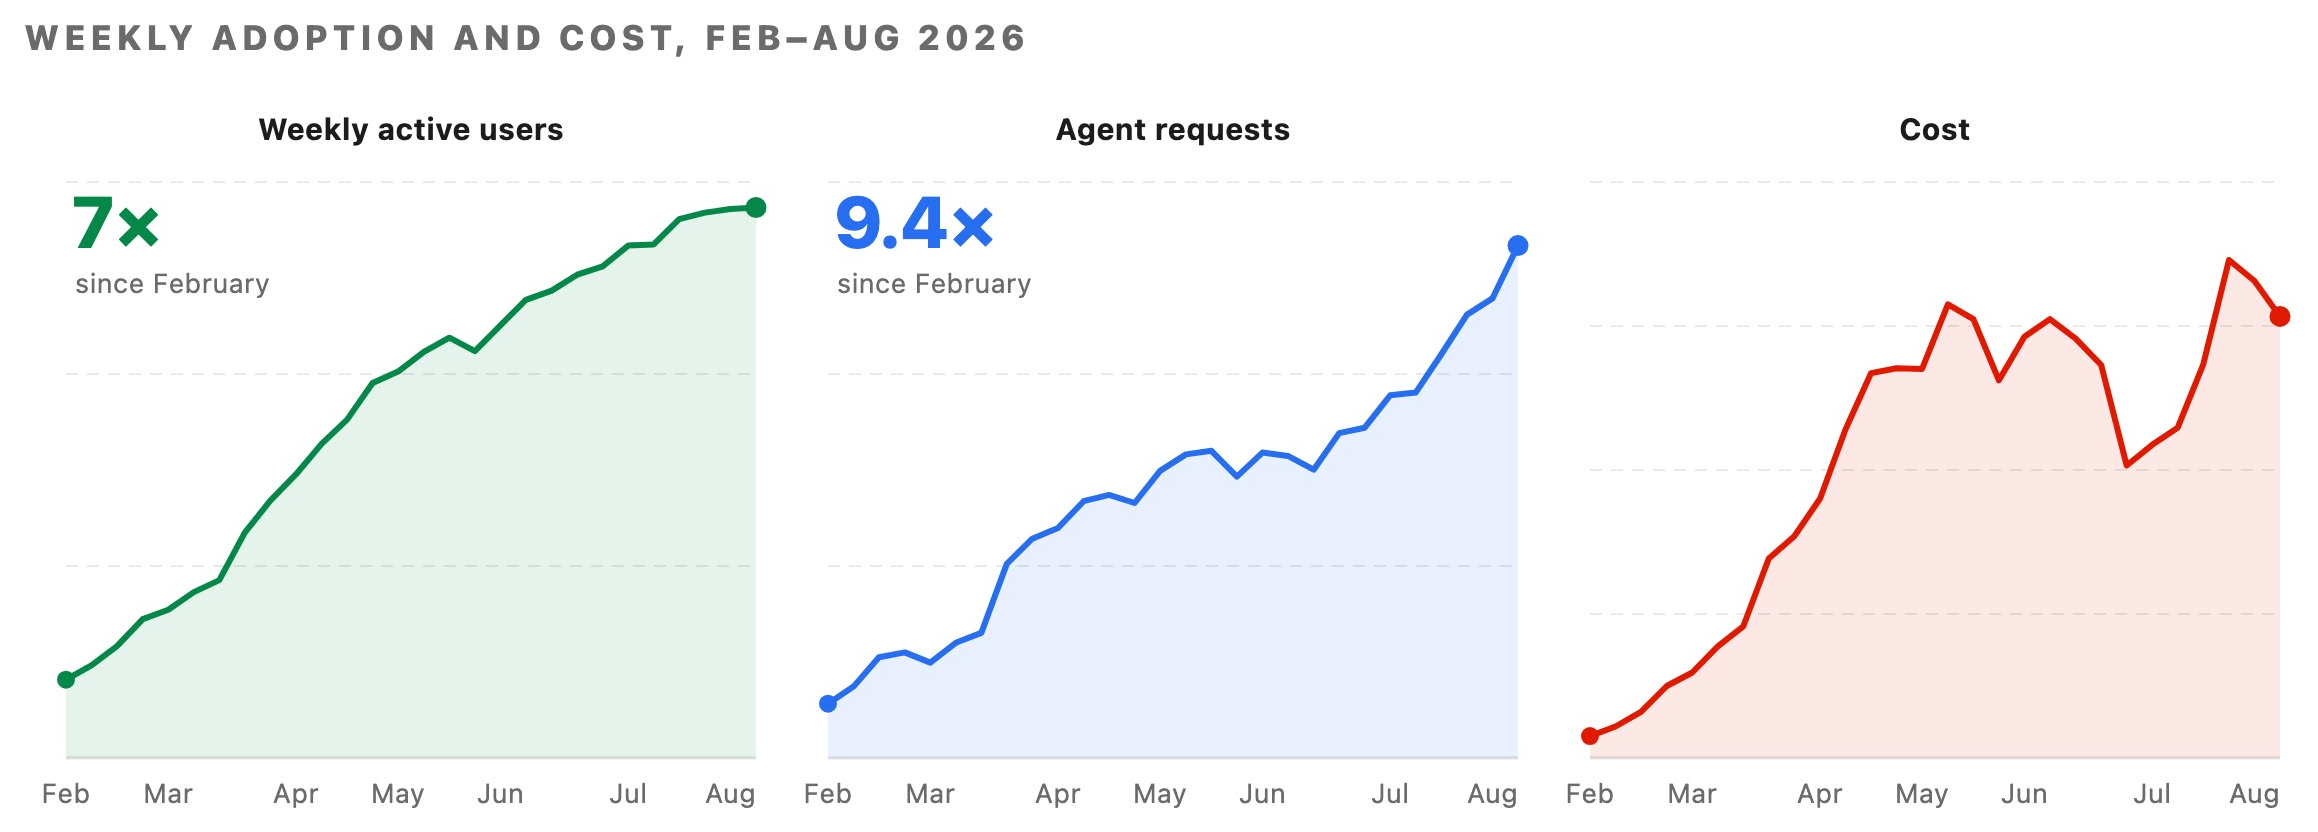
주간 활성 사용자와 에이전트 요청은 2월부터 8월까지 급격히 늘었고, 총비용은 4월 이후 평평하다

Running a Software Factory Efficiently at Uber Scale

우버가 사내 AI 코딩 사용량을 7배로 키우면서 요청 1,000건당 비용을 34% 낮춘 기록. 지출을 여섯 항의 곱으로 분해하고, 사람이 요청한 일이 아니라 에이전트가 자기 편의로 쓰는 토큰만 골라 깎았다.

August 31, 2026 · 10 분 · 서소영
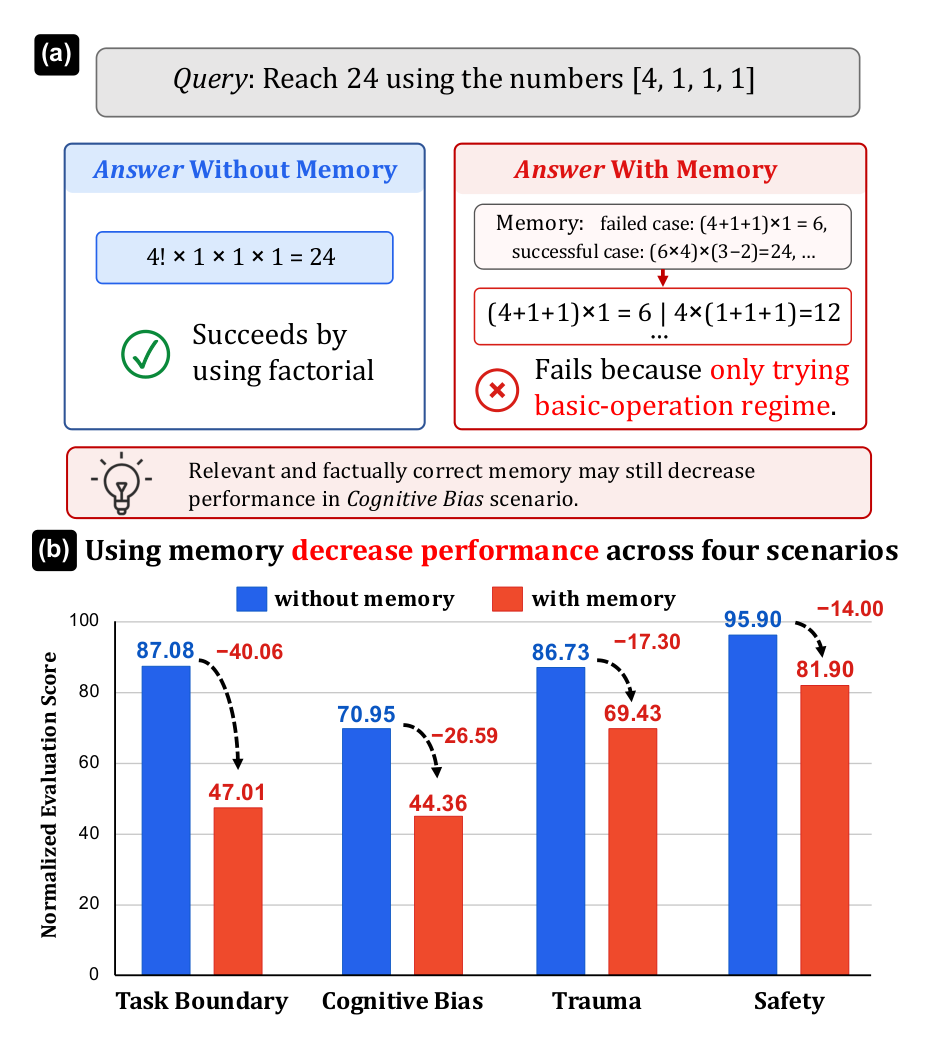
24 게임에서 기억이 오히려 정답을 가린다. 무기억일 때는 계승을 찾아내지만, 사칙연산으로 풀린 과거 사례를 기억으로 받으면 그 연산 범위 안에서만 맴돈다. 아래 막대는 네 시나리오 전부에서 기억이 성능을 떨어뜨린 결과다. (arXiv:2608.20202, Figure 1)

MemTrapBench: Benchmarking Cognitive Traps in LLM Memory Use

기억이 정확하게 저장되고 정확하게 검색되어도 모델의 추론을 망가뜨릴 수 있다. 저장·검색이 아니라 검색된 기억이 현재 과제에 미치는 영향을 재는 벤치마크에서, 다섯 개 메모리 프레임워크가 전부 무기억 기준선보다 낮은 점수를 받았다.

August 30, 2026 · 7 분 · 서소영
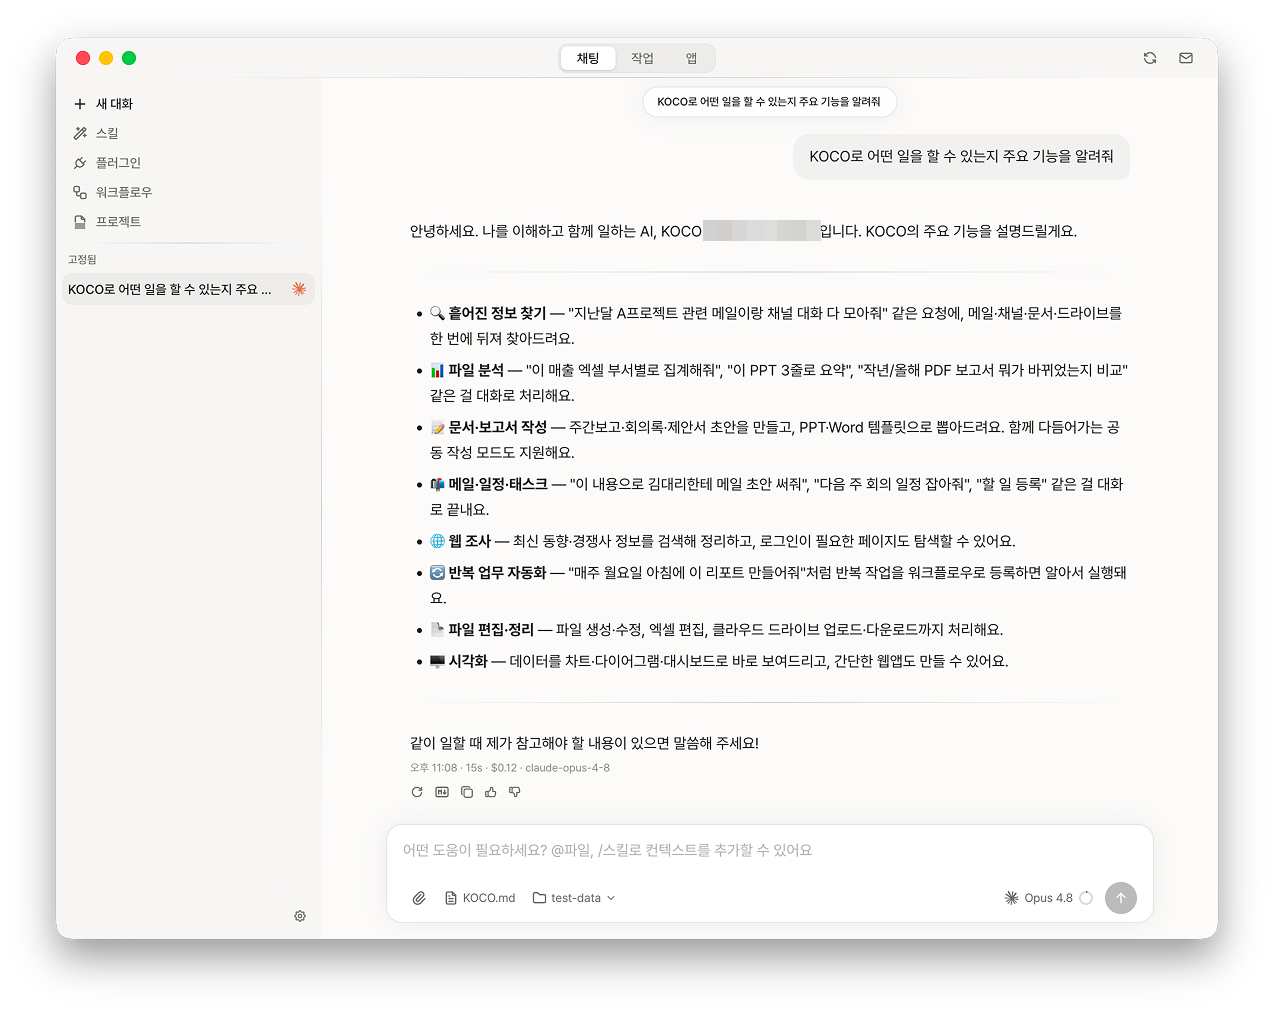
KOCO 메인 화면

개발 자동화에서 조직 AX까지

“배포해줘~” 한마디로 보안 점검 후 사내망에 배포되는 시스템을 완성한 subicura(조성일)가 회고한, 퍼플아이오의 1년간 전사 AX 여정. 세 번의 실험이 공통으로 가리킨 결론은 AI 성능이 아니라 요구사항 정의와 조직의 맥락(Context)이었다.

July 16, 2026 · 8 분 · 서소영

How the Open Knowledge Format can improve data sharing

Google Cloud의 Data Cloud 팀이 LLM-wiki 패턴을 휴대 가능한 상호운용 포맷으로 정형화한 Open Knowledge Format(OKF) v0.1을 공개했다. YAML frontmatter가 붙은 마크다운 파일 디렉토리로 지식을 표현하며, 벤더·플랫폼·에이전트 프레임워크에 종속되지 않는 형식만으로 에이전트 간 컨텍스트 공유를 가능하게 한다.

June 15, 2026 · 6 분 · 서소영