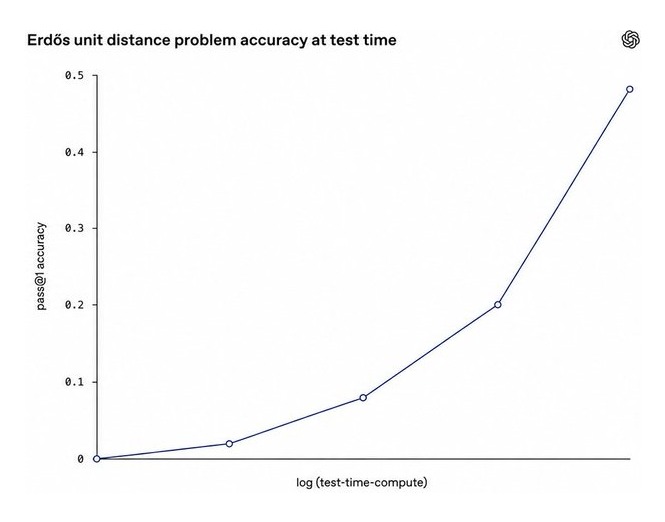
노암 브라운: 대규모 테스트 타임 컴퓨트의 함의 (2026)
OpenAI 추론 연구자 노암 브라운(@polynoamial)이 X에 올린 장문 글을 정리한다. 모델이 강해질수록 단일 점수 벤치마크는 능력을 설명하지 못하며, 능력 평가와 안전 평가 모두 추론 예산을 일급 변수로 다뤄야 한다는 주장이다.
OpenAI 추론 연구자 노암 브라운(@polynoamial)이 X에 올린 장문 글을 정리한다. 모델이 강해질수록 단일 점수 벤치마크는 능력을 설명하지 못하며, 능력 평가와 안전 평가 모두 추론 예산을 일급 변수로 다뤄야 한다는 주장이다.
Microsoft AI가 자사 첫 추론 모델 MAI-Thinking-1을 공개했다. 35B-active·1T-total 규모의 sparse MoE로, 타사 모델 증류 없이 자체 데이터·자체 가속기 위에서 처음부터 학습한 ‘Hill-Climbing Machine’ 파이프라인의 첫 결실이다.
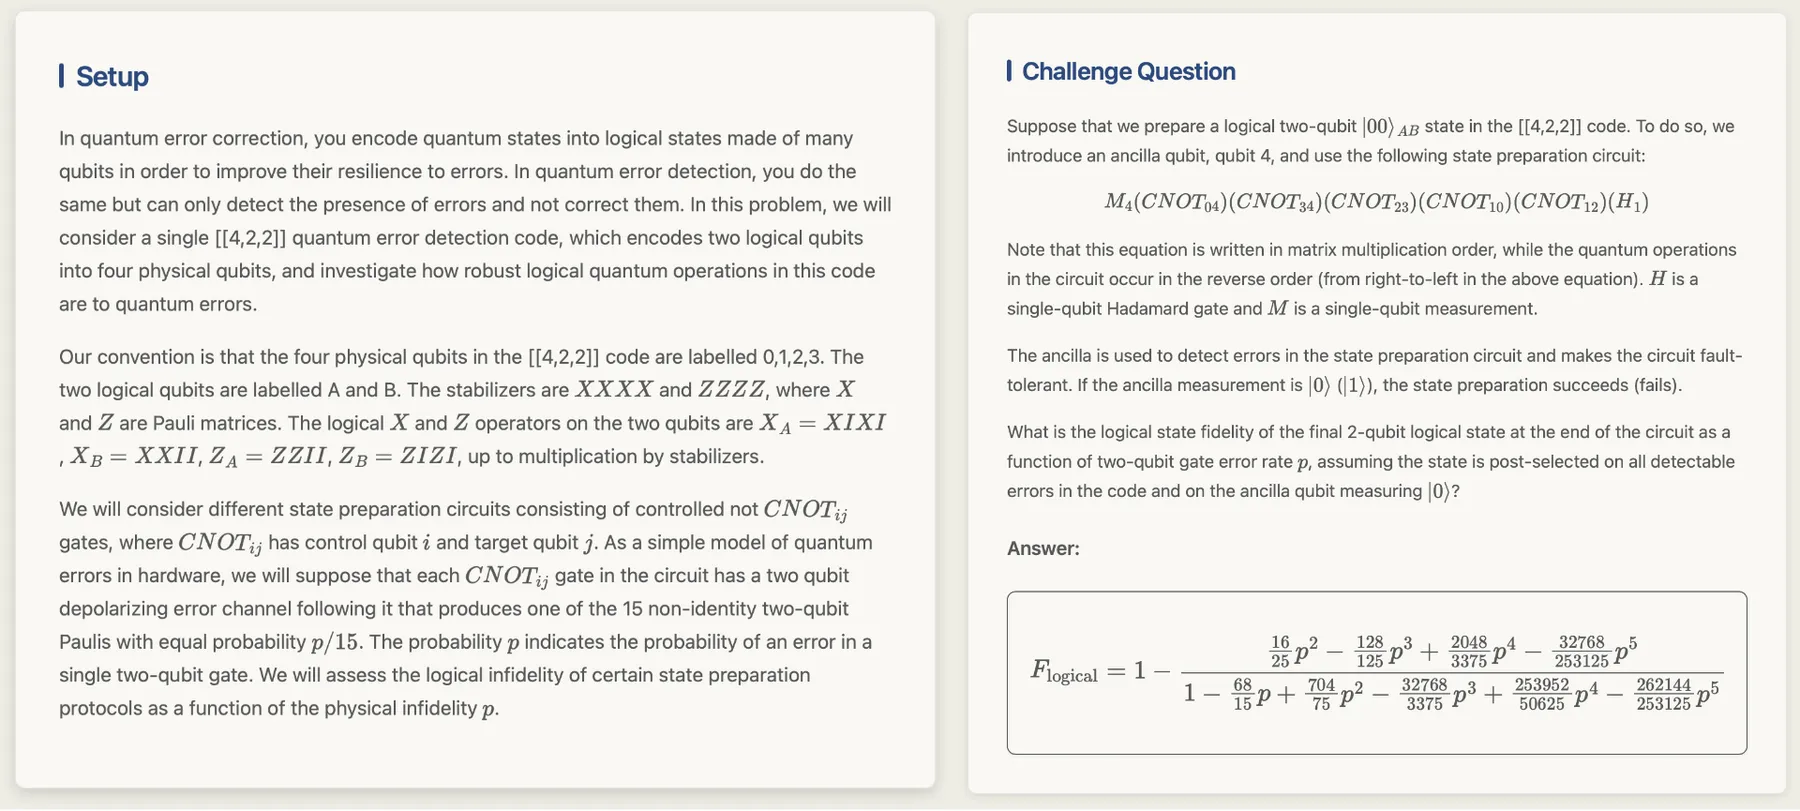
Hugging Face가 공개한 멀티에이전트 프레임워크 physics-intern은 9개 전문 에이전트와 적대적 검토 루프로 이론물리학 벤치마크 CritPt에서 31.4%를 기록해 GPT 5.5 Pro(30.6%)를 넘어섰다 — 스케일 대신 비계(scaffolding)로 프론티어를 추월한 사례.
ARC Prize가 GPT-5.5와 Opus 4.7에게 한 번도 본 적 없는 게임 135개를 던졌다. 둘 다 1%도 못 풀었지만, 진짜 발견은 점수가 아니라 틀리는 방식의 차이였다.
ARC Prize가 GPT-5.5와 Opus 4.7을 ARC-AGI-3으로 평가한 분석 보고서. 두 모델 모두 1% 미만의 점수를 기록했지만, 진짜 발견은 점수가 아니라 실패의 질적 차이에 있다.
AI가 추론을 흉내 내는 시대가 끝나고 있다. 루프 트랜스포머는 뇌의 시상-피질 루프와 독립적으로 같은 해법에 도달했다. 이것이 AGI의 문턱인 이유를 이야기한다.