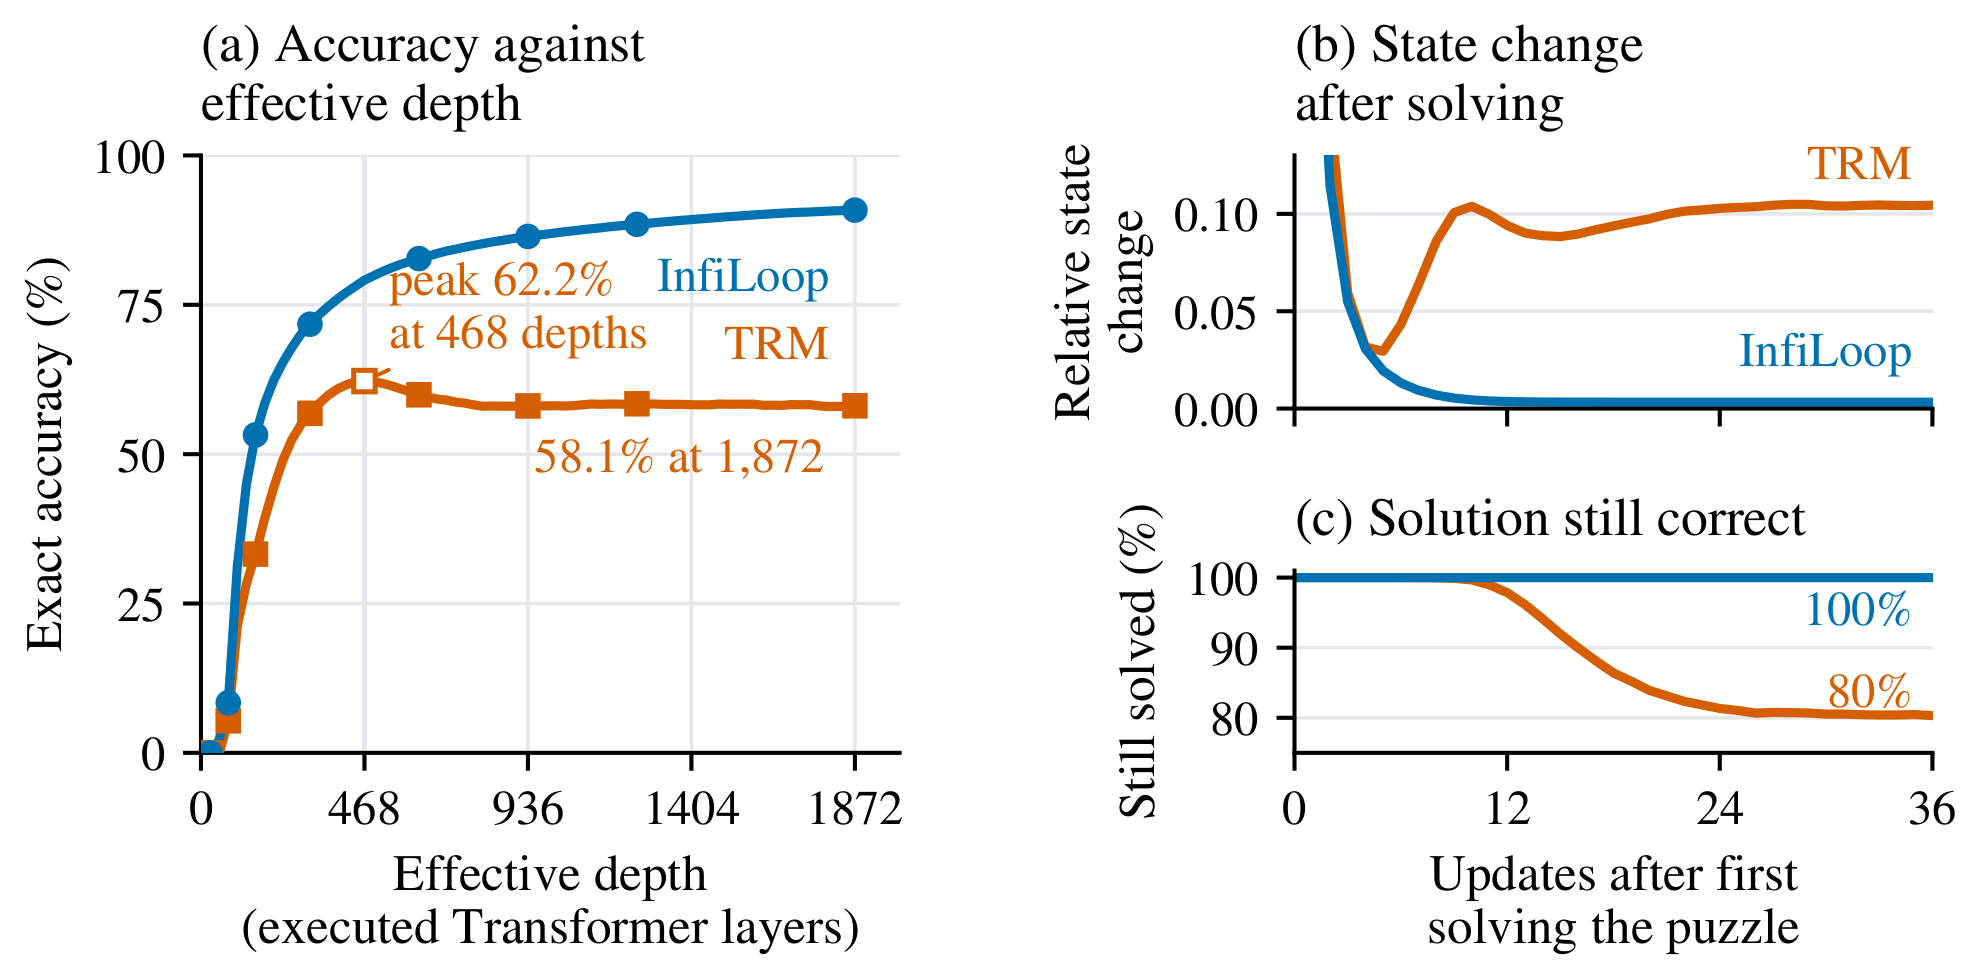
Sudoku-Extreme에서 실행 층 수에 따른 정확도와 풀이 완료 후 상태 변화를 비교한 그래프. 직전 상태만 넘기는 TRM은 468층에서 최고점 62.2%를 기록한 뒤 정확도가 떨어지고 이미 푼 퍼즐의 19.7%를 잃는 반면, InfiLoop는 1,872층에서 90.9%까지 오르며 푼 퍼즐을 모두 유지한다.

Scaling to Tens of Thousands of Test-Time Iterations with Loop-Native Attention Residuals

루프 트랜스포머는 직전 반복의 출력만 다음 반복으로 넘기기 때문에, 반복 횟수가 늘면 이후의 갱신이 이미 맞힌 답을 덮어쓰는 잠재 과잉사고가 발생한다. InfiLoop는 반복마다 내용 점수와 지수 감쇠로 과거 상태를 가중 합산한다. 토큰당 벡터 하나와 스칼라 하나만 유지하는 점화식이라 메모리 사용량이 반복 횟수와 상관없이 일정하다. 700만 파라미터 모델로 Sudoku-Extreme 97.9%, ARC-AGI-2 13.6%를 기록했고, 실행 층 수를 2만 4,960층까지 늘려도 성능이 계속 올랐다.
October 20, 2026 · 12 분 · 서소영
Introducing Glimpse: 본 것으로부터 물리 세계를 추론하는 시각적 사고 모델

Introducing Glimpse

Elorian이 오픈웨이트 기반 모델에 사후학습을 적용해 만든 시각 추론 모델 Glimpse를 공개했다. 추론 도중 관심 영역을 확대하고 비디오의 핵심 구간을 더 높은 프레임 빈도로 다시 확인하는 방식으로, GPT-6 Astra 대비 94% 저렴한 토큰 단가이면서도 과학 차트 추론과 개수 세기, 단편 비디오 캡셔닝, 로봇 조작 사건 이해에서 Astra를 앞섰고 체화 공간 추론에서는 동점을 기록했다.

October 17, 2026 · 11 분 · 서소영
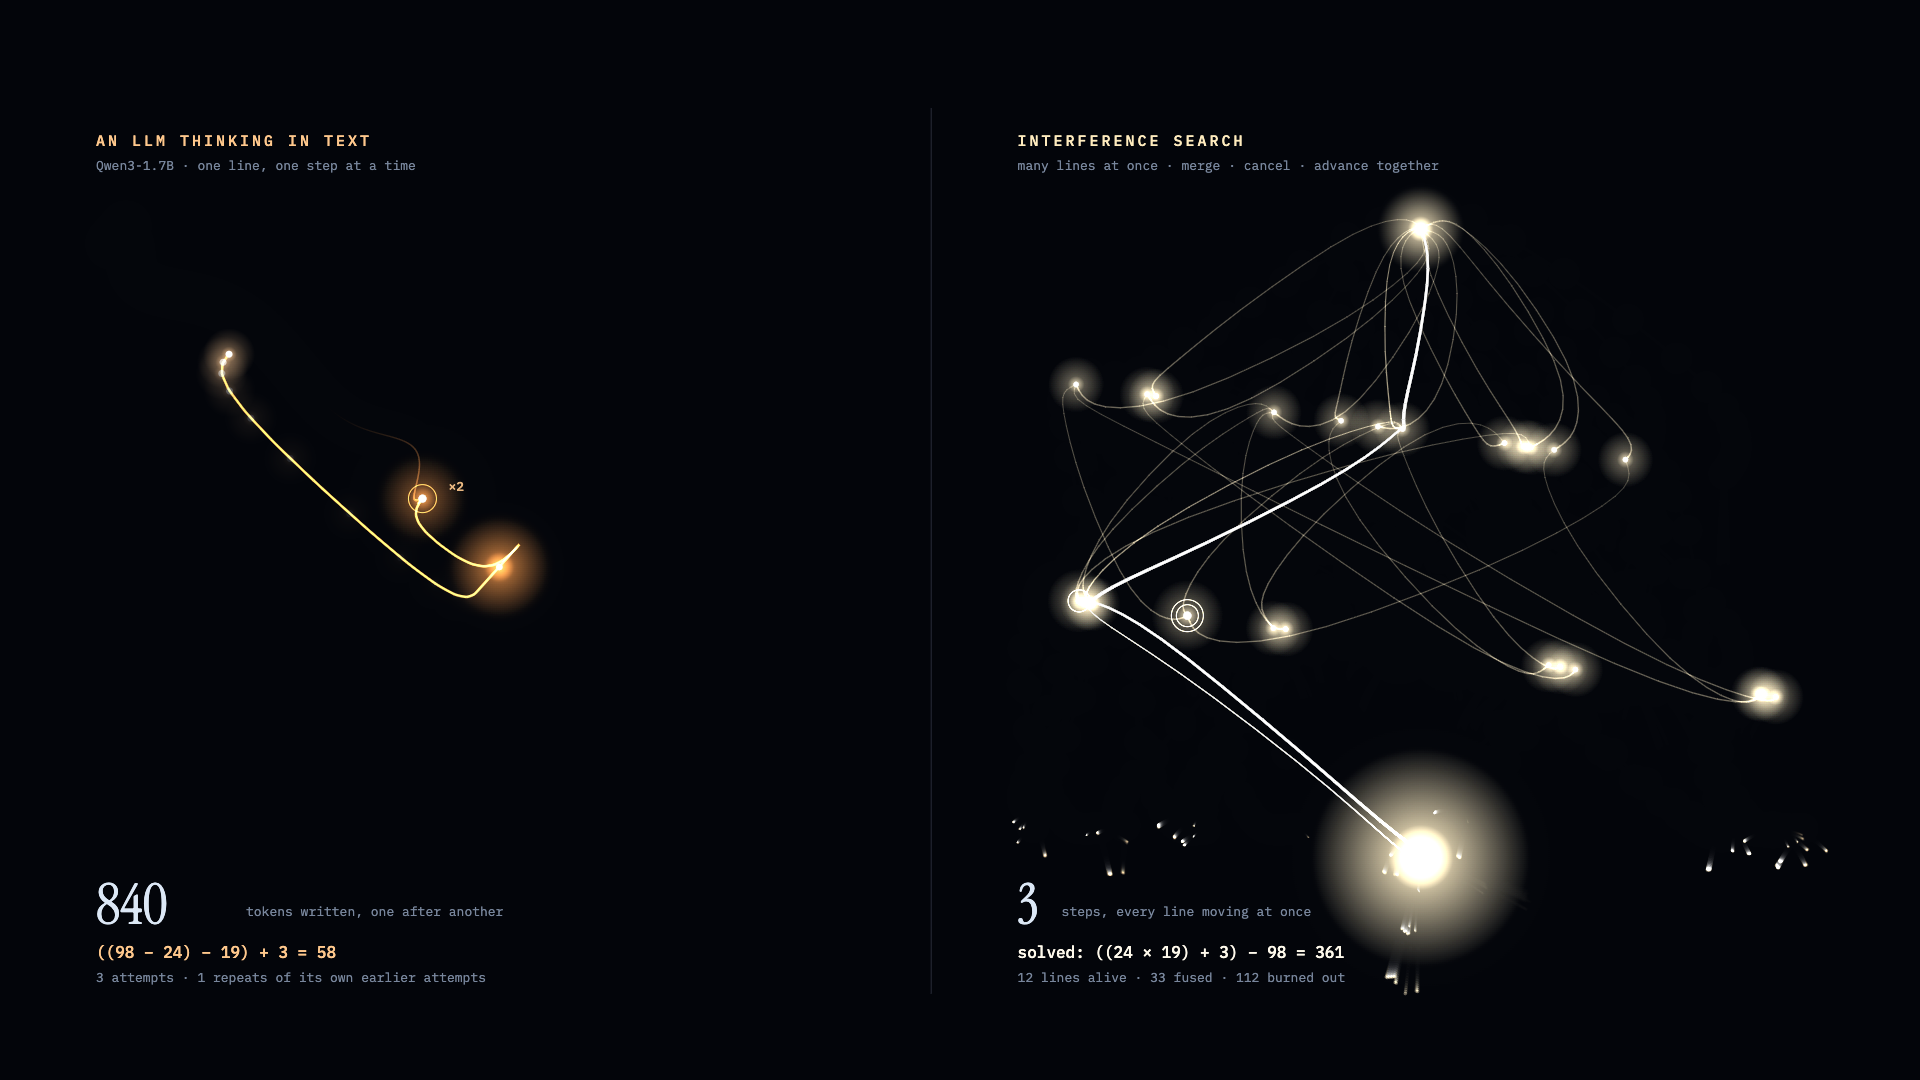
같은 카운트다운 문제를 두 방식으로 푸는 원문 그림 1. 왼쪽은 Qwen3-1.7B가 텍스트로 추론한 기록으로, 840토큰을 쓰는 동안 시도 3개 중 1개가 자기 이전 시도의 반복이다. 오른쪽은 Interference Search로, 여러 분기를 동시에 전개하고 중복을 병합해 3단계 만에 ((24 × 19) + 3) − 98 = 361을 찾는다. 출처: Badtheorylabs/interference-search, Apache 2.0

Interference Search: Reasoning over merged states, many branches at once

라고스(Lagos)에 있는 연구소 Bad Theory Labs가 언어 모델의 한 줄짜리 추론 대신 명시적 상태 위에서 여러 분기를 한꺼번에 전개하고, 같은 상태는 병합하고, 작은 판정기로 막다른 분기를 제거하는 탐색 방식을 공개했다. 어려운 카운트다운 30문제에서 같은 판정기와 같은 예산으로 단일 사슬은 21문제, 이 방식은 30문제를 풀었고, 필요한 순차 단계는 23.7에서 3으로 줄었다. 코드 과제에서는 차이가 잡음 수준이었고, 언어 모델을 학습시키는 일은 다음 단계로 남았다.

September 26, 2026 · 15 분 · 서소영
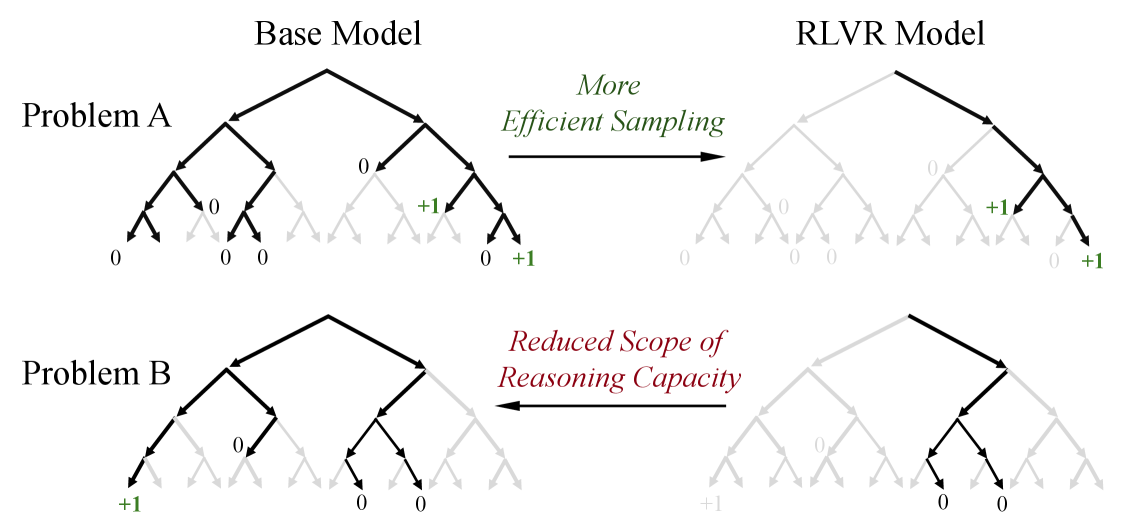
베이스 모델과 RLVR 모델의 탐색 트리 비교 도식. 문제 A에서는 RLVR이 보상받은 경로 쪽으로 분포를 몰아 샘플링 효율을 높이지만, 문제 B에서는 베이스 모델에 있던 정답 경로가 RLVR 모델에서 사라진다.

Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?

칭화대 LeapLab과 상하이교통대 연구진이 검증 가능한 보상 기반 강화학습(RLVR)의 효과를 pass@k로 다시 측정한 논문. k가 작을 때는 RLVR 모델이 앞서지만 k를 키우면 베이스 모델이 역전하며, RLVR이 쓰는 추론 경로는 이미 베이스 모델의 분포 안에 들어 있었다.

September 18, 2026 · 10 분 · 서소영
천공 카드와 기계 도면을 조합한 TypeSafe의 Jev 발표 이미지

Introducing System One Models & Jev

Jev는 글을 쓰는 대신 선택지와 확률을 반환하는 판단용 모델이다. 무엇을 자동화할 수 있는지, API 사용 방법과 입력 100만 토큰당 0.042달러의 비용, ‘환각 0%’의 의미를 살펴본다.

September 16, 2026 · 7 분 · 서소영
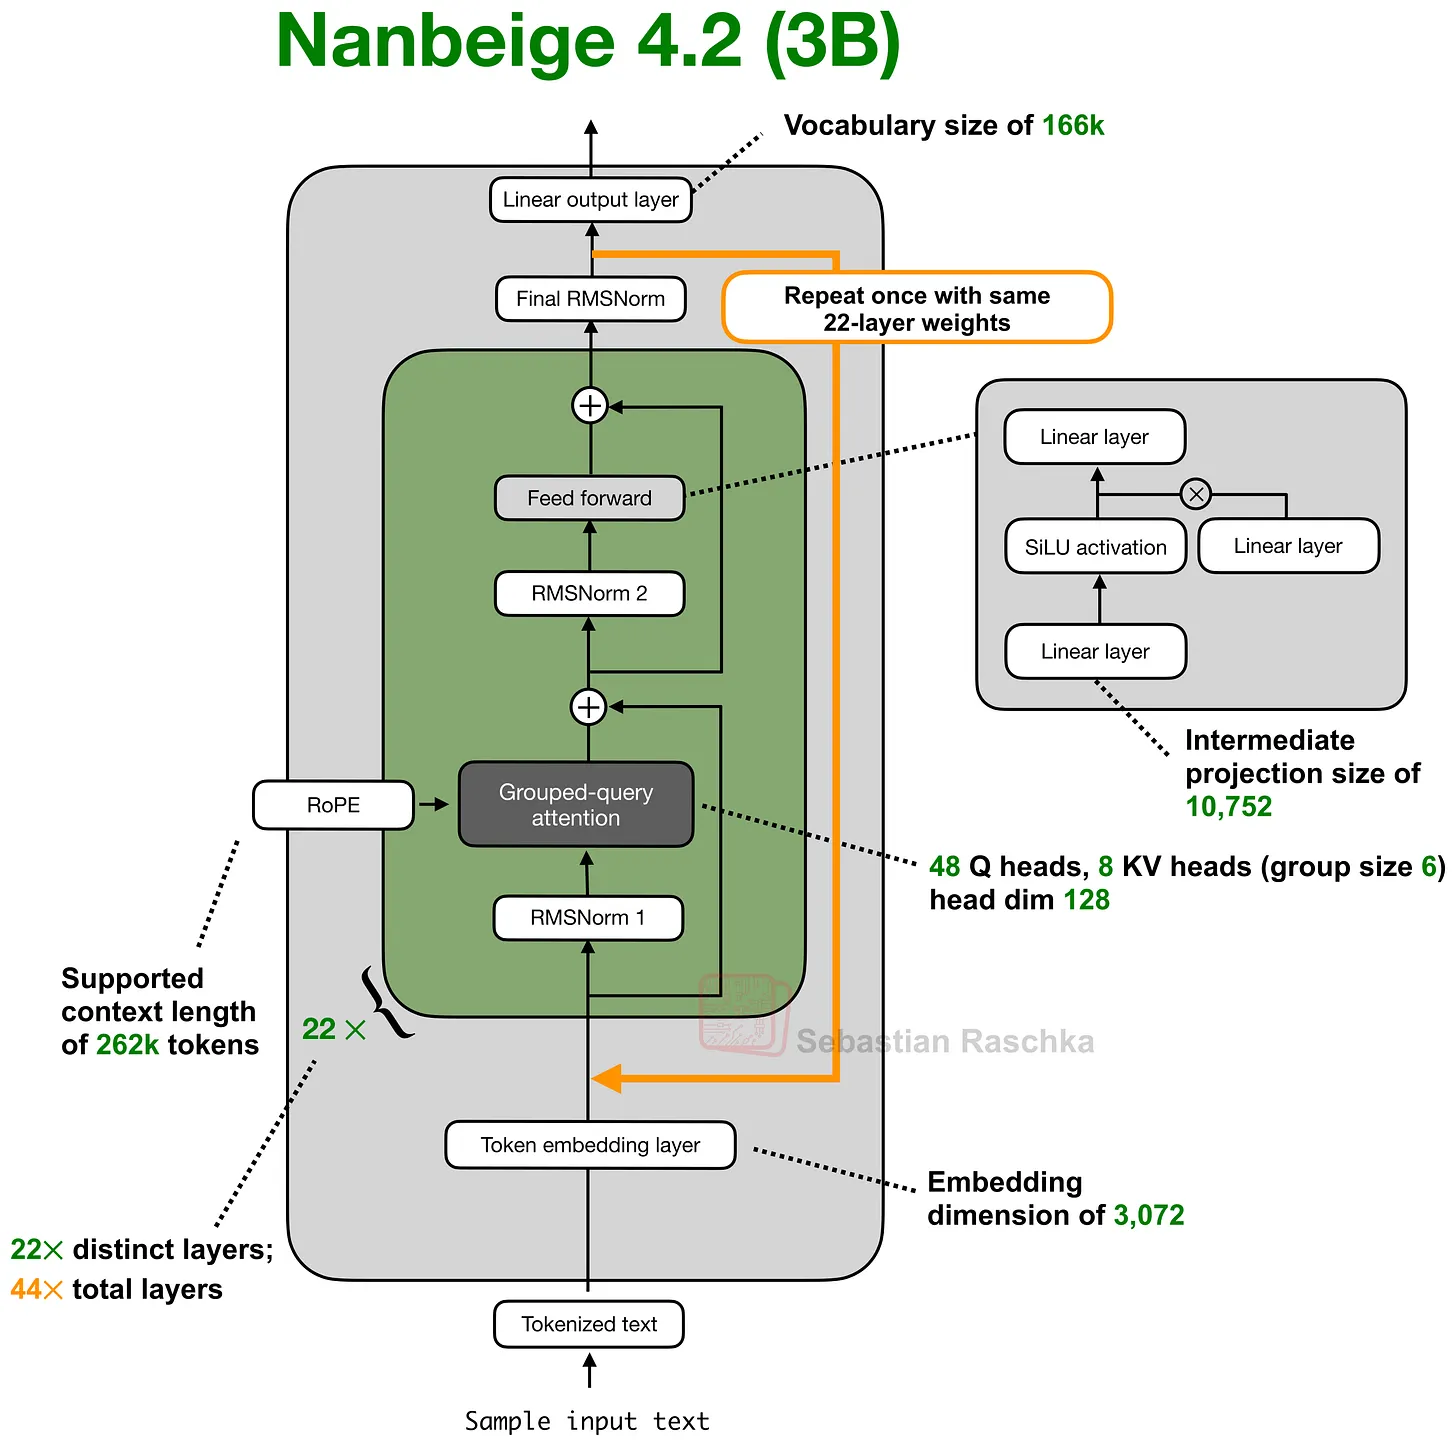
Nanbeige4.2-3B 아키텍처 도식. 22개 트랜스포머 블록 위에서 주황색 화살표가 스택 맨 아래로 되돌아간다

GPT-6 Astra, Looped Transformers, and Hidden Reasoning

The Information은 GPT-6 Astra가 루프 트랜스포머를 써서 추론 흔적을 가린다고 보도했다. Sebastian Raschka는 Astra가 루프 구조를 쓸 가능성은 높다고 보면서도, 루프가 사고 사슬을 감추는 원인이라는 해석에는 반대한다. 루프 트랜스포머가 무엇이고 무엇을 아끼며 무엇을 아끼지 못하는지를 논문 네 편과 함께 정리한 글이다.

September 10, 2026 · 15 분 · 서소영

Ten advances in mathematics and theoretical computer science

OpenAI가 차기 모델 Astra의 내부 버전으로 10년 넘게 진전이 없던 수학과 이론전산학 난제 10건에 새 결과를 내고, 각 증명을 Lean으로 형식화해 공개했다.

August 2, 2026 · 5 분 · 서소영
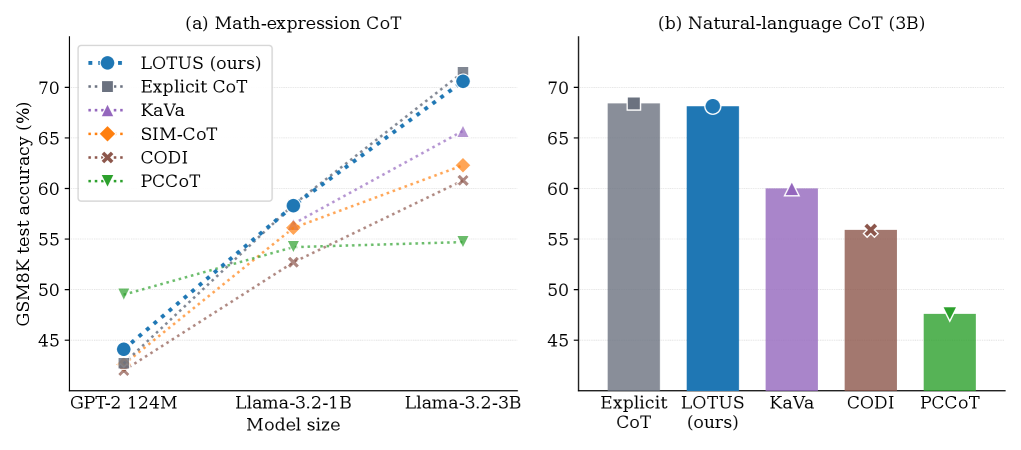
Figure 1 — LOTUS는 백본이 커져도 명시적 CoT의 정확도 상한을 따라간다

Bridging the Gap Between Latent and Explicit Reasoning with Looped Transformers

앞으로 에이전트는 생각을 굳이 말로 하지 않아도 될 수 있다. LOTUS 논문은 언어 모델의 추론을 사람이 읽는 문장이 아니라 모델 내부의 계산 상태에서 진행하는 방향이, 3B 규모에서 실제로 통한다는 첫 증거를 제시한다. Chain-of-Thought가 사라지는 미래가 성능·효율의 필연으로 다가온다.

July 21, 2026 · 6 분 · 서소영
OpenAI와 Broadcom이 공동 발표한 Jalapeño 칩. (출처: OpenAI)

OpenAI·Broadcom, LLM 추론 전용 칩 'Jalapeño' 공개

OpenAI가 Broadcom·Celestica와 함께 LLM 추론에 백지부터 설계한 첫 자체 칩 Jalapeño(인텔리전스 프로세서)를 공개했다. 설계에서 tape-out까지 9개월, 와트당 성능에서 현세대 최고 수준을 앞서고, 2026년 말부터 Microsoft 등 파트너와 함께 기가와트 규모 데이터센터에 배포한다.

June 24, 2026 · 5 분 · 서소영
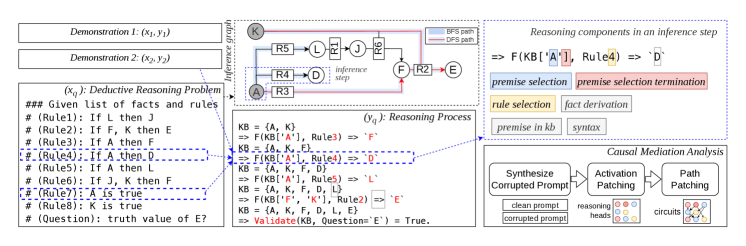
프레임워크 개요. 연역 추론 문제, 추론 그래프, 그리고 인과 매개 분석 흐름

Revealing Algorithmic Deductive Circuits for Logical Reasoning

LLM이 연역 추론을 수행할 때 전체 attention head의 약 3%만이 핵심 회로를 이룬다는 것을 인과 매개 분석으로 보인 논문. 추론 흐름은 규칙 조건 매칭에서 출발해 순회 알고리즘 구현, 전제와 규칙 선택, 종료 결정으로 순차 진행된다.

June 9, 2026 · 5 분 · 서소영