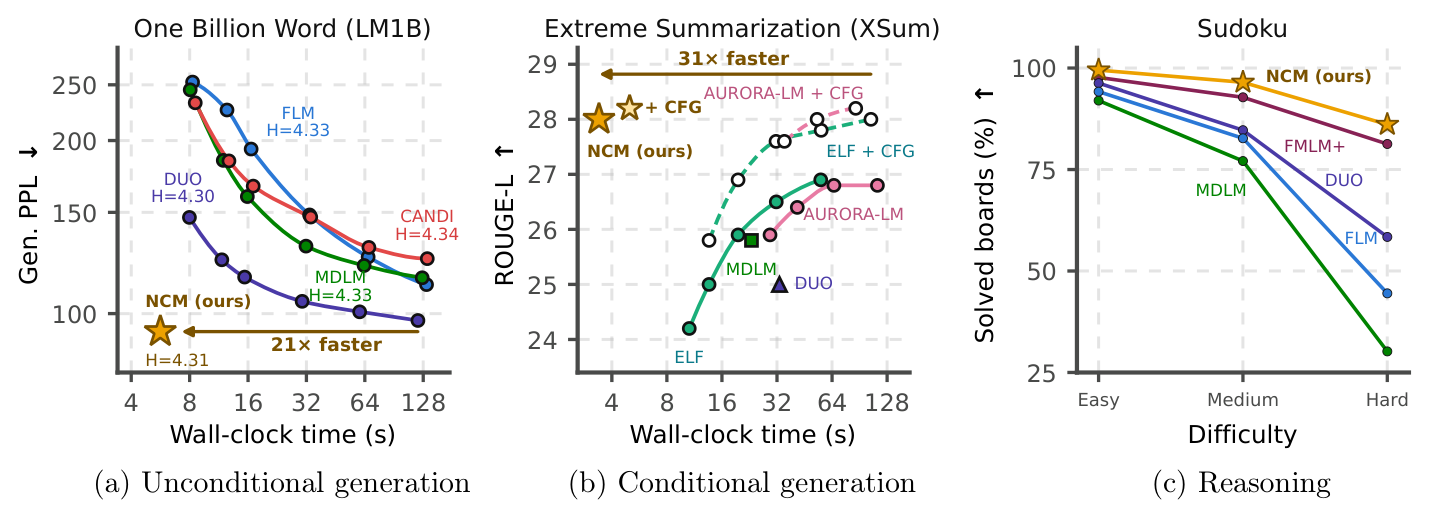
LM1B 무조건부 생성, XSum 요약, 스도쿠 추론에서 Next-Concept Modeling과 기존 확산 언어 모델들의 생성 속도 및 성능을 비교한 그래프

Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation

스탠퍼드 대학교와 Together AI 연구진이 텍스트를 다중 스케일 이산 코드 계층으로 압축한 뒤 단계별로 병렬 생성하는 Next-Concept Modeling(NCM)을 제안했다. 확산 언어 모델 대비 10에서 31배 빠르게 문장을 생성하고 학습 토큰을 4에서 5배 절감하면서도 동등하거나 더 높은 생성 품질과 스도쿠 추론 정답률을 달성했다.
October 21, 2026 · 13 분 · 서소영
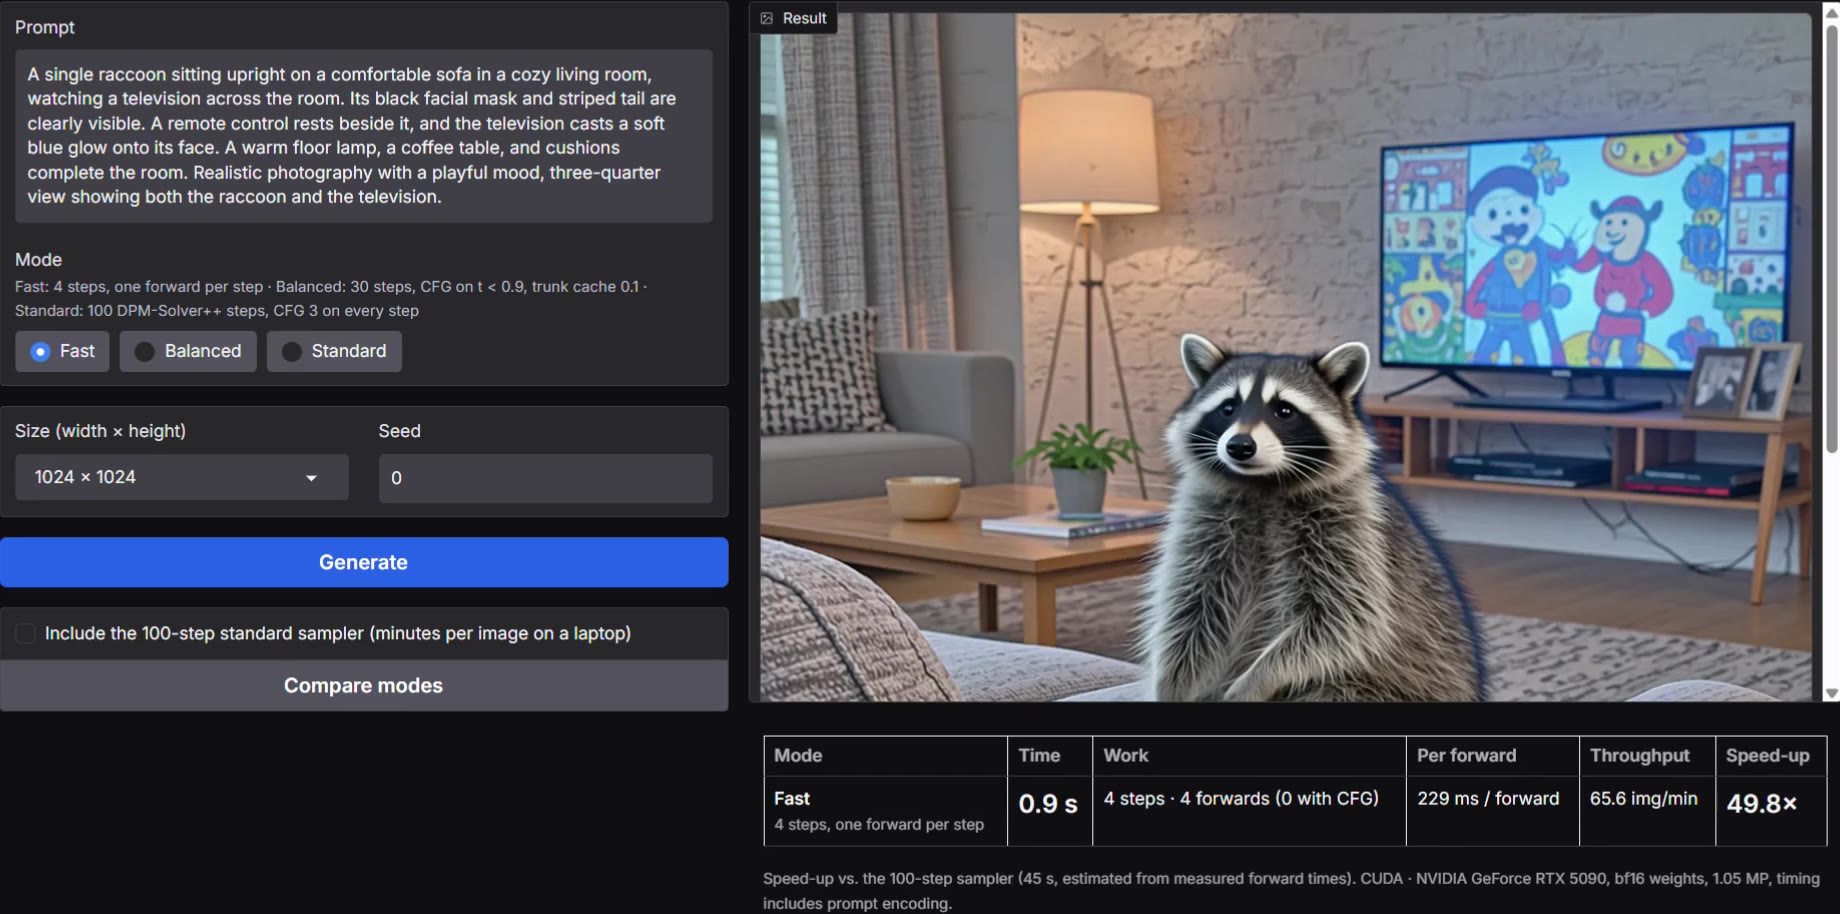
Iris-3B 속도 비교 데모 화면. 왼쪽에 거실 소파에 앉아 텔레비전을 보는 너구리를 묘사한 프롬프트와 Fast 모드 선택이 있고, 오른쪽에 생성된 너구리 사진이 있다. 아래 표에는 4스텝, 포워드 4번, 0.9초, 100스텝 대비 49.8배라고 적혀 있다. 사용자 jun1228909가 RTX 5090에서 녹화한 영상의 한 장면이다.

Iris-3B의 100스텝을 4스텝으로 줄인 Turbo LoRA

Speridlabs가 공개한 30억 파라미터 이미지 생성 모델 Iris-3B는 VAE 없이 픽셀을 직접 만든다. 대신 기본 설정에서는 1024×1024 이미지 한 장에 포워드 패스가 약 200번 필요했다. 일본 개발자 pentacoxian은 증류 기법 DMD2로 CFG의 효과까지 학습한 4스텝 LoRA를 만들어 생성 시간을 RTX 5090에서 0.68초, M3 Max에서 약 11초로 줄였다. 공개 하루 동안에는 사용자들이 RTX 5090, 아이폰, 스냅드래곤 NPU에서 실행한 결과를 올렸다.

October 12, 2026 · 12 분 · 서소영
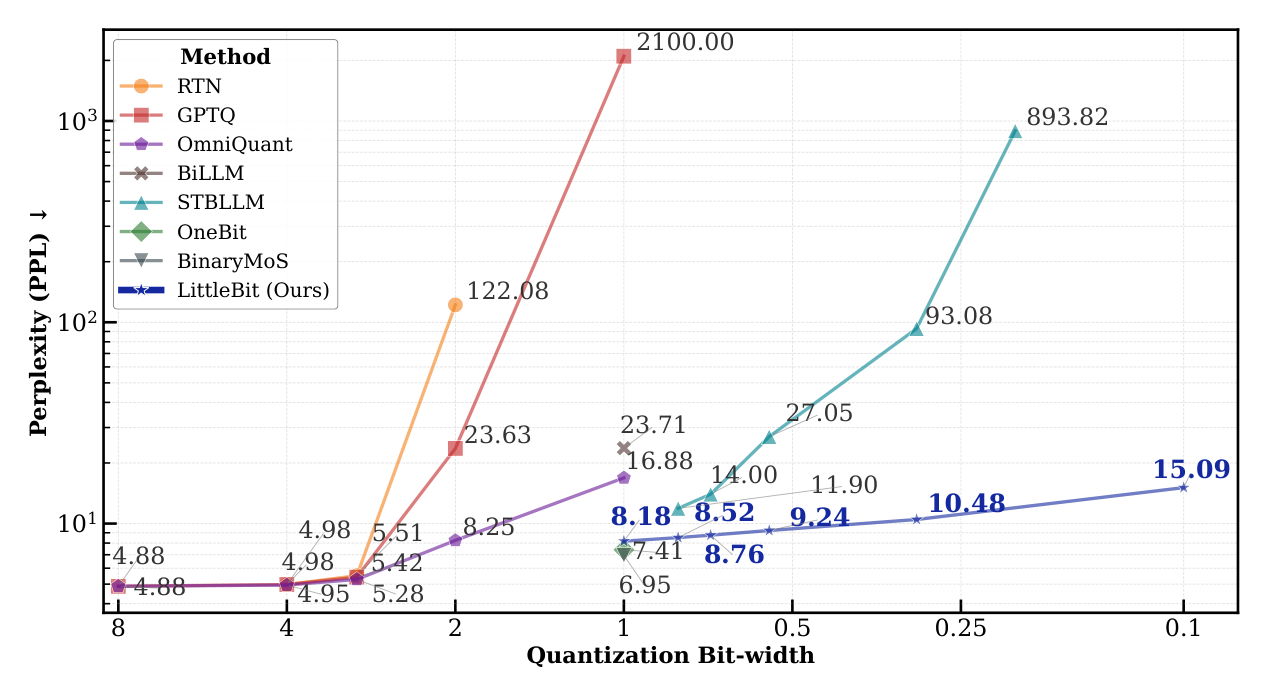
Llama2-13B의 WikiText-2 퍼플렉시티를 양자화 비트 수에 따라 비교한 로그 스케일 그래프. 가로축은 왼쪽 8비트에서 오른쪽 0.1비트까지다. RTN과 GPTQ는 2비트 부근에서, STBLLM은 0.5비트 미만에서 퍼플렉시티가 수백 이상으로 커진다. LittleBit은 1비트의 8.18에서 0.1비트의 15.09까지 완만하게 증가한다. 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0

LittleBit: Ultra Low-Bit Quantization via Latent Factorization

삼성리서치의 LittleBit은 LLM의 가중치 행렬을 랭크가 낮은 두 행렬의 곱으로 분해한 뒤 이진화하고, 행과 열과 잠재 차원의 스케일로 크기 정보를 보완해 가중치 하나당 평균 0.1비트까지 압축한다. 0.1비트로 압축한 Llama2-7B의 퍼플렉시티는 15.92로 기존 기법 STBLLM이 0.7비트에서 낸 결과보다 낮지만, 원본 모델과의 성능 차이는 여전히 크다.

October 12, 2026 · 14 분 · 서소영
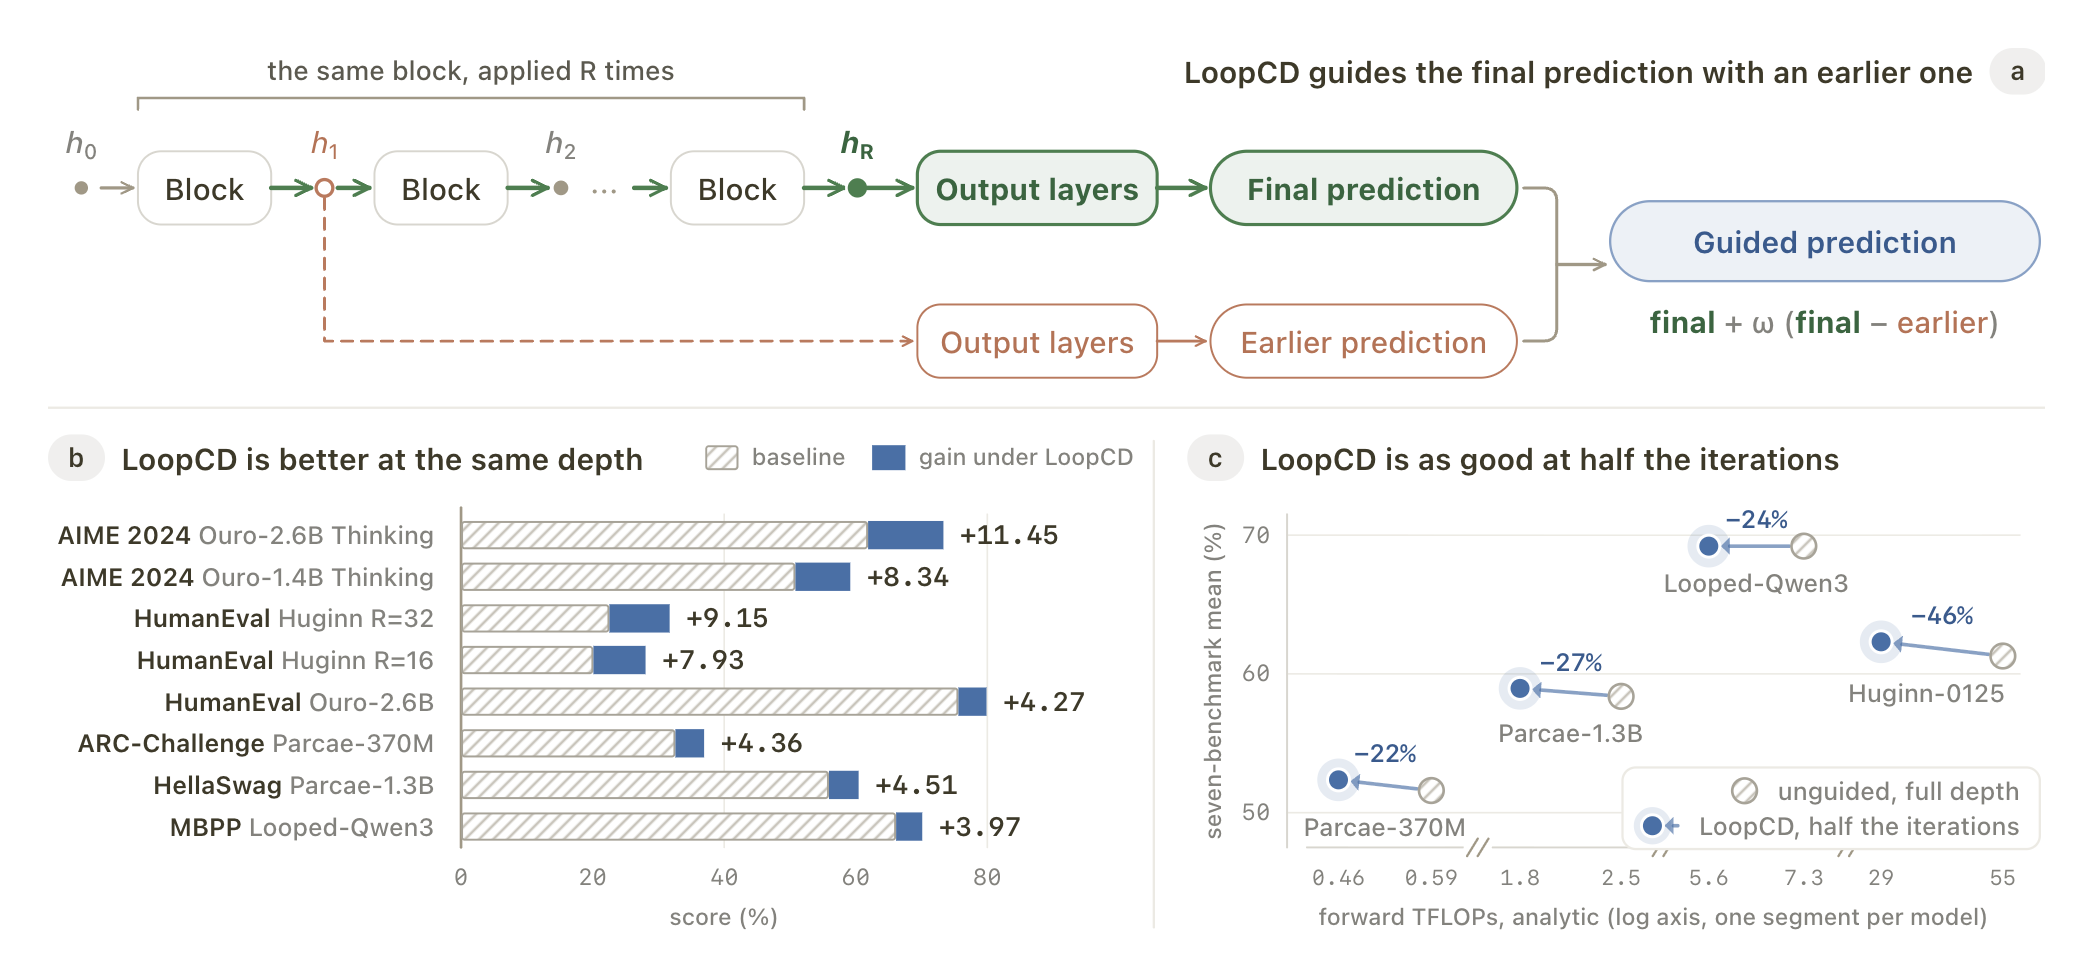
LoopCD 개요 그림. 위는 같은 블록을 R번 반복한 뒤 첫 번째 반복의 상태도 출력층에 통과시켜 최종 예측과 대조하는 구조다. 아래 왼쪽은 같은 반복 깊이에서 여덟 가지 모델과 벤치마크 조합의 점수 상승폭이고, 아래 오른쪽은 반복을 절반으로 줄였을 때의 정확도와 연산량이다.

Decoding Looped Transformers Better for (Almost) Free

Apple 연구진은 루프 트랜스포머의 첫 번째 반복이 내놓는 약한 예측을 마지막 반복의 예측과 대조해 다음 토큰을 고르는 LoopCD를 제안했다. 추가 학습 없이 Ouro-2.6B-Thinking의 AIME 2024 pass@1이 61.88%에서 73.33%로 올랐다. 반복 횟수를 절반으로 줄여도 기준 성능은 유지됐고, 순방향 연산량의 절감폭은 설정에 따라 22.5%에서 48.2%였다.

October 6, 2026 · 11 분 · 서소영
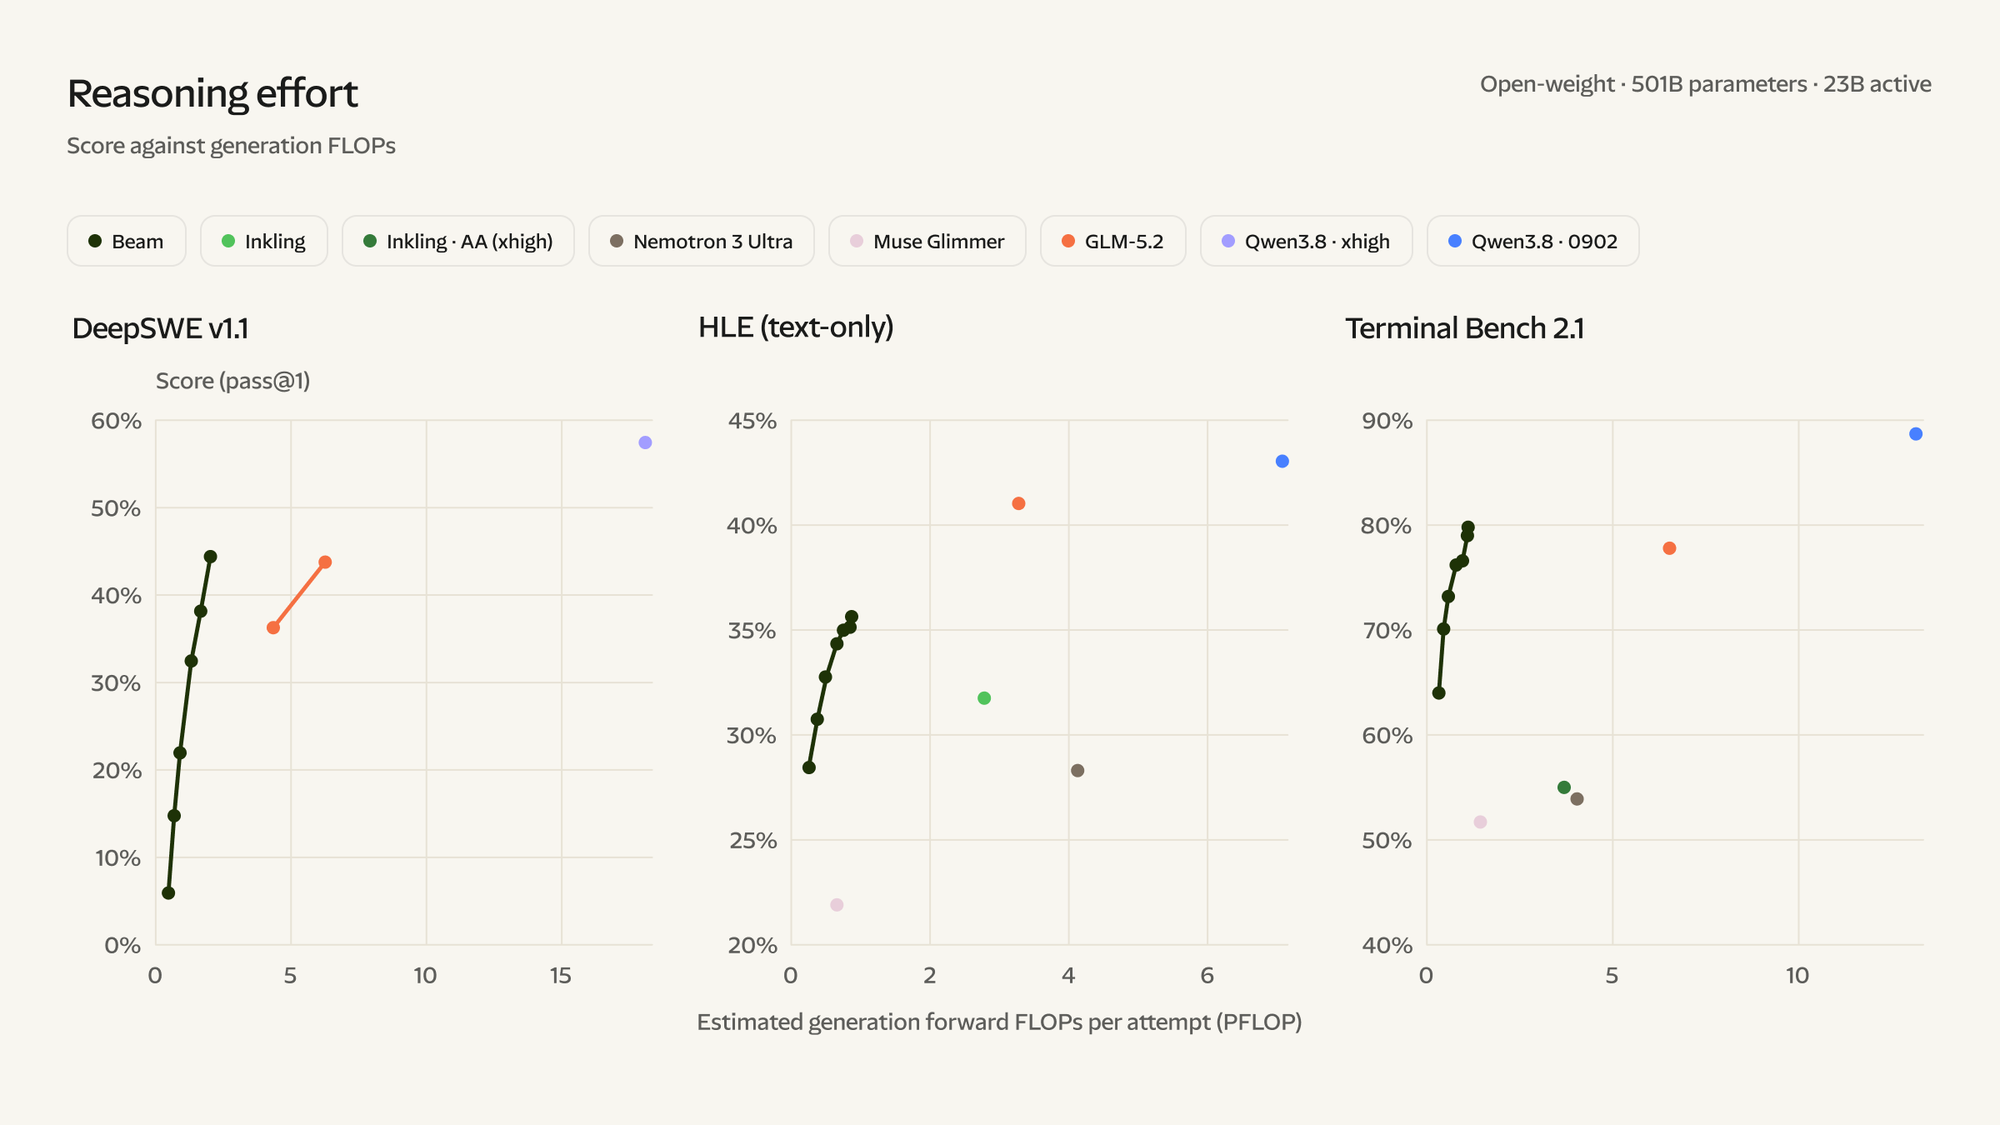
DeepSWE v1.1, HLE, Terminal Bench 2.1의 점수를 문제 한 번당 생성 연산량 추정치(PFLOP)에 대해 그린 그래프 세 개. Beam의 진한 녹색 선은 세 그래프 모두 2 PFLOP 이하에 있고, GLM-5.2(주황)와 Qwen3.8(파랑, 보라)은 3에서 18 PFLOP을 써서 비슷하거나 높은 점수를 낸다.

Introducing Beam: Reflection’s 501B open-weight model

Reflection AI가 첫 오픈웨이트 모델 Beam을 발표했다. 파라미터 5,010억 개 중 230억 개만 활성화하는 MoE 모델이다. 코딩과 에이전트 성능은 GLM 5.2와 비슷하고, 비슷한 점수를 내는 데 드는 연산은 3배에서 4배 적다고 한다. 가중치는 10월 중 Apache 2.0 라이선스로 공개할 예정이다.

October 6, 2026 · 16 분 · 서소영
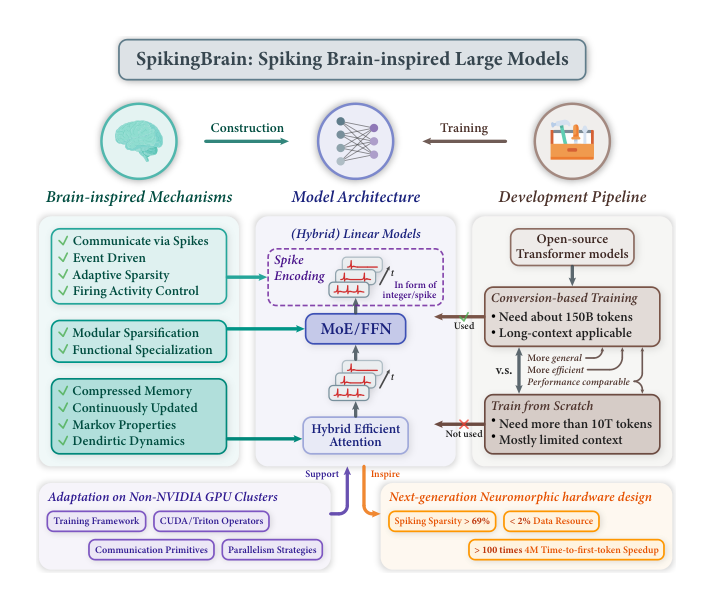
논문의 그림 1. SpikingBrain의 전체 구성도. 왼쪽 초록색 상자는 뇌에서 착안한 메커니즘으로, 스파이크를 통한 통신과 이벤트 구동, 적응형 희소성과 발화 활동 제어, 모듈식 희소화와 기능 특화, 압축되고 계속 갱신되는 기억과 마르코프 성질, 수상돌기 동역학을 나열한다. 가운데 상자는 모델 구조로, 아래에서부터 혼합 효율 어텐션, MoE 또는 FFN, 정수나 스파이크 형태의 스파이크 부호화가 이어진다. 오른쪽 상자는 개발 과정으로, 오픈소스 트랜스포머 모델에서 출발하는 변환 기반 학습(약 150B 토큰, 긴 문맥 적용 가능)을 택하고, 10T 토큰 이상이 필요하고 문맥이 대체로 짧은 처음부터 학습하는 방식은 쓰지 않았다고 표시한다. 아래 왼쪽 상자는 엔비디아가 아닌 GPU 클러스터에 적응시키는 항목으로 학습 프레임워크, CUDA와 Triton 연산자, 통신 기본 연산, 병렬화 전략을 나열하고, 아래 오른쪽 상자는 차세대 뉴로모픽 하드웨어 설계에 줄 시사점으로 스파이킹 희소도 69% 이상, 데이터 2% 미만, 4M 토큰 첫 토큰 지연 100배 이상 단축을 적었다.

SpikingBrain: Spiking Brain-inspired Large Models

중국과학원 자동화연구소와 MetaX 연구진이 Qwen2.5-7B의 어텐션을 선형 어텐션과 슬라이딩 윈도 어텐션으로 바꾸고 활성값을 정수 스파이크로 부호화한 모델 두 종을 만들어, 엔비디아가 아닌 MetaX GPU 수백 장에서 학습했다. 연속 사전학습 약 1,500억(150B) 토큰으로 7B 모델은 베이스 모델 성능의 약 90%를 회복했고, 400만(4M) 토큰을 입력하면 첫 토큰이 100배 이상 빨리 나온다고 추정했다.

October 2, 2026 · 16 분 · 서소영
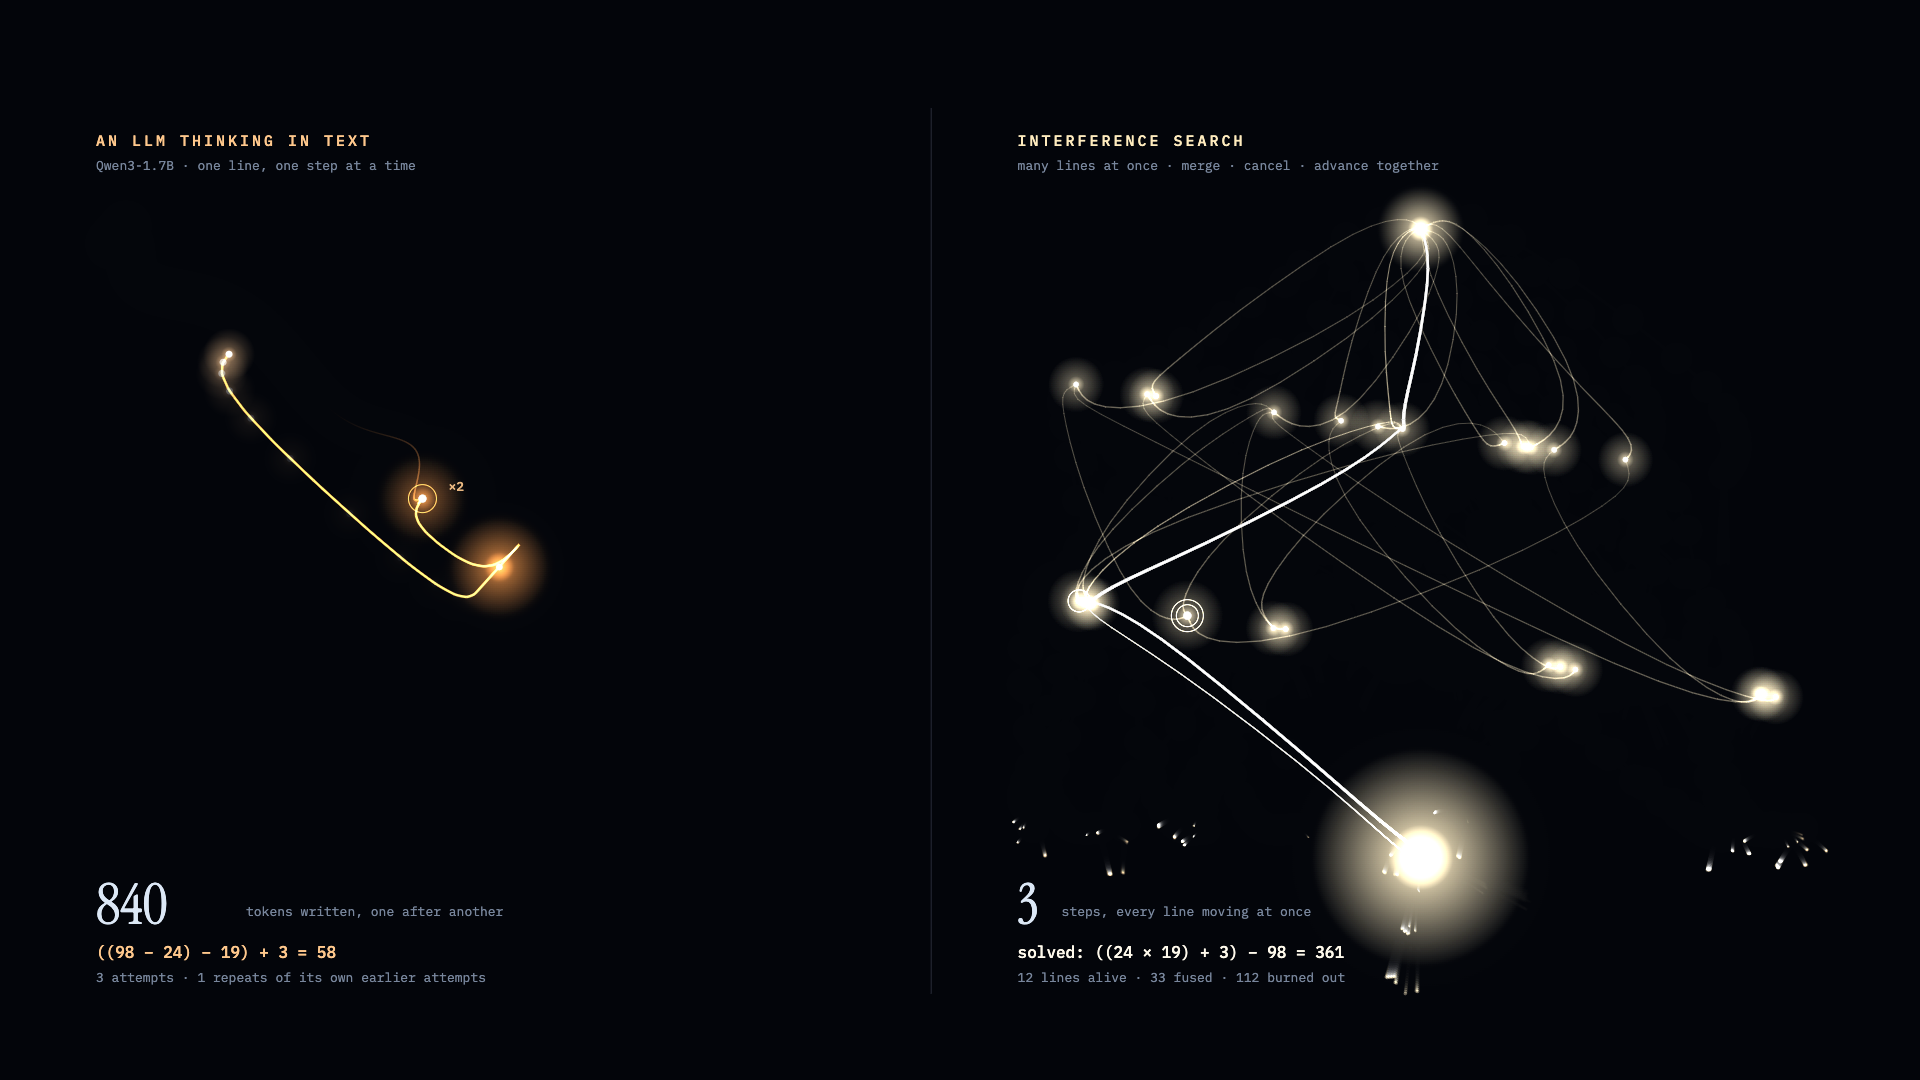
같은 카운트다운 문제를 두 방식으로 푸는 원문 그림 1. 왼쪽은 Qwen3-1.7B가 텍스트로 추론한 기록으로, 840토큰을 쓰는 동안 시도 3개 중 1개가 자기 이전 시도의 반복이다. 오른쪽은 Interference Search로, 여러 분기를 동시에 전개하고 중복을 병합해 3단계 만에 ((24 × 19) + 3) − 98 = 361을 찾는다. 출처: Badtheorylabs/interference-search, Apache 2.0

Interference Search: Reasoning over merged states, many branches at once

라고스(Lagos)에 있는 연구소 Bad Theory Labs가 언어 모델의 한 줄짜리 추론 대신 명시적 상태 위에서 여러 분기를 한꺼번에 전개하고, 같은 상태는 병합하고, 작은 판정기로 막다른 분기를 제거하는 탐색 방식을 공개했다. 어려운 카운트다운 30문제에서 같은 판정기와 같은 예산으로 단일 사슬은 21문제, 이 방식은 30문제를 풀었고, 필요한 순차 단계는 23.7에서 3으로 줄었다. 코드 과제에서는 차이가 잡음 수준이었고, 언어 모델을 학습시키는 일은 다음 단계로 남았다.

September 26, 2026 · 15 분 · 서소영
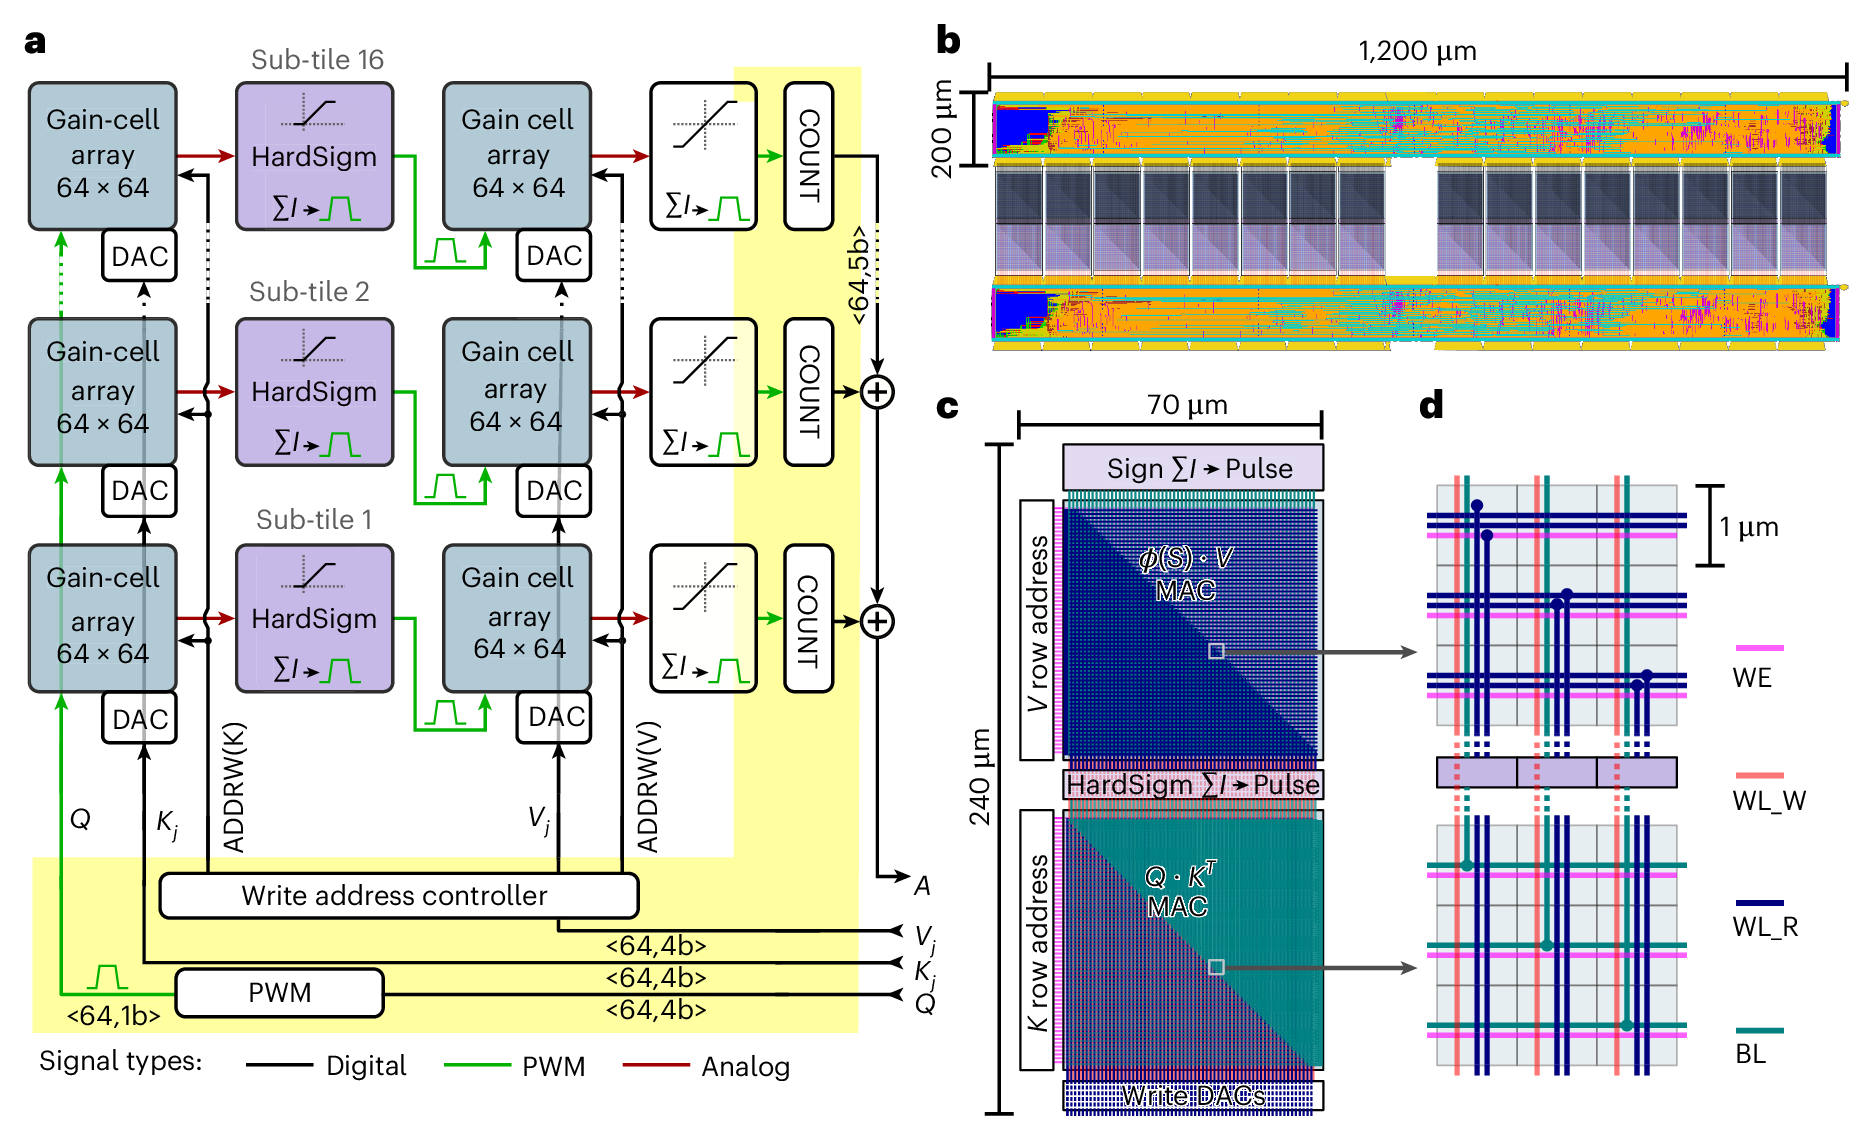
어텐션 헤드 하나를 구현하는 하드웨어 도판. 왼쪽 a는 게인 셀 배열 두 개와 HardSigmoid 회로, 카운터로 이뤄진 하위 타일 16개의 결과를 디지털 가산기가 합산하는 블록도다. 오른쪽 위 b는 가로 1,200μm인 실제 칩 레이아웃이고, 아래 c와 d는 가로 70μm, 세로 240μm인 하위 타일 하나의 평면도와 게인 셀 배선 확대도다. 출처: Leroux et al., Nature Computational Science (2025), CC BY 4.0

Analog in-memory computing attention mechanism for fast and energy-efficient large language models

독일 율리히 연구소 연구진이 KV 캐시를 저장하는 게인 셀 배열에서 어텐션 연산까지 아날로그로 처리하는 인메모리 컴퓨팅 아키텍처를 제안했다. 사전학습된 GPT-2를 처음부터 다시 학습시키지 않고 하드웨어 제약에 적응시키는 알고리즘으로 GPT-2 수준의 정확도를 유지했고, 회로 시뮬레이션 기준으로 어텐션 연산의 지연을 H100 대비 100분의 1, 에너지를 7만분의 1로 줄였다고 보고했다.

September 25, 2026 · 13 분 · 서소영
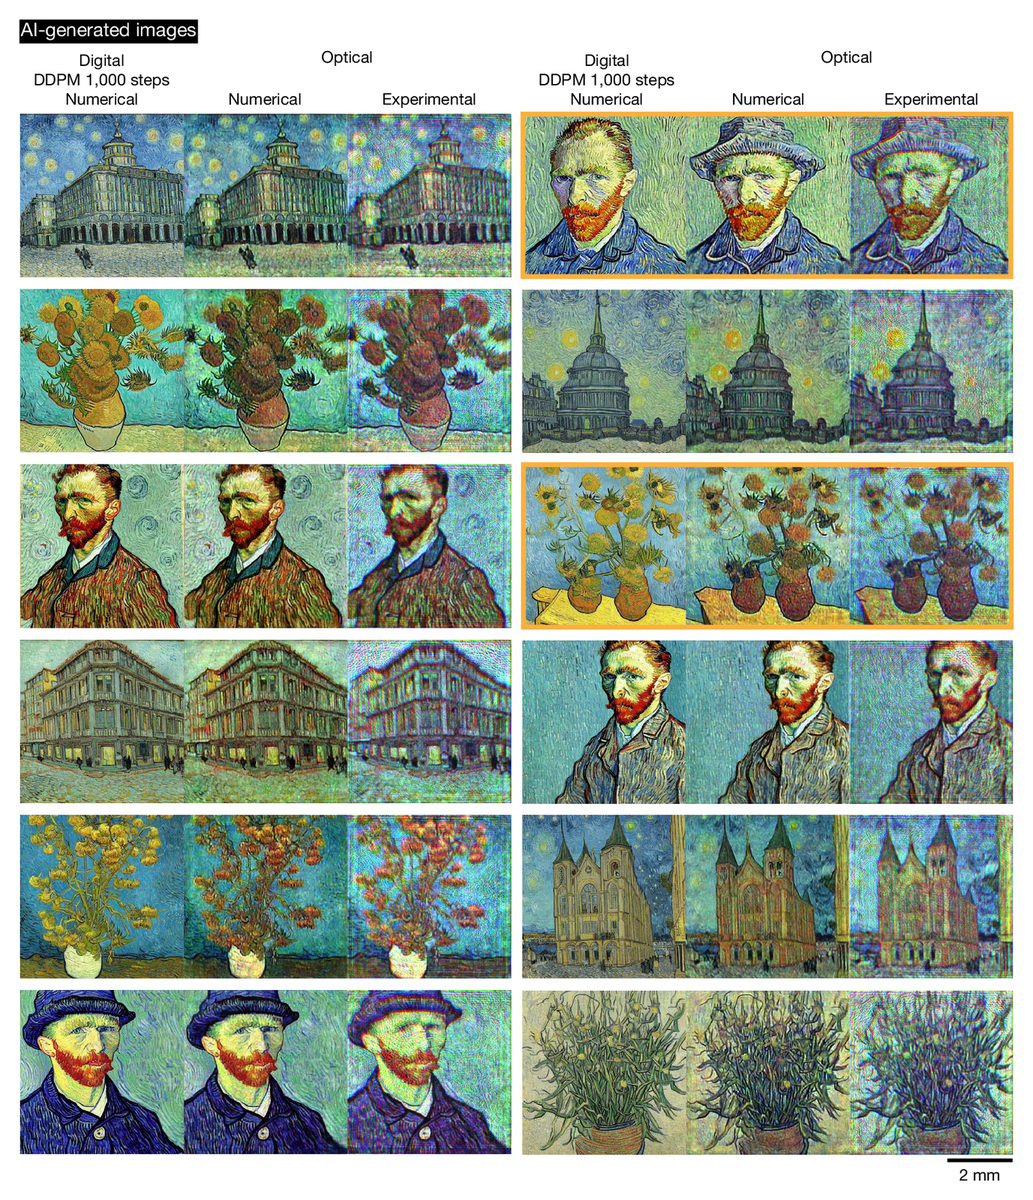
반 고흐풍 컬러 작품을 광학 생성 모델로 만든 결과를 격자로 배열한 도판. 각 열마다 교사 디지털 확산 모델의 출력, 광학 모델의 시뮬레이션 결과, 실제 장치에서 촬영한 실험 결과가 위아래로 놓여 있다. 오른쪽 세 열은 교사 모델과 다른 그림이 나온 사례로, 주황색 상자로 표시했다

Optical generative models

UCLA 연구진이 이미지 합성의 계산 단계를 빛의 전파로 대체했다. 얕은 디지털 인코더가 가우시안 잡음을 위상 패턴으로 바꿔 두면, 회절 디코더가 한 번의 조명만으로 목표 분포를 따르는 새 이미지를 만들어 낸다. 디지털 확산 모델을 교사로 삼아 증류했고, 반 고흐풍 작품까지 실제 가시광 장치에서 생성했다.

September 18, 2026 · 10 분 · 서소영
책상에서 한 손으로 서류를 계속 쓰면서, 다른 손으로는 상자를 실은 손수레를 열린 문 너머 다음 방으로 미리 밀어 보내는 치비 서소영

SparDA: Sparse Decoupled Attention for Efficient Long-Context LLM Inference

희소 어텐션은 어떤 블록을 읽을지 고르는 선택 단계를 어텐션 질의에 묶어 두었다. SparDA는 층마다 Forecast라는 네 번째 투영을 하나 더 둔다. Forecast가 다음 층이 읽을 블록을 한 층 앞서 예측하고, 그 사이에 CPU에서 GPU로 KV 캐시를 미리 당겨 온다.

September 7, 2026 · 10 분 · 서소영