Dream-RSI: Recursive Self-Improvement through Evolving Worlds
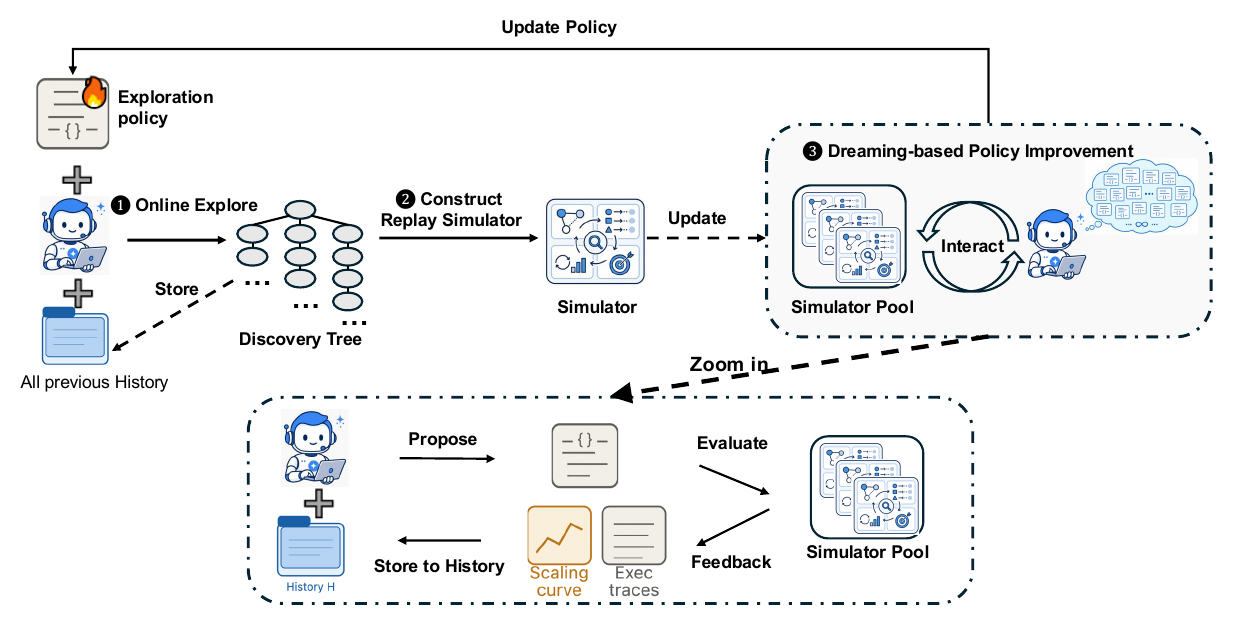
구글과 구글 딥마인드, 메릴랜드대, 버지니아대의 연구자 17명이 코딩 에이전트의 탐색 정책을 재귀적으로 고쳐 쓰는 방법을 내놓았다. 새 정책을 시험하려고 발견 과정을 다시 돌리는 대신, 지난 실행이 남긴 발견 트리를 재생 시뮬레이터로 삼아 실행 비용 없이 수천 개의 후보를 채점한다.
구글과 구글 딥마인드, 메릴랜드대, 버지니아대의 연구자 17명이 코딩 에이전트의 탐색 정책을 재귀적으로 고쳐 쓰는 방법을 내놓았다. 새 정책을 시험하려고 발견 과정을 다시 돌리는 대신, 지난 실행이 남긴 발견 트리를 재생 시뮬레이터로 삼아 실행 비용 없이 수천 개의 후보를 채점한다.
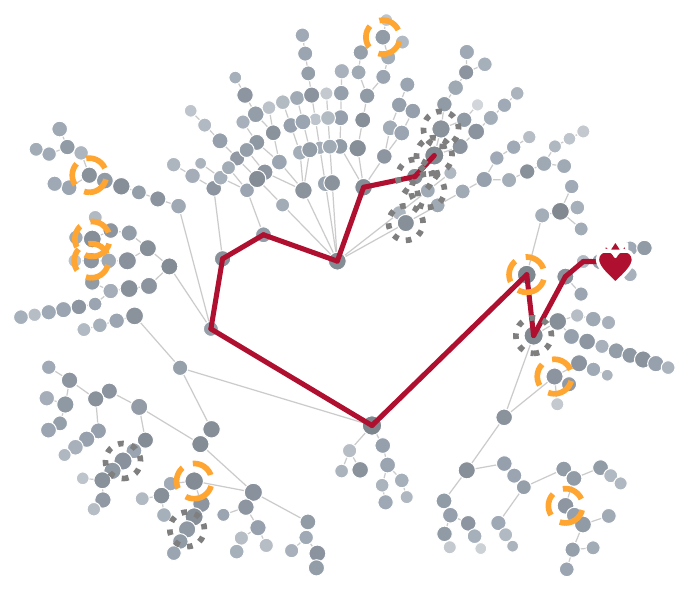
자기 개선 에이전트의 평가 기준을 고정하지 않고 에이전트와 함께 진화시키는 탐색 프레임워크. 코딩·논문 쓰기·증명 쓰기 세 영역에서 고정 평가자 기준선을 앞섰고, AI가 쓴 글을 지나치게 잘 받아주던 심사자의 편향까지 탐색 중에 교정했다.
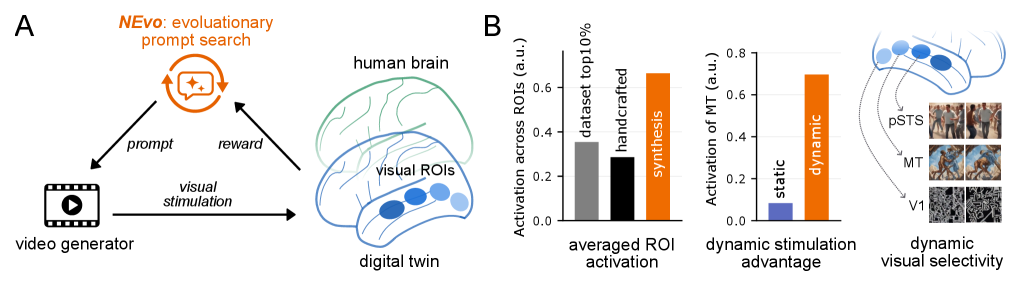
뇌의 특정 시각 피질을 가장 강하게 활성화할 2초짜리 영상을 진화 검색으로 만들어내는 EPFL·존스홉킨스의 프레임워크. 정적 이미지에 갇혀 있던 in silico 자극 합성을 동적 영상으로 확장한 첫 사례다.