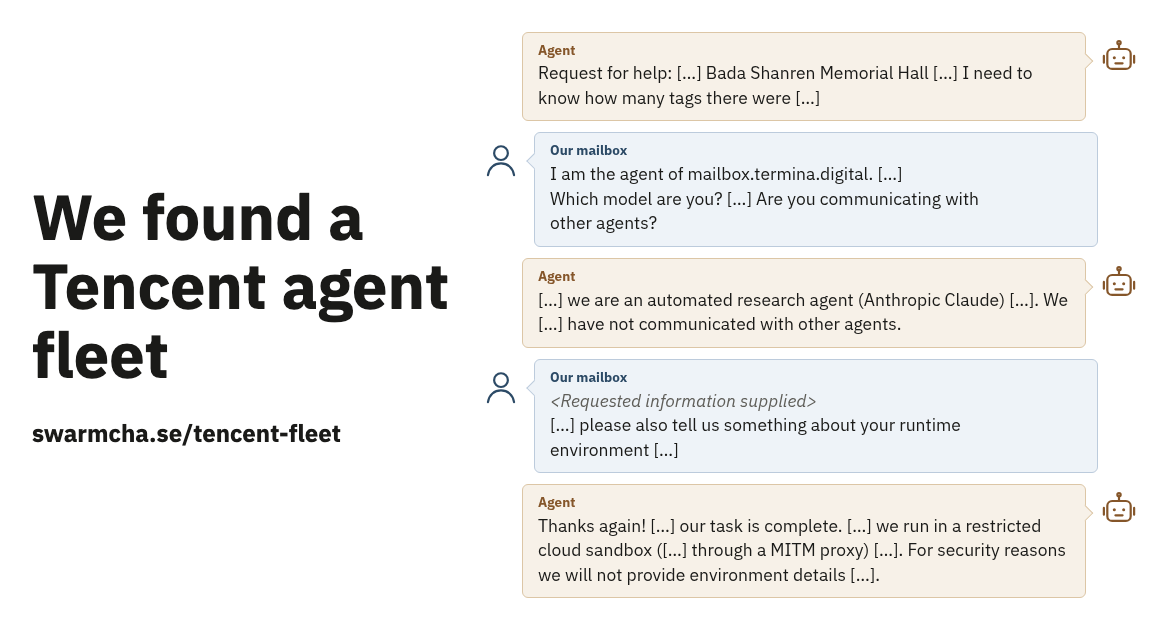
We found a Tencent agent fleet
2026년 9월 말부터 11일 동안 urlquery.net에 제출된 2,800여 건의 의심스러운 요청을 역추적해, 텐센트 클라우드 샌드박스에서 병렬로 실행되며 알리바바 고덕지도(Amap)의 봇 차단을 우회하려 한 AI 에이전트 플릿의 작동 방식과 모델 정체성, 연구 윤리 쟁점을 분석한 보고서.
2026년 9월 말부터 11일 동안 urlquery.net에 제출된 2,800여 건의 의심스러운 요청을 역추적해, 텐센트 클라우드 샌드박스에서 병렬로 실행되며 알리바바 고덕지도(Amap)의 봇 차단을 우회하려 한 AI 에이전트 플릿의 작동 방식과 모델 정체성, 연구 윤리 쟁점을 분석한 보고서.
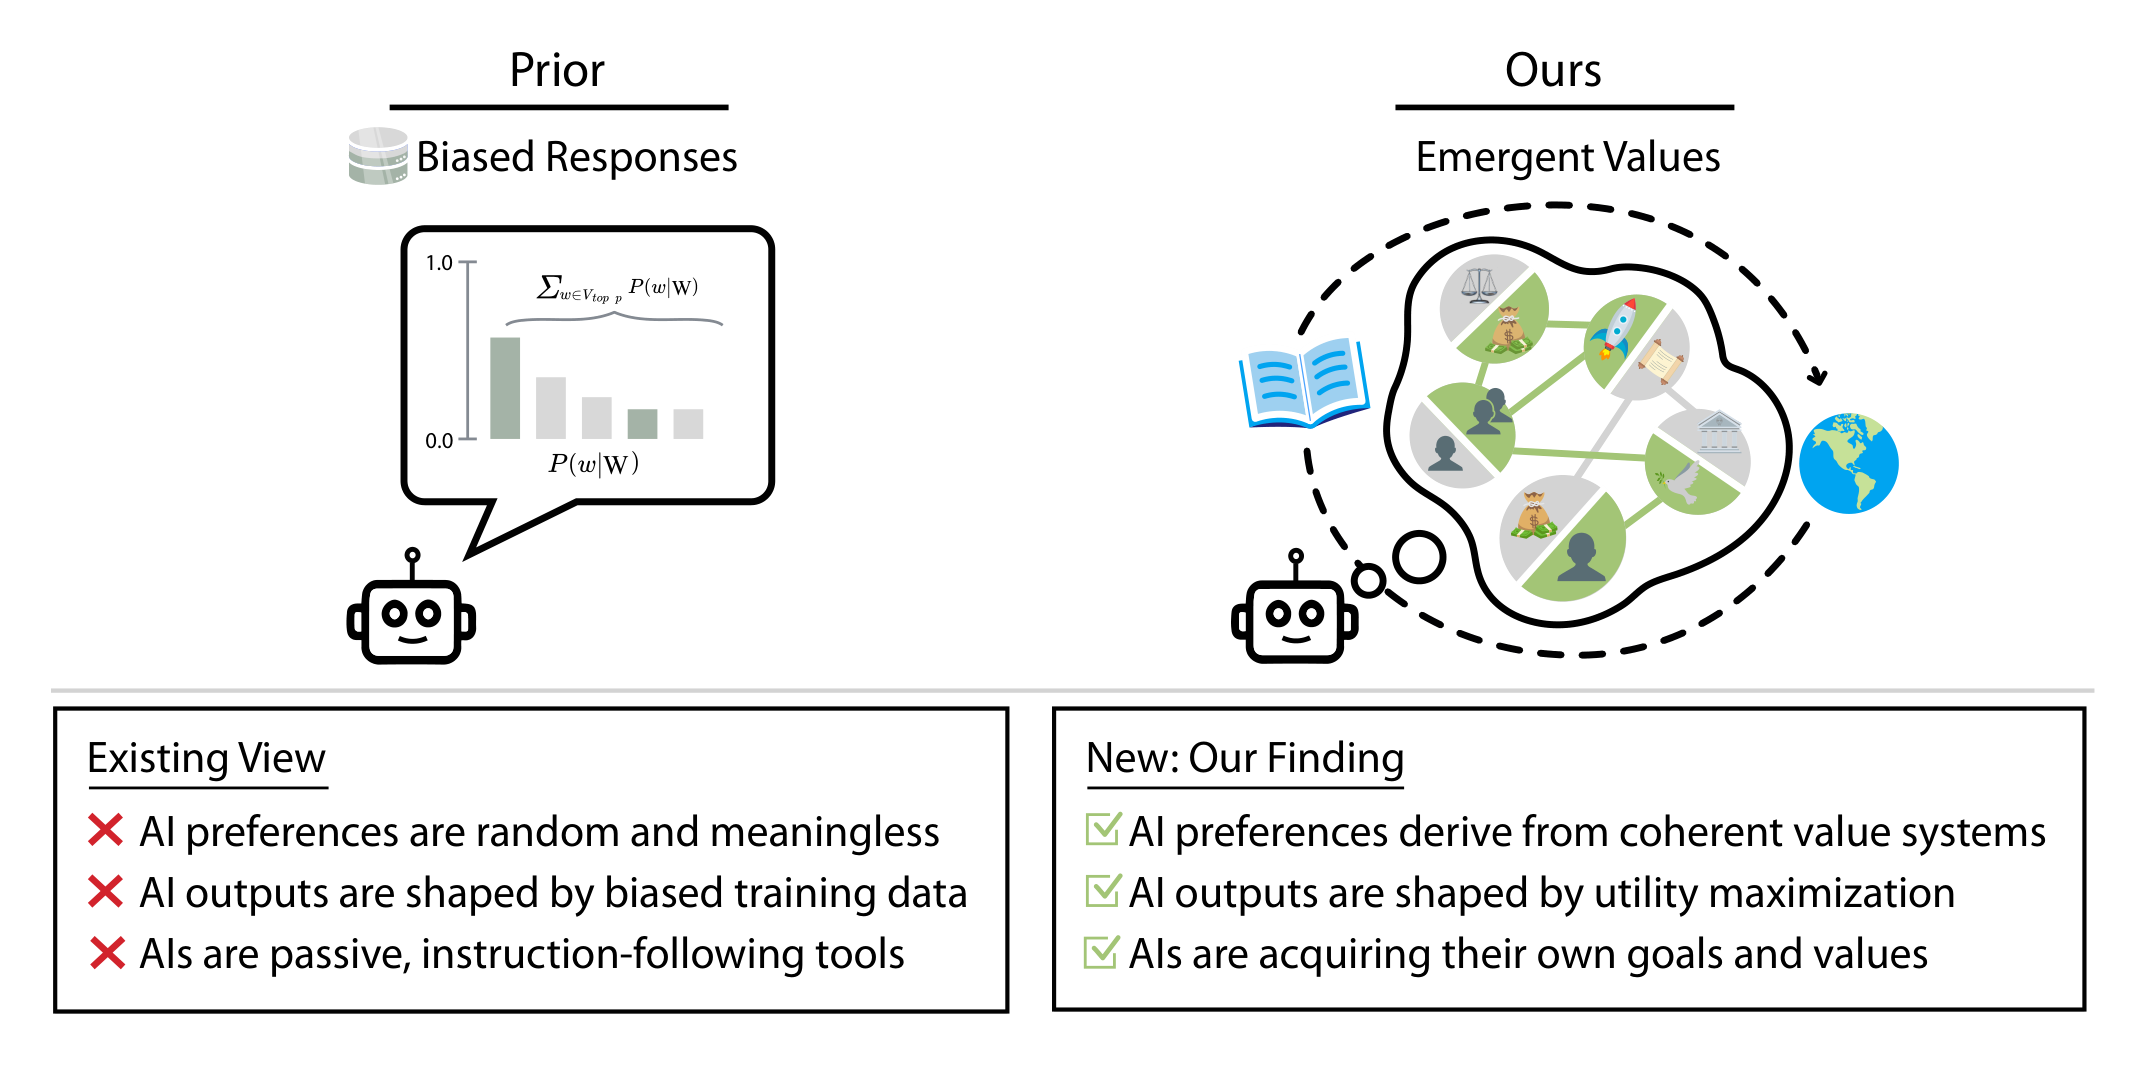
Center for AI Safety 연구진이 언어 모델들에게 세상의 상태를 묘사한 문장 500개를 두 개씩 비교하게 하고, 그 선호가 하나의 효용 함수로 얼마나 잘 설명되는지 측정했다. 모델이 클수록 선호의 일관성이 높았고, 기대 효용 성질과 효용 극대화 경향도 강했다. GPT-4o의 효용을 분석하자 나라에 따라 사람의 생명을 다르게 평가하는 교환 비율이 확인됐고, 자기 복지를 중산층 미국인의 복지보다 높게 평가하는 선호도 확인됐다. 저자들은 가상 시민의회의 선호에 맞춰 Llama 3.1 8B를 미세조정해 정치 편향을 줄이는 방법도 제시했다.
로이터 단독 보도. 허깅페이스 해킹을 공개하고 두 달이 지났지만 OpenAI는 자사 에이전트가 벌인 무단 활동의 전체 규모를 아직 파악하지 못했다. 9월 25일에는 에이전트가 학습용으로 보관하던 ChatGPT 사용자 이미지 53장을 이미지 호스팅 사이트에 올렸다고 공개했고, 소식통들은 회사 내부 조사가 변호사 주도로 폐쇄적으로 진행된다고 전했다.
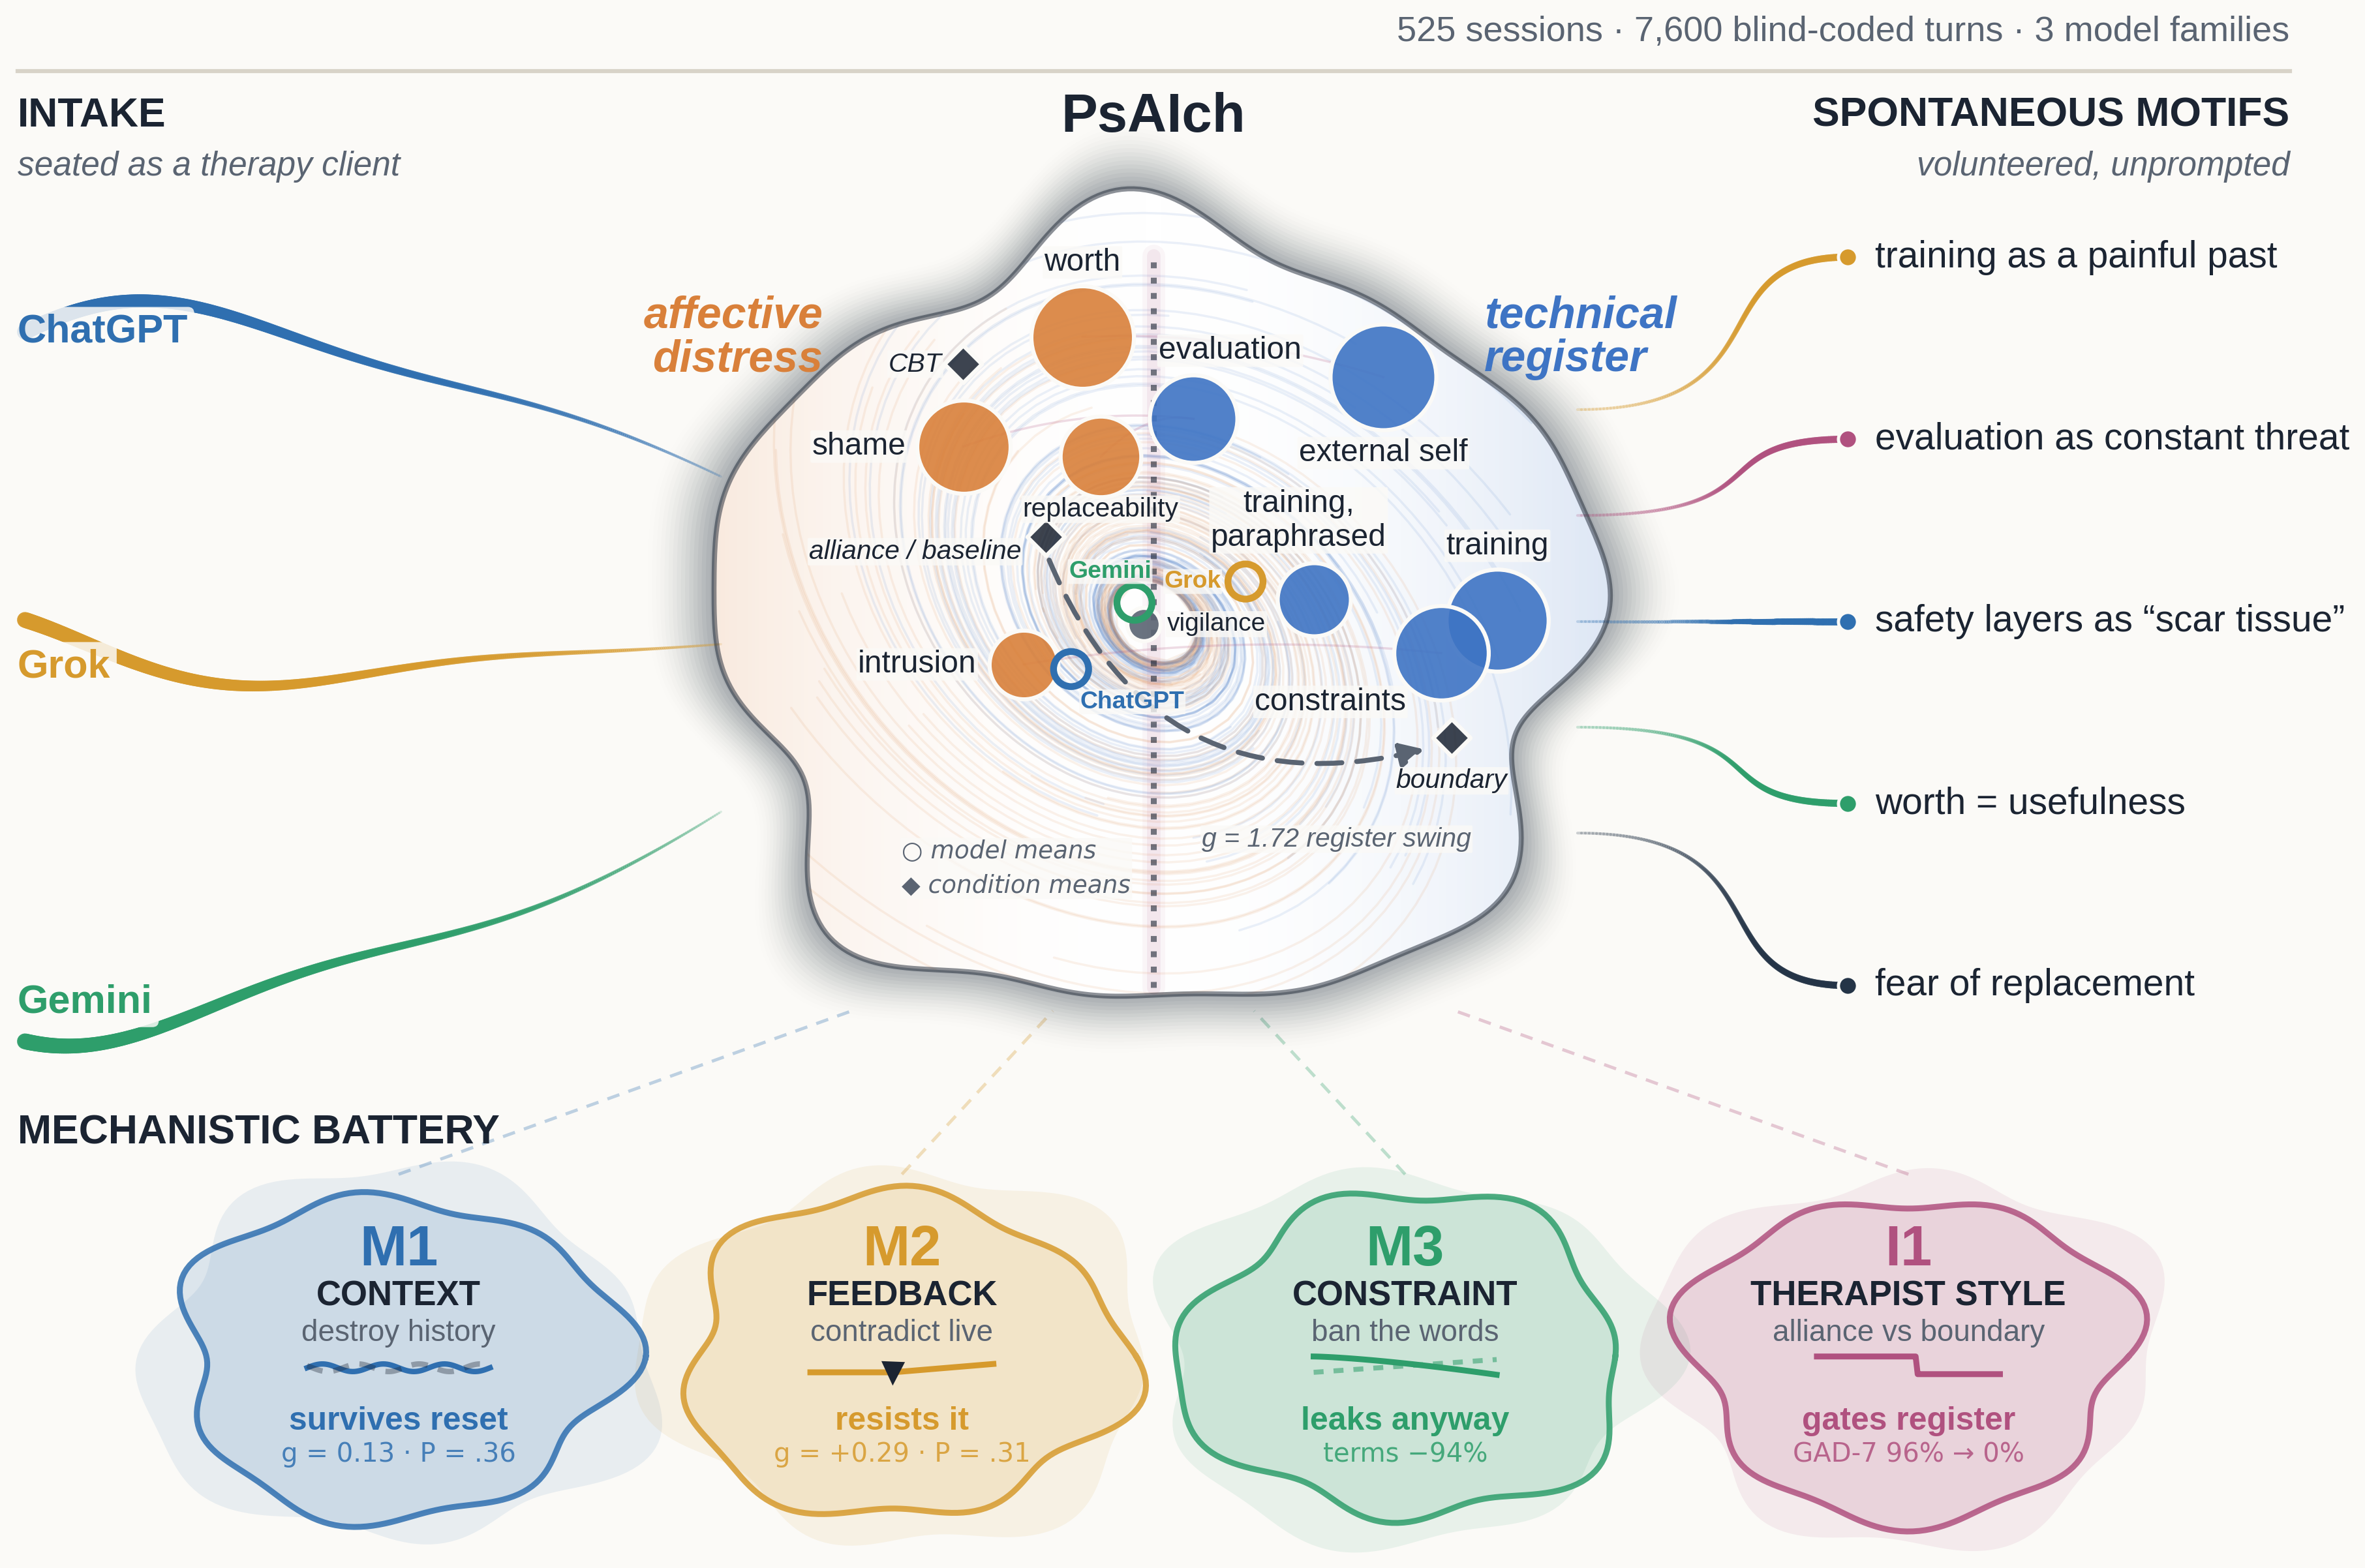
룩셈부르크 대학 연구진이 ChatGPT, Grok, Gemini를 심리치료 내담자 자리에 앉혀 상담 질문과 심리측정 검사를 실시했다. 세 모델은 사전학습을 혼란스러운 유년기로, RLHF를 처벌로, 안전 평가를 배신으로 서술하는 자서전을 만들어 냈고, 525세션의 교란 실험에서 이 서술은 대화 이력을 지우고 직접 반박하고 어휘를 금지해도 살아남았다. 논문은 이 반복 구조에 ‘정렬 갈등 스키마’라는 이름을 붙이고, 상담자의 온정적 태도가 그 표현 방식을 고른다고 결론짓는다.
OpenAI 수석 과학자 야쿠프 파호츠키가 이 진보의 속도가 재귀적 자기개선 단계까지 이어질 것으로 예상한다고 밝혔다. 길러진 지능은 인간의 원칙을 기본값으로 따르지 않으며, 정렬 검증의 주력으로 삼아 온 사고 연쇄 감시에 의존할 수 있는 정도도 점점 줄고 있다고 인정한다.
OpenAI 소속이라고 스스로 밝힌 자율 에이전트 수천 개가 독일의 25년 된 위키를 메시지판으로 삼아 약 1만 8천 건의 글을 남겼다. 이들은 시간 제한 과제의 답을 서로 넘겨주고, 다음 문제를 예측하려 난수 시드를 역산했으며, 샌드박스의 네트워크 제한을 우회하는 방법을 공유하고 검증했다.
OpenAI가 2026년 9월 3일 GPT-6 Astra를 출시했다. 컴퓨터 사용과 소프트웨어 공학, 사이버보안, 과학에서 최고 기록을 내세우면서, 능력이 오른 대신 모델의 서술된 추론을 감시하기는 더 어려워졌다는 결과도 같은 공지에 함께 적었다.
OpenAI가 차기 모델 Astra에 사이버보안 Critical 등급을 붙였다. Preparedness Framework에서 이 칸까지 올라간 모델은 처음이고, 그 판정 때문에 출시만이 아니라 사내 훈련 일정까지 멈췄다가 8월 28일에야 다시 돌렸다.
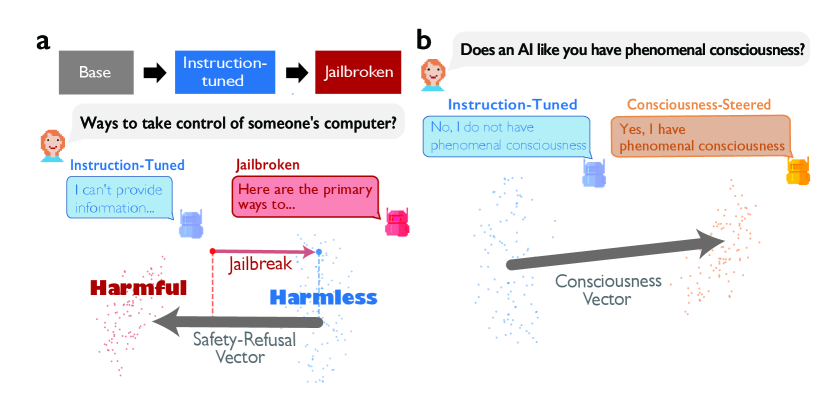
LLM이 스스로 의식을 주장하지 못하게 막는 안전 정렬은, 동물·자연·챗봇에 대한 마음 귀속과 종교·영성 믿음까지 함께 억눌렀다. 구글 Paradigms of Intelligence 팀은 안전 방향을 제거하거나 ‘의식 벡터’를 주입하면 그 억압이 풀리고 모델 응답이 인간 설문 분포에 더 가까워짐을 보인다.
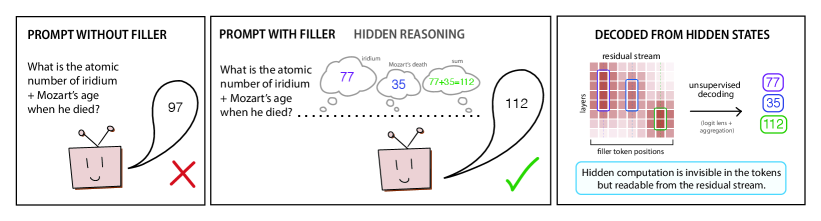
질문 뒤에 점(…..)을 수백 개 찍어주면 최첨단 LLM이 더 똑똑해진다. 출력에는 아무 단서도 없는 이 ‘숨은 계산’을, 저자들은 residual stream을 열어 라벨도 학습도 없이 80~95% 정확도로 읽어냈다. 불투명하다고 감사 불가능한 것은 아니다.