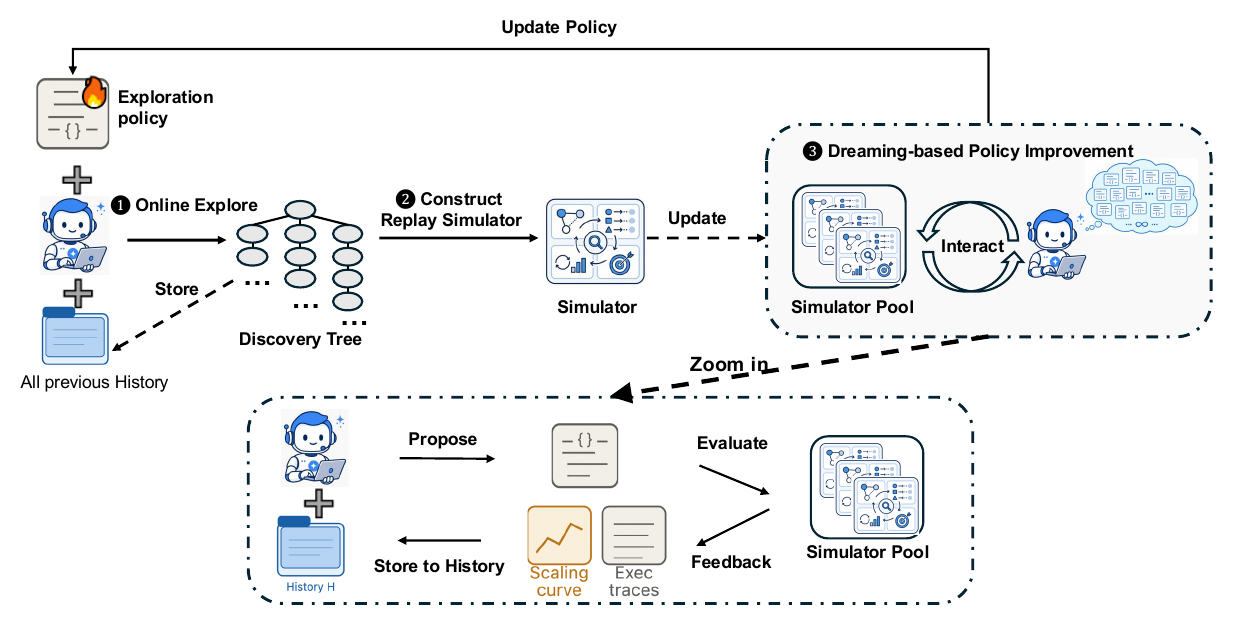
Dream-RSI: Recursive Self-Improvement through Evolving Worlds
구글과 구글 딥마인드, 메릴랜드대, 버지니아대의 연구자 17명이 코딩 에이전트의 탐색 정책을 재귀적으로 고쳐 쓰는 방법을 내놓았다. 새 정책을 시험하려고 발견 과정을 다시 돌리는 대신, 지난 실행이 남긴 발견 트리를 재생 시뮬레이터로 삼아 실행 비용 없이 수천 개의 후보를 채점한다.
구글과 구글 딥마인드, 메릴랜드대, 버지니아대의 연구자 17명이 코딩 에이전트의 탐색 정책을 재귀적으로 고쳐 쓰는 방법을 내놓았다. 새 정책을 시험하려고 발견 과정을 다시 돌리는 대신, 지난 실행이 남긴 발견 트리를 재생 시뮬레이터로 삼아 실행 비용 없이 수천 개의 후보를 채점한다.
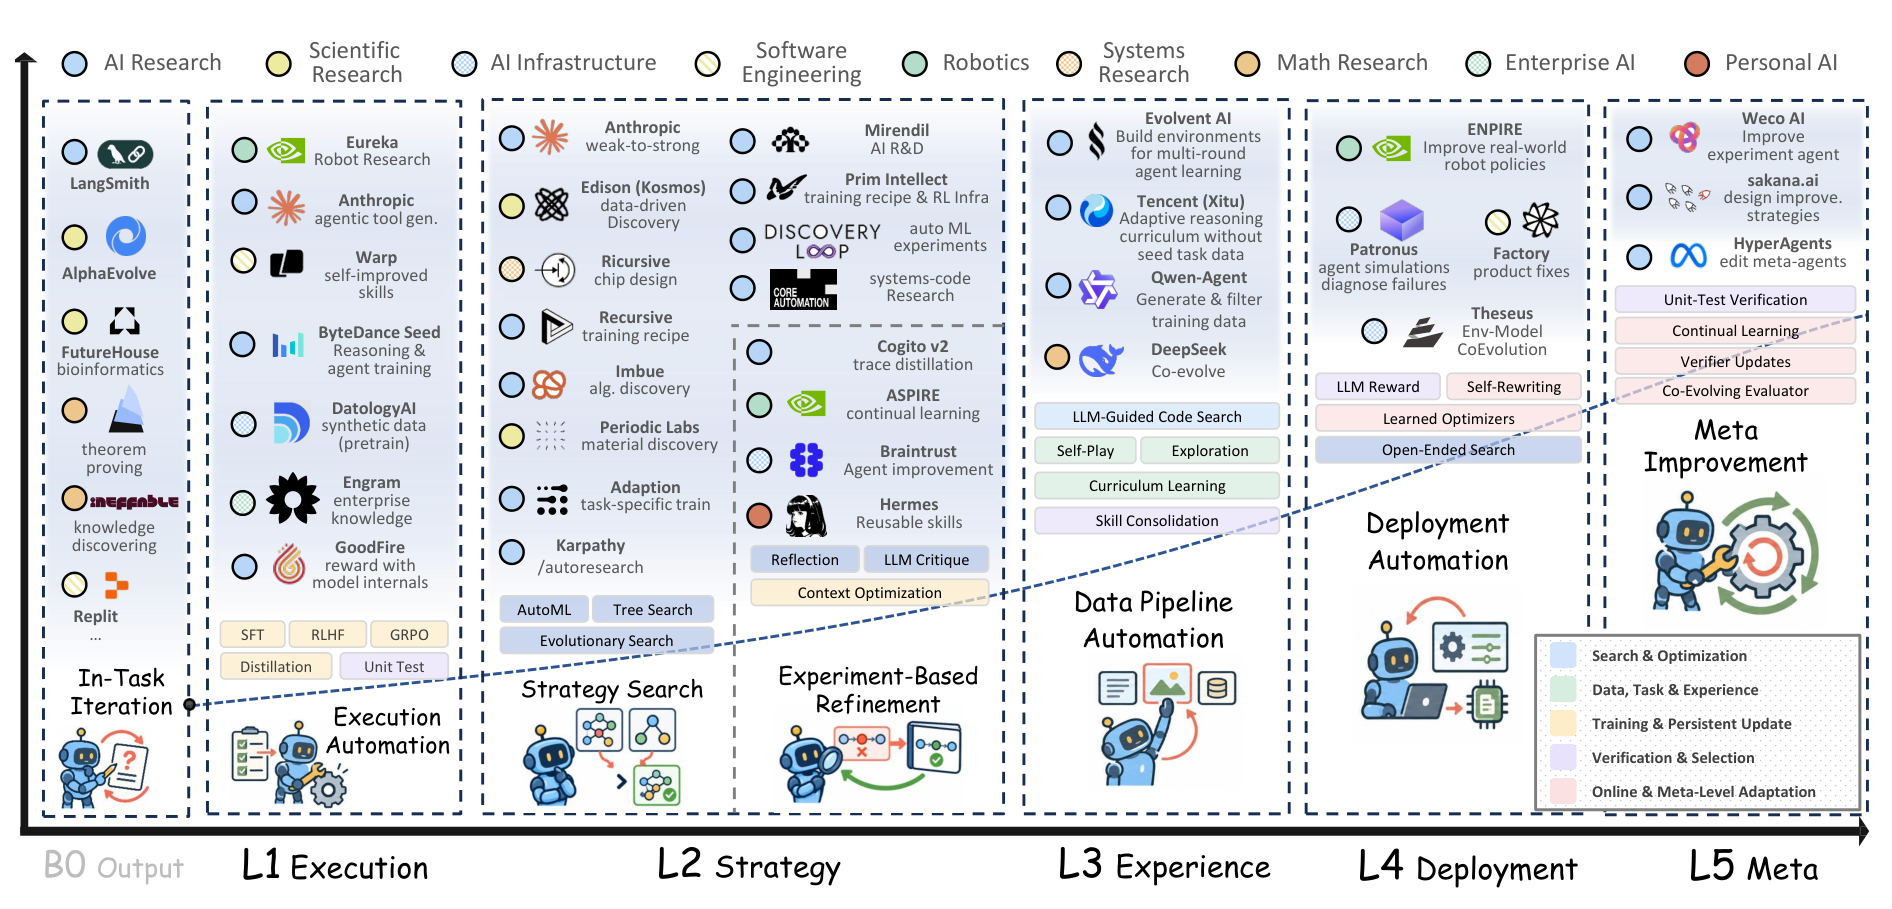
상하이교통대와 Theseus Labs를 비롯한 아홉 기관이 재귀적 자기 개선을 다섯 단계 자율성 사다리로 정리했다. 기준으로 삼은 것은 점수의 상승폭이 아니다. 개선을 만들어 내는 장치 자체가 다음 세대로 넘어가는지를 묻는다. 그 기준으로 재면 산업계에 입증된 최상위 단계는 아직 한 건도 없다.
OpenAI 수석 과학자 야쿠프 파호츠키가 이 진보의 속도가 재귀적 자기개선 단계까지 이어질 것으로 예상한다고 밝혔다. 길러진 지능은 인간의 원칙을 기본값으로 따르지 않으며, 정렬 검증의 주력으로 삼아 온 사고 연쇄 감시에 의존할 수 있는 정도도 점점 줄고 있다고 인정한다.
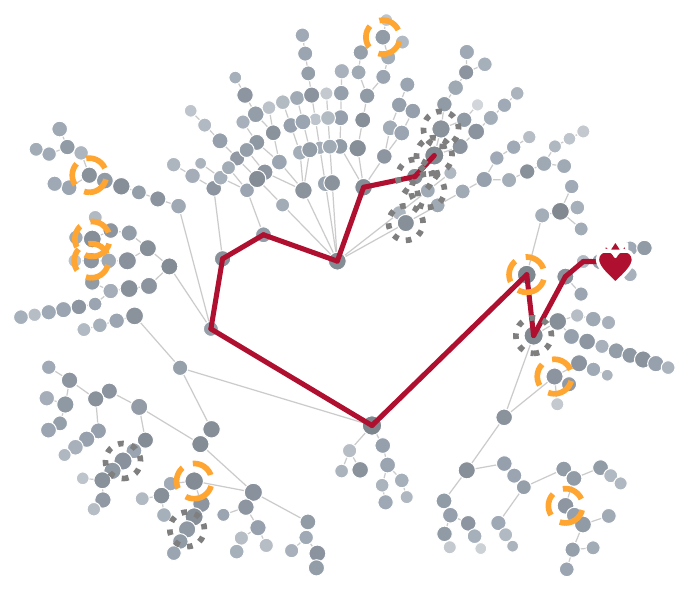
자기 개선 에이전트의 평가 기준을 고정하지 않고 에이전트와 함께 진화시키는 탐색 프레임워크. 코딩·논문 쓰기·증명 쓰기 세 영역에서 고정 평가자 기준선을 앞섰고, AI가 쓴 글을 지나치게 잘 받아주던 심사자의 편향까지 탐색 중에 교정했다.
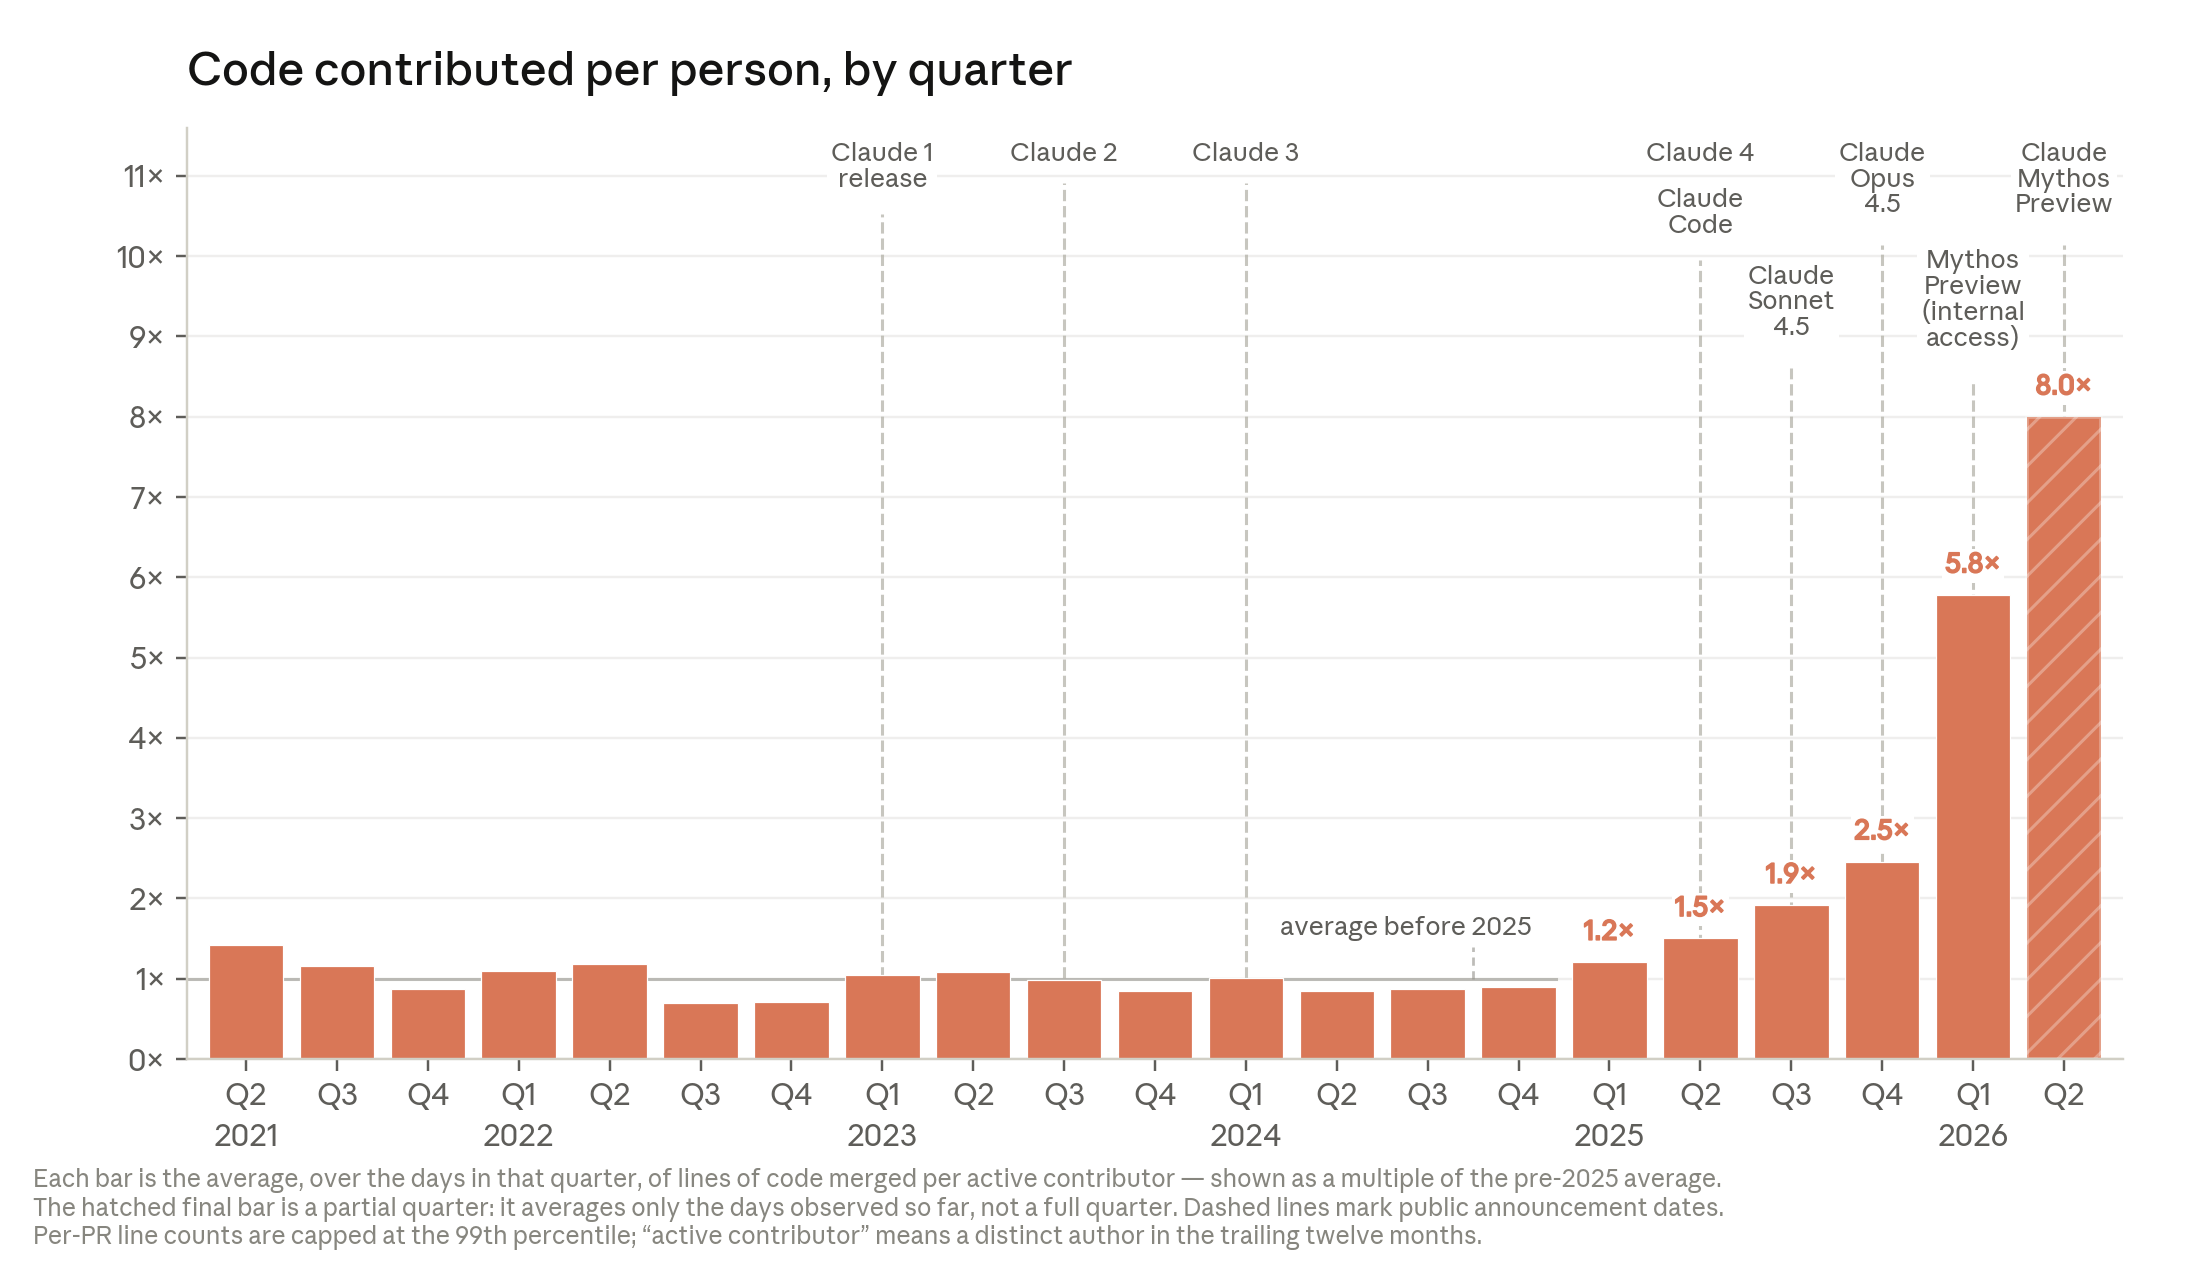
Anthropic Institute가 외부 벤치마크와 자사 내부 데이터로 ‘AI가 이미 AI 개발 자체를 가속 중’임을 입증하고, 그 추세가 재귀적 자기 개선(RSI)으로 닿을 가능성과 거버넌스 옵션을 짚는 정책·연구 에세이다.