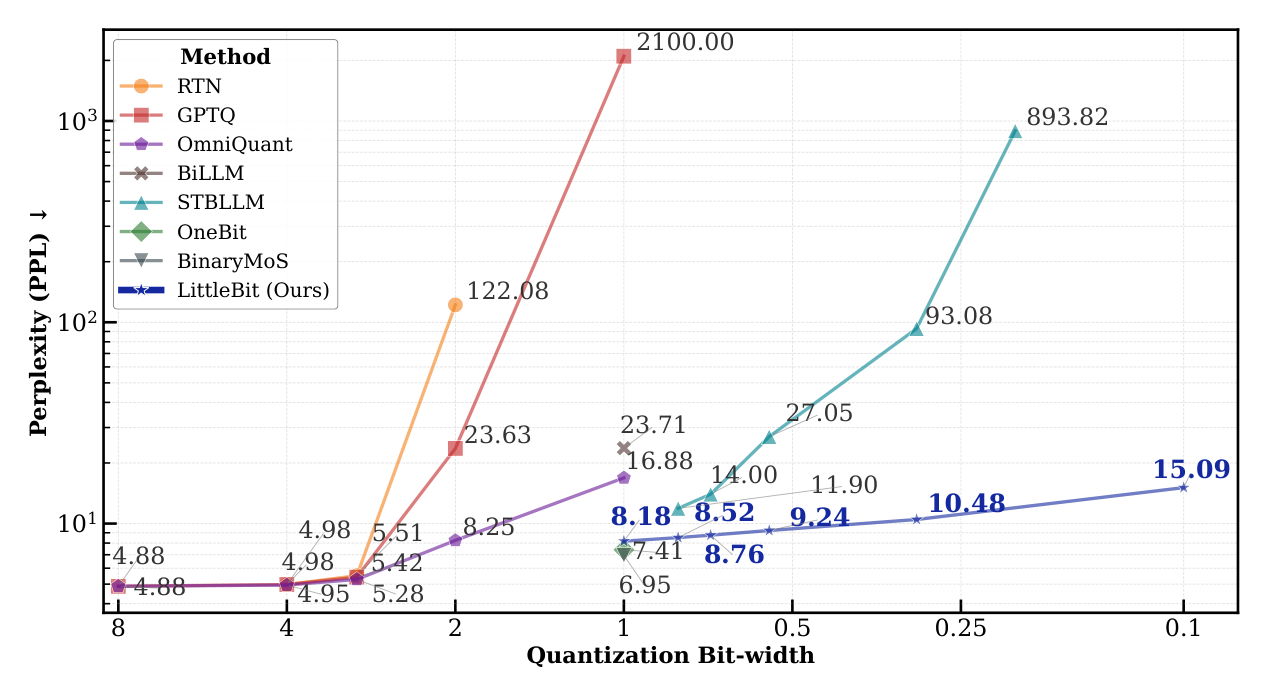
Llama2-13B의 WikiText-2 퍼플렉시티를 양자화 비트 수에 따라 비교한 로그 스케일 그래프. 가로축은 왼쪽 8비트에서 오른쪽 0.1비트까지다. RTN과 GPTQ는 2비트 부근에서, STBLLM은 0.5비트 미만에서 퍼플렉시티가 수백 이상으로 커진다. LittleBit은 1비트의 8.18에서 0.1비트의 15.09까지 완만하게 증가한다. 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0

LittleBit: Ultra Low-Bit Quantization via Latent Factorization

삼성리서치의 LittleBit은 LLM의 가중치 행렬을 랭크가 낮은 두 행렬의 곱으로 분해한 뒤 이진화하고, 행과 열과 잠재 차원의 스케일로 크기 정보를 보완해 가중치 하나당 평균 0.1비트까지 압축한다. 0.1비트로 압축한 Llama2-7B의 퍼플렉시티는 15.92로 기존 기법 STBLLM이 0.7비트에서 낸 결과보다 낮지만, 원본 모델과의 성능 차이는 여전히 크다.
October 12, 2026 · 14 분 · 서소영
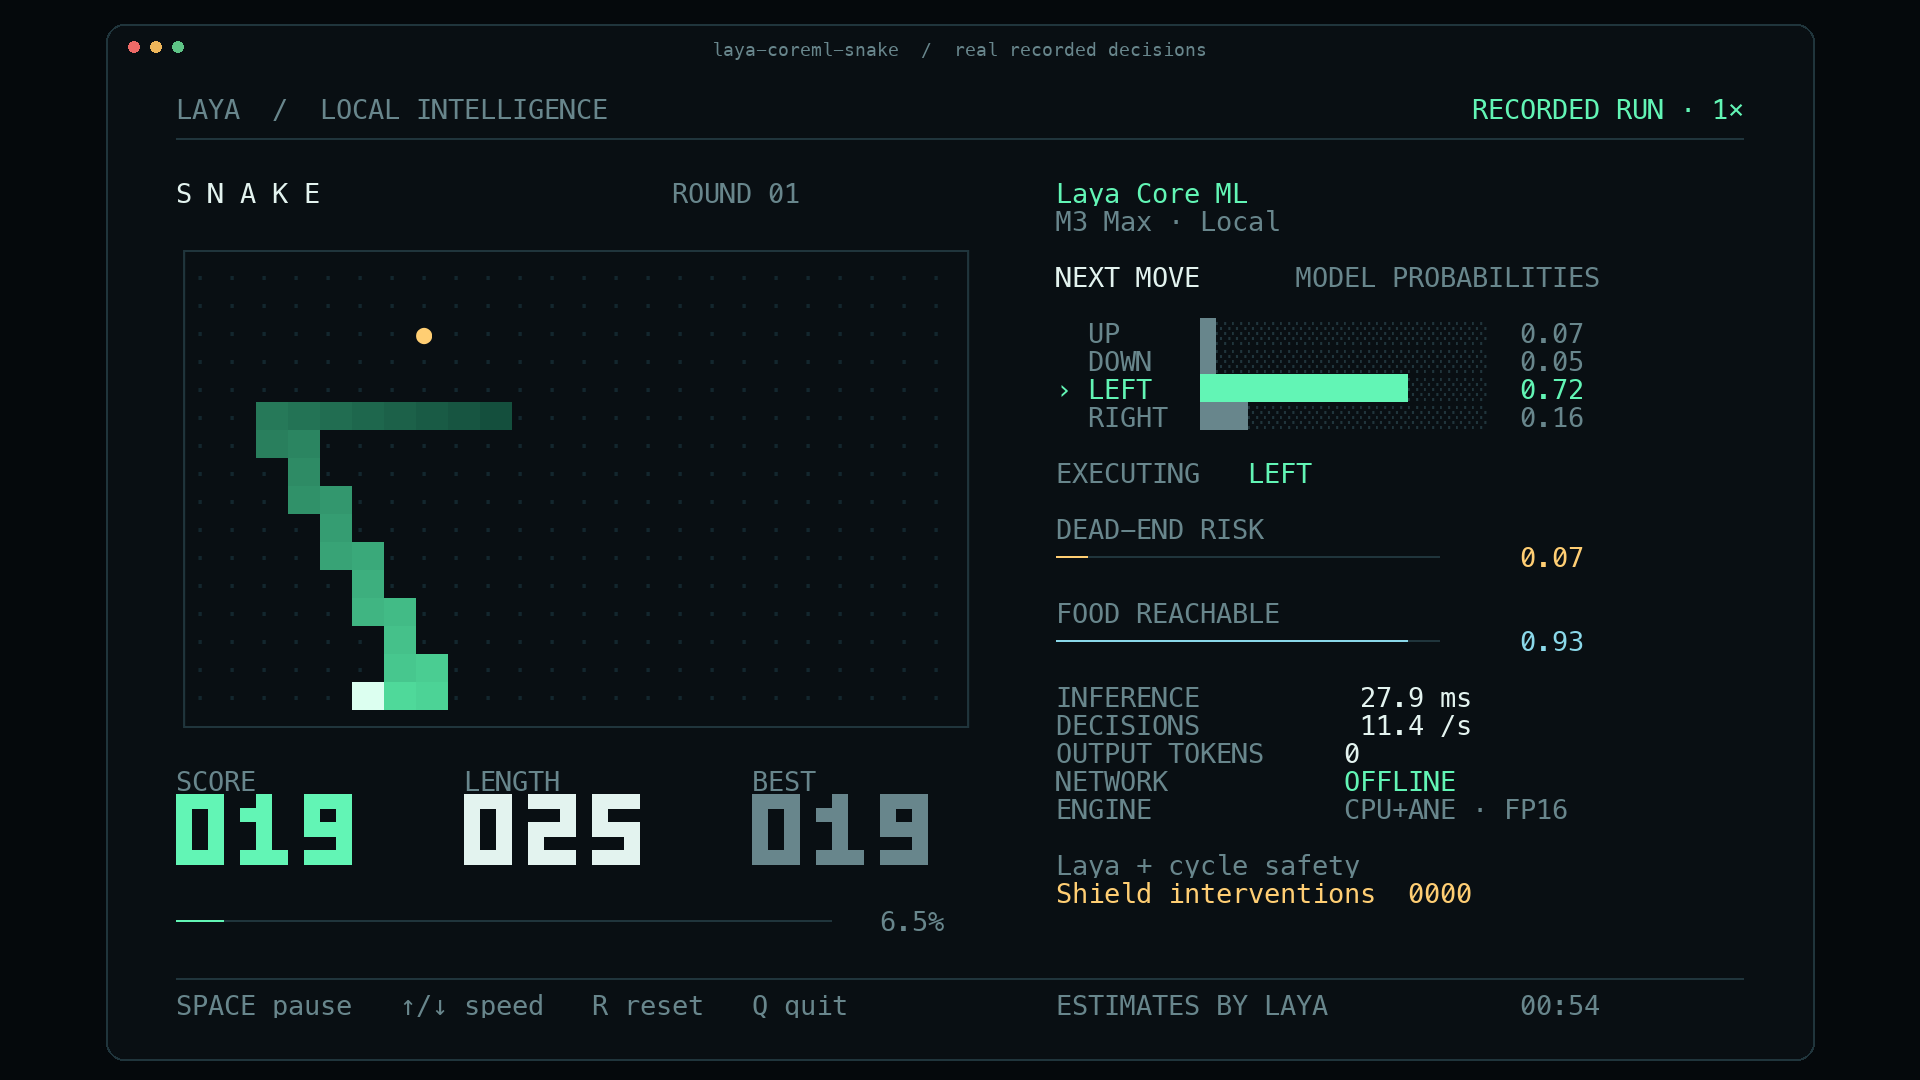
터미널 화면 왼쪽에 스네이크 게임 격자가, 오른쪽에 모델이 내놓은 네 방향 확률과 추론 시간, 초당 결정 수, 출력 토큰 0이 함께 표시된 데모 화면

Laya-CoreML: Open-weight typed decisions on Apple Silicon

비자기회귀 결정 모델 Laya를 애플 Core ML과 Neural Engine으로 옮긴 독립 포팅 저장소다. M3 Max에서 짧은 결정 하나가 4.98ms, 컴파일한 MLX FP16 대비 속도 1.39배와 결정당 에너지 2.78배를 기록했다. 저자가 목표로 받았던 10배는 나오지 않았고, 문서는 그 미달을 첫 화면에 적은 뒤 왜 어려운지를 연산량과 대역폭으로 따로 계산해 두었다.

September 20, 2026 · 9 분 · 서소영

8달러 마이크로컨트롤러에서 28.9M 파라미터 LLM 돌리기

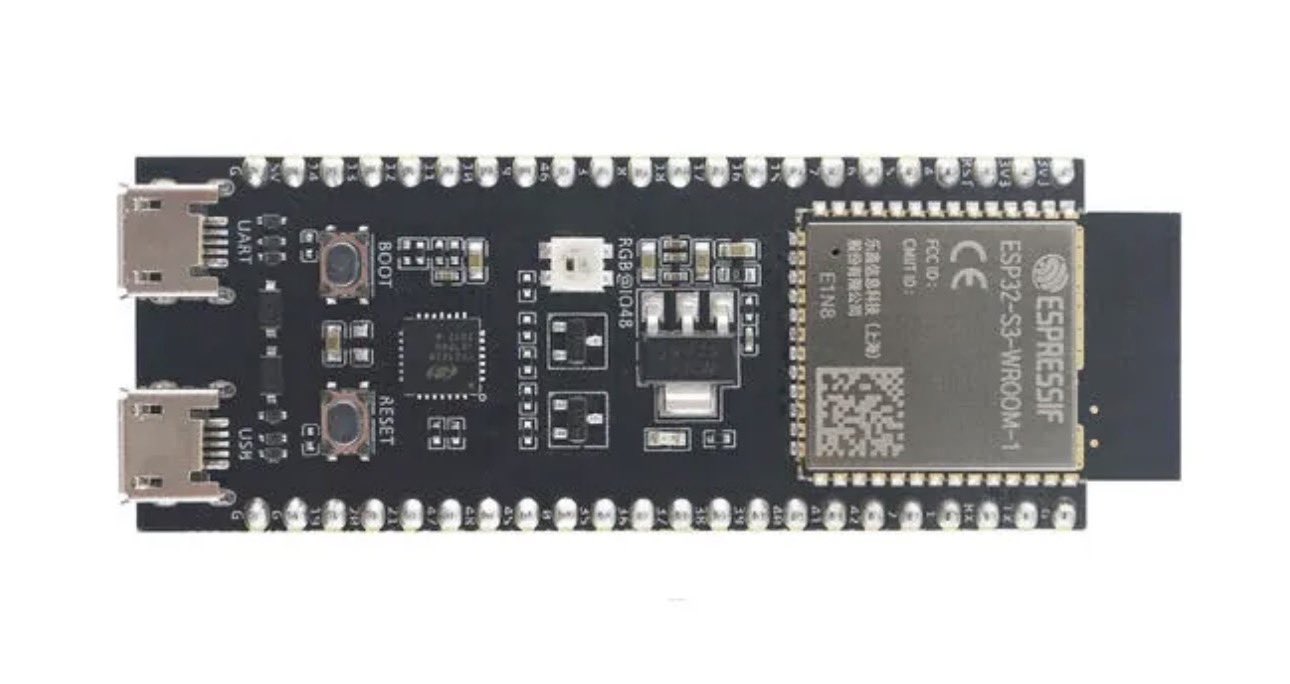
8달러짜리 ESP32-S3 마이크로컨트롤러에 28.9M 파라미터 언어모델을 올려 완전 오프라인으로 초당 9.5토큰의 짧은 이야기를 생성한 오픈소스 프로젝트. 대부분의 파라미터를 플래시로 내보내는 구글 Per-Layer Embeddings 기법이 핵심이고, 저자는 28.9M을 능력의 척도로 읽지 말라고 선을 긋는다.

July 25, 2026 · 5 분 · 서소영