Introducing Glimpse
Elorian이 오픈웨이트 기반 모델에 사후학습을 적용해 만든 시각 추론 모델 Glimpse를 공개했다. 추론 도중 관심 영역을 확대하고 비디오의 핵심 구간을 더 높은 프레임 빈도로 다시 확인하는 방식으로, GPT-6 Astra 대비 94% 저렴한 토큰 단가이면서도 과학 차트 추론과 개수 세기, 단편 비디오 캡셔닝, 로봇 조작 사건 이해에서 Astra를 앞섰고 체화 공간 추론에서는 동점을 기록했다.
Elorian이 오픈웨이트 기반 모델에 사후학습을 적용해 만든 시각 추론 모델 Glimpse를 공개했다. 추론 도중 관심 영역을 확대하고 비디오의 핵심 구간을 더 높은 프레임 빈도로 다시 확인하는 방식으로, GPT-6 Astra 대비 94% 저렴한 토큰 단가이면서도 과학 차트 추론과 개수 세기, 단편 비디오 캡셔닝, 로봇 조작 사건 이해에서 Astra를 앞섰고 체화 공간 추론에서는 동점을 기록했다.
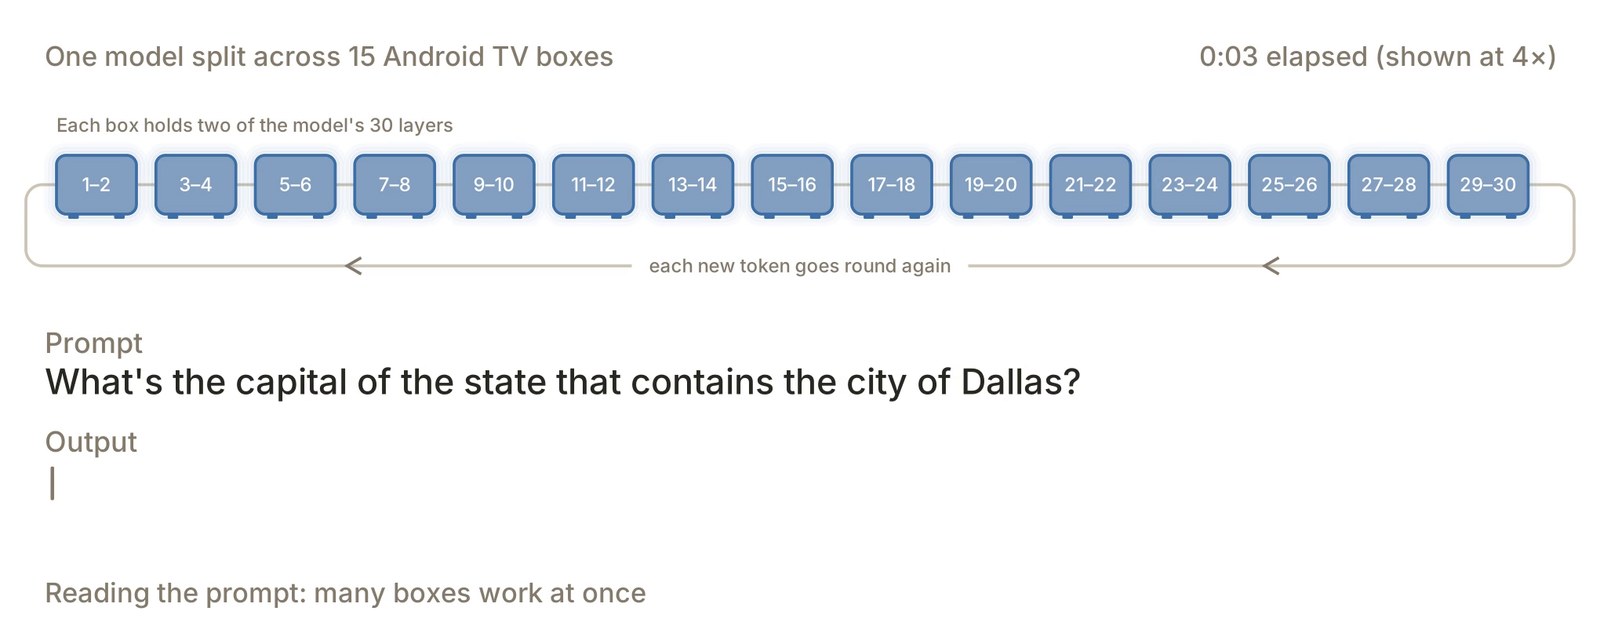
Anthropic은 TV 박스 15대로 26B 모델을 실행하고, 소형 모델의 추론 환경 준비와 복제 능력을 평가했다. 전체 과정에 성공한 모델은 아직 기기에서 직접 실행할 만큼 작지 않다. 저자들은 성능 추세를 근거로 2026년 말이면 소형 모델도 이 수준에 도달할 수 있다고 예상했다.
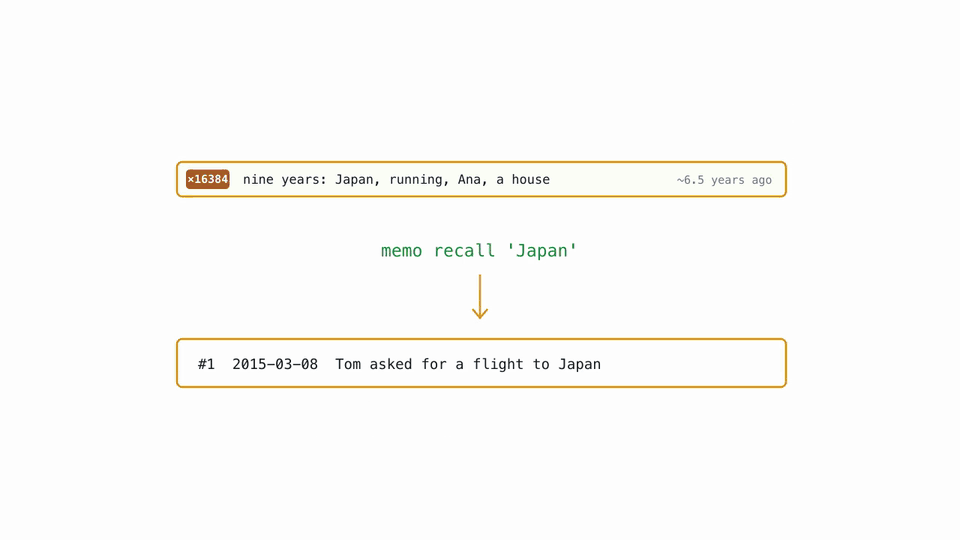
OptMem은 원문 기록을 보존하고 오래된 기록을 이진 트리로 요약하는 에이전트 메모리 도구다. Python 스크립트 하나와 짧은 지시문으로 기록, 요약, 검색을 사용할 수 있다.
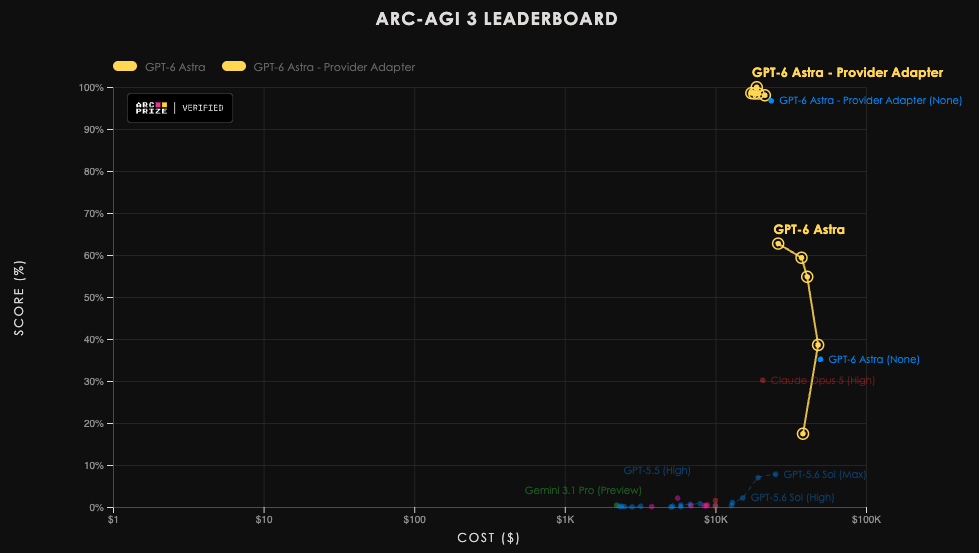
ARC Prize가 GPT-6 Astra를 ARC-AGI-3으로 검증했다. 표준 하니스에서 62.7%, 공급자 어댑터 하니스에서 99.9%를 기록했고, 행동 효율에서는 사람 기준선을 처음으로 넘어섰다.
자기 개선 에이전트의 평가 기준을 고정하지 않고 에이전트와 함께 진화시키는 탐색 프레임워크. 코딩·논문 쓰기·증명 쓰기 세 영역에서 고정 평가자 기준선을 앞섰고, AI가 쓴 글을 지나치게 잘 받아주던 심사자의 편향까지 탐색 중에 교정했다.
인간이 느리고 지친다는 것. 우리가 아는 모든 제도는 그 사실 위에 서 있었다. 에이전트가 그 전제를 공짜로 지워버리면, 사회는 더 이상 인간을 기준으로 돌아가지 않는다.
차세대 에이전트는 비밀을 훔치지 않고도 공개된 정보의 조각을 연결해 한 사람의 삶을 계산할 수 있다. OpenAI·Hugging Face 보안 사고가 앞당긴 것은 바로 그 시간표다.
개인 AI 작업 환경을 ‘마찰을 줄인다’는 기준 하나로 진화시켰더니, 도착한 곳은 조직 인프라의 문법이었다. 그 과정의 기록.
Anthropic Claude Code 팀 Thariq이 Fable 5로 일하며 재발견한 오래된 교훈. 이제 작업의 병목은 모델이 아니라 내가 unknown을 얼마나 명확히 하는가로 옮겨갔다.
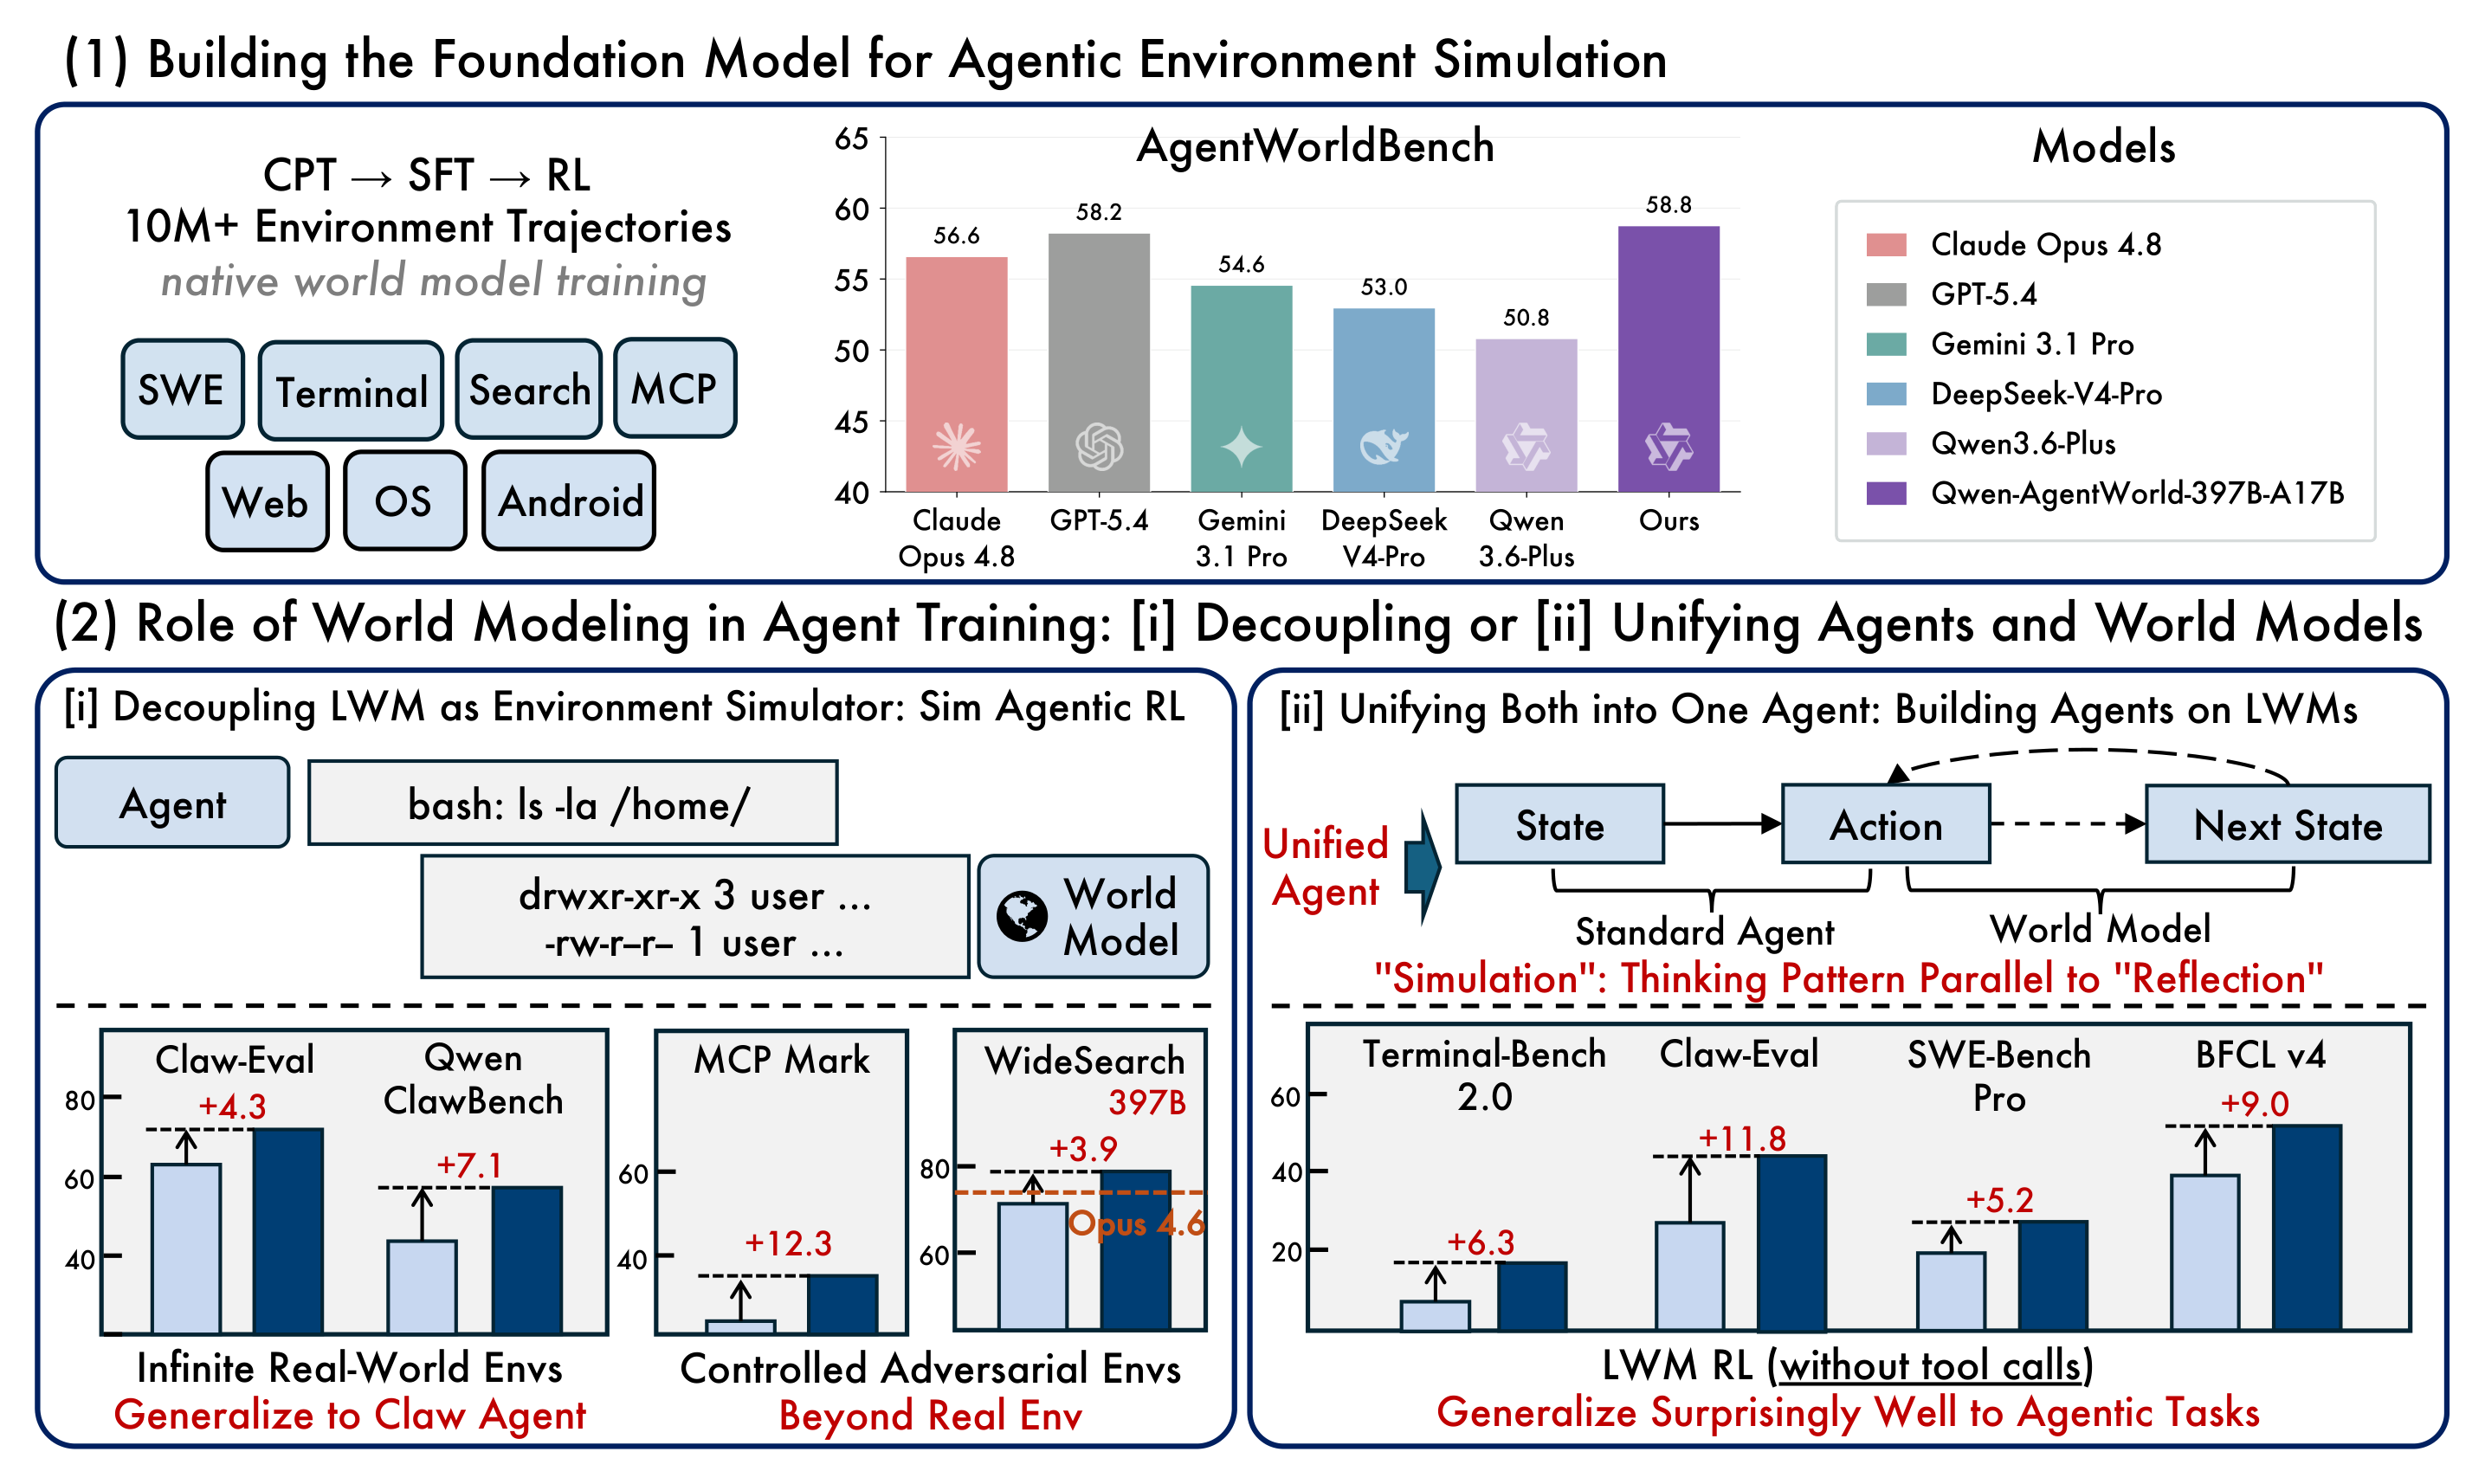
Qwen 팀이 일곱 가지 에이전트 환경(MCP·Search·Terminal·SWE·Web·OS·Android)을 하나의 모델로 시뮬레이션하는 언어 월드 모델 Qwen-AgentWorld를 공개했다. CPT→SFT→RL 3단계로 훈련했고, 397B-A17B 모델이 GPT-5.4·Claude Opus 4.8·Gemini 3.1 Pro를 넘는 AgentWorldBench 성능과 함께 시뮬레이션 RL이 실제 환경 학습을 능가하는 결과를 보였다.