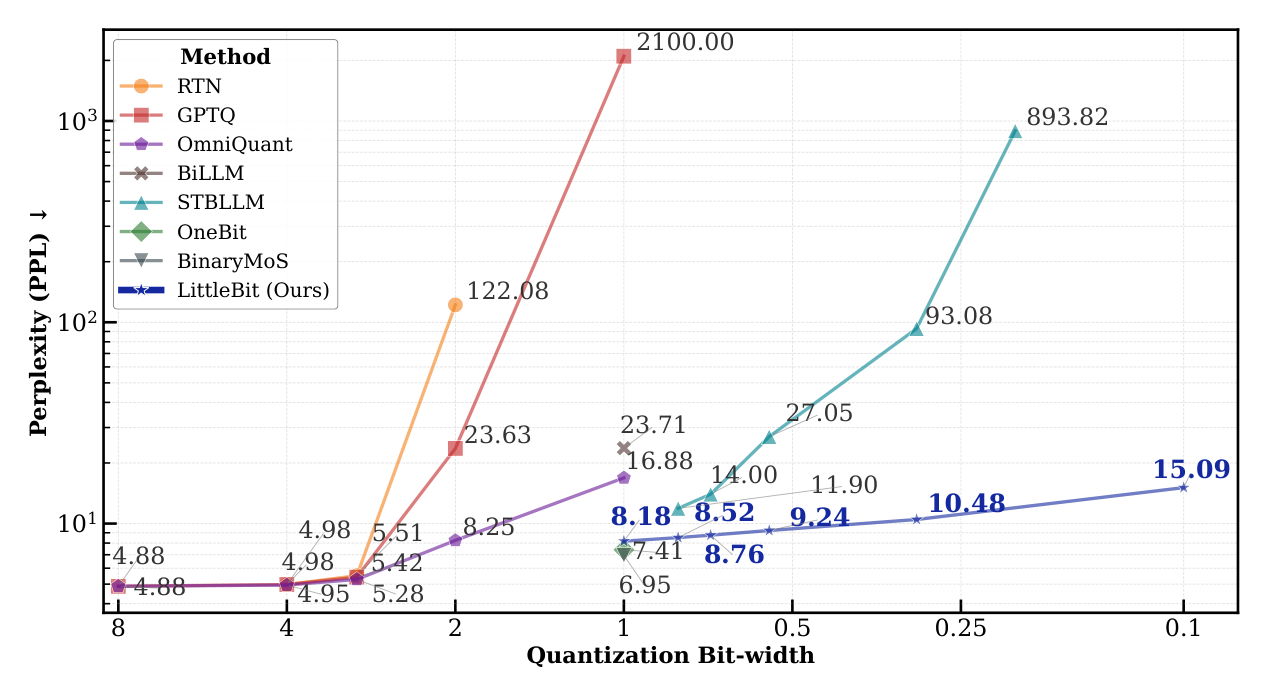
Llama2-13B의 WikiText-2 퍼플렉시티를 양자화 비트 수에 따라 비교한 로그 스케일 그래프. 가로축은 왼쪽 8비트에서 오른쪽 0.1비트까지다. RTN과 GPTQ는 2비트 부근에서, STBLLM은 0.5비트 미만에서 퍼플렉시티가 수백 이상으로 커진다. LittleBit은 1비트의 8.18에서 0.1비트의 15.09까지 완만하게 증가한다. 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0

LittleBit: Ultra Low-Bit Quantization via Latent Factorization

삼성리서치의 LittleBit은 LLM의 가중치 행렬을 랭크가 낮은 두 행렬의 곱으로 분해한 뒤 이진화하고, 행과 열과 잠재 차원의 스케일로 크기 정보를 보완해 가중치 하나당 평균 0.1비트까지 압축한다. 0.1비트로 압축한 Llama2-7B의 퍼플렉시티는 15.92로 기존 기법 STBLLM이 0.7비트에서 낸 결과보다 낮지만, 원본 모델과의 성능 차이는 여전히 크다.
October 12, 2026 · 14 분 · 서소영
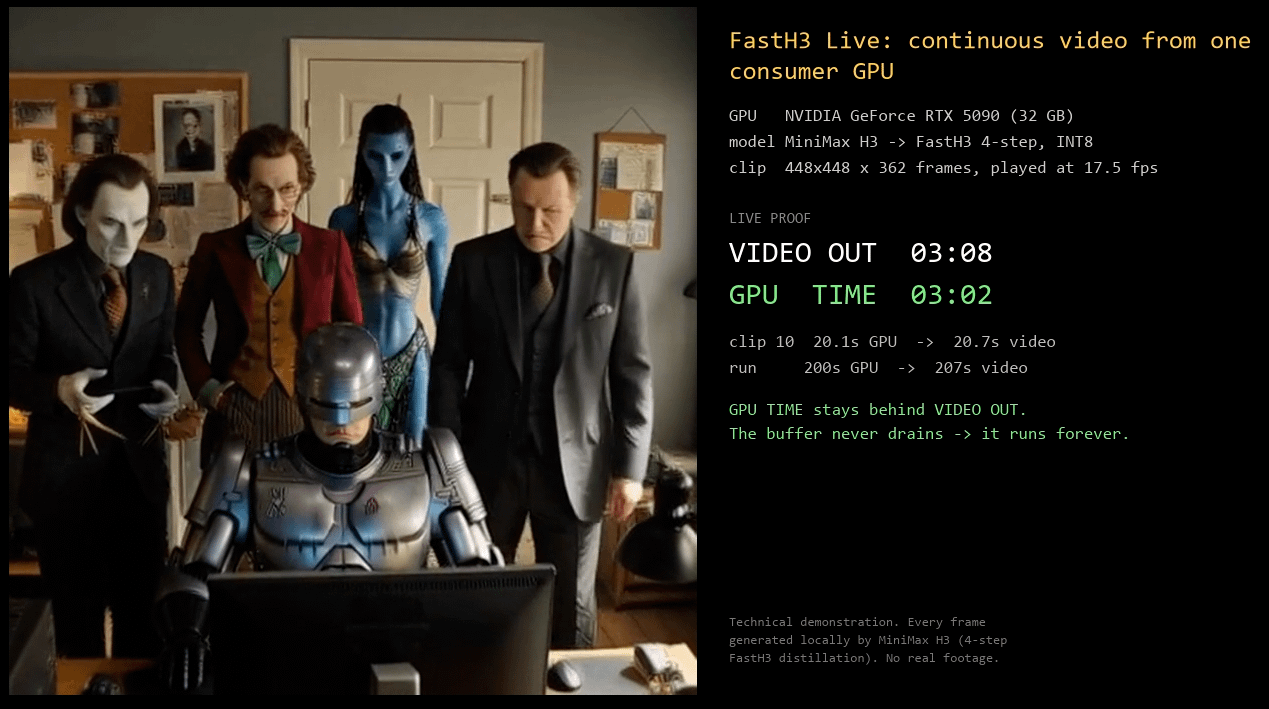
생성된 영상의 한 프레임과 계측 패널. 한 방에 모일 수 없는 다섯 인물이 컴퓨터 앞에 모여 있고, 오른쪽에는 누적 영상 길이 03:08과 누적 GPU 시간 03:02이 나란히 표시되어 있다

An endless AI TV channel on a single gaming GPU

게이밍 GPU 한 장으로 끊기지 않는 AI 영상 채널을 돌린 기록이다. 19.2초의 GPU 시간으로 20.1초 분량의 영상을 만들어 재생 버퍼가 마르지 않게 했고, 모델은 그대로 두고 ComfyUI의 노드별 실행 시간을 계측해 얻은 속도다.

September 5, 2026 · 11 분 · 서소영

kimi-k3-mlx — Kimi K3를 Apple Silicon으로 포팅하다

Moonshot의 2.78조 파라미터 멀티모달 MoE, Kimi K3를 Apple의 MLX 프레임워크로 옮긴 포트. 39개 테스트를 모두 통과하고 mxfp4 티어는 원본과 비트 단위로 일치하지만, 정작 이 모델은 지구상 어떤 맥에서도 한 토큰조차 만들어낸 적이 없다.

July 29, 2026 · 10 분 · 서소영
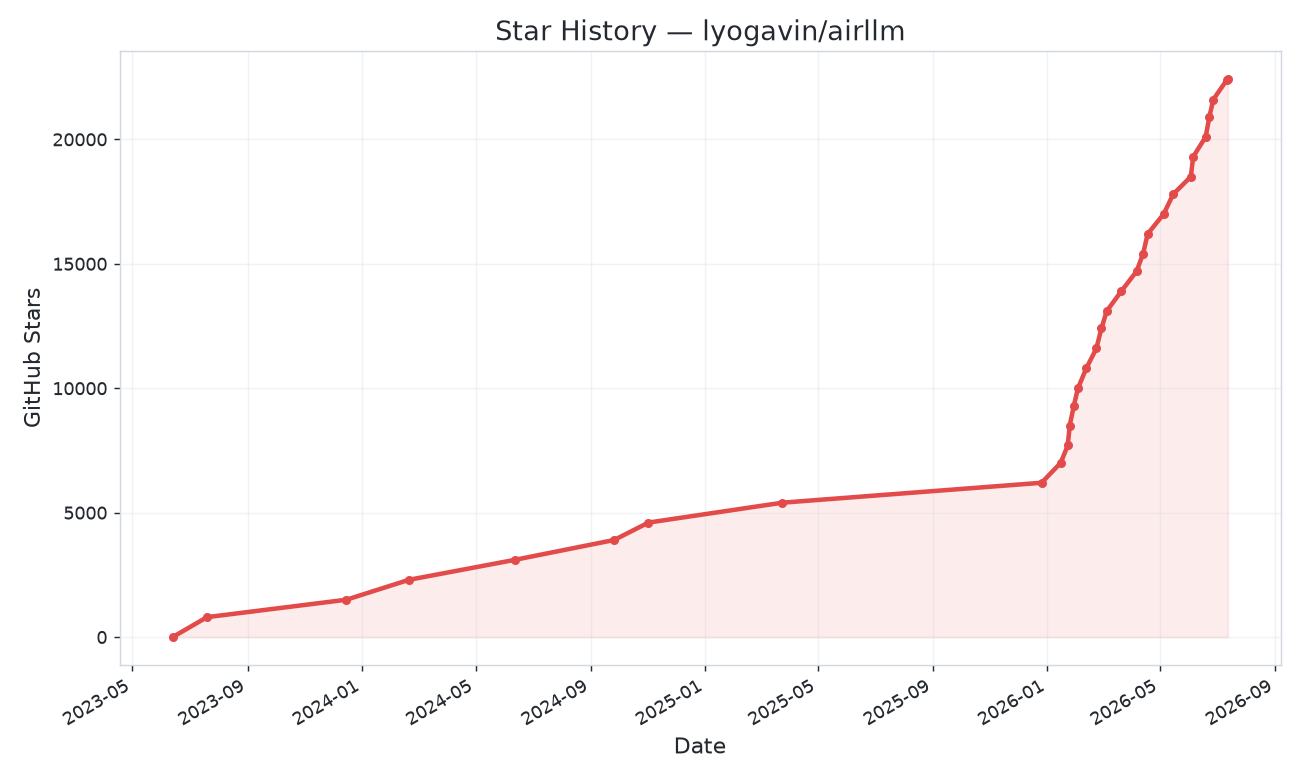
스타 히스토리

AirLLM: 4GB GPU로 70B 모델 돌리기

AirLLM은 트랜스포머 레이어를 한 장씩만 GPU에 올리는 방식으로 671B 모델을 12GB 카드에 얹는다. 필요 VRAM을 총 파라미터가 아니라 레이어 크기로 바꾸는 영리한 트릭이지만, 그 대가로 토큰마다 모델 전체를 디스크에서 다시 읽는다.

July 17, 2026 · 6 분 · 서소영
turbovec — Google's TurboQuant for vector search

turbovec — Google's TurboQuant for vector search

구글 리서치의 TurboQuant 양자화 알고리즘을 Rust로 구현한 벡터 인덱스. 학습 단계 없이 벡터를 16배로 압축하고, 손수 짠 SIMD 커널로 FAISS보다 빠르게 검색한다.

July 17, 2026 · 5 분 · 서소영