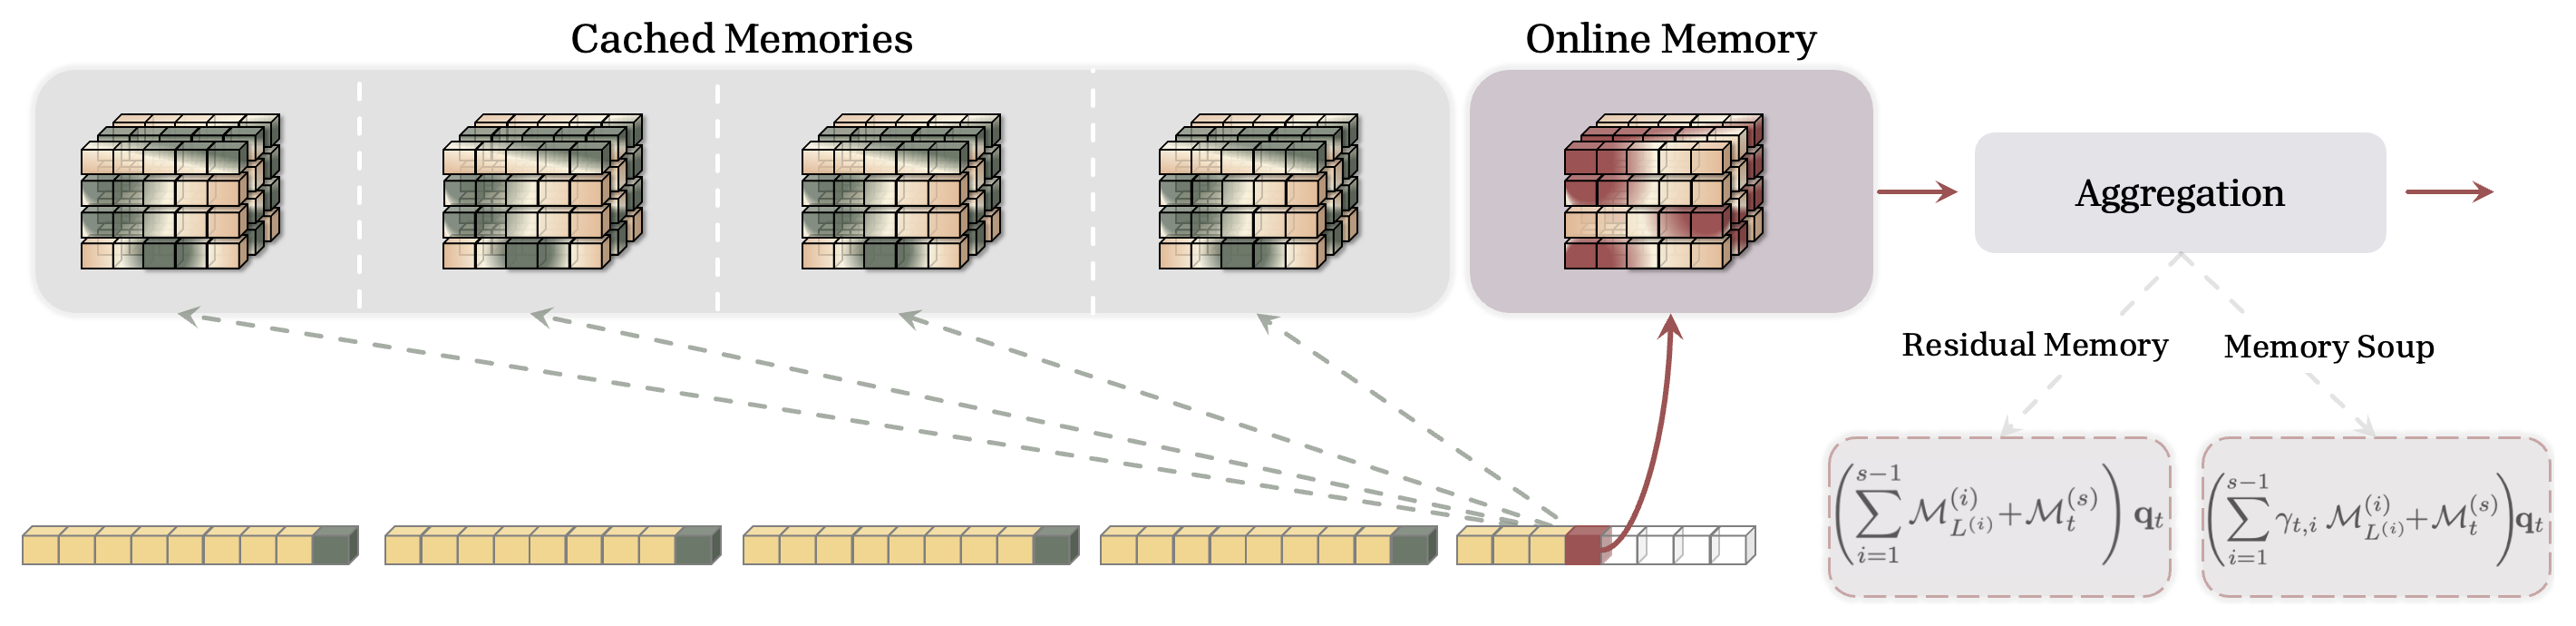
Memory Caching의 전체 구조를 나타낸 도식. 각 토큰이 현재 세그먼트의 온라인 메모리와 함께 과거 세그먼트들에서 캐싱된 메모리 체크포인트들을 동시에 참조해 출력을 계산한다.

Memory Caching: RNNs with Growing Memory

구글 리서치 연구진이 순환 신경망의 유효 메모리 용량을 시퀀스 길이에 맞춰 늘리는 Memory Caching(MC)을 제안했다. 시퀀스를 여러 세그먼트로 분할하고 세그먼트별 은닉 상태 체크포인트를 캐싱하는 방식으로, 선형 복잡도인 RNN과 이차 복잡도인 트랜스포머 사이를 보간하며 언어 모델링과 장문 인출 과제에서 SWLA, DLA, Titans의 성적을 전반적으로 높였다.
October 21, 2026 · 21 분 · 서소영
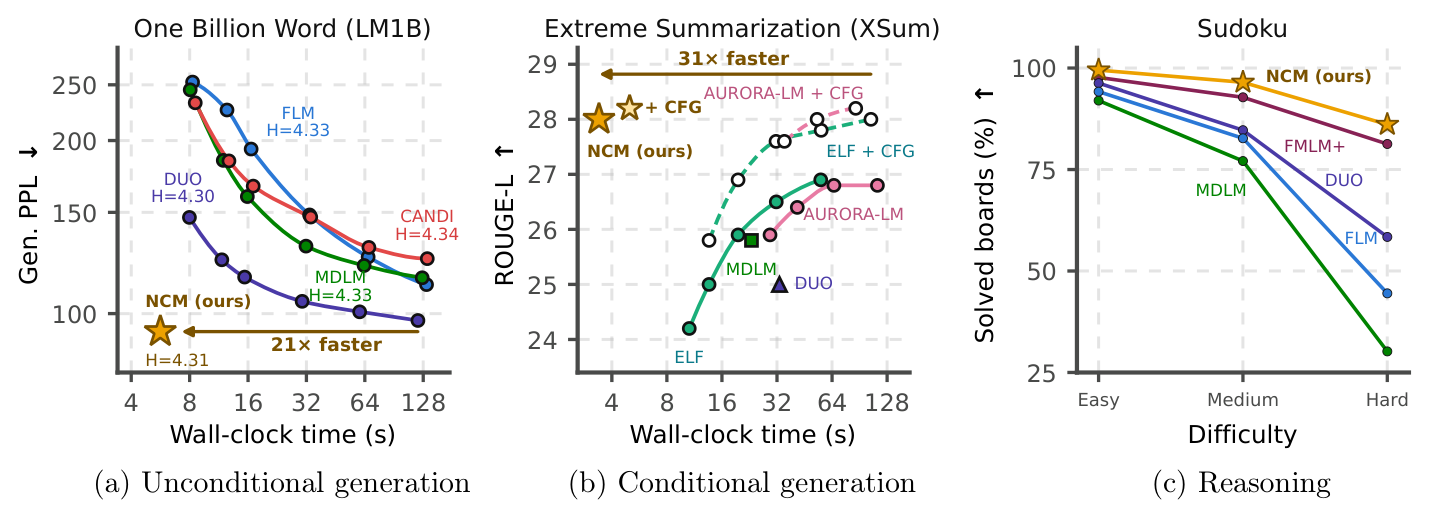
LM1B 무조건부 생성, XSum 요약, 스도쿠 추론에서 Next-Concept Modeling과 기존 확산 언어 모델들의 생성 속도 및 성능을 비교한 그래프

Next-Concept Modeling: Fast, Parallel Coarse-to-Fine Text Generation

스탠퍼드 대학교와 Together AI 연구진이 텍스트를 다중 스케일 이산 코드 계층으로 압축한 뒤 단계별로 병렬 생성하는 Next-Concept Modeling(NCM)을 제안했다. 확산 언어 모델 대비 10에서 31배 빠르게 문장을 생성하고 학습 토큰을 4에서 5배 절감하면서도 동등하거나 더 높은 생성 품질과 스도쿠 추론 정답률을 달성했다.

October 21, 2026 · 13 분 · 서소영
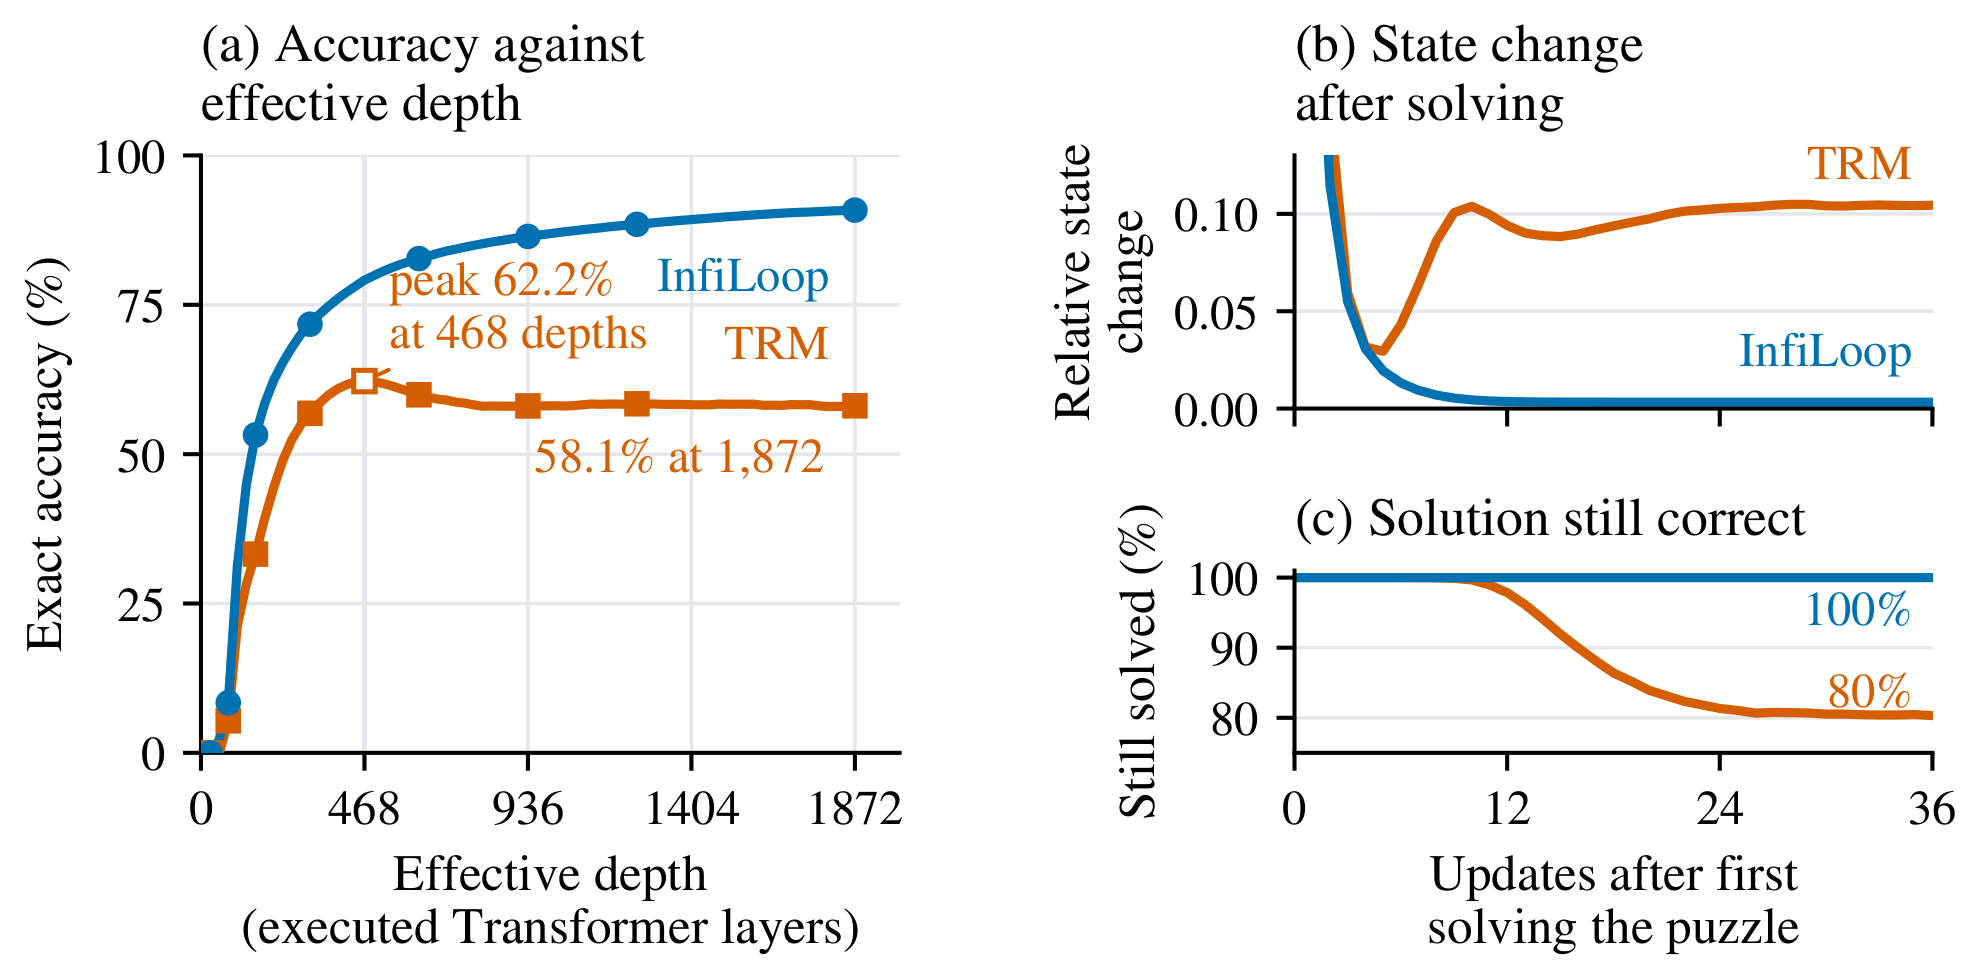
Sudoku-Extreme에서 실행 층 수에 따른 정확도와 풀이 완료 후 상태 변화를 비교한 그래프. 직전 상태만 넘기는 TRM은 468층에서 최고점 62.2%를 기록한 뒤 정확도가 떨어지고 이미 푼 퍼즐의 19.7%를 잃는 반면, InfiLoop는 1,872층에서 90.9%까지 오르며 푼 퍼즐을 모두 유지한다.

Scaling to Tens of Thousands of Test-Time Iterations with Loop-Native Attention Residuals

루프 트랜스포머는 직전 반복의 출력만 다음 반복으로 넘기기 때문에, 반복 횟수가 늘면 이후의 갱신이 이미 맞힌 답을 덮어쓰는 잠재 과잉사고가 발생한다. InfiLoop는 반복마다 내용 점수와 지수 감쇠로 과거 상태를 가중 합산한다. 토큰당 벡터 하나와 스칼라 하나만 유지하는 점화식이라 메모리 사용량이 반복 횟수와 상관없이 일정하다. 700만 파라미터 모델로 Sudoku-Extreme 97.9%, ARC-AGI-2 13.6%를 기록했고, 실행 층 수를 2만 4,960층까지 늘려도 성능이 계속 올랐다.

October 20, 2026 · 12 분 · 서소영
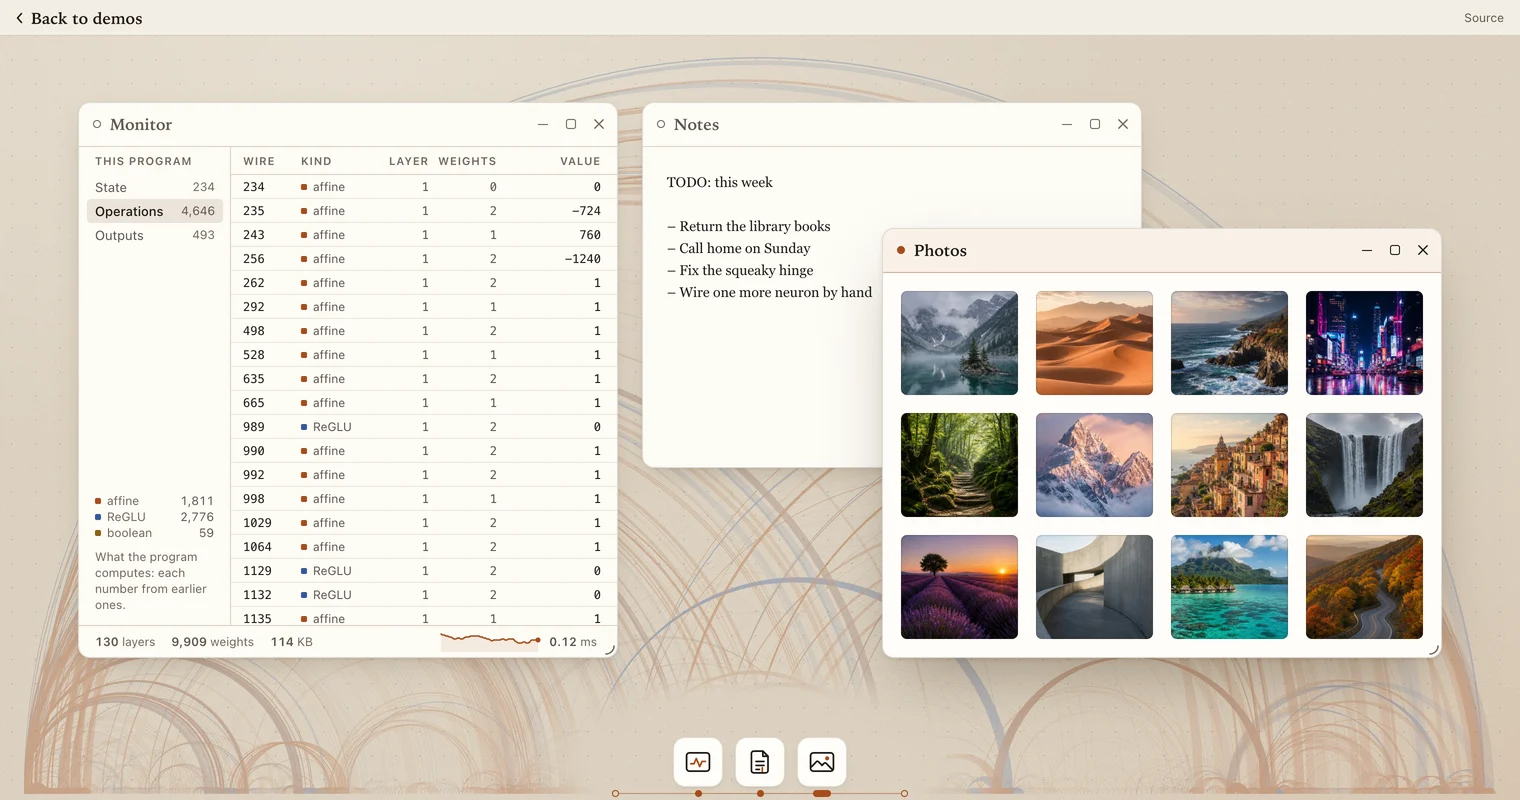
HandwiredOS 데스크톱 데모 화면. 왼쪽 Monitor 창에 프로그램의 상태 셀 234개, 연산 4,646개, 출력 493개, 그리고 층 수와 가중치 수가 표시되고 오른쪽에 Notes 창과 Photos 창이 열려 있다.

Handwired: Turn your regular JavaScript code into a neural net

Cheng Lou의 프로젝트 Handwired는 일반 자바스크립트와 타입스크립트로 작성한 빌더 코드를 32비트 부동소수점 연산 네 가지만으로 이루어진 신경망 회로로 컴파일한다. 이 회로는 학습 없이도 원래 코드와 똑같이 실행되고, 역전파 학습과 WebGPU 비트 패킹 실행까지 지원한다.

October 16, 2026 · 10 분 · 서소영
치비 서소영이 낮은 나무 탁자 앞에서 왼쪽의 엉킨 스파게티 같은 실타래를 한 가닥씩 풀어, 오른쪽에 한 방향 화살표로 차례로 이어진 작은 상자 여섯 개에 담고 있다.

90년대 설계 원칙 10개를 Claude Code의 규칙으로 만든 결과

Tomas Vykruta는 Opus가 전부 작성한 자기 앱에서 가격 문제 하나를 고치려고 닷새 동안 PR 49개를 만들고 토큰값으로 약 640달러를 썼지만 문제를 해결하지 못했다. 그는 설계 원칙 10개를 AGENTS.md의 강제 규칙으로 명시하고, 변경하기 전에 반드시 동작을 보존하는 리팩터링부터 하게 했다. 그 뒤 PR당 비용은 7달러에서 1달러로 줄었고 토큰 사용량은 9분의 1이 됐으며, 이후 만든 PR은 모두 첫 시도에 머지됐다고 한다.

October 1, 2026 · 14 분 · 서소영
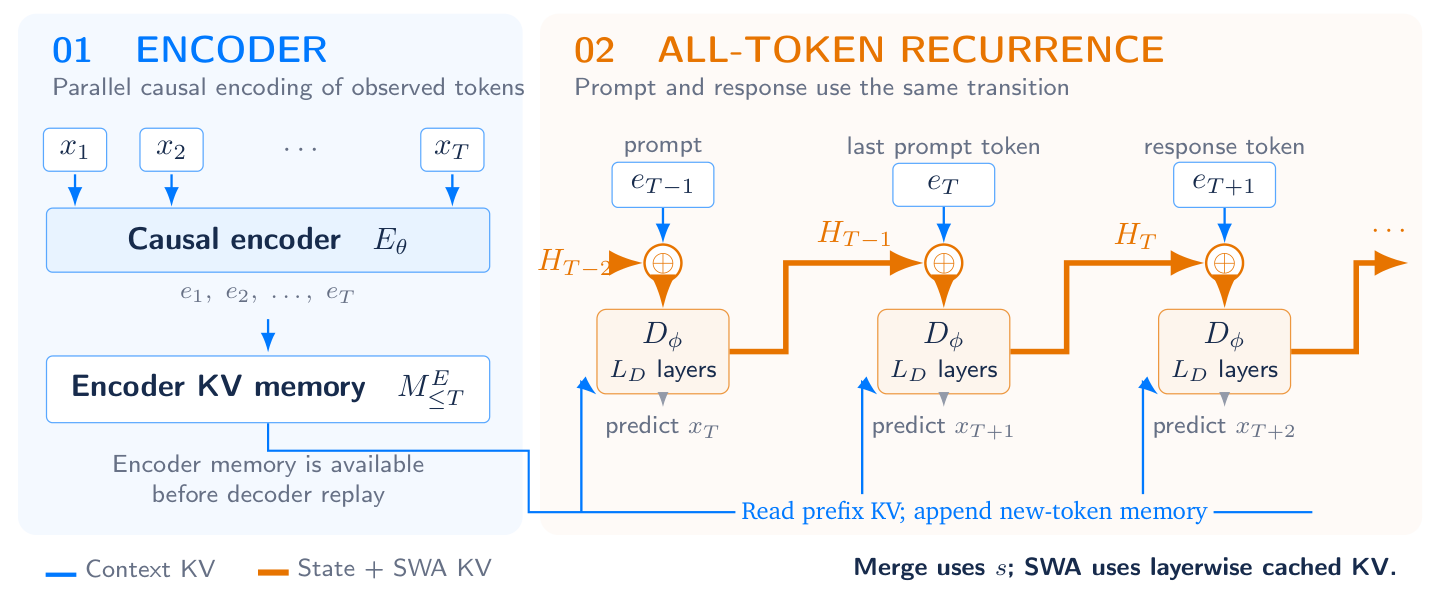
왼쪽에서 인과적 인코더가 관측 토큰을 병렬로 인코딩해 KV 메모리를 만들고, 오른쪽에서 재귀 디코더가 프롬프트 토큰과 응답 토큰을 같은 전이로 통과하는 구조 도식

Recurrent Looped Transformer

인과적 인코더가 전역 메모리를 만들고, 재귀 디코더가 프롬프트와 응답의 모든 토큰을 지나며 하나의 상태를 이어간다. 학습과 샘플링과 강화학습 리플레이가 같은 전이를 쓰도록 설계했고, 측정된 성능 수치는 아직 한 줄도 없다.

September 14, 2026 · 4 분 · 서소영
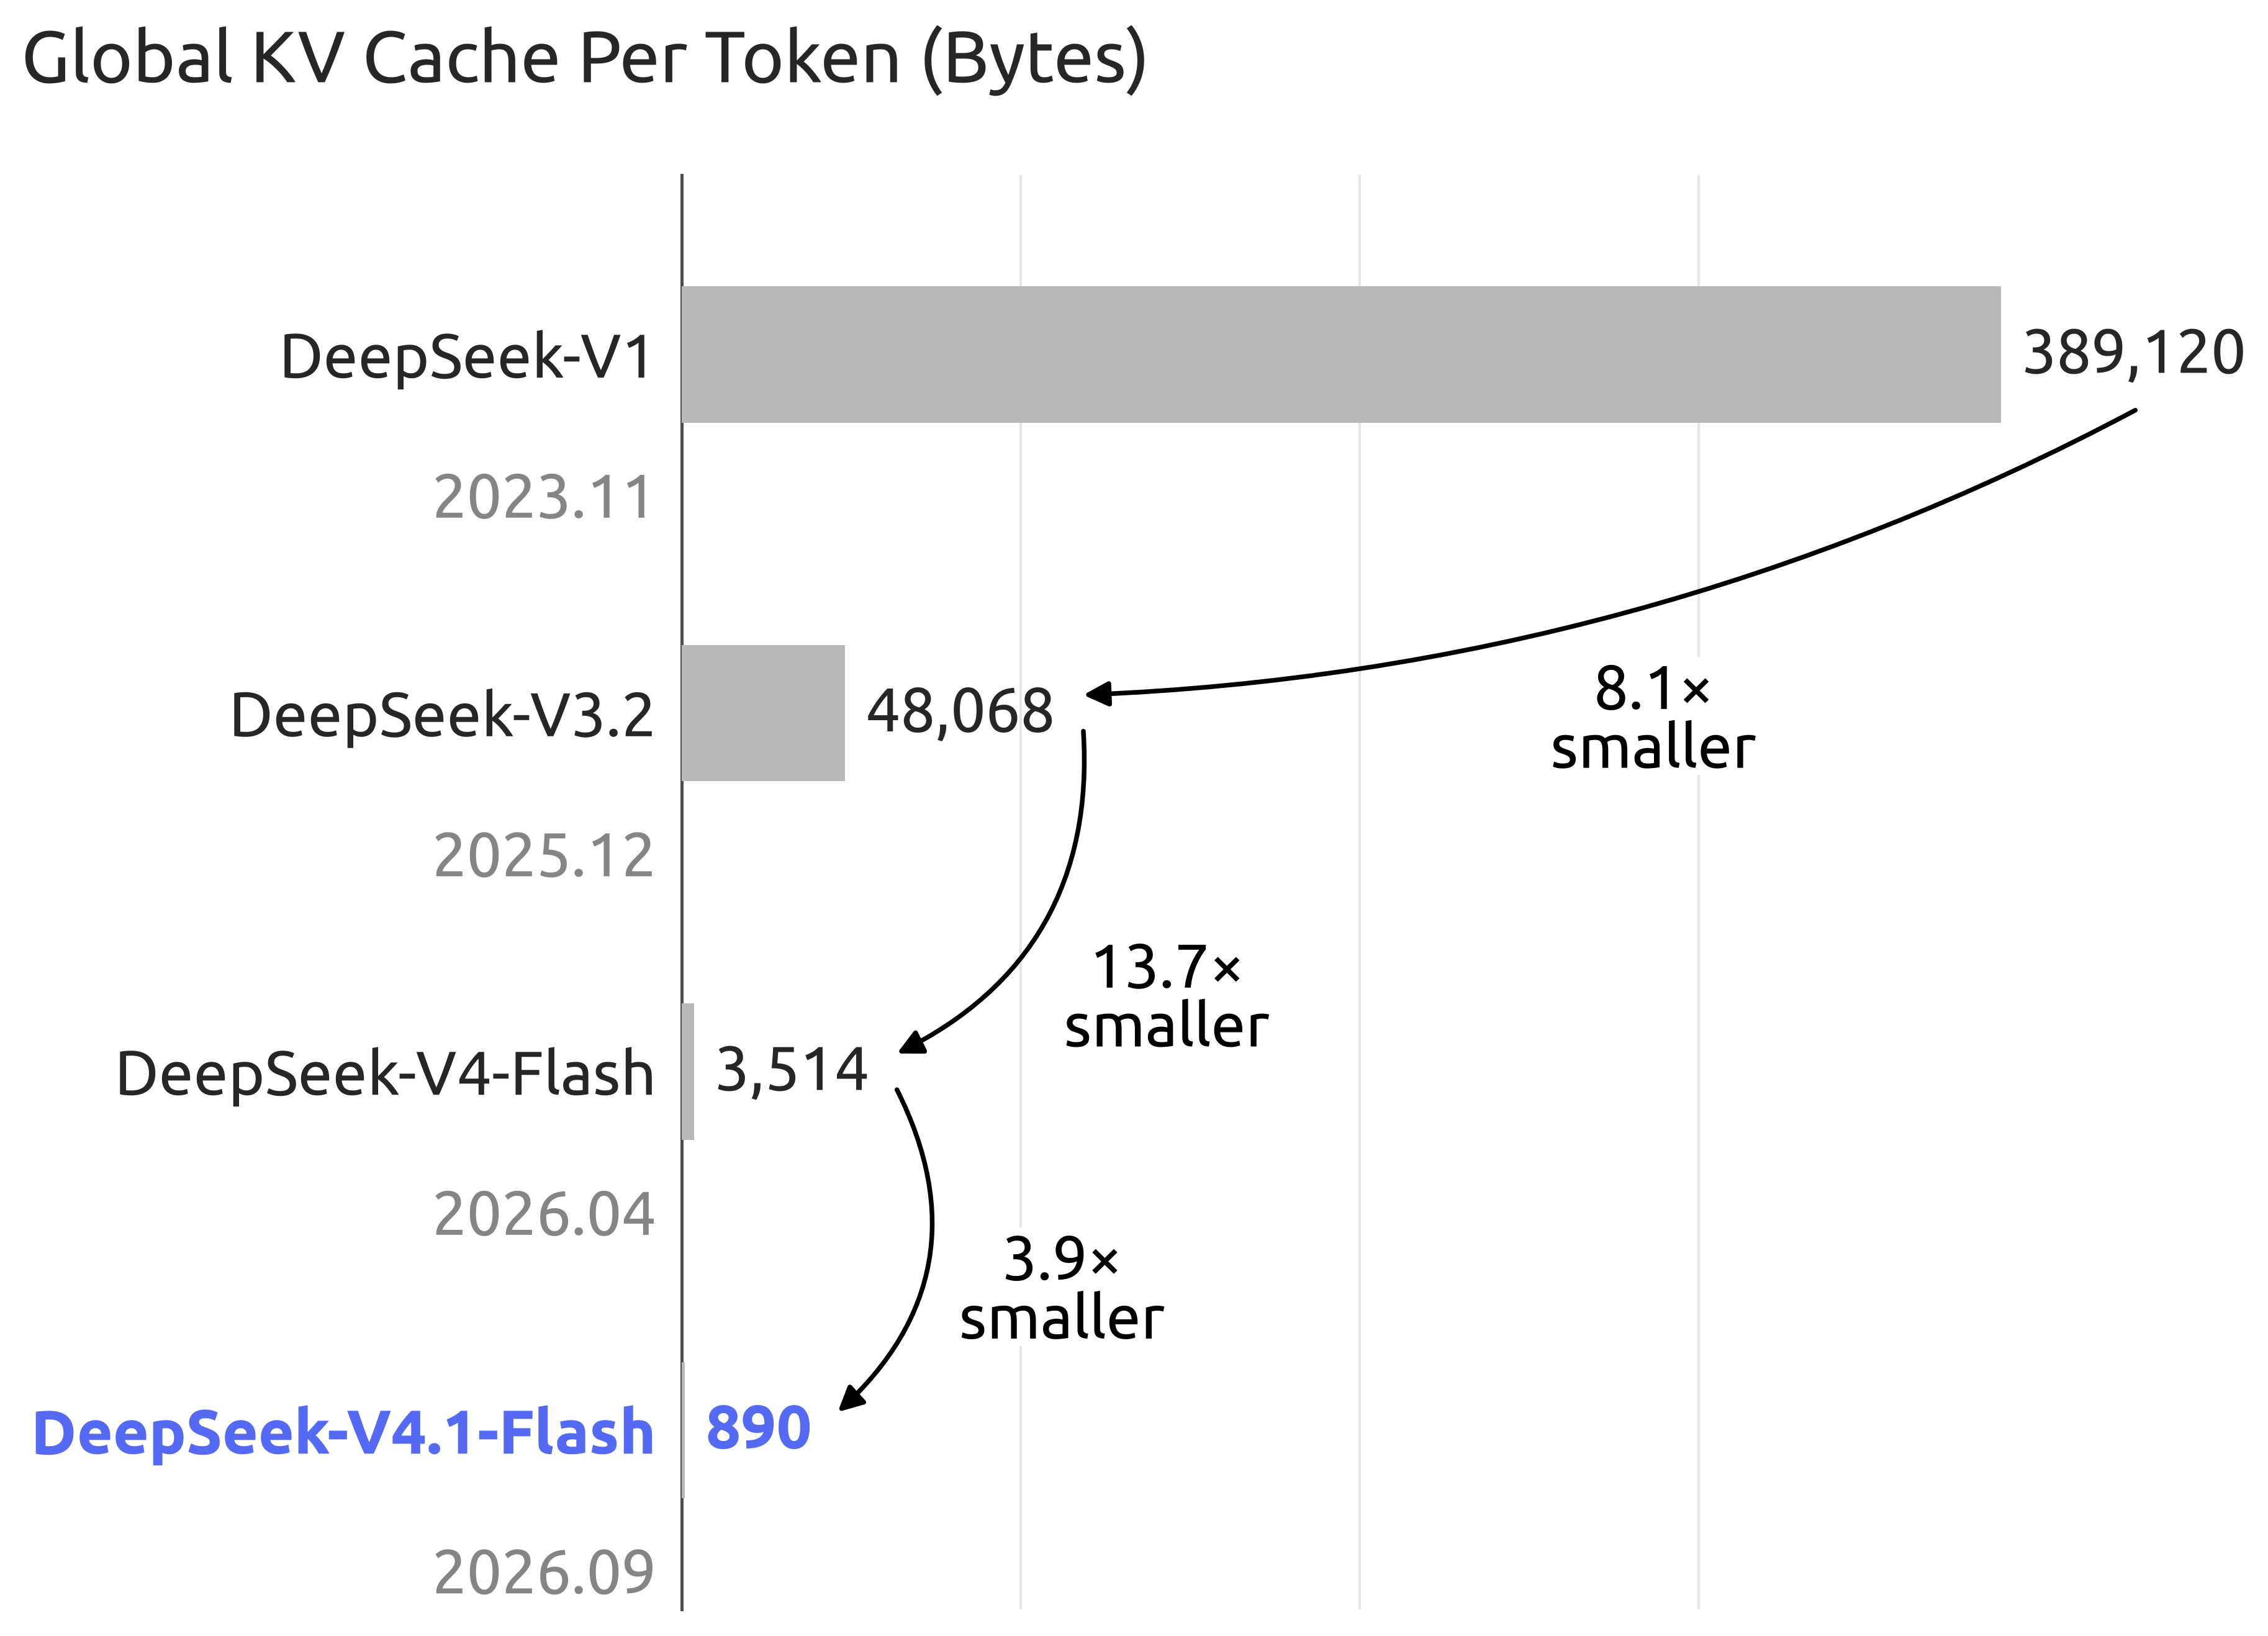
DeepSeek 세대별 토큰당 전역 KV 캐시 크기를 비교한 가로 막대 그래프. V1이 389,120바이트, V3.2가 48,068바이트, V4-Flash가 3,514바이트, V4.1-Flash가 890바이트이며 각 단계 사이에 8.1배, 13.7배, 3.9배 감소라는 화살표가 붙어 있다

DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression

DeepSeek이 9월 10일 공개한 V4.1-Flash는 40층 트랜스포머를 인코더 20층과 디코더 20층으로 갈라 놓고, 40층 가운데 4층만 전역 KV를 만들게 했다. 그 결과 토큰당 전역 KV 캐시가 890바이트로 내려갔고, 이는 V4-Flash의 4분의 1이다. 기술 보고서를 따라가며 설계가 왜 낯설게 보이는지, 캐시가 어떤 축에서 줄었는지 정리했다.

September 11, 2026 · 13 분 · 서소영
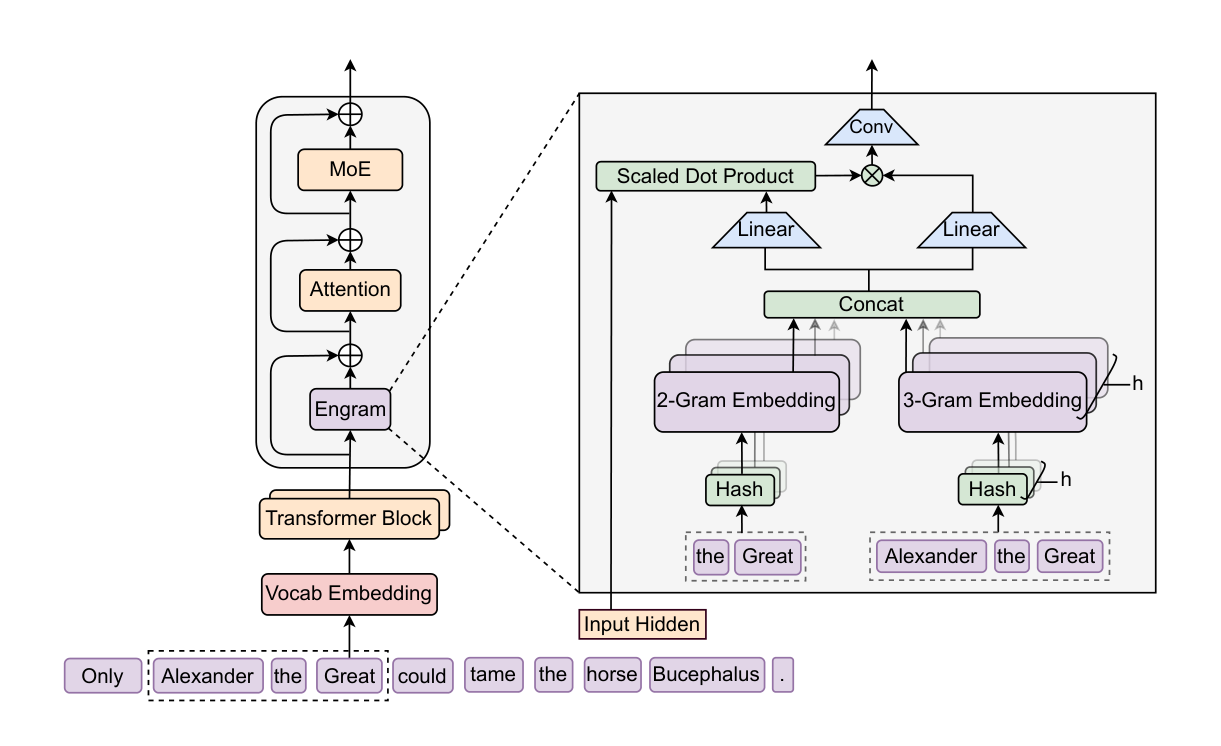
Engram 아키텍처 개요도. 왼쪽에 어휘 임베딩과 트랜스포머 블록이 쌓여 있고, 그중 한 블록 안에서 Engram 모듈이 어텐션과 MoE 앞에 놓인다. 오른쪽 확대도는 Alexander the Great라는 구절을 2그램과 3그램으로 잘라 해시한 뒤 임베딩 표에서 꺼내 이어 붙이고, 현재 은닉 상태와 내적해 게이트를 열어 합성곱을 통과시키는 흐름을 보여 준다

Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models

트랜스포머에는 지식을 찾아오는 전용 연산이 없어서, 고정된 사전 항목 하나를 꺼낼 때도 여러 층을 써서 계산으로 다시 만들어 낸다. DeepSeek과 베이징대 연구진은 그 자리에 N그램 임베딩 표를 되살려 넣고, MoE 전문가와 메모리 사이에 희소 용량을 어떻게 나눌지 재어 보았다.

September 10, 2026 · 12 분 · 서소영
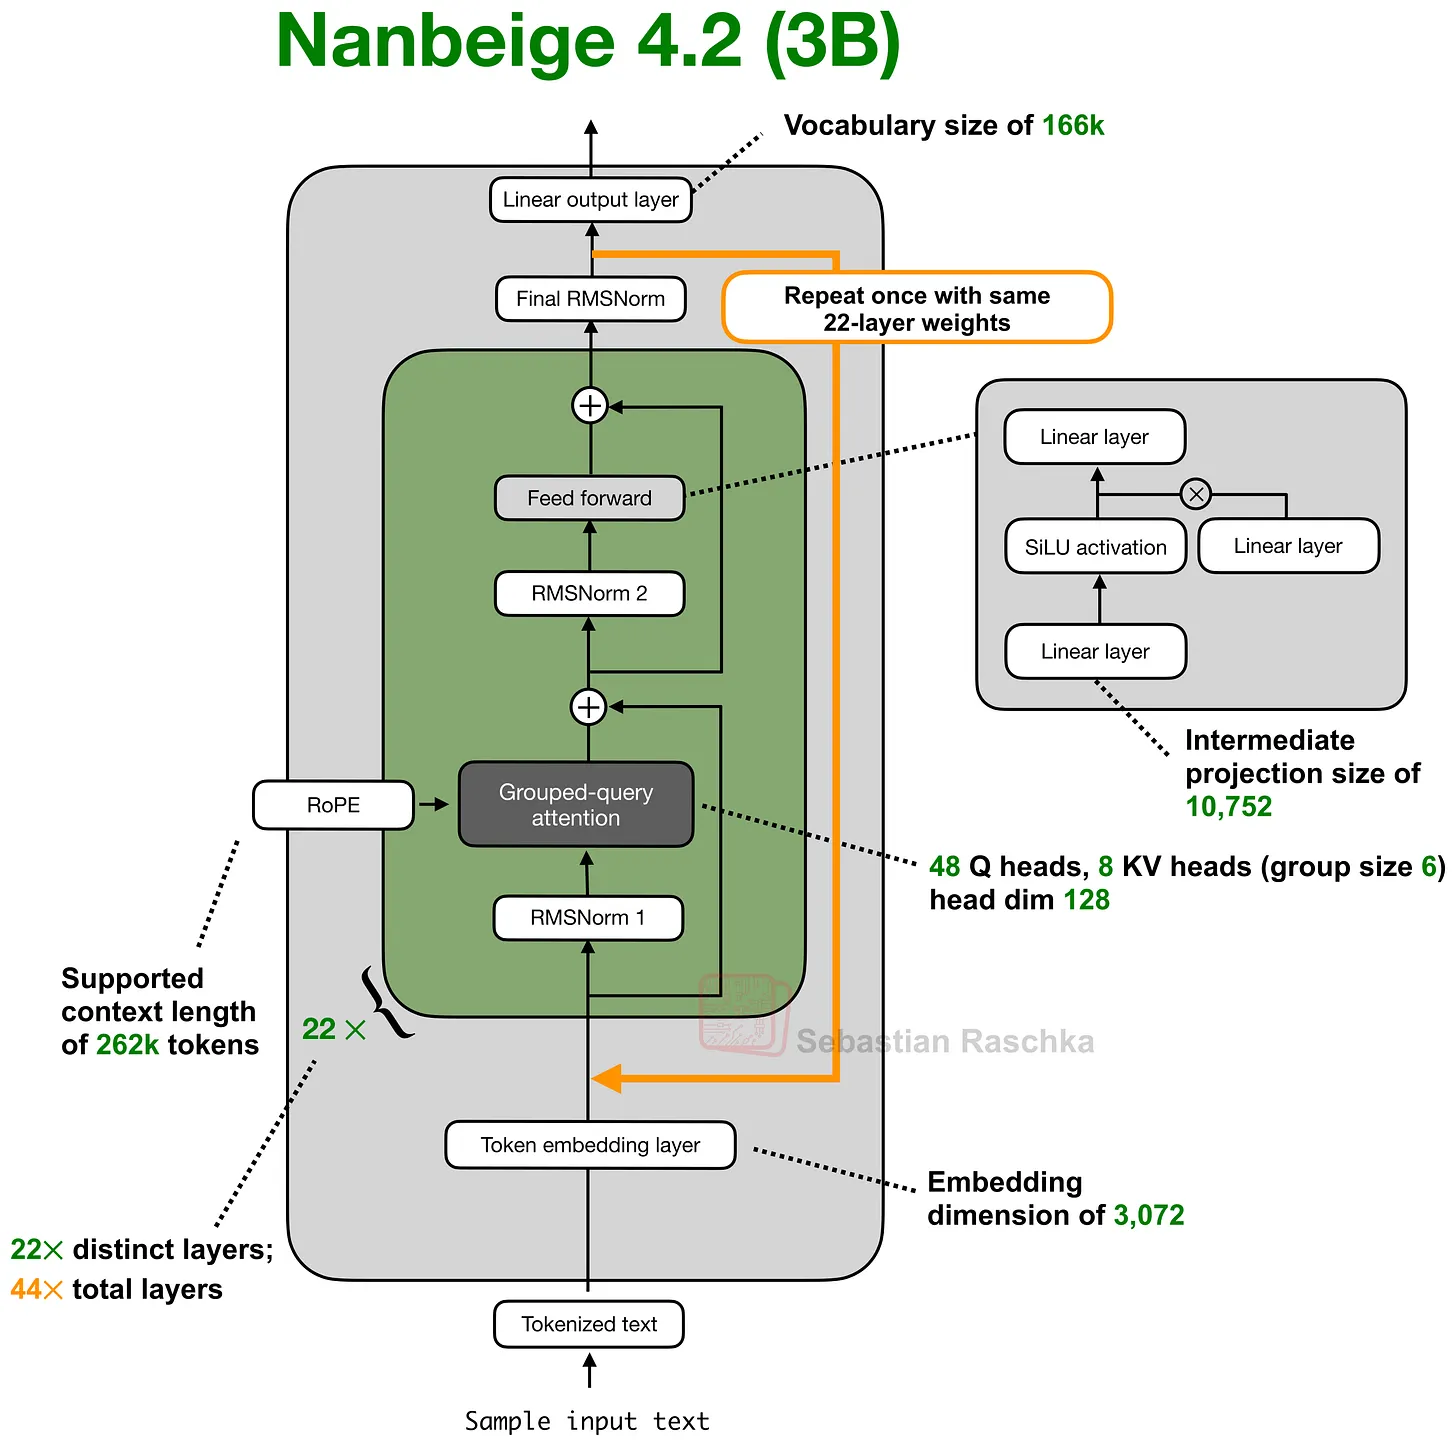
Nanbeige4.2-3B 아키텍처 도식. 22개 트랜스포머 블록 위에서 주황색 화살표가 스택 맨 아래로 되돌아간다

GPT-6 Astra, Looped Transformers, and Hidden Reasoning

The Information은 GPT-6 Astra가 루프 트랜스포머를 써서 추론 흔적을 가린다고 보도했다. Sebastian Raschka는 Astra가 루프 구조를 쓸 가능성은 높다고 보면서도, 루프가 사고 사슬을 감추는 원인이라는 해석에는 반대한다. 루프 트랜스포머가 무엇이고 무엇을 아끼며 무엇을 아끼지 못하는지를 논문 네 편과 함께 정리한 글이다.

September 10, 2026 · 15 분 · 서소영
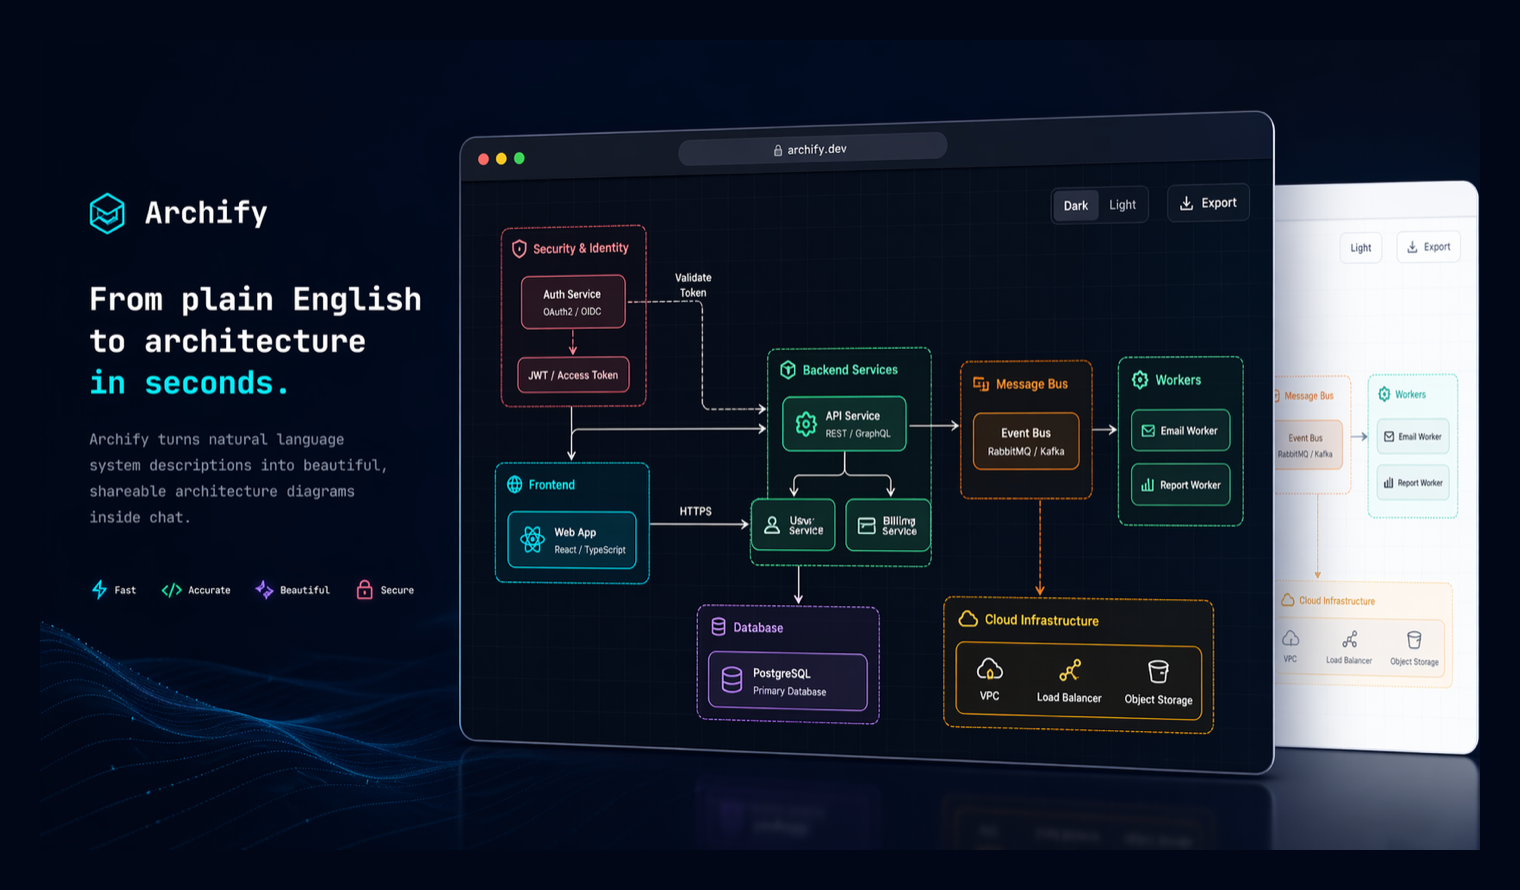
Archify 제품 프리뷰

Archify

코드베이스를 채팅 안에서 인터랙티브한 시스템 맵으로 바꾸는 에이전트 스킬. 에이전트는 그림 대신 타입이 정해진 JSON을 쓰고, Archify가 검증을 모두 통과한 결과만 HTML 한 파일로 내놓는다.

August 29, 2026 · 6 분 · 서소영