SpikingBrain: Spiking Brain-inspired Large Models
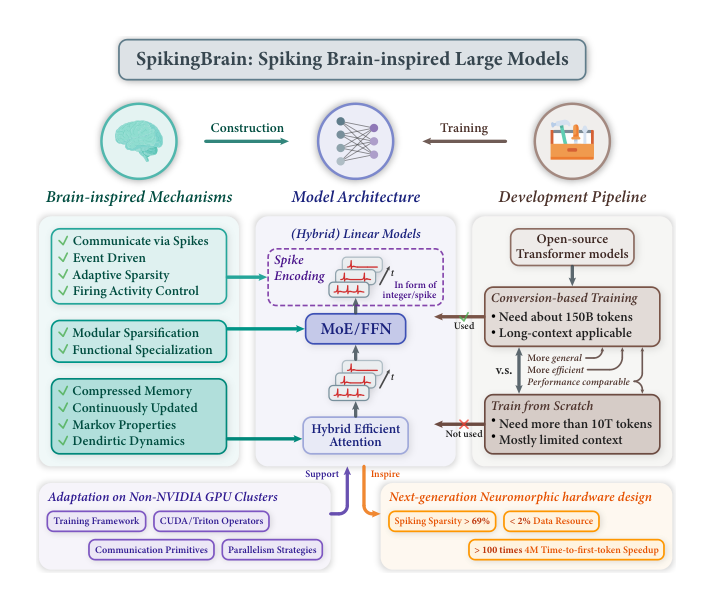
중국과학원 자동화연구소와 MetaX 연구진이 Qwen2.5-7B의 어텐션을 선형 어텐션과 슬라이딩 윈도 어텐션으로 바꾸고 활성값을 정수 스파이크로 부호화한 모델 두 종을 만들어, 엔비디아가 아닌 MetaX GPU 수백 장에서 학습했다. 연속 사전학습 약 1,500억(150B) 토큰으로 7B 모델은 베이스 모델 성능의 약 90%를 회복했고, 400만(4M) 토큰을 입력하면 첫 토큰이 100배 이상 빨리 나온다고 추정했다.