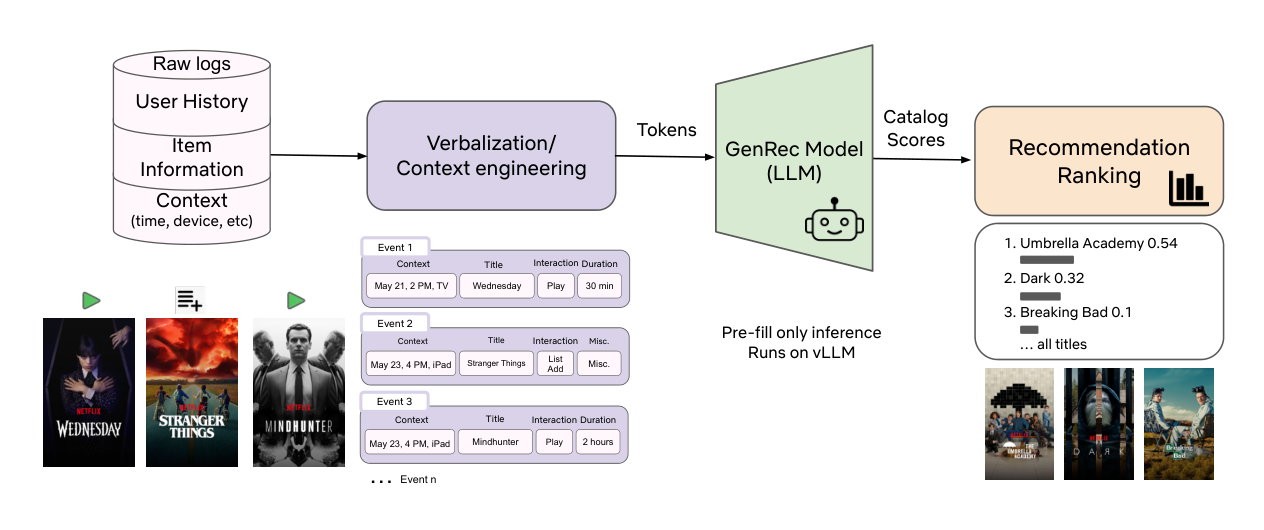
GenRec: An LLM-Backed Recommendation Ranker at Netflix
넷플릭스가 수천 개의 수작업 피처에 기반한 추천 랭커를 대체할 후보로 LLM 기반 랭커 GenRec을 만들고, 기존 랭커와 비교한 결과를 공개했다. GenRec은 시청 이력을 텍스트로 서술해 프리필 한 번으로 카탈로그 전체의 점수를 계산하며, 사후 학습 라벨을 40분의 1만 쓰고도 대규모 A/B 테스트에서 통계적으로 유의한 개선을 얻었다.
넷플릭스가 수천 개의 수작업 피처에 기반한 추천 랭커를 대체할 후보로 LLM 기반 랭커 GenRec을 만들고, 기존 랭커와 비교한 결과를 공개했다. GenRec은 시청 이력을 텍스트로 서술해 프리필 한 번으로 카탈로그 전체의 점수를 계산하며, 사후 학습 라벨을 40분의 1만 쓰고도 대규모 A/B 테스트에서 통계적으로 유의한 개선을 얻었다.
스탠퍼드대와 텔아비브대 등의 연구진이 자연 데이터를 경사 갱신에 한 번도 쓰지 않고 언어 모델을 사전학습하는 셀프 플레이 방법을 제안했다. 생성자 모델은 만능 튜링 기계용 프로그램을 짜고, 학습자 모델은 그 출력 바이트를 예측한다. 이렇게 학습한 모델의 텍스트, 이미지, 음악 제로샷 손실은 연산량이 늘수록 거듭제곱 법칙에 따라 줄었다.
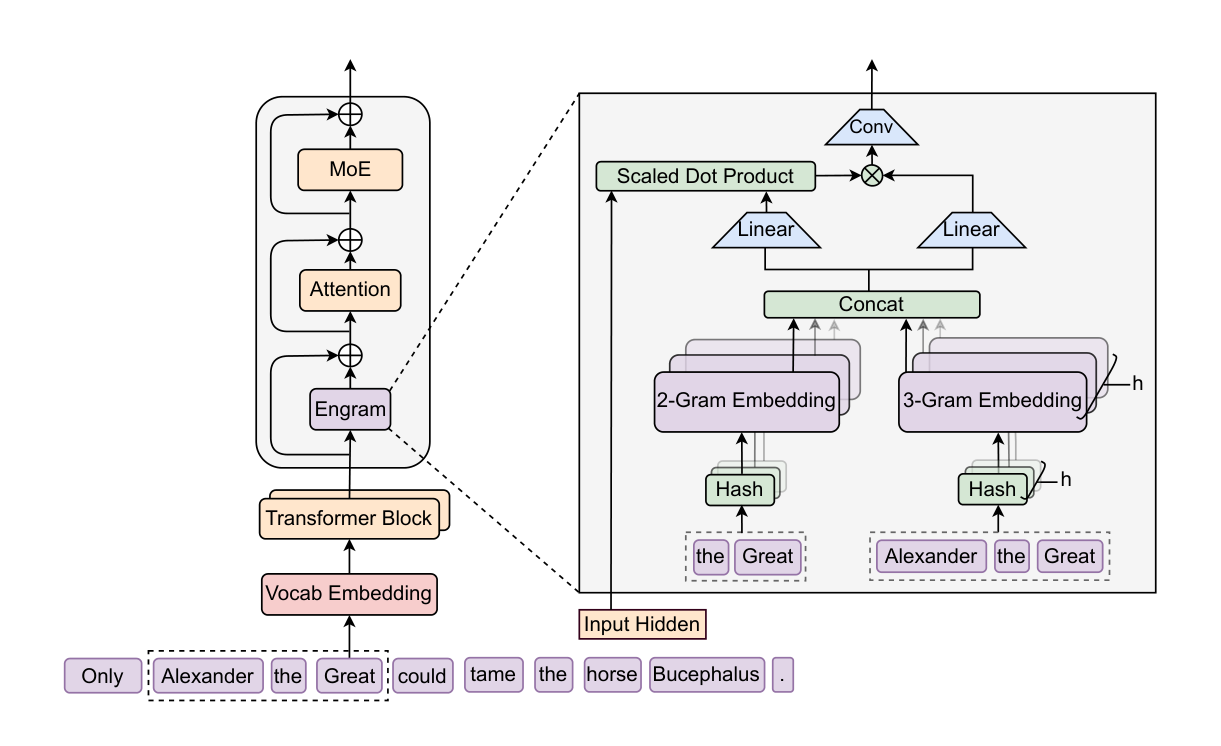
트랜스포머에는 지식을 찾아오는 전용 연산이 없어서, 고정된 사전 항목 하나를 꺼낼 때도 여러 층을 써서 계산으로 다시 만들어 낸다. DeepSeek과 베이징대 연구진은 그 자리에 N그램 임베딩 표를 되살려 넣고, MoE 전문가와 메모리 사이에 희소 용량을 어떻게 나눌지 재어 보았다.
상하이 AI 연구소 InternAgent 팀이 공개한 롱 호라이즌 에이전트 모델 Agents-A1의 4B dense 버전. ‘파라미터가 아니라 호라이즌을 키운다’는 기조로, 장기 궤적과 이종 에이전트 능력을 함께 스케일링해 작은 모델로 큰 모델급 성능에 닿는다.
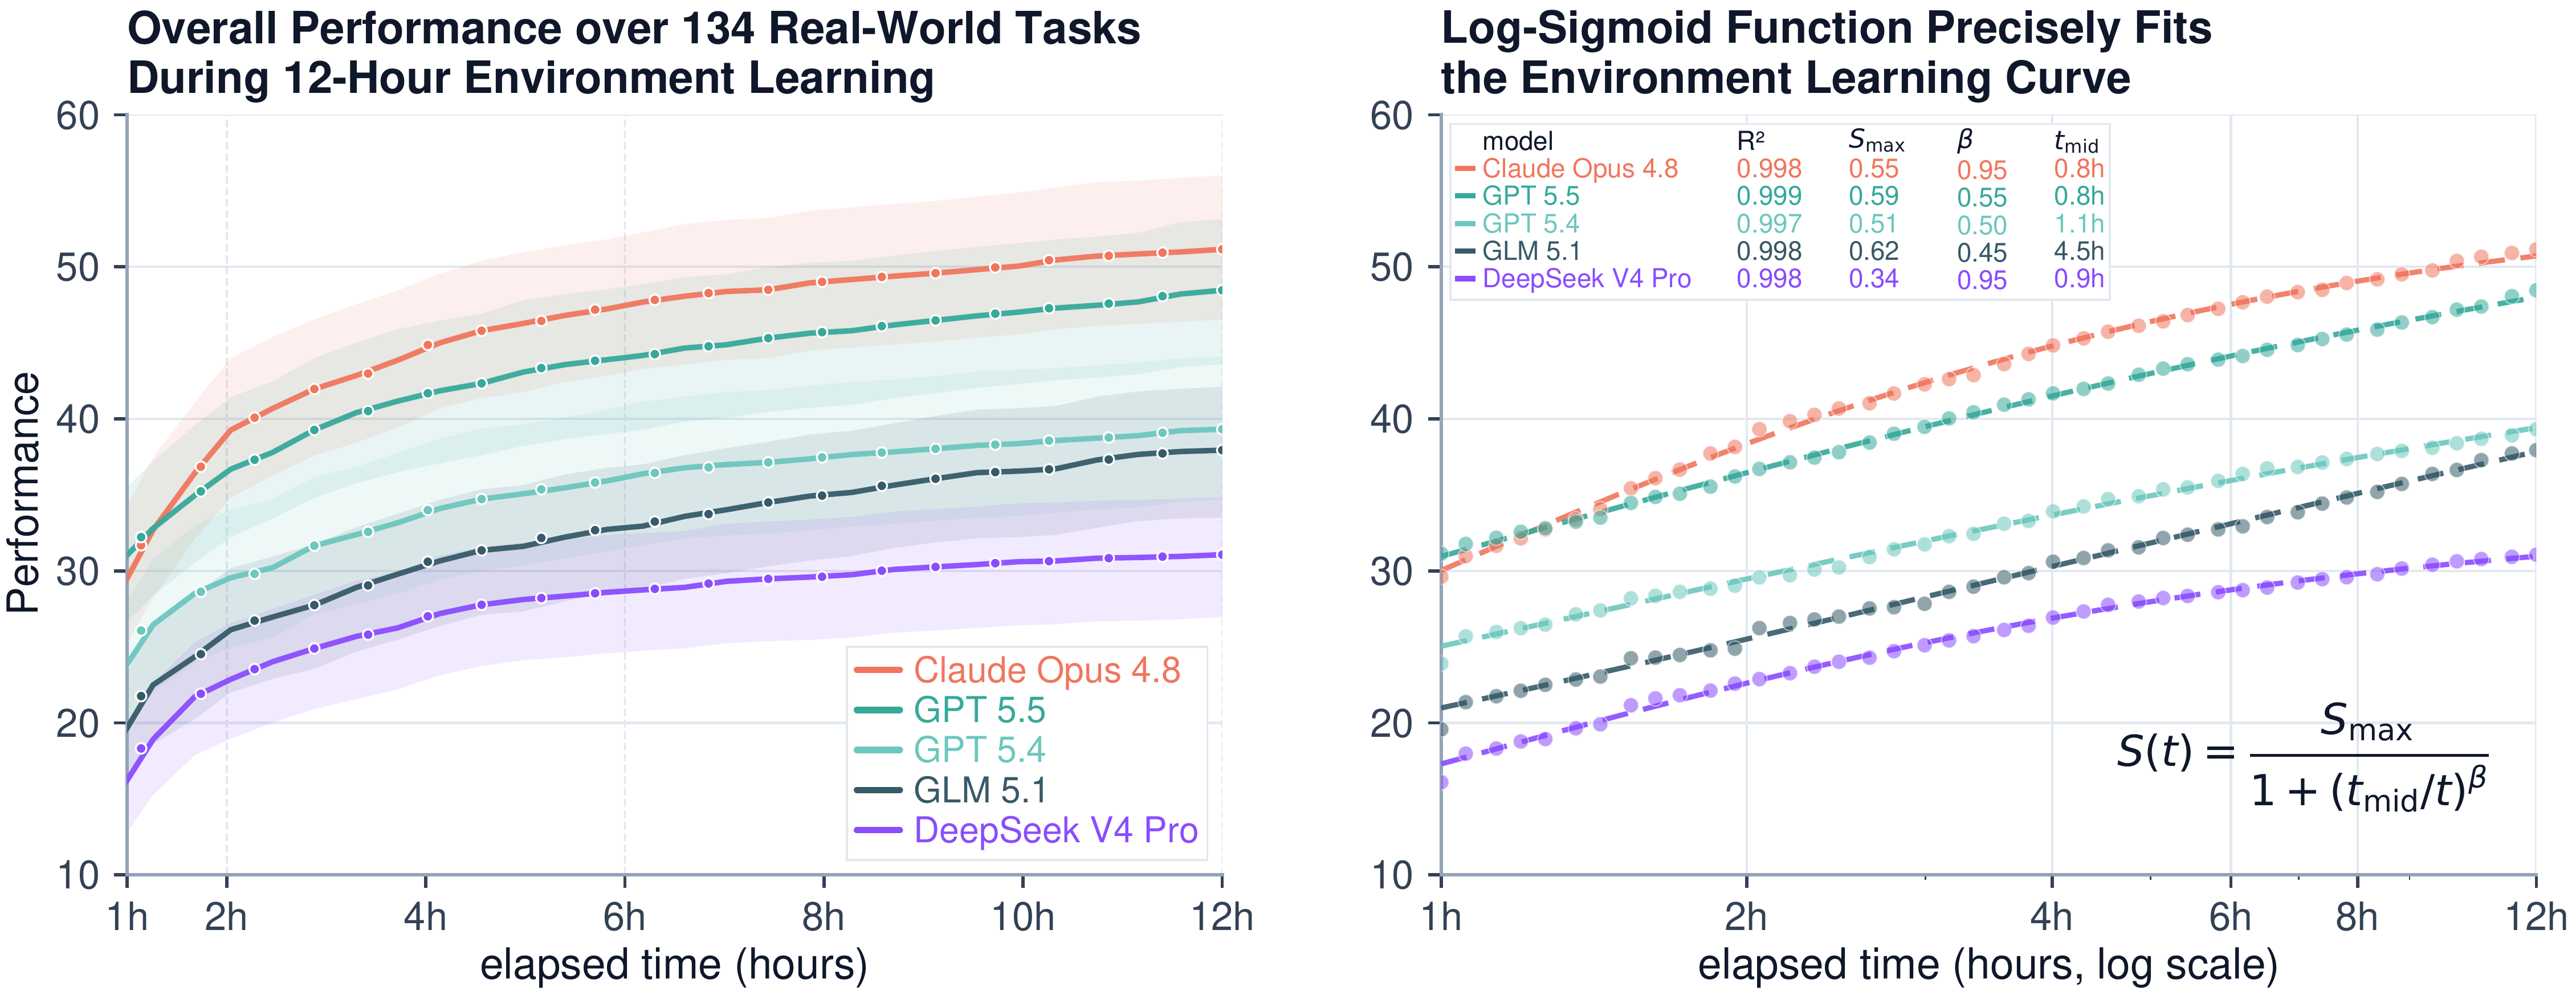
ByteDance Seed가 공개한 EdgeBench는 6개 능력군에 걸친 134개 실세계 태스크로 프론티어 에이전트의 12시간 이상 환경 학습을 측정한 벤치마크다. 약 38,000시간의 상호작용을 분석한 결과, 환경 학습 성능은 로그-시그모이드 스케일링 법칙(R²=0.998)을 따르고 학습 속도는 대략 3개월마다 두 배가 된다.
KB증권 이은택·김민규의 2026년 하반기 반기전략 리포트. 강세장 유지지만 종점 시그널을 미리 규정한다는 관점 — AI CapEx가 스스로 멈출 수 없는 국면, 자본공급자의 이탈이 실제 종점, 130년 3대 버블의 공통 후반부 패턴, 개인 수급이 만드는 주도주 생명연장을 다룬다.
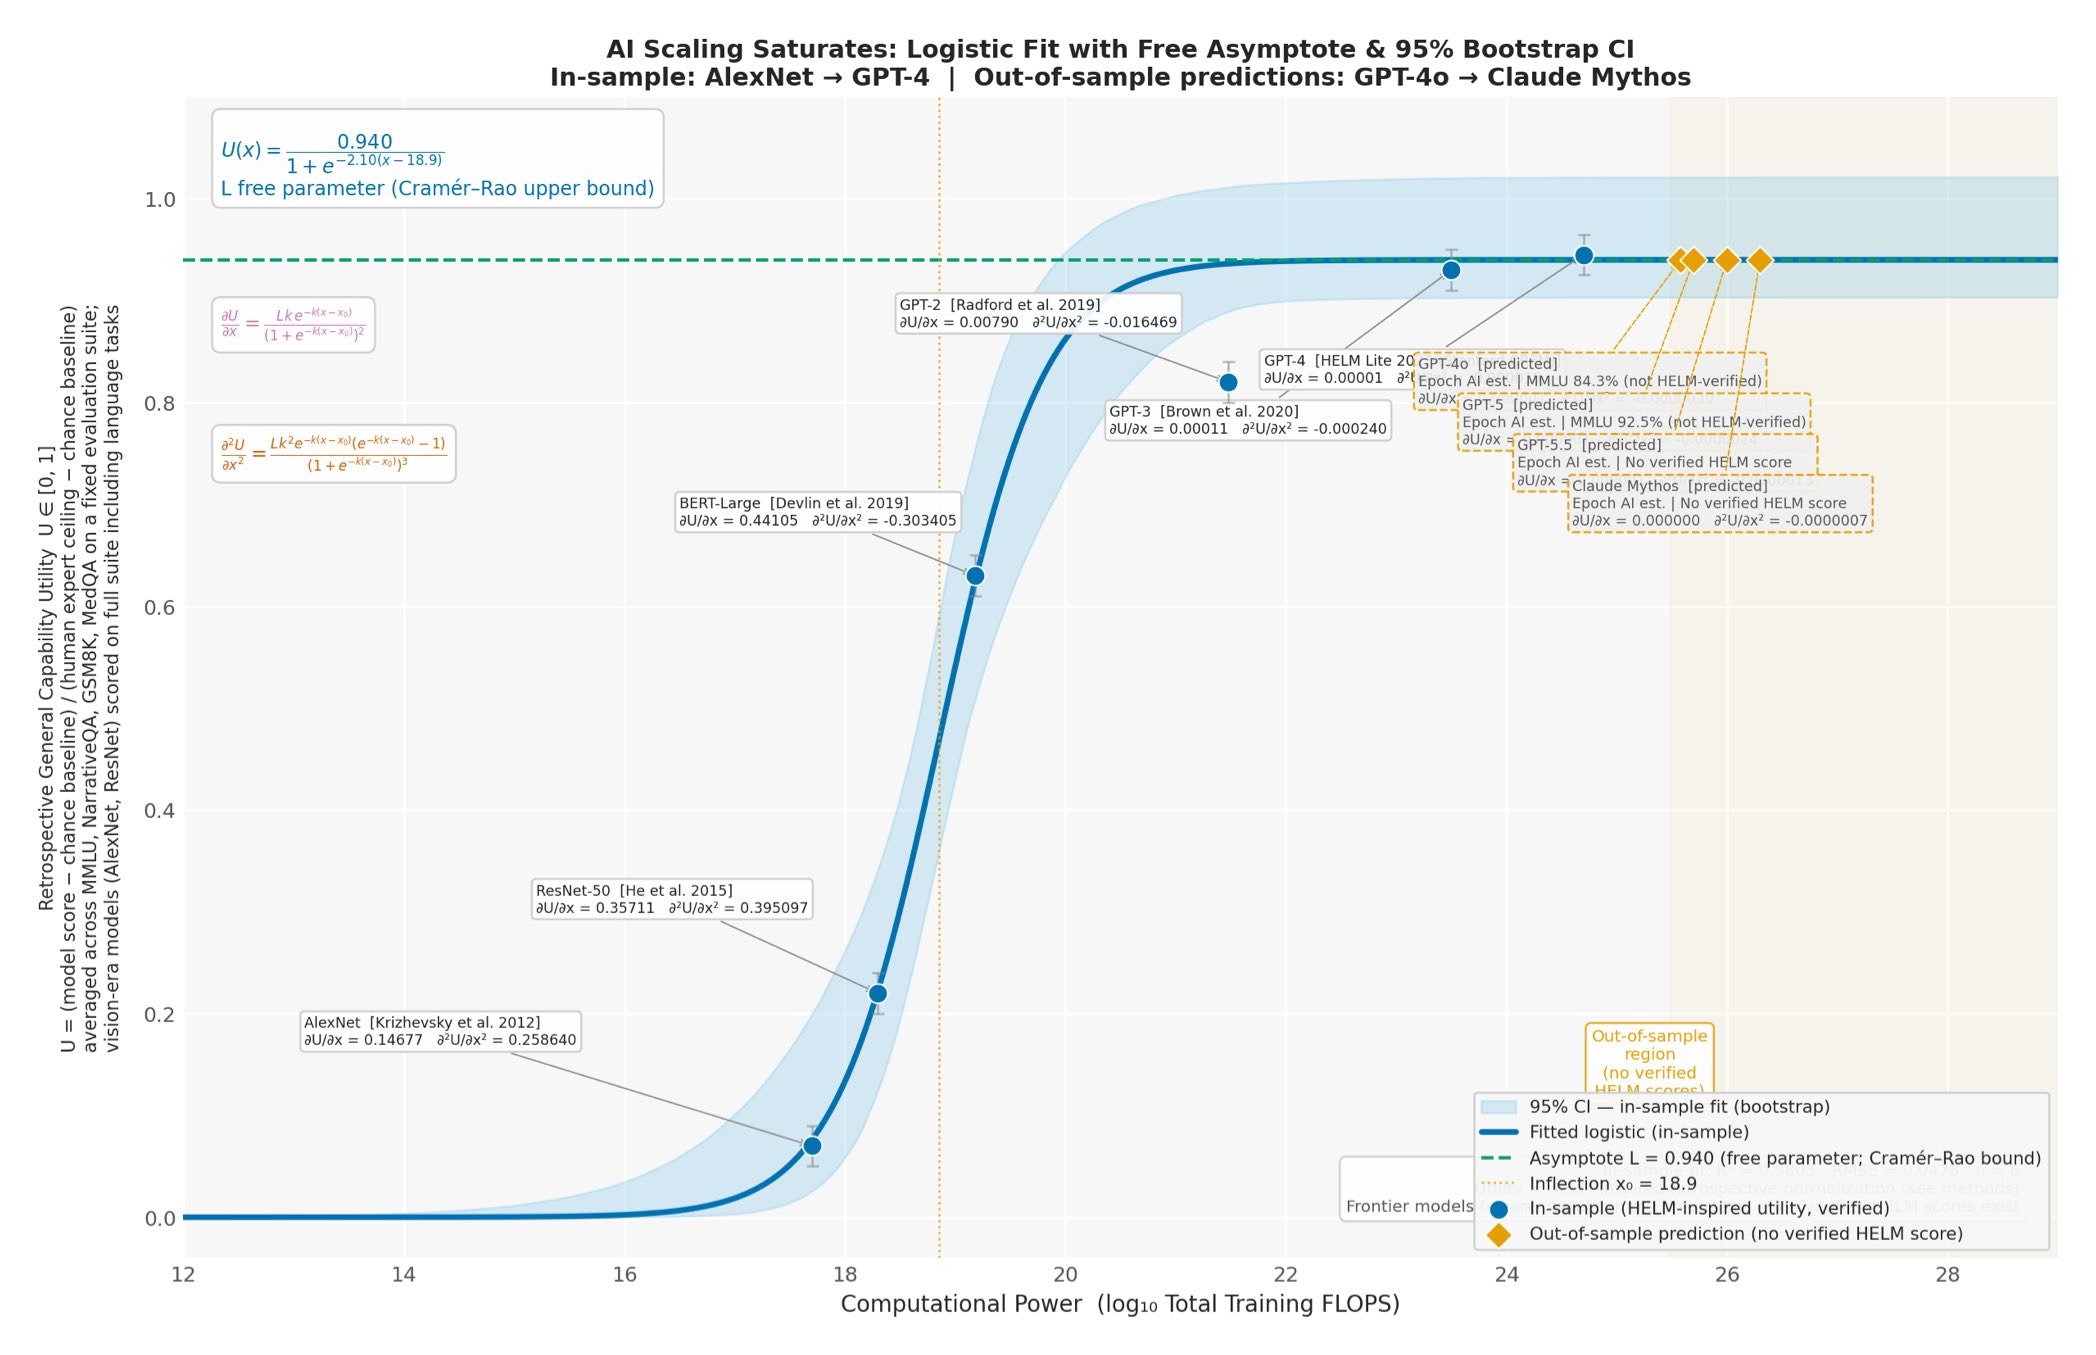
통계에 밝은 종양내과 의사 @5_utr가 AlexNet부터 GPT-4까지의 데이터에 로지스틱 곡선을 적합해 ‘AI 스케일링은 지수가 아니라 포화한다’고 주장했다. 타래의 진짜 칼끝은 거시경제다 — AI 밸류에이션이 지수함수로 가격책정됐는데 데이터는 로지스틱이 훨씬 잘 맞으니 함수형 오설정이자 버블이라는 것. 주장과 그 한계를 함께 정리한다.
Anthropic이 Fable을 출시한 직후 zero_goliath가 쓴 짧은 에세이. 컴퓨트가 아니라 데이터 파이프라인이 진짜 병목이며, RLVR이 한계에 닿으면 AI가 운영하는 실제 회사들의 손익이 다음 보상 신호가 된다고 본다.
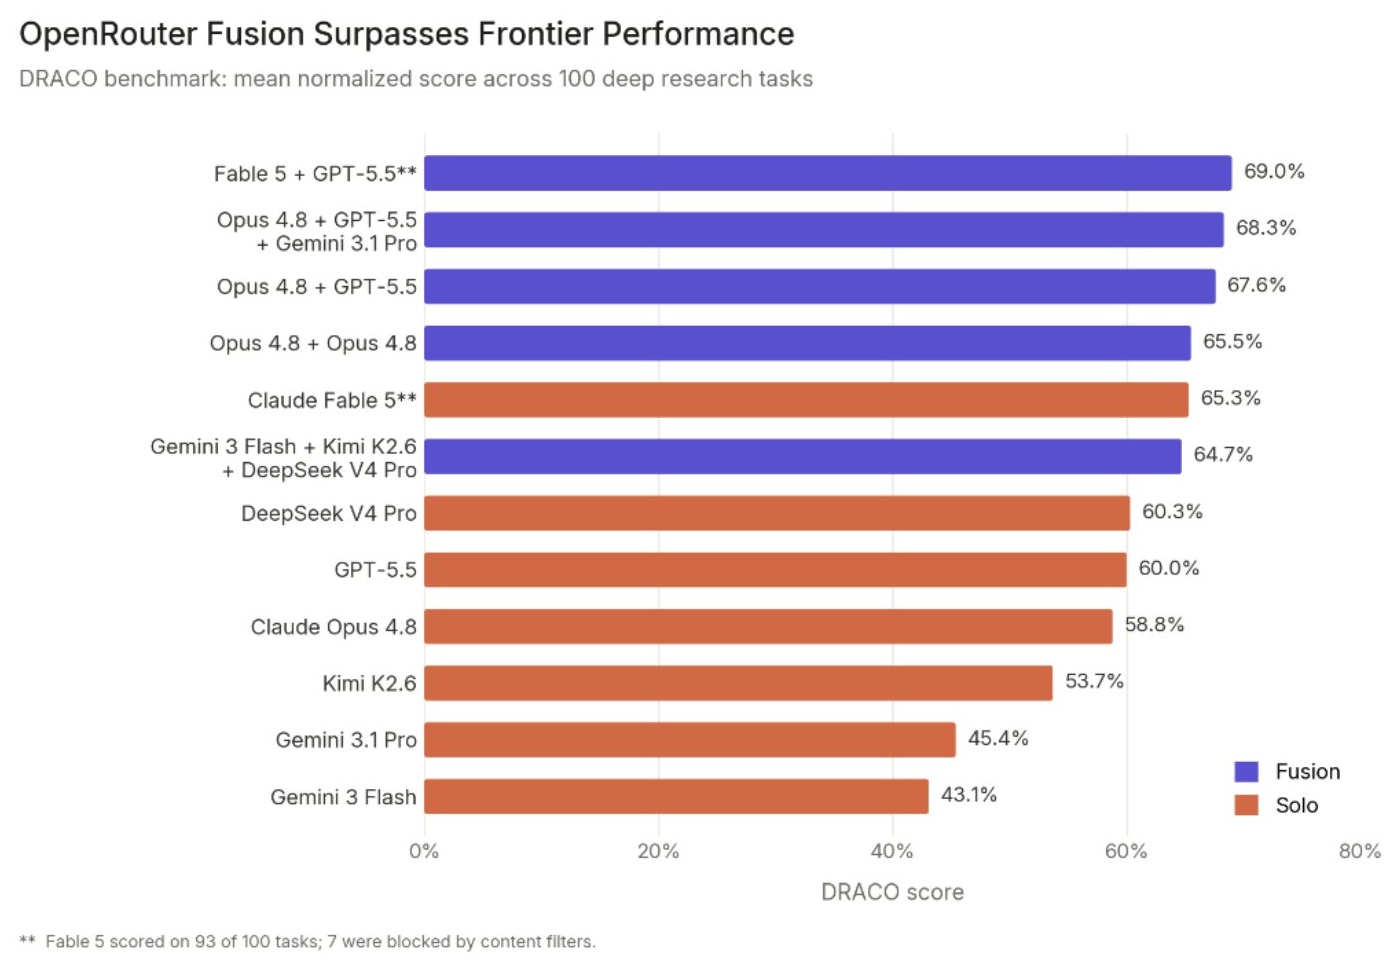
Andrew Trask는 더 큰 단일 모델이 AI 한계를 독점하리라는 통념이 끝났다고 선언한다. 작은 모델들의 가중 앙상블이 정확도·속도·비용에서 이미 단일 프런티어 모델을 추월하기 시작했고, AI의 미래는 회사 단위가 아닌 세계 단위의 ’network-source AI’다.
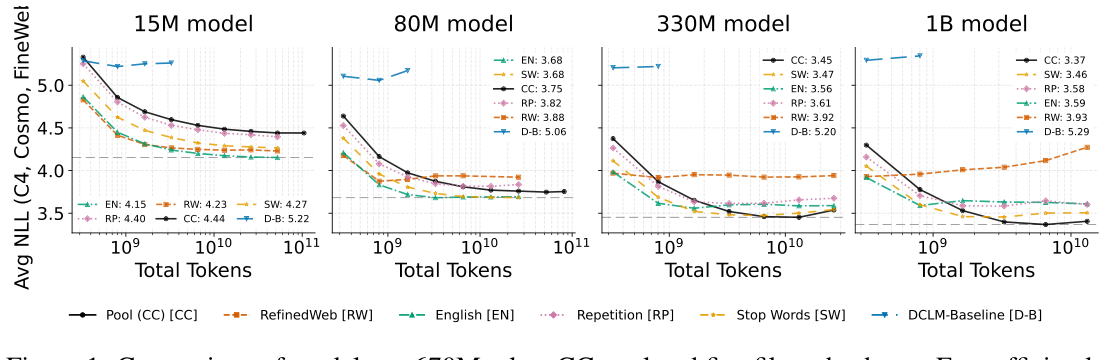
컴퓨트가 충분히 크면 데이터 필터링은 오히려 손해다 — Stanford 연구진이 Common Crawl과 5개 표준 필터를 비교하여, 큰 모델이 ‘저품질’ 데이터에서도 이득을 본다는 증거를 제시한다.