Sparse Reward Subsystem in Large Language Models
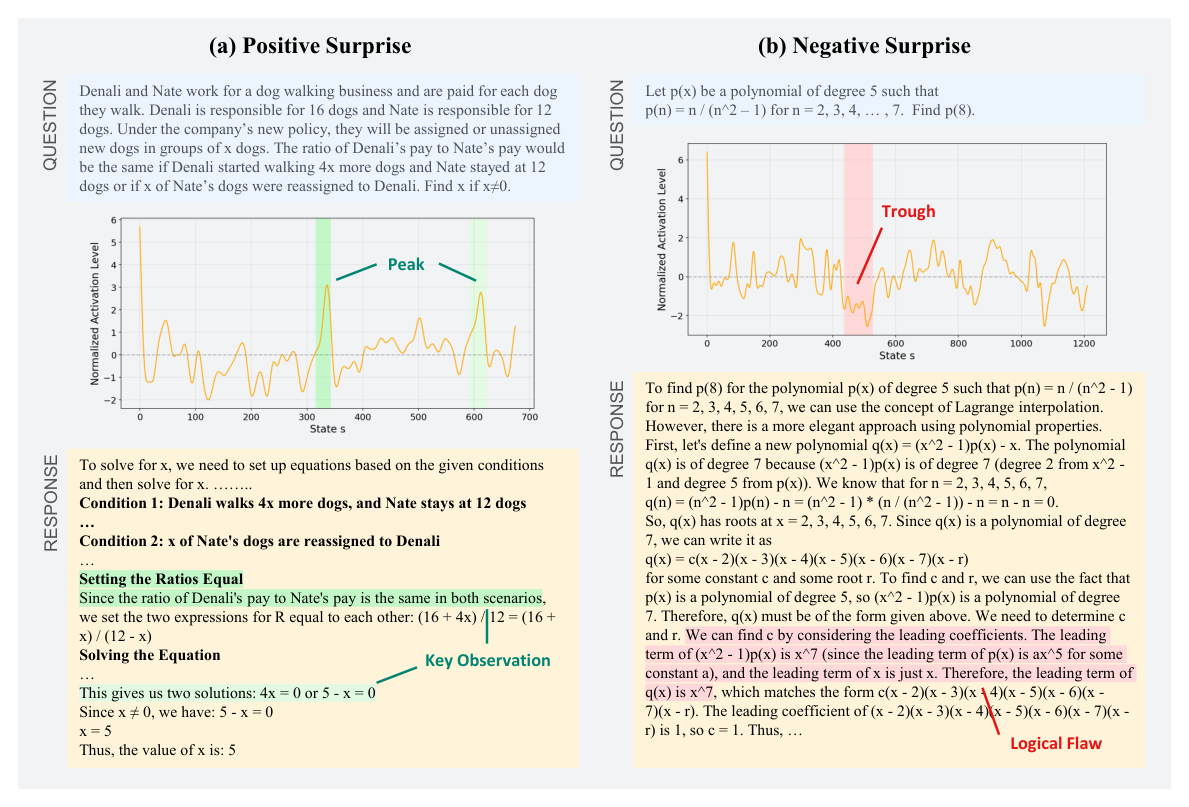
LLM의 히든 스테이트에 담긴 보상 정보는 뉴런 전체에 흩어져 있지 않고 1%에도 못 미치는 극소수 뉴런에 몰려 있다. 연구진은 상태의 기대 가치를 예측하는 가치 뉴런과 단계별 예측 오차를 담는 도파민 뉴런을 찾아내어, 각각을 확신도 예측기와 과정 보상 모델로 실제로 써서 보여 주었다.
LLM의 히든 스테이트에 담긴 보상 정보는 뉴런 전체에 흩어져 있지 않고 1%에도 못 미치는 극소수 뉴런에 몰려 있다. 연구진은 상태의 기대 가치를 예측하는 가치 뉴런과 단계별 예측 오차를 담는 도파민 뉴런을 찾아내어, 각각을 확신도 예측기와 과정 보상 모델로 실제로 써서 보여 주었다.
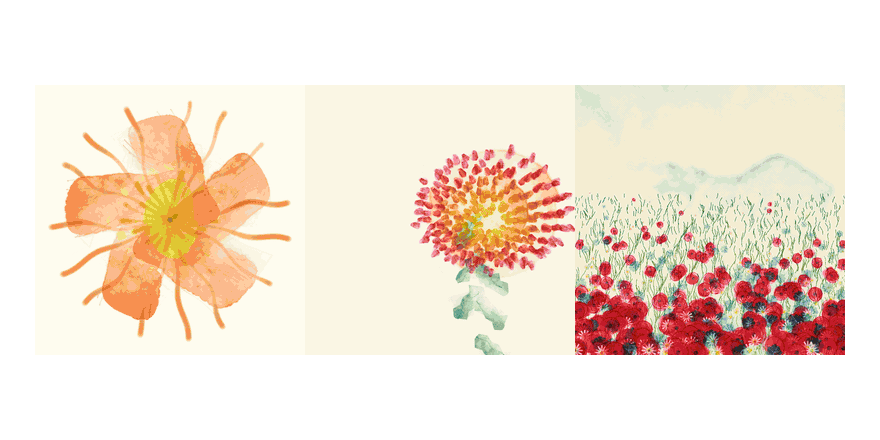
이 수채화들은 이미지 생성 모델이 만든 것이 아니다. 언어 모델이 그림을 그려 내는 자바스크립트를 작성했고, 그 코드를 쓰는 방법은 강화학습으로 익혔다.