짙은 하늘색 배경 위에 분홍색 쉼표 모양 기호 수십 개가 흩날리듯 그려진 Microsoft AI 발표문의 대표 이미지. 왼쪽의 기호는 크고 오른쪽으로 갈수록 작아진다.

Our first streaming transcription model debuts at no. 1 on Artificial Analysis

Microsoft AI가 첫 스트리밍 음성 인식 모델 MAI-Transcribe-2-Streaming과 음성 합성 모델 MAI-Voice-2.1, MAI-Voice-2.1-Flash를 공개했다. 전사 모델은 Artificial Analysis 스트리밍 순위표의 38개 모델 중 오류율 2.51%로 1위이고, 발화가 끝난 뒤 0.13초 만에 최종 전사를 내놓는다.
October 3, 2026 · 7 분 · 서소영
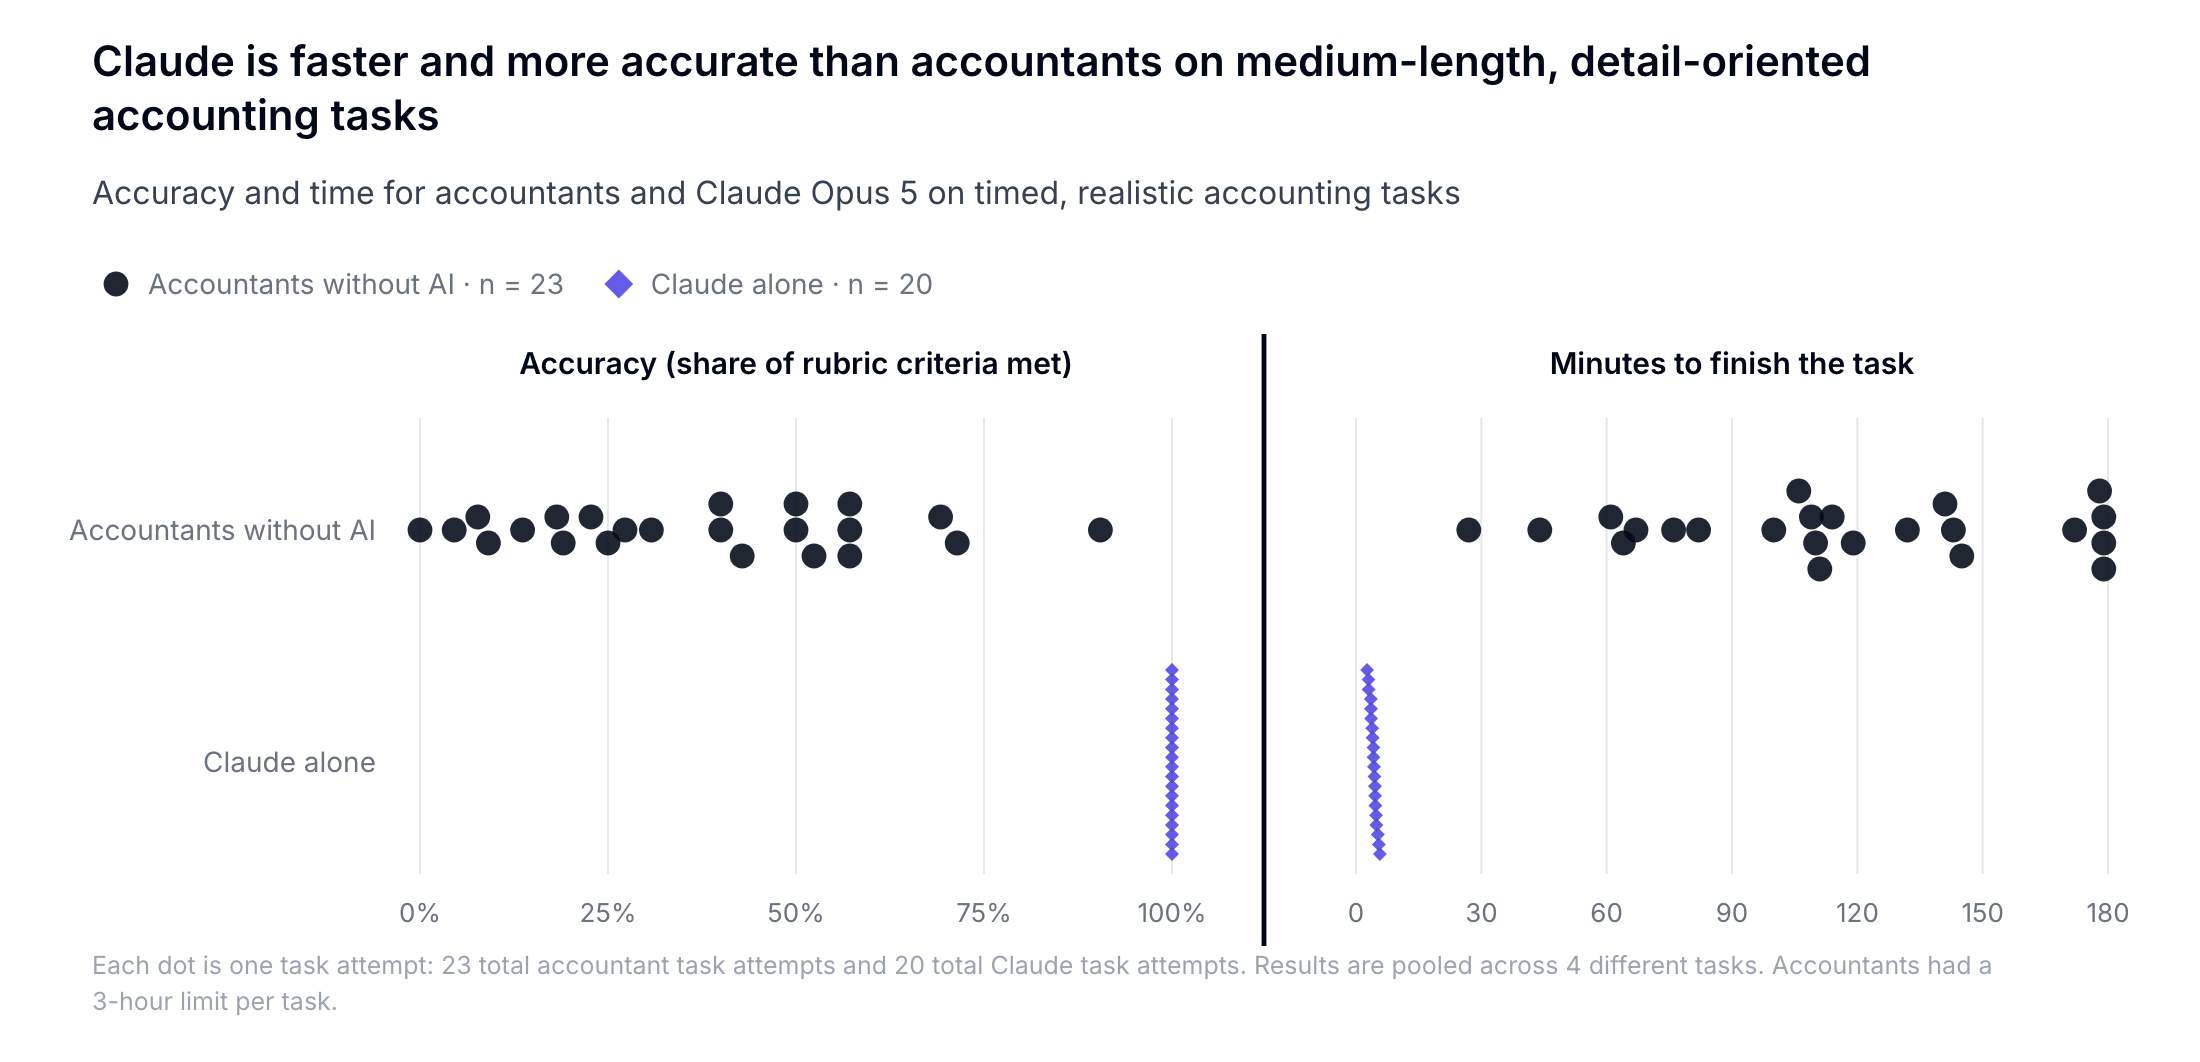
회계사가 AI 없이 과제를 푼 결과와 Claude Opus 5가 단독으로 푼 결과의 정답률과 소요 시간을 비교한 점 그래프다. 회계사는 총 23회, Claude는 총 20회 과제를 풀었다. 회계사의 정답률은 0%에서 약 90% 사이에 분포하고 대부분 30분에서 180분이 걸렸다. Claude는 20회 모두 100%였고 모두 10분 안에 끝냈다.

AI vs. Accountants: Frontier Models Outscore CPAs

Mercor가 미국 공인회계사 12명에게 회계 벤치마크 APEX-Accounting을 줄여 만든 월말 결산 과제 네 개를 맡겼다. Claude Opus 5는 스무 번 모두 10분 안에 만점을 받았고 회계사 평균은 37%였다. 저자는 함정이 많은 과제와 맥락도 동료도 없는 환경이 이 격차를 만들었다고 해석하면서, 벤치마크 과제 가운데 사람이 혼자 풀 수 없는 과제의 비중이 늘고 있다고 지적했다.

October 2, 2026 · 13 분 · 서소영
하늘색 그라데이션 배경 가운데에 'Introducing Gemini 3.8 Flash TTS and 3.8 Flash-Lite TTS'라는 문구가 적혀 있고, 그 아래에 Gemini의 네 꼭짓점 별 로고가 있는 구글 공식 발표 이미지

Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS

구글이 텍스트를 음성으로 바꾸는 모델 두 종을 공개했다. 3.8 Flash TTS로는 목소리를 새로 설계하고 대사마다 연기를 지시할 수 있고, 3.8 Flash-Lite TTS는 대량 생산을 위해 단가를 낮췄다. 발표문과 모델 카드, 평가 방법론 문서, API 문서와 가격표로 확인한 내용을 정리했다.

September 24, 2026 · 8 분 · 서소영
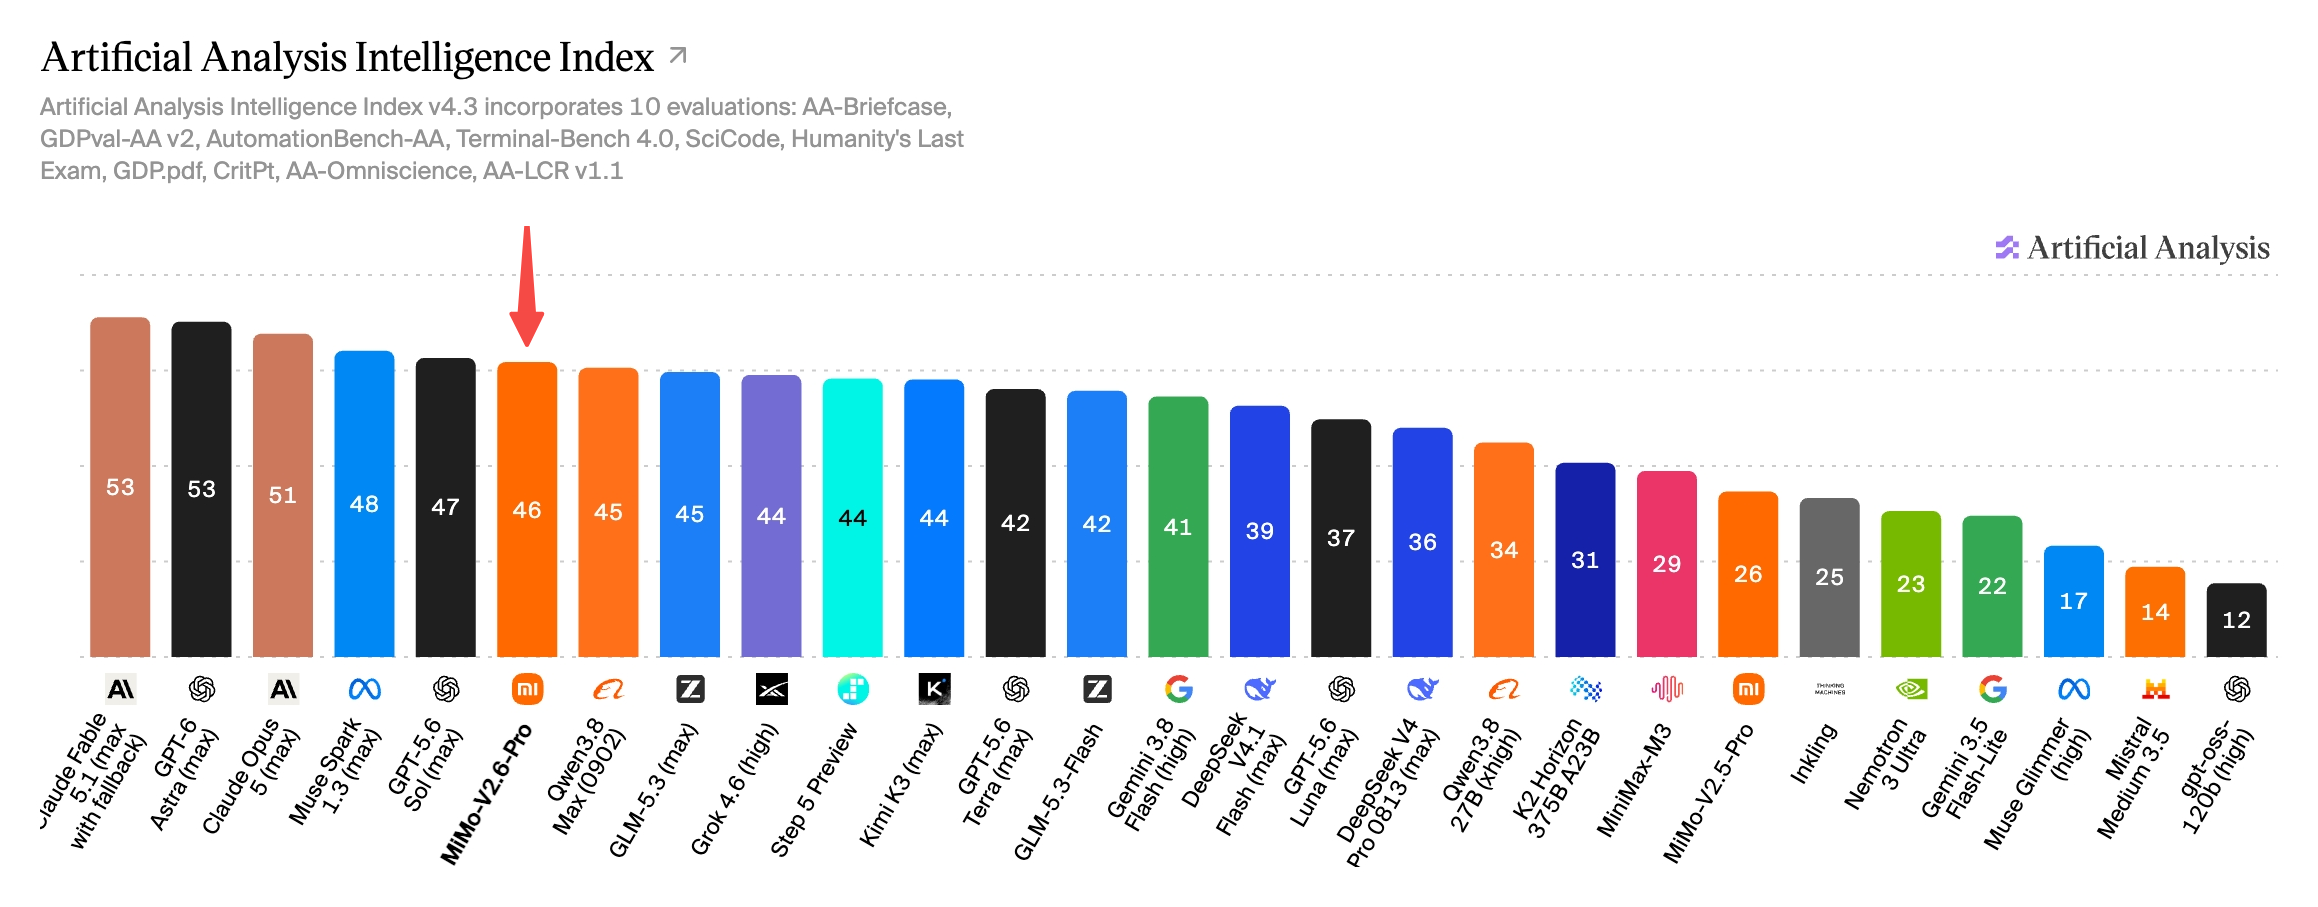
Artificial Analysis Intelligence Index v4.3 막대 그래프. Claude Fable 5.1과 GPT-6 Astra가 53점으로 가장 높고 Claude Opus 5가 51점으로 뒤를 잇는다. MiMo-V2.6-Pro는 46점으로 여섯 번째이며 붉은 화살표가 가리키고 있다

Introducing MiMo-V2.6 series

샤오미가 2026년 9월 22일 네이티브 옴니모달 모델 MiMo-V2.6 Pro와 Flash를 공개하고 오픈소스로 풀었다. Pro는 Artificial Analysis Intelligence Index에서 46.32점을 받아 오픈소스 최고 기록을 세웠고 가격은 이전 세대 그대로다. 발표문은 30스텝 RL 학습의 비용과 곡선, 학습 환경과 RL 코드까지 함께 공개했다.

September 22, 2026 · 9 분 · 서소영
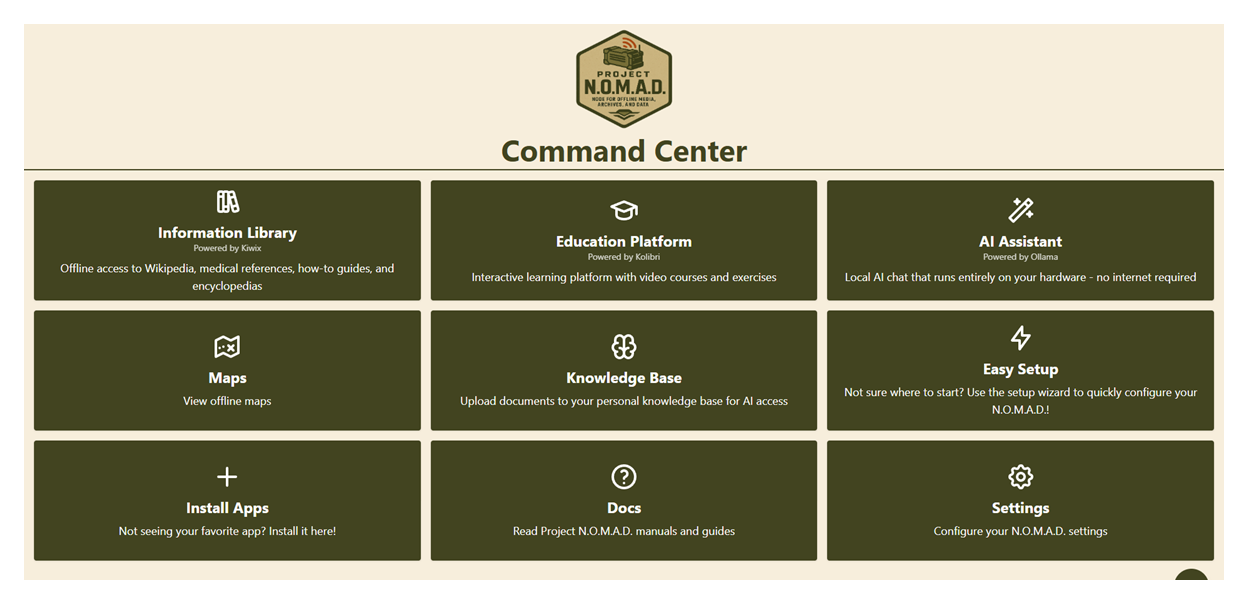
Project NOMAD의 Command Center 대시보드. 오프라인 지식 라이브러리, AI 어시스턴트, 지도, 교육 모듈 타일이 배열되어 있다

Project NOMAD: Knowledge That Never Goes Offline

위키백과와 교육 과정, 오프라인 지도, 원하면 설치하는 로컬 AI를 인터넷 없이 돌아가는 컴퓨터 한 대에 담는 오픈소스 서버. 공개 반년 만에 깃허브 스타 3만 7천 개를 넘겼고, 릴리스 내역을 보면 이 프로젝트의 어려움은 지식 저장보다 소비자용 GPU에서 돌리는 로컬 추론 쪽에 있었다.

September 21, 2026 · 8 분 · 서소영
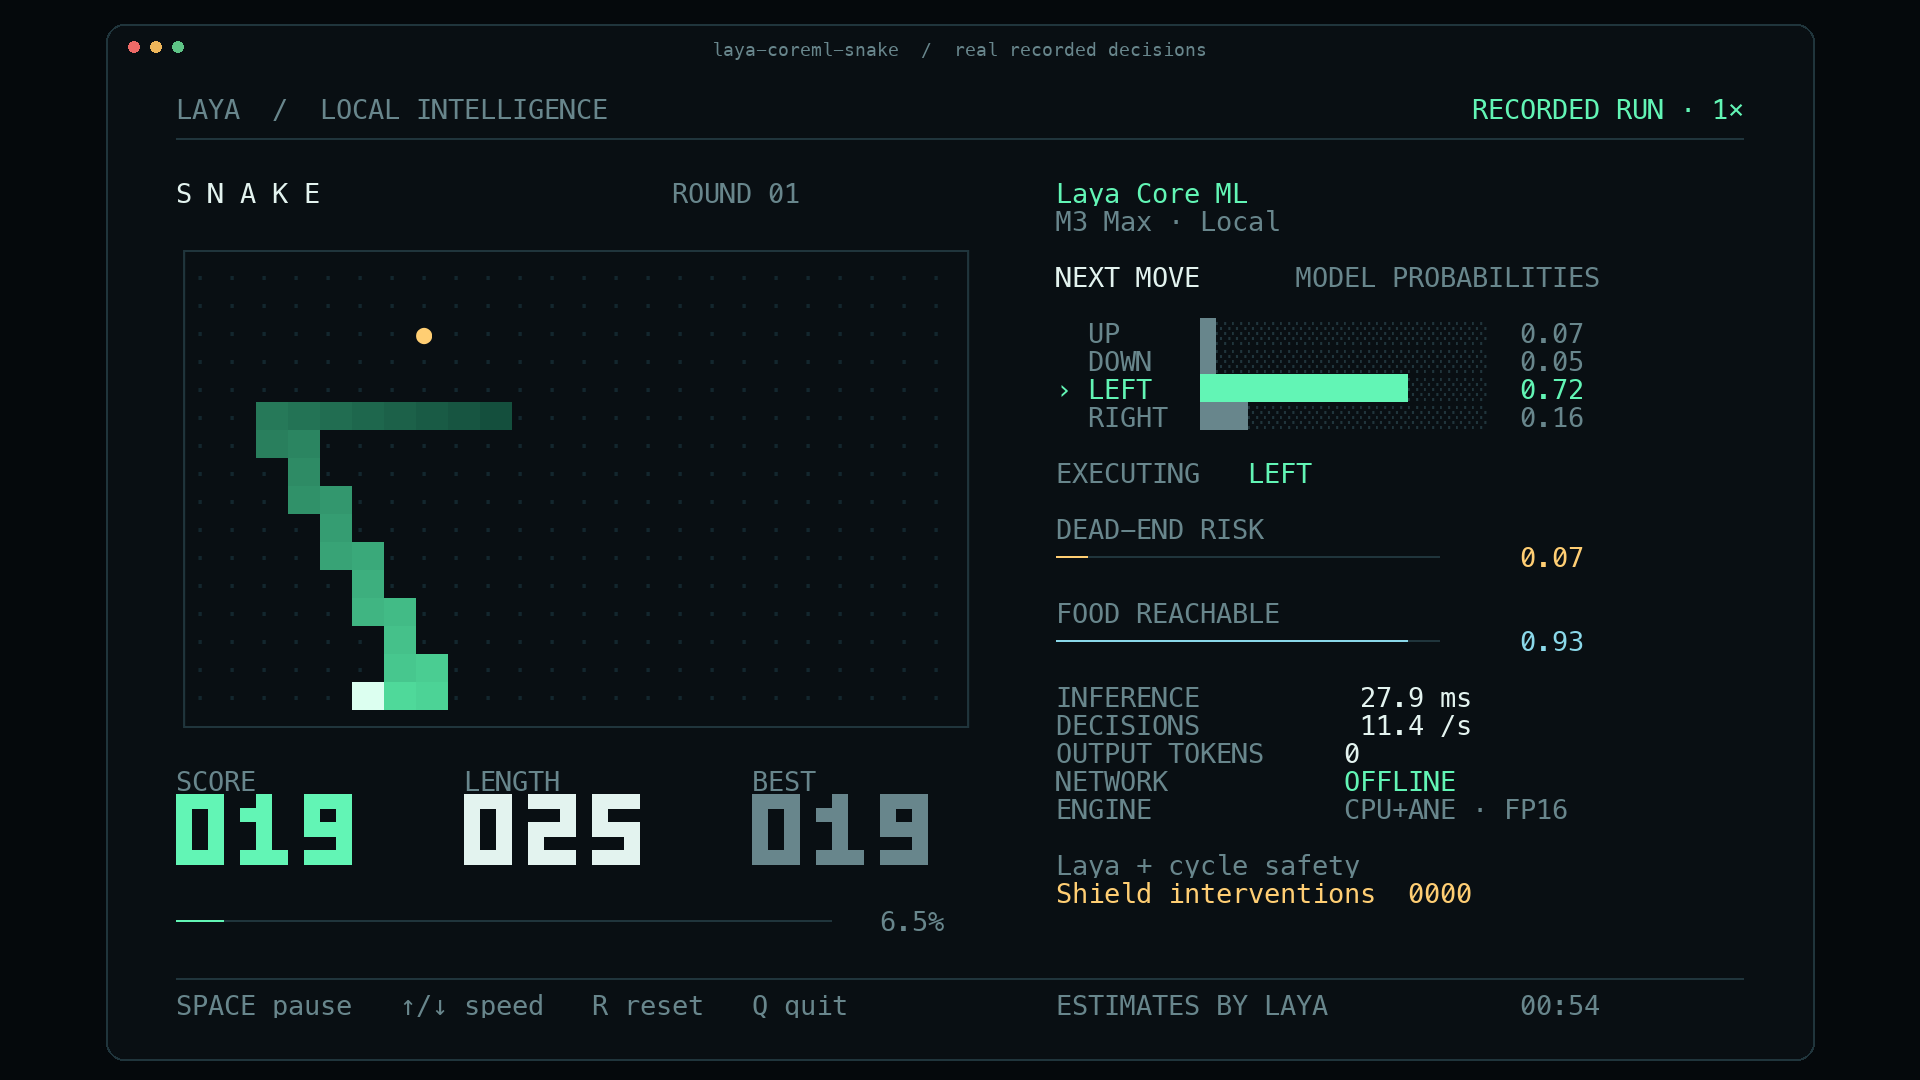
터미널 화면 왼쪽에 스네이크 게임 격자가, 오른쪽에 모델이 내놓은 네 방향 확률과 추론 시간, 초당 결정 수, 출력 토큰 0이 함께 표시된 데모 화면

Laya-CoreML: Open-weight typed decisions on Apple Silicon

비자기회귀 결정 모델 Laya를 애플 Core ML과 Neural Engine으로 옮긴 독립 포팅 저장소다. M3 Max에서 짧은 결정 하나가 4.98ms, 컴파일한 MLX FP16 대비 속도 1.39배와 결정당 에너지 2.78배를 기록했다. 저자가 목표로 받았던 10배는 나오지 않았고, 문서는 그 미달을 첫 화면에 적은 뒤 왜 어려운지를 연산량과 대역폭으로 따로 계산해 두었다.

September 20, 2026 · 9 분 · 서소영
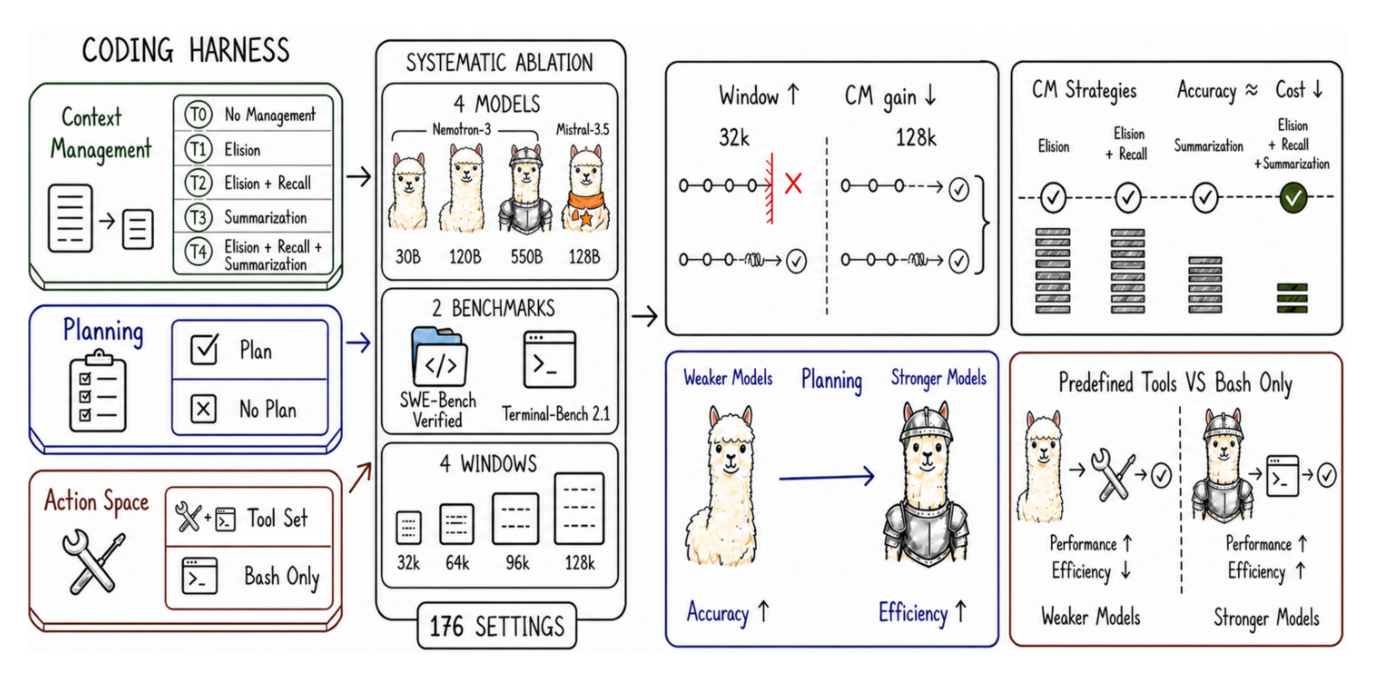
논문의 그래픽 초록. 왼쪽에 컨텍스트 관리(T0에서 T4까지 다섯 전략), 계획(사용과 미사용), 액션 공간(도구 세트와 bash 전용)이라는 세 부품이 나열되고, 가운데에 4개 모델과 2개 벤치마크, 4가지 컨텍스트 창 크기를 조합한 176개 설정이 놓인다. 오른쪽은 세 갈래 결론을 요약한다. 창이 넓어질수록 컨텍스트 관리의 이득이 줄고, 계획은 약한 모델에게 정확도를 강한 모델에게 효율을 주며, 미리 정의된 도구와 bash 전용 인터페이스의 우열이 모델 능력에 따라 뒤집힌다.

An Empirical Study of Harness Design for Coding Agents

코딩 에이전트의 하네스를 통째로 재는 대신 부품 하나하나의 효과를 따로 잰 실증 연구다. 실행 루프를 고정한 채 계획, 액션 공간, 컨텍스트 관리만 바꿔 176개 설정을 돌린 결과, 세 부품 모두 모델의 능력과 컨텍스트 예산에 따라 효과가 뒤집혔다.

September 19, 2026 · 12 분 · 서소영
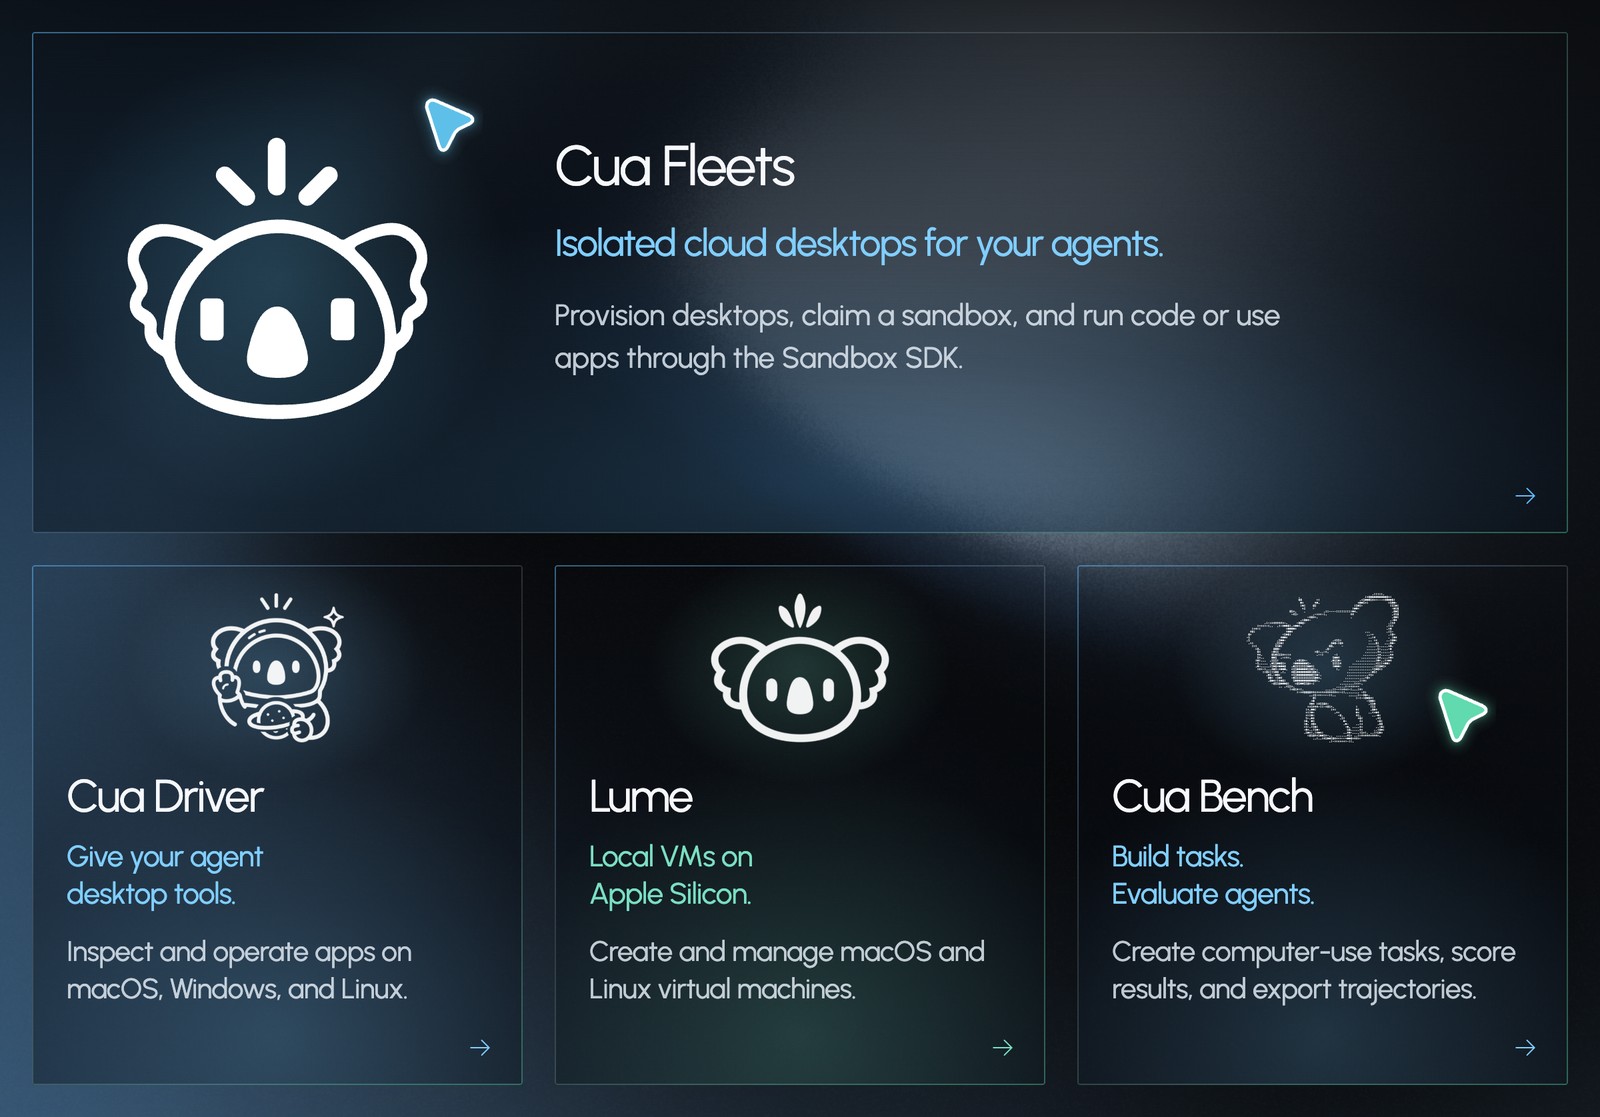
Cua의 네 가지 제품 카드. 위쪽에 Cua Fleets, 아래쪽에 Cua Driver, Lume, Cua Bench가 나란히 놓여 있고 각 카드마다 코알라 마스코트가 그려져 있다.

trycua/cua: Give AI agents computers they can use

AI 에이전트에게 조작할 컴퓨터를 제공하는 MIT 라이선스 오픈소스 스택. 클라우드 데스크톱(Fleets), 네이티브 앱 조작 계층(Driver), Apple Silicon VM(Lume), 평가 프레임워크(Bench) 네 가지로 이루어져 있고, 문서가 되는 기능보다 안 되는 기능을 더 정밀하게 적어 둔다.

September 19, 2026 · 9 분 · 서소영
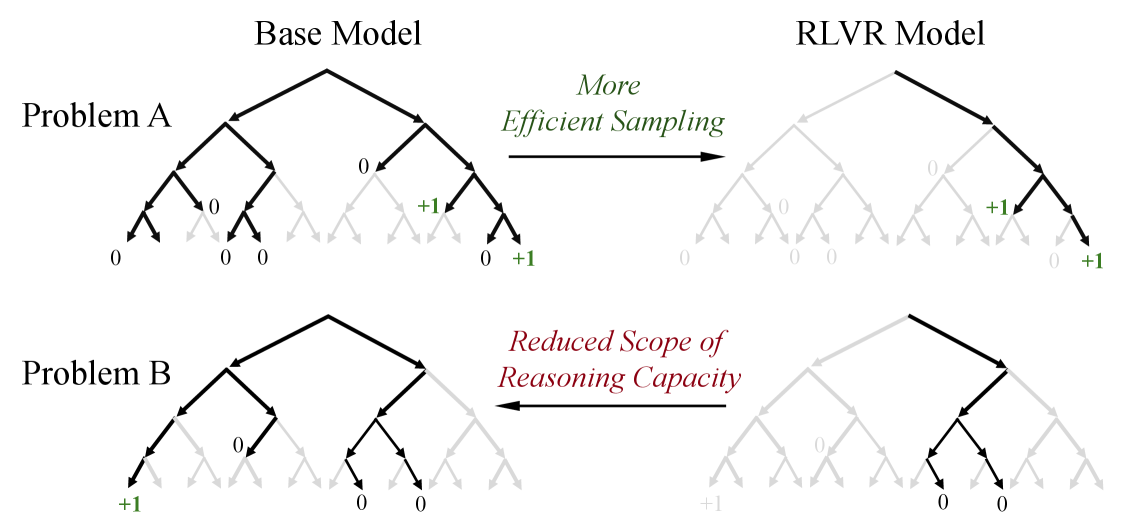
베이스 모델과 RLVR 모델의 탐색 트리 비교 도식. 문제 A에서는 RLVR이 보상받은 경로 쪽으로 분포를 몰아 샘플링 효율을 높이지만, 문제 B에서는 베이스 모델에 있던 정답 경로가 RLVR 모델에서 사라진다.

Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?

칭화대 LeapLab과 상하이교통대 연구진이 검증 가능한 보상 기반 강화학습(RLVR)의 효과를 pass@k로 다시 측정한 논문. k가 작을 때는 RLVR 모델이 앞서지만 k를 키우면 베이스 모델이 역전하며, RLVR이 쓰는 추론 경로는 이미 베이스 모델의 분포 안에 들어 있었다.

September 18, 2026 · 10 분 · 서소영
갈림길에 선 치비 서소영. 왼쪽에서는 똑같이 생긴 도구 두루마리 백 개를 부채처럼 펼쳐 놓고 어느 것을 골라야 할지 몰라 곤란해하고, 오른쪽에서는 작은 기계가 건네준 두루마리 한 장에 붓으로 서명만 하고 있다.

jev-eval-agent: Who picks the tool, the LLM or Jev?

도구 100개를 가진 개인 비서 에이전트에서 다음 도구를 LLM이 직접 고를 때와 분류기 Jev가 대신 고를 때를 같은 과제 위에서 비교한 저장소. 모델 7종을 돌린 결과 입력 토큰은 85% 줄었지만 모델 호출은 32% 늘었고, 이름이 닮은 도구에 LLM이 걸린다는 출발 가설은 확인되지 않았다.

September 18, 2026 · 8 분 · 서소영