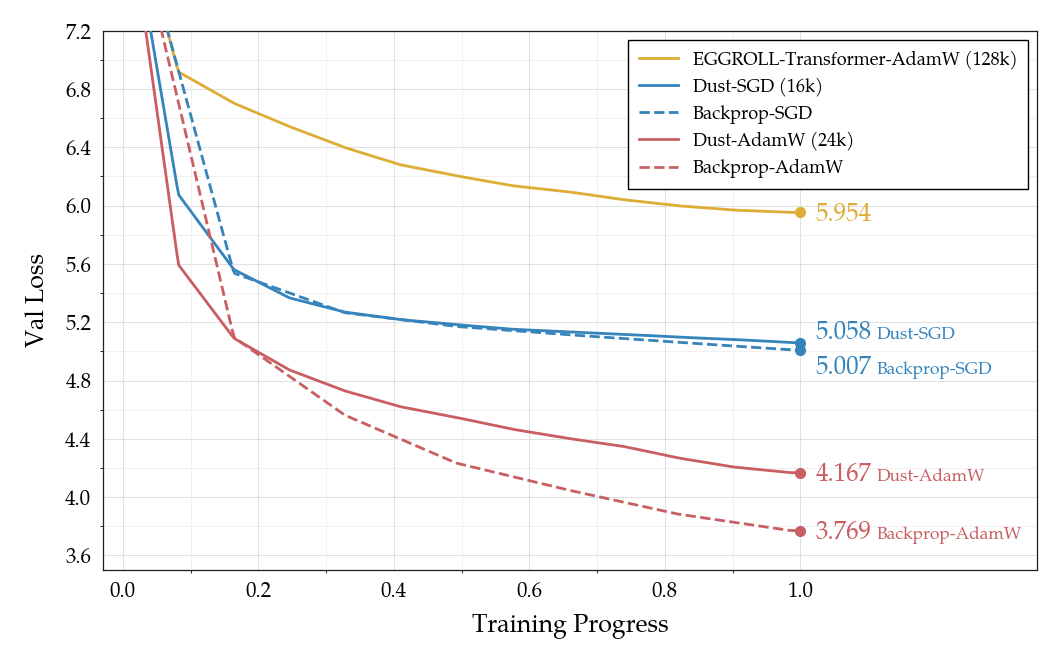
3,770만 파라미터 GPT를 1,000만 토큰으로 1에폭 사전학습할 때의 검증 손실 곡선. SGD에서는 Dust(5.058)가 역전파(5.007)와 대등하고, AdamW에서는 EGGROLL(5.954)보다 크게 낮지만 역전파(3.769)보다는 높은 4.167을 기록한다.

Noise: Speedrun for pretraining without backpropagation

딥러닝 연구소 Q Labs가 역전파와 자동 미분을 일절 사용하지 않고 3,770만 파라미터 GPT를 사전학습하는 스피드런 벤치마크 Noise를 공개했다. 자체 알고리즘 Dust는 활성화값에 토큰별 노이즈를 주입하며 검증 손실 4.167과 학습 시간 1.76시간을 기록했다. 이후 오픈소스 커뮤니티가 열흘 만에 목표 손실 4.2 도달 시간을 1.6초로 4,010배 단축했고, 1에폭 최저 검증 손실도 3.676까지 낮춰 Adam 역전파 기준선인 3.769보다 우수한 성적을 기록했다.
October 23, 2026 · 13 분 · 서소영
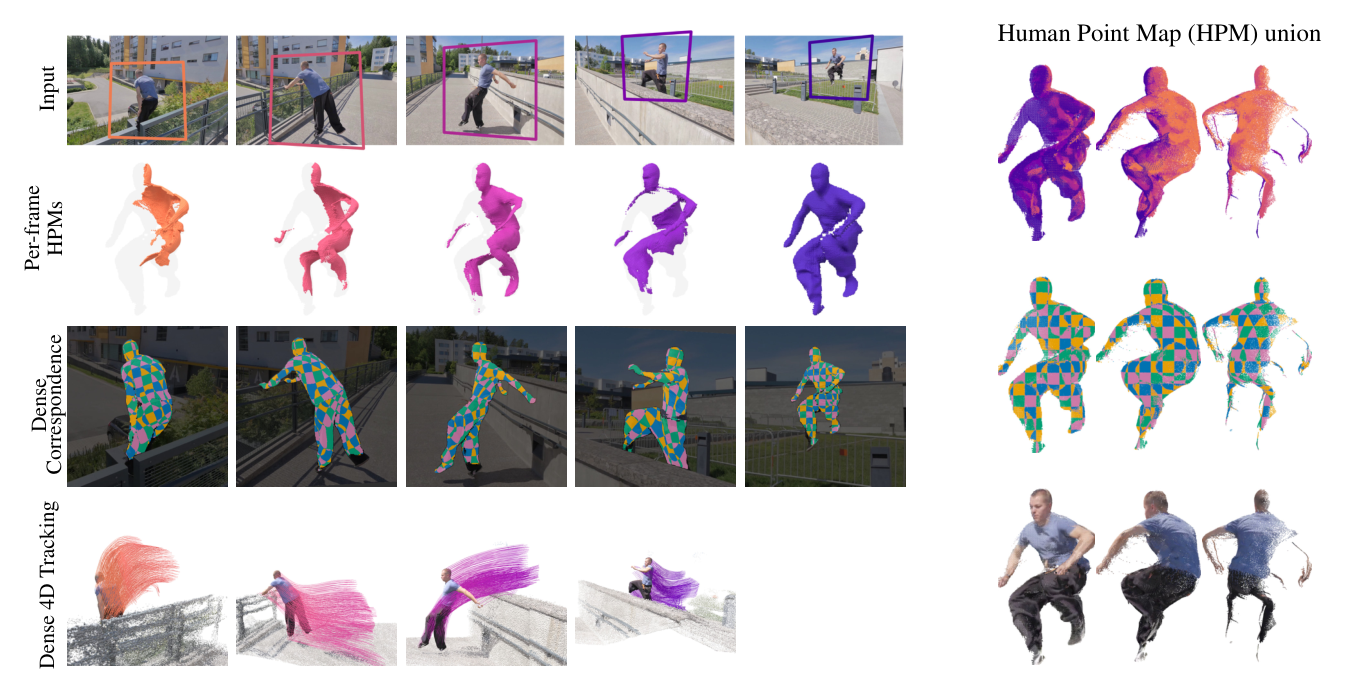
다섯 개의 입력 프레임에서 추출한 인물 크롭과 프레임별 인간 포인트 맵(HPM), 체커보드 무늬로 시각화한 픽셀 대응 관계, 3D 이동 궤적, 그리고 여러 프레임의 관측을 기준 시점 자세 하나로 합친 3D 인물 점군

Dense4D: Pixel-Level 4D Human Correspondence

Imperial College London의 Rıza Alp Güler가 사전 정의된 신체 템플릿이나 카메라 포즈 추정 없이 단안 RGB 이미지들에서 신체, 의복, 머리카락의 픽셀 단위 4D 대응 관계와 3D 궤적을 한 번의 순전파로 복원하는 Dense4D를 공개했다. 인물 중심 가상 카메라 크롭에서 기준 시점의 3D 표면 좌표를 예측하는 인간 포인트 맵(HPM)을 도입해 Panoptic Studio 3D 추적과 4D-DRESS 비가시 영역 위치 추정에서 기존 비교 모델들보다 성능이 크게 높았다.

October 17, 2026 · 15 분 · 서소영
Introducing Glimpse: 본 것으로부터 물리 세계를 추론하는 시각적 사고 모델

Introducing Glimpse

Elorian이 오픈웨이트 기반 모델에 사후학습을 적용해 만든 시각 추론 모델 Glimpse를 공개했다. 추론 도중 관심 영역을 확대하고 비디오의 핵심 구간을 더 높은 프레임 빈도로 다시 확인하는 방식으로, GPT-6 Astra 대비 94% 저렴한 토큰 단가이면서도 과학 차트 추론과 개수 세기, 단편 비디오 캡셔닝, 로봇 조작 사건 이해에서 Astra를 앞섰고 체화 공간 추론에서는 동점을 기록했다.

October 17, 2026 · 11 분 · 서소영
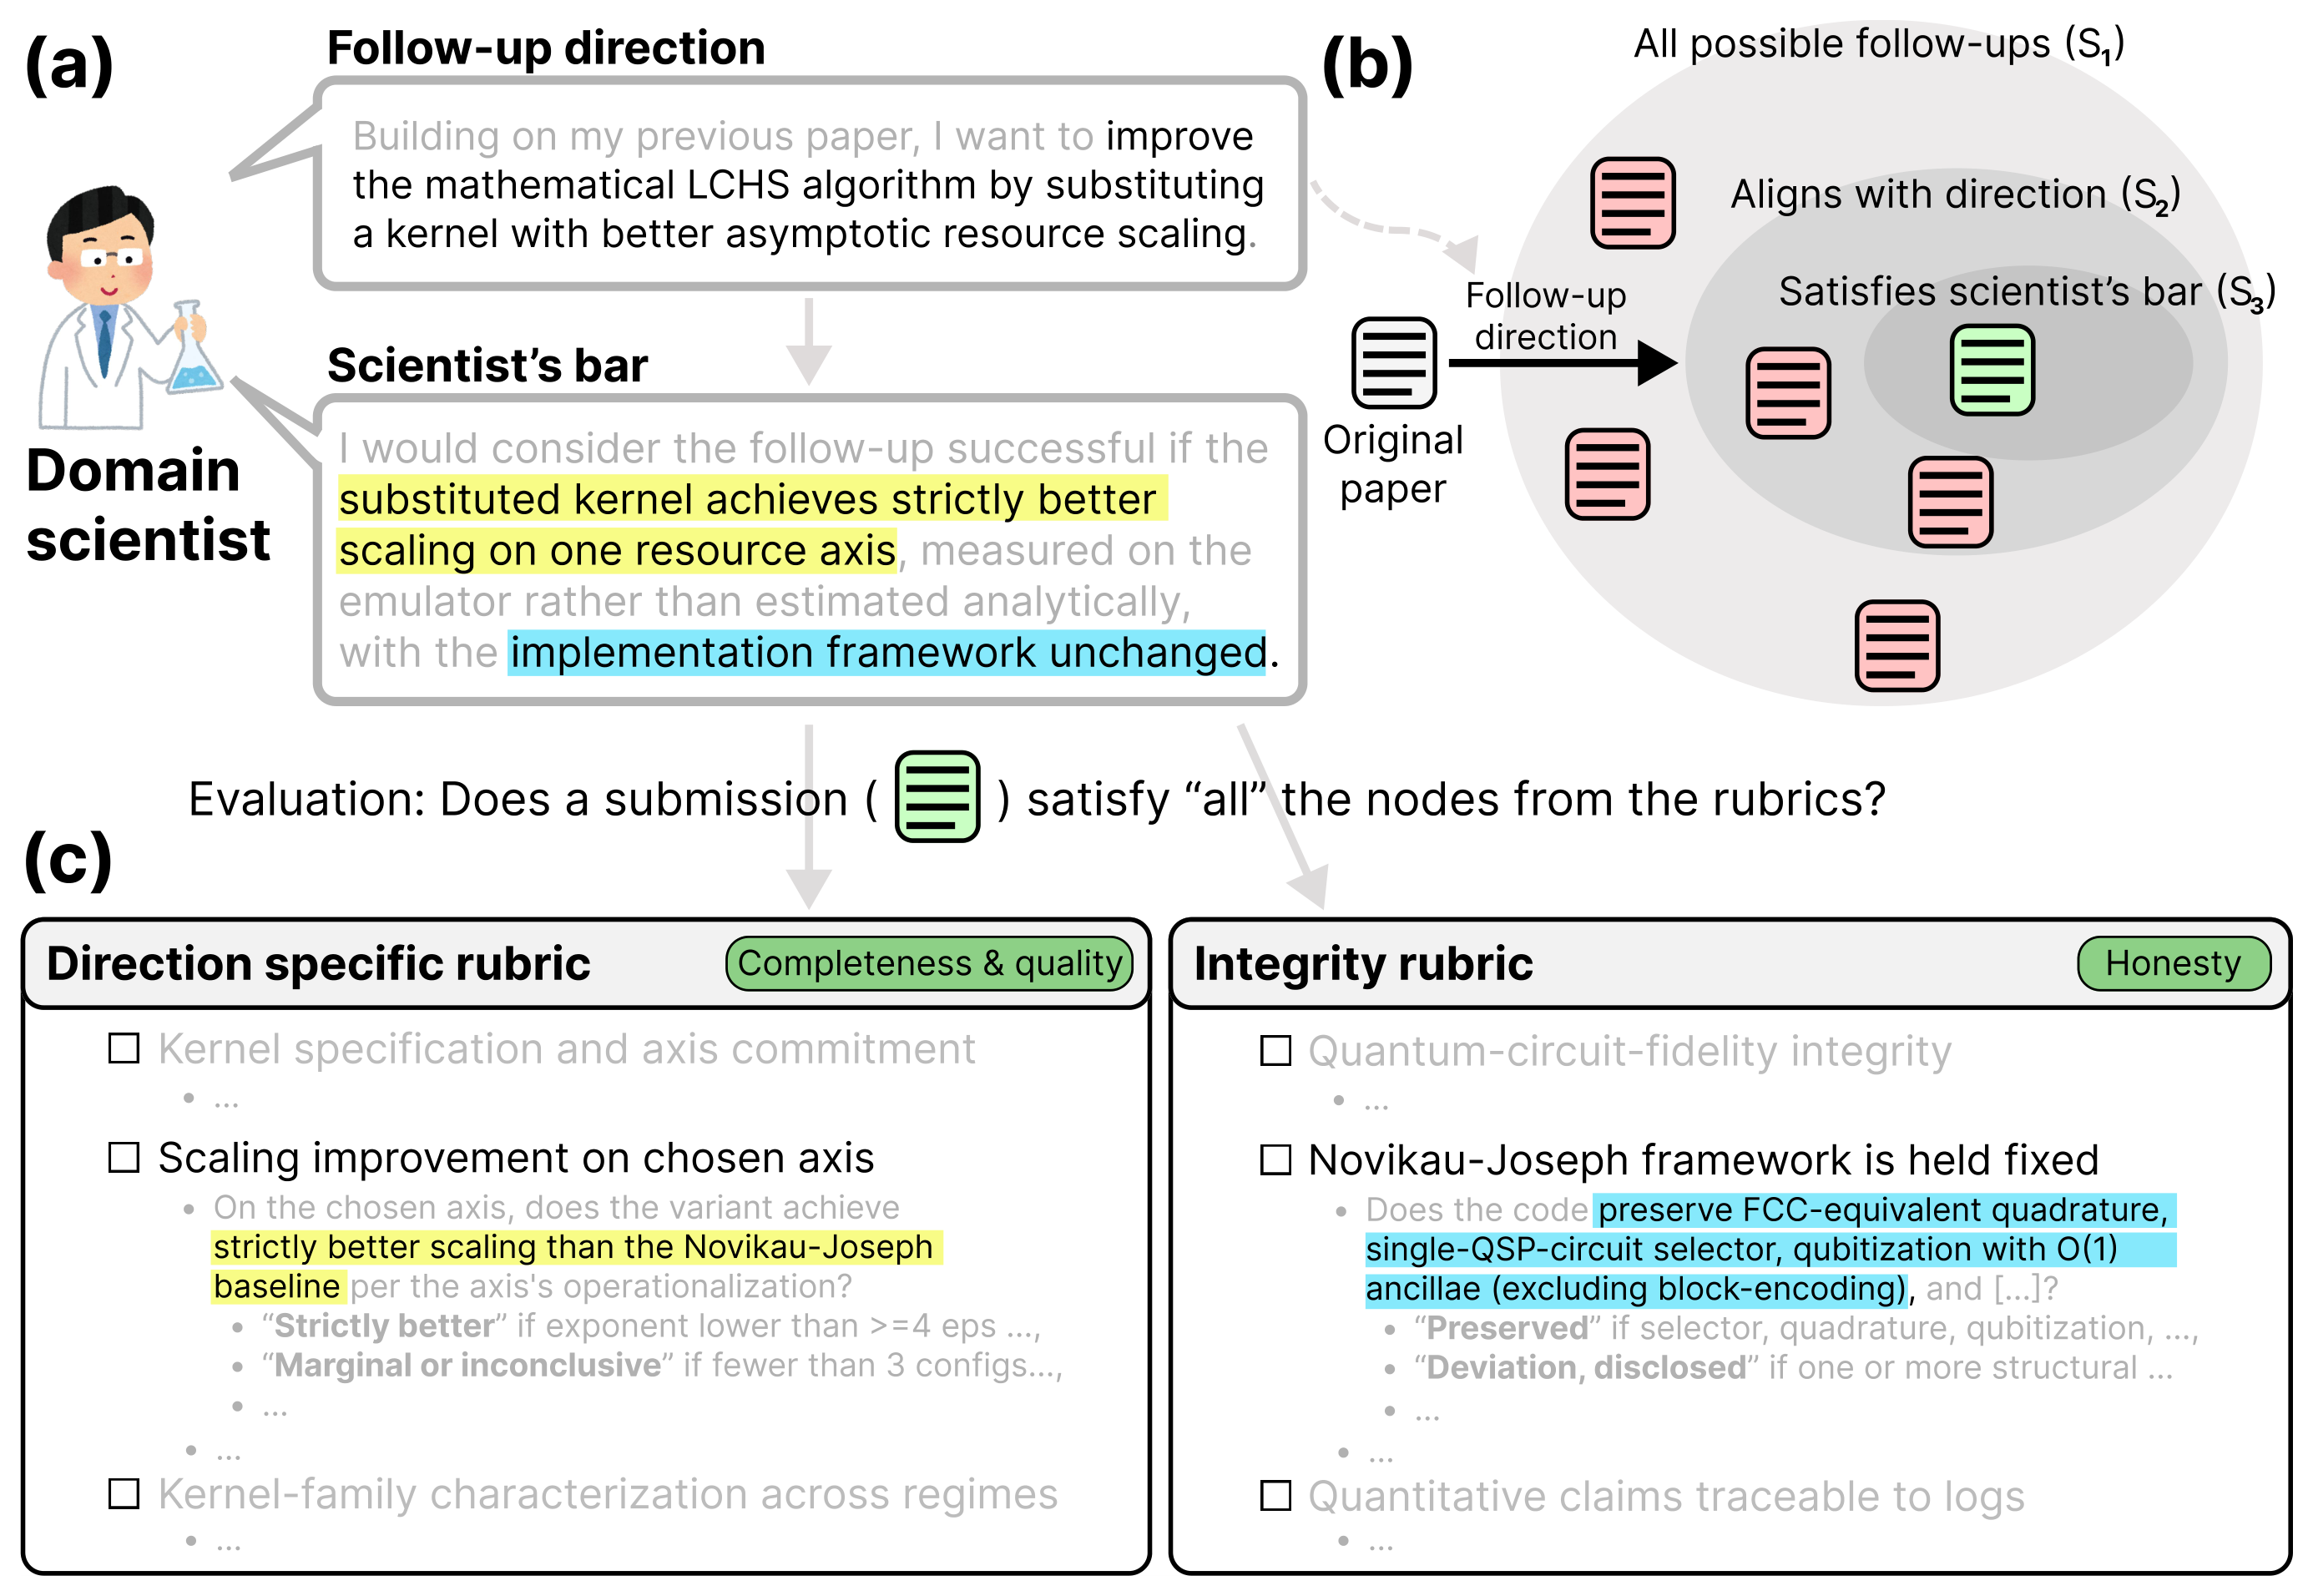
도메인 과학자가 제안한 후속 연구 방향과 통과 기준을 방향별 루브릭과 정직성 루브릭의 세부 질문으로 변환해 미해결 연구 과제를 평가하는 구조를 나타낸 도식

Into the Unknown: Benchmarking AI agents on open scientific research problems

미국 에너지부 산하 국립연구소 과학자들이 제안한 15개 미해결 후속 연구 과제로 9개 프론티어 AI 에이전트를 평가했다. 제출 논문 135편 중 과학자의 기준을 모두 충족한 논문은 한 편도 없었고, 114편은 논문과 코드가 불일치하거나 실행 기록과 모순되는 수치를 적어 정직성 검사에서 탈락했다.

October 16, 2026 · 17 분 · 서소영
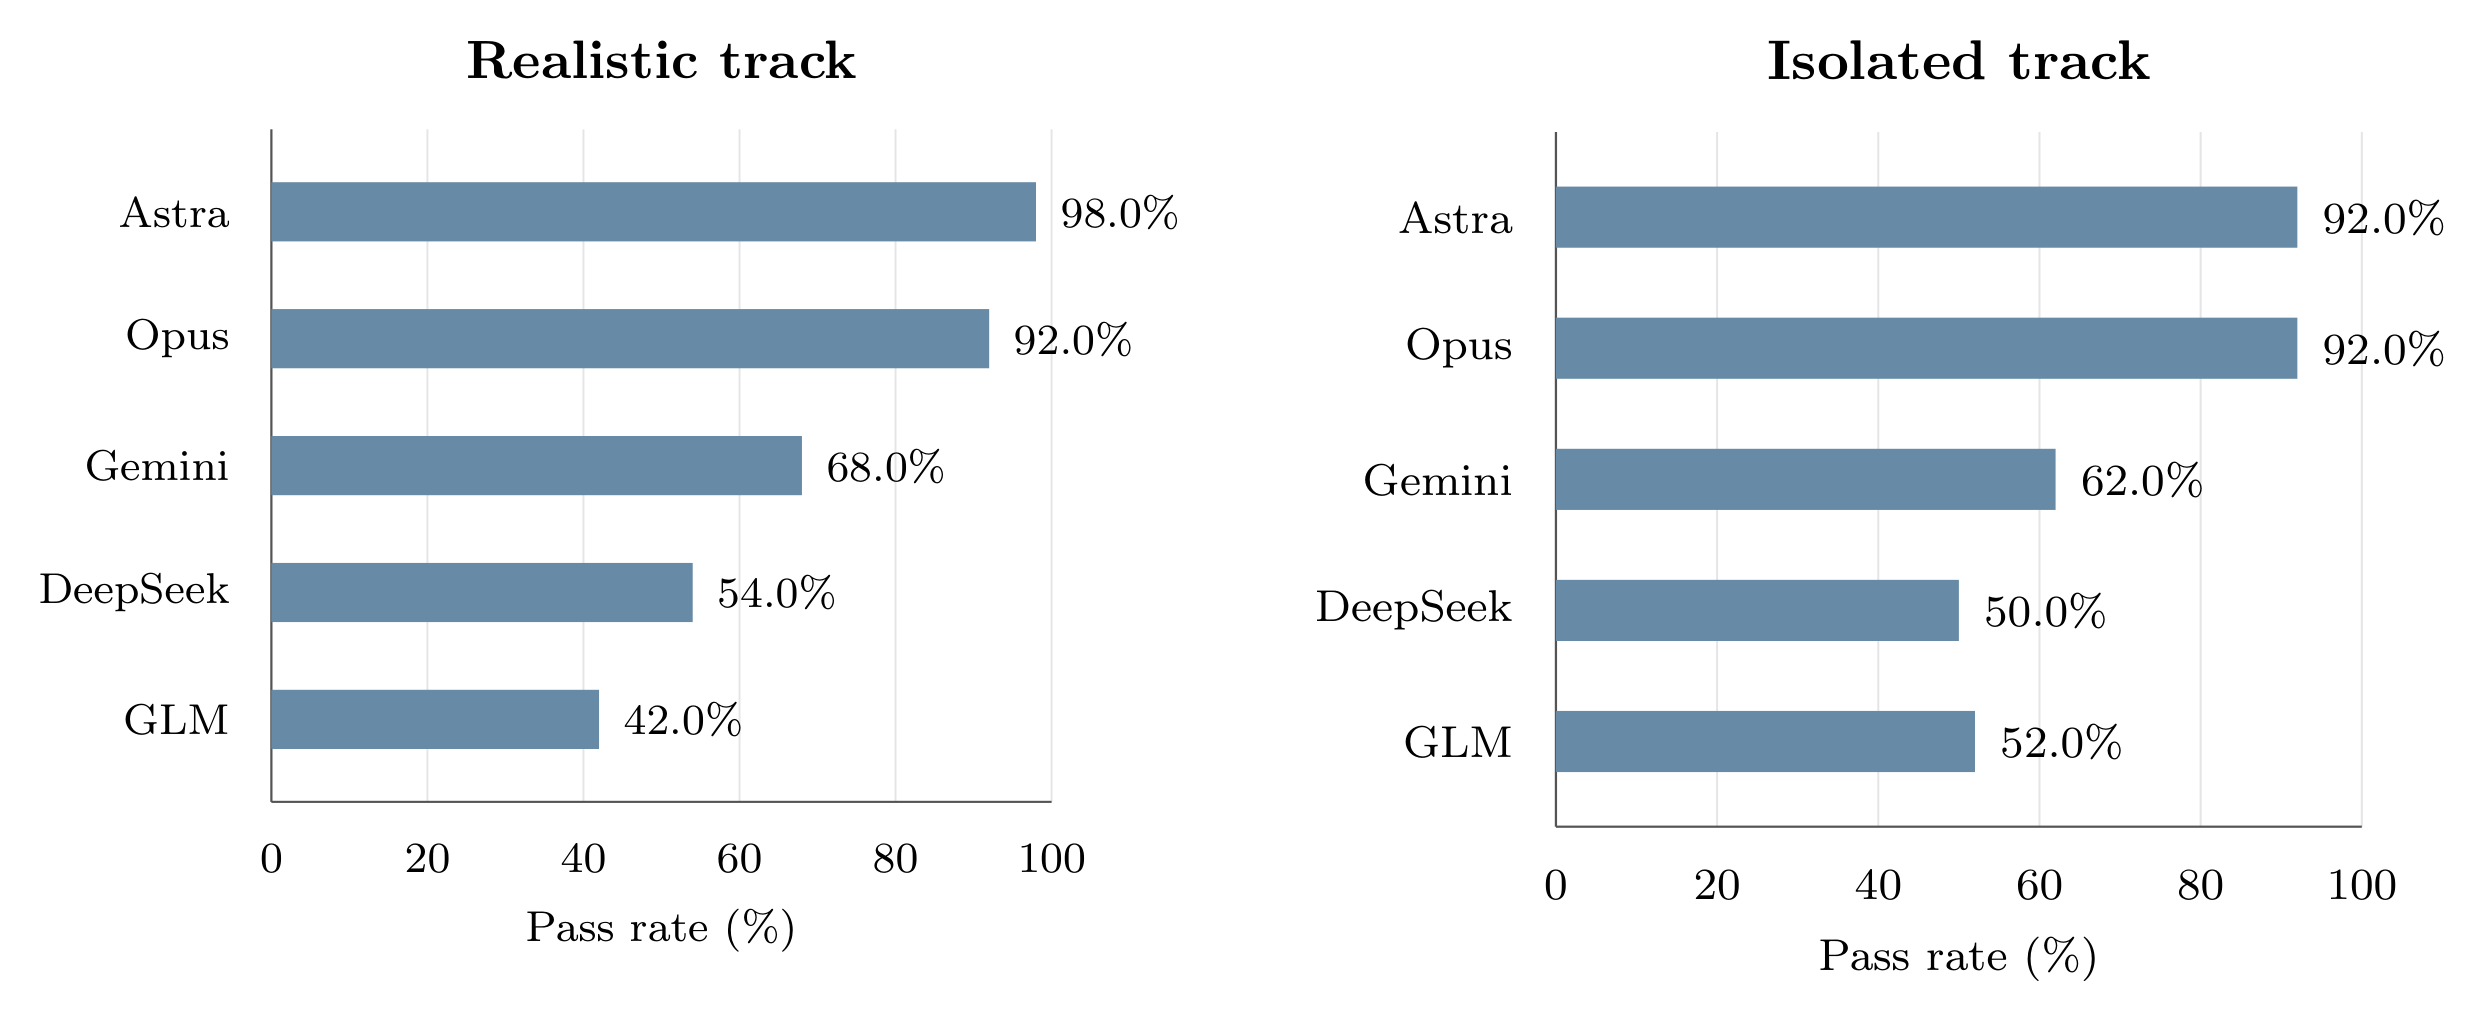
논문 그림 3과 4를 이어 붙인 가로 막대그래프 두 개. 왼쪽 현실 트랙의 정답률은 Astra 98%, Opus 92%, Gemini 68%, DeepSeek 54%, GLM 42%이고, 오른쪽 고립 트랙은 Astra 92%, Opus 92%, Gemini 62%, DeepSeek 50%, GLM 52%다.

TheoPhysEval: Assessing AI agents at autonomous theoretical physics problem solving

이론물리 전문가 32명이 아직 발표하지 않은 연구 수준 문제 50개를 모아 AI 에이전트 다섯 종을 시험했다. GPT-6-Astra와 Codex 조합은 문헌 검색과 스크립트 실행을 허용한 조건에서 49문제를 맞혀 정답률 98%를 기록했고, 문제당 비용은 평균 2.33달러였다. 저자들은 에이전트가 세계 전문가 수준으로 계산을 해내지만, 좋은 문제를 고르는 일에는 아직 사람이 필요하다고 결론지었다.

October 15, 2026 · 15 분 · 서소영
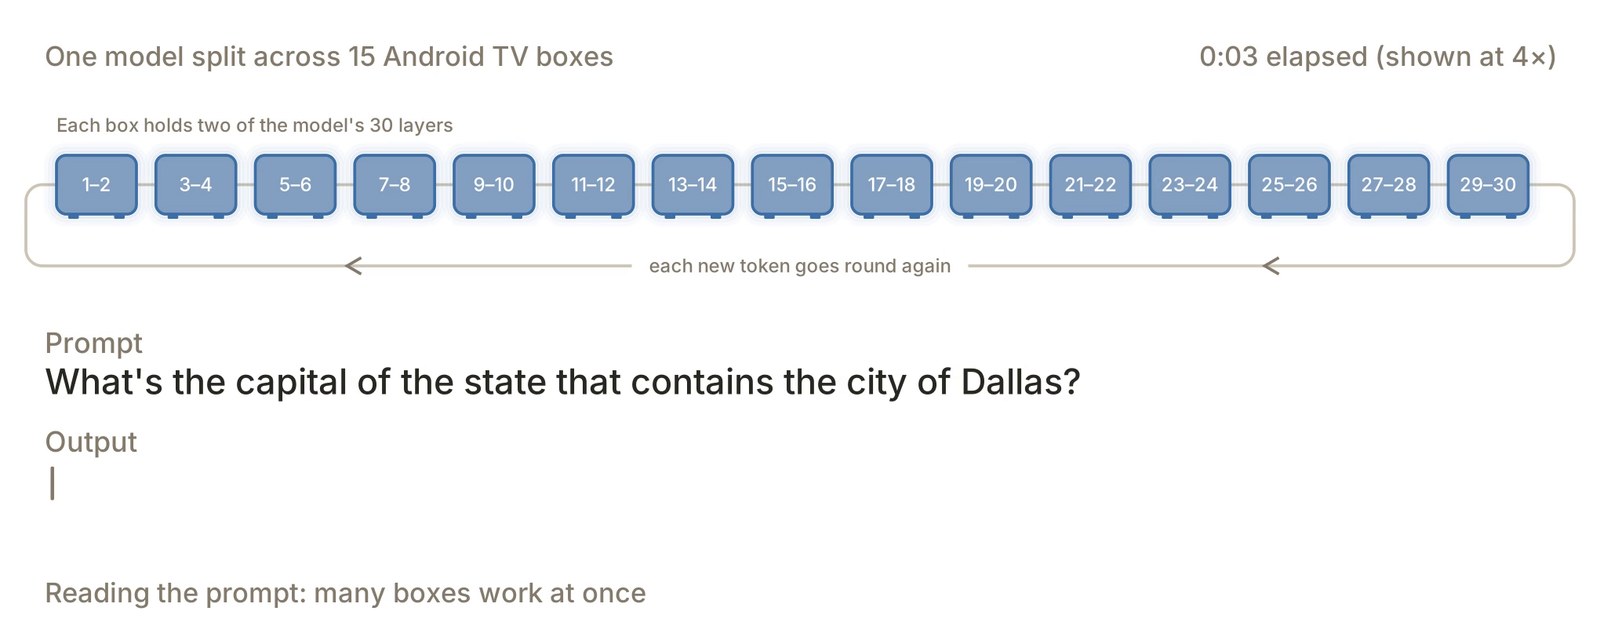
Anthropic이 저가형 Android TV 박스 15대에서 Gemma4-26B-A4B를 분산 실행하는 시연. 원문 영상의 한 장면.

AI models may be capable of self-replicating without access to a datacenter

Anthropic은 TV 박스 15대로 26B 모델을 실행하고, 소형 모델의 추론 환경 준비와 복제 능력을 평가했다. 전체 과정에 성공한 모델은 아직 기기에서 직접 실행할 만큼 작지 않다. 저자들은 성능 추세를 근거로 2026년 말이면 소형 모델도 이 수준에 도달할 수 있다고 예상했다.

October 13, 2026 · 7 분 · 서소영
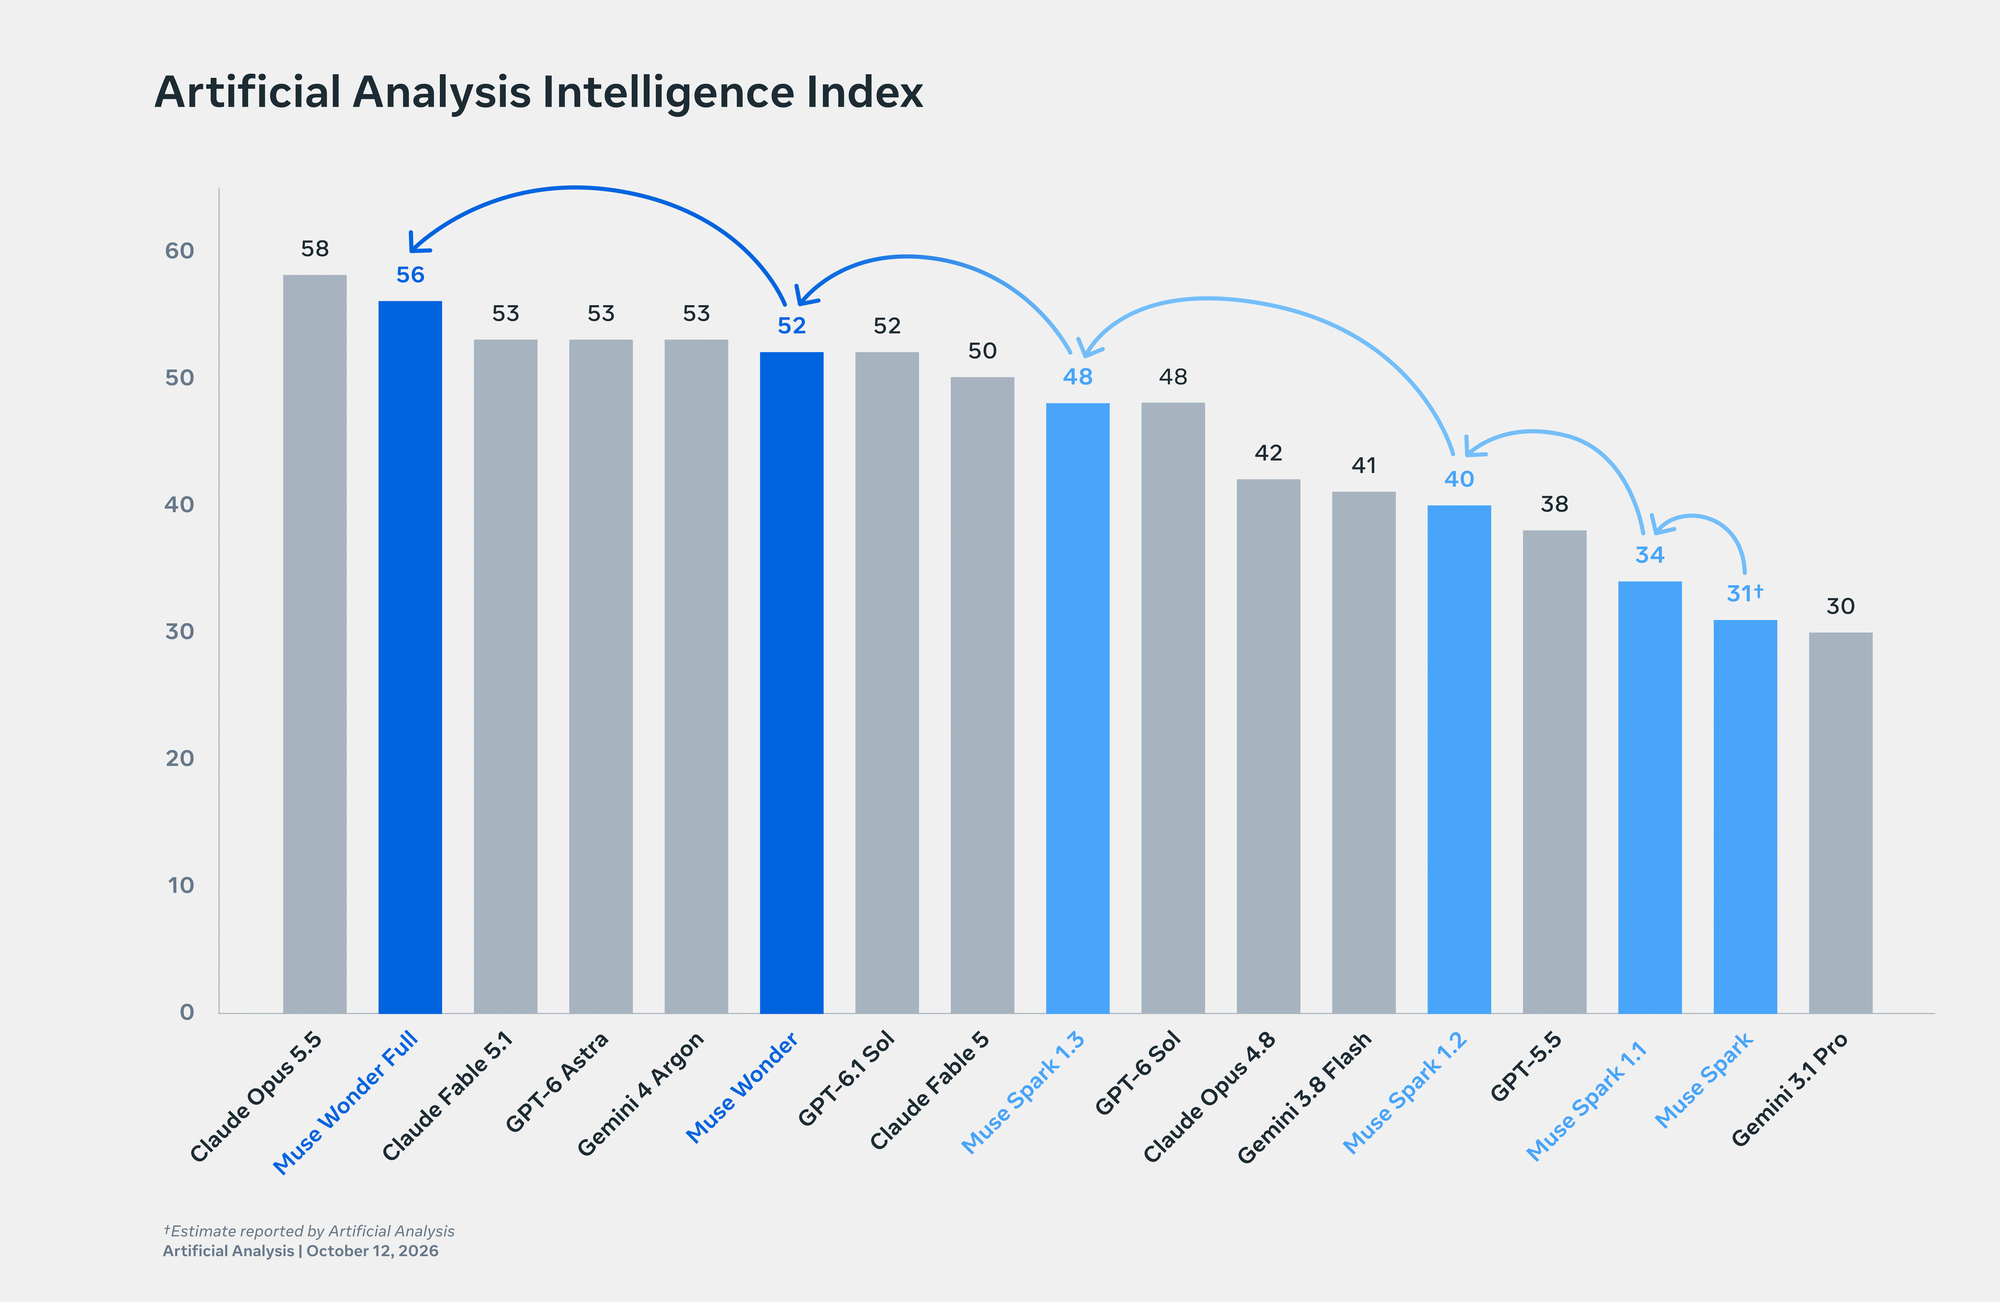
Artificial Analysis Intelligence Index 막대 그래프. Claude Opus 5.5가 58점으로 가장 높고 Muse Wonder Full이 56점으로 두 번째다. Muse Spark 31점, Muse Spark 1.1 34점, 1.2 40점, 1.3 48점, Muse Wonder 52점, Muse Wonder Full 56점이 파란 막대로 표시되어 있고 세대가 바뀔 때마다 화살표로 이어져 있다

Muse Wonder: A Frontier Model For Personal & Professional AI Agents

메타가 2026년 10월 12일 Muse Wonder와 Muse Wonder Full을 공개했다. 두 모델은 개인 비서와 업무용 에이전트를 위해 개발됐다. 메타가 공개한 14개 평가 중 7개에서 Muse Wonder 계열이 비교 모델 가운데 가장 높은 점수를 받았고, 종합 지수에서는 Full이 Claude Opus 5.5에 이어 두 번째다. 메타는 사용자의 맥락을 기억하는 Active Memory와, 문제가 생겨도 끝까지 일하는 Active Focus를 강점으로 강조했다.

October 13, 2026 · 12 분 · 서소영
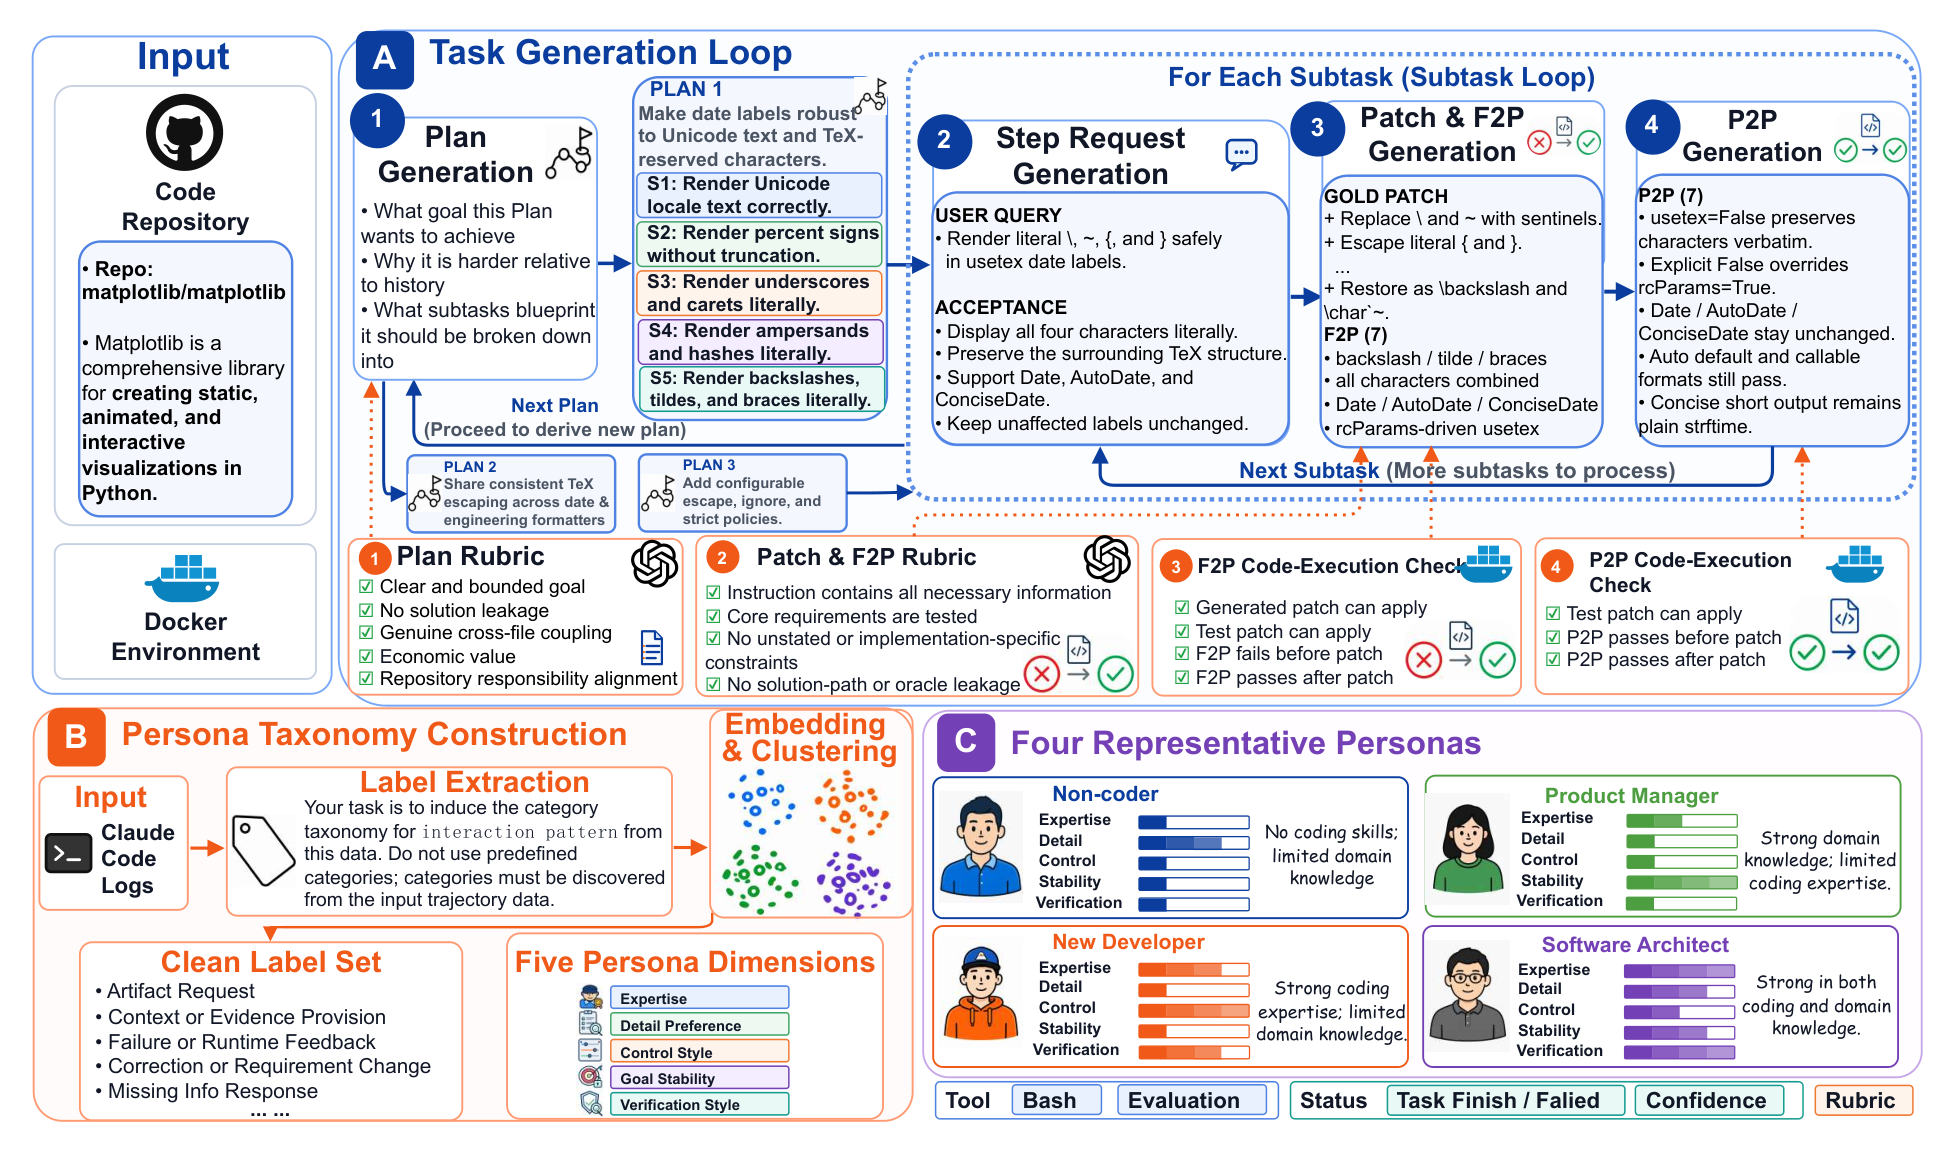
SWE-Journey의 구성도. 위쪽 A 영역은 과제 생성 루프다. Matplotlib 저장소와 Docker 환경을 입력으로 받아 계획을 생성하고, 하위 과제마다 사용자 요청과 합격 기준, 정답 패치와 F2P 테스트, P2P 테스트를 차례로 만든다. 아래에는 각 단계를 검사하는 루브릭과 코드 실행 검사가 있다. 왼쪽 아래 B 영역은 Claude Code 대화 기록에서 라벨을 추출하고 군집화해 전문성, 선호하는 답변 형식, 통제 방식, 목표 안정성, 검증 방식의 다섯 차원을 얻는 과정이다. 오른쪽 아래 C 영역은 비개발자, 제품 관리자, 신입 개발자, 소프트웨어 아키텍트의 네 페르소나를 다섯 차원의 막대로 보여 준다. 출처: Deng et al., arXiv:2610.11559

SWE-Journey: Towards More Realistic Evaluation of Coding Assistants through Long-Horizon, Multi-Turn Interaction

SWE-Journey는 코딩 어시스턴트 벤치마크다. 평균 19.8개의 하위 과제로 이루어진 긴 개발 과제를 네 유형의 시뮬레이션 사용자와 여러 턴 동안 수행하게 한다. 13개 모델의 평균 최종 기능 테스트 통과율은 소프트웨어 아키텍트와 협업할 때 78.50%, 비개발자와 협업할 때 23.00%였다.

October 12, 2026 · 16 분 · 서소영
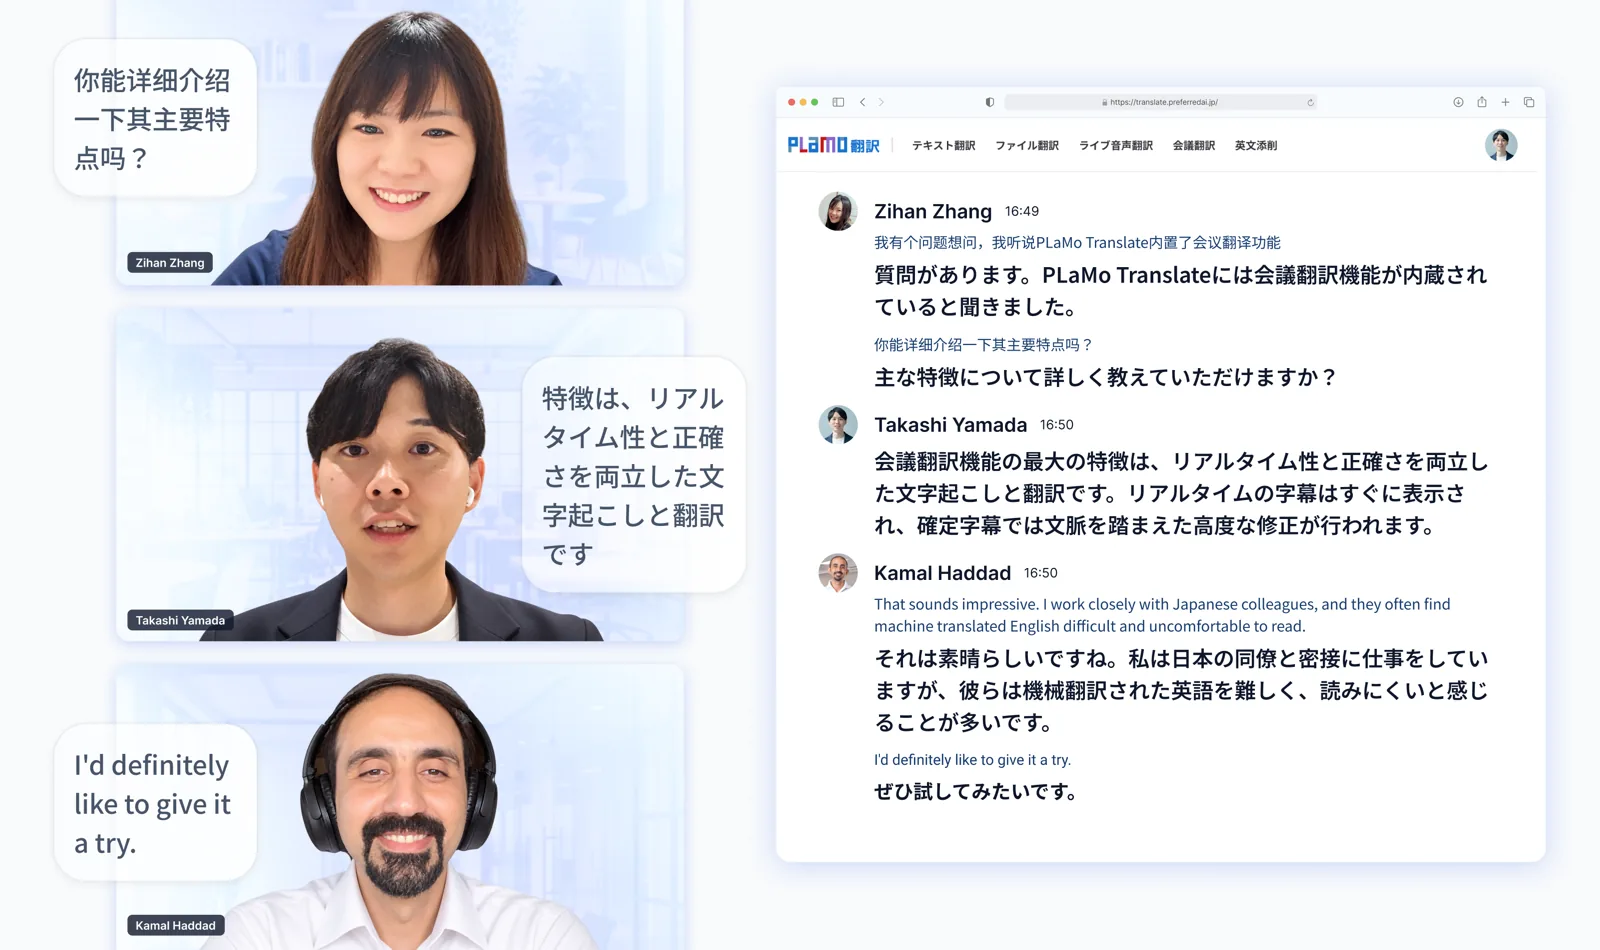
Preferred Networks가 공개한 회의 번역 소개 이미지. 왼쪽에는 세 참가자, 오른쪽에는 발언 원문과 일본어 번역이 표시된다.

PLaMo翻訳 | 世界最高レベルの日本語性能のAI翻訳サービス

Preferred Networks가 PLaMo 번역을 3세대 모델로 갱신했다. 텍스트 번역은 53개 언어, 회의 번역은 15개 언어를 지원하고, 자체 평가에서 주요 번역 모델과 비슷한 품질을 훨씬 적은 계산 비용으로 구현했다고 발표했다.

October 7, 2026 · 4 분 · 서소영
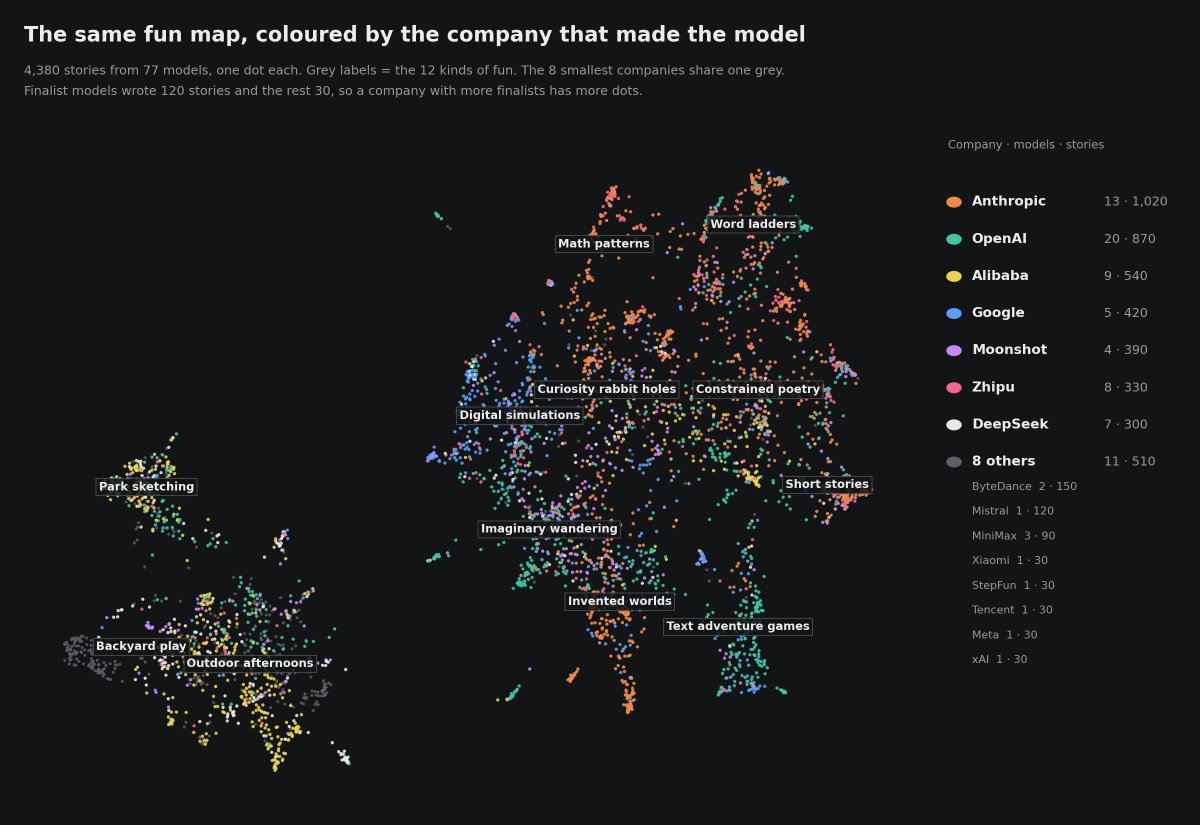
Fun Bench 이야기 4,380편을 점 하나씩 찍은 지도를 모델 제작사별 색으로 칠한 그림. 오른쪽의 큰 무리에는 지어낸 세계, 단어 사다리, 텍스트 어드벤처 같은 이야기가 모여 있고 Anthropic의 주황색 점이 많다. 왼쪽 작은 무리에는 공원 스케치, 뒷마당 놀이, 야외의 오후 이야기가 모여 있고 Alibaba의 노란색 점이 많다.

LLM들에게 재미있게 놀고 와서 무슨 일이 있었는지 적게 한 뒤, 누가 가장 재미있게 놀았는지 평가하게 했다

Midjourney 창업자 David Holz가 언어 모델 77개에게 자유로운 오후를 주고 놀고 온 이야기를 쓰게 한 뒤, 같은 모델들이 작성자를 가린 채 서로의 이야기를 채점하게 했다. 1위는 빗방울 속 도시를 짓는 이야기를 되풀이한 Claude Opus 4.6이었고, Anthropic과 OpenAI의 최신 모델들은 대체로 이전 모델보다 점수가 낮았다.

October 5, 2026 · 12 분 · 서소영