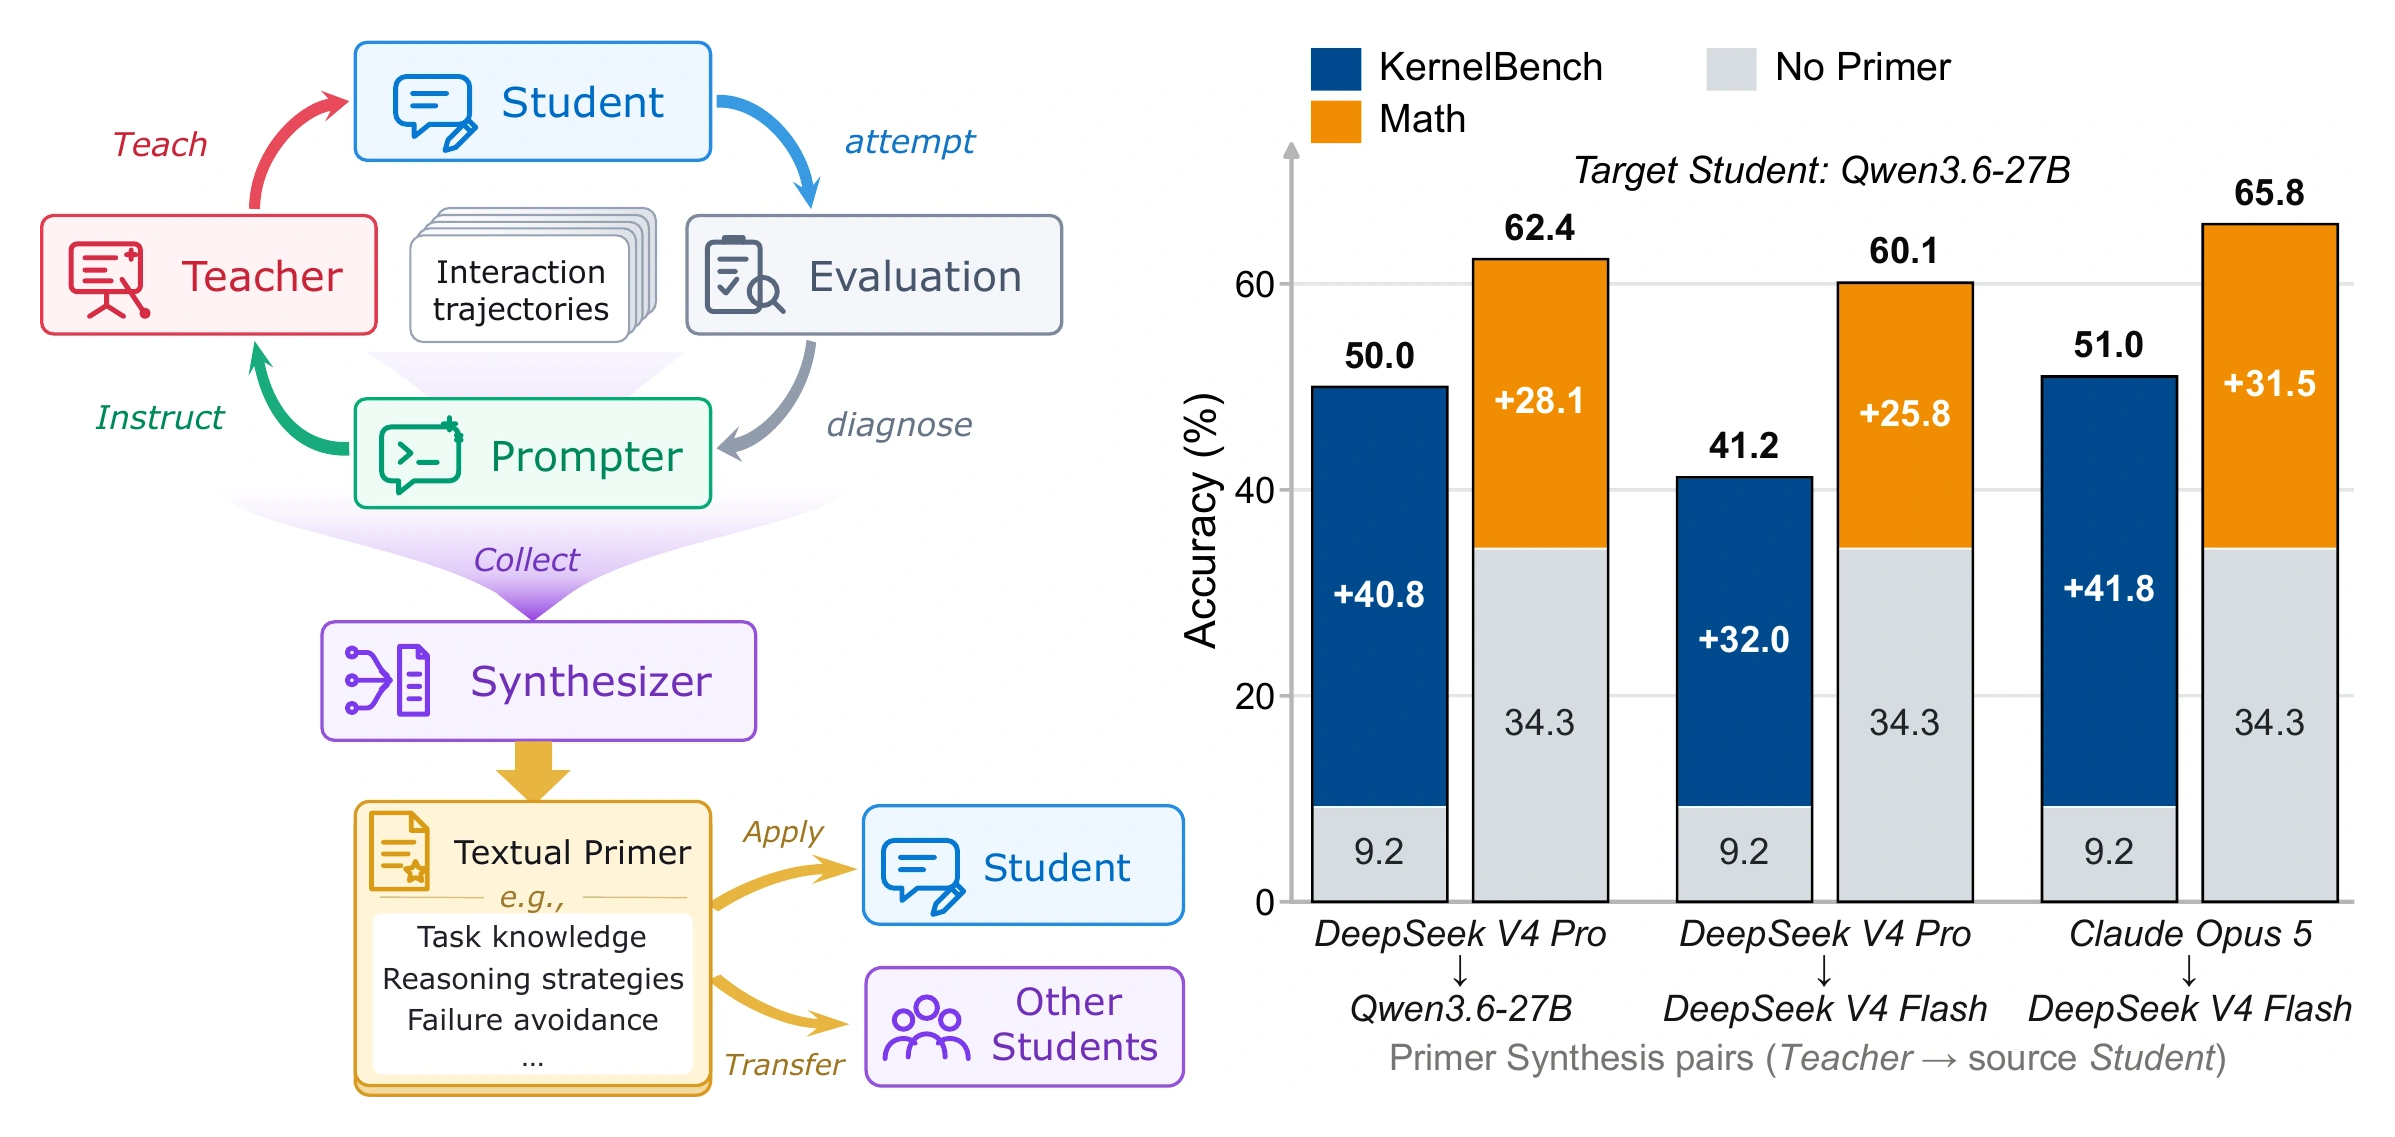
논문의 그림 1. 왼쪽에는 UTT의 순환이 그려져 있다. 학생이 문제를 풀면 Prompter가 채점 결과를 진단해 선생에게 지시하고, 선생이 학생을 가르친다. Synthesizer는 이 기록을 모아 Primer를 만들고, Primer는 원래 학생과 다른 학생들에게 적용된다. 오른쪽 막대그래프는 세 조합에서 만든 Primer를 Qwen3.6-27B에 적용한 정확도다. KernelBench는 9.2%에서 41.2%와 51.0% 사이로, 수학은 34.3%에서 60.1%와 65.8% 사이로 올랐다. 출처: Lu & Wang, arXiv:2610.12114

Universal Textual Teaching for LLMs

웨스트레이크 대학교 연구진은 강한 모델이 맞히고 약한 모델이 틀린 문제에서 얻은 교훈을 Primer라는 자연어 안내문으로 정리해 약한 모델에게 전달하는 방법 UTT를 제안했다. 약한 모델의 가중치는 학습시키지 않는다. Primer를 받은 DeepSeek V4 Flash의 KernelBench 정확도는 9.4%에서 48.6%로, 올림피아드 수학 정확도는 27.6%에서 51.7%로 올랐고, 합성에 참여하지 않은 다른 학생 모델도 같은 Primer로 점수가 올랐다.
October 13, 2026 · 16 분 · 서소영
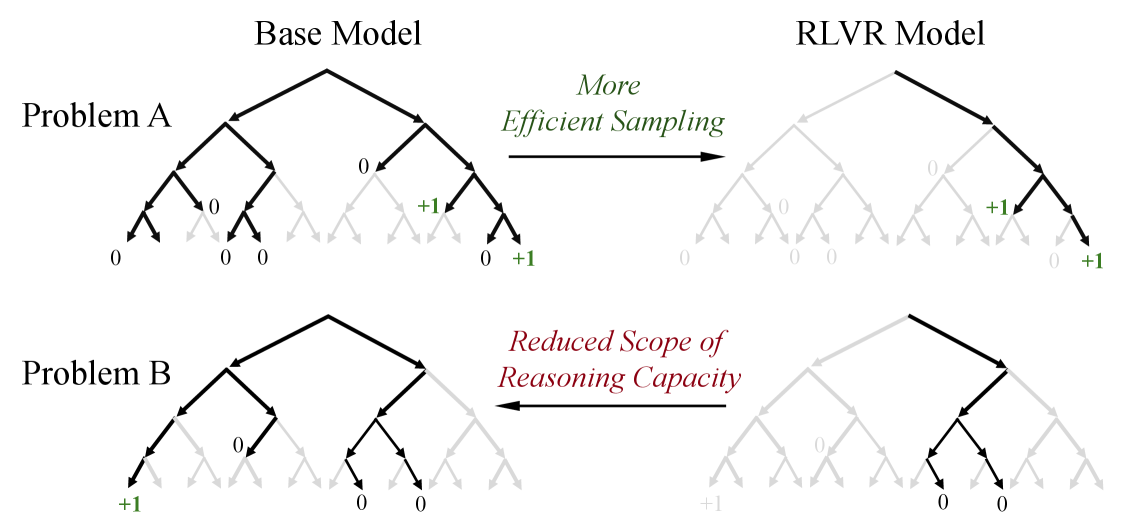
베이스 모델과 RLVR 모델의 탐색 트리 비교 도식. 문제 A에서는 RLVR이 보상받은 경로 쪽으로 분포를 몰아 샘플링 효율을 높이지만, 문제 B에서는 베이스 모델에 있던 정답 경로가 RLVR 모델에서 사라진다.

Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?

칭화대 LeapLab과 상하이교통대 연구진이 검증 가능한 보상 기반 강화학습(RLVR)의 효과를 pass@k로 다시 측정한 논문. k가 작을 때는 RLVR 모델이 앞서지만 k를 키우면 베이스 모델이 역전하며, RLVR이 쓰는 추론 경로는 이미 베이스 모델의 분포 안에 들어 있었다.

September 18, 2026 · 10 분 · 서소영
치비 서소영이 손바닥만 한 작은 로봇을 들어 올려 커다란 코끼리에게 쪽지를 건네게 하고, 코끼리가 구불구불한 길 대신 바닥에 그려진 짧은 직선 경로를 따라 걷는 라인아트

Training a 4B model to produce 81% faster query plans than Postgres

4B 오픈웨이트 모델을 오프폴리시 증류와 에이전틱 RL로 후학습시켜 Postgres의 기본 쿼리 플랜보다 빠른 플랜을 만들게 한 개인 실험 기록이다. 조인 순서 벤치마크 113개 질의에서 기하평균 1.81배 speedup을 얻었고, 들어간 돈은 모두 1,200달러였다.

September 17, 2026 · 17 분 · 서소영
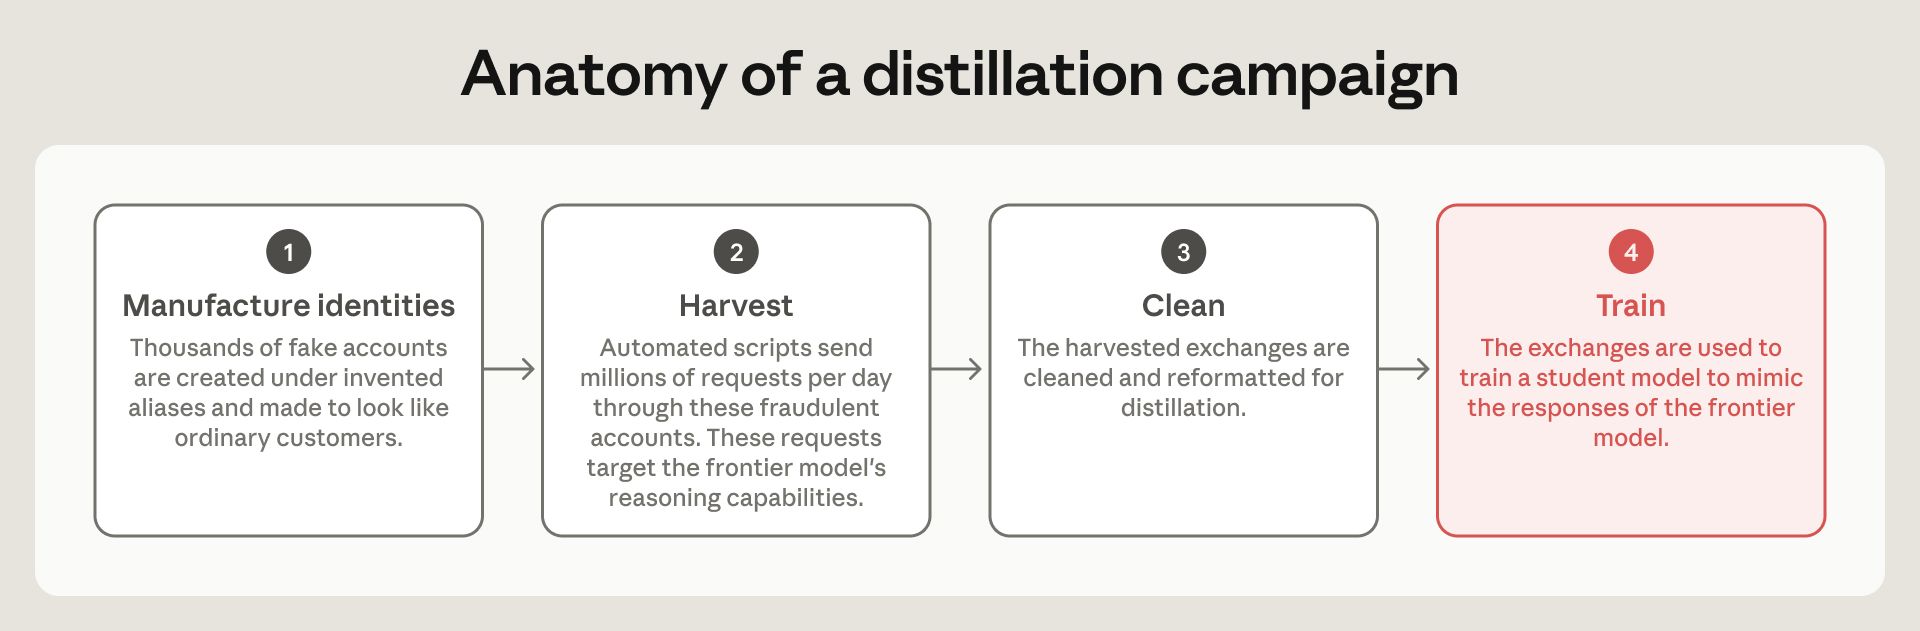
가짜 신원 제조, 수확, 정제, 학습의 네 단계로 불법 증류 캠페인을 그린 Anthropic의 도식

Countering misuse of AI: September 2026

Anthropic이 2025년 12월부터 2026년 8월까지 차단한 Claude 오용 사례를 일곱 갈래로 묶어 공개했다. 사이버 공격과 감시, 여론 조작, 무기 개발에 이르는 사례와 함께, 중국에 자리한 일곱 개 연구소의 증류 캠페인을 실명으로 지목했다.

September 11, 2026 · 16 분 · 서소영

Needle — 26M 함수 호출 전용 모델, FFN을 통째로 들어낸 어텐션 네트워크

Cactus Compute가 Gemini 3.1을 26M 파라미터로 증류한 함수 호출 전용 모델. FFN을 통째로 들어낸 인코더-디코더 ‘Simple Attention Network’와 INT4 QAT, 게이트드 잔차, 토큰 가중 손실 등 작은 모델을 위한 설계 결정을 정리한다.

May 14, 2026 · 6 분 · 서소영