The Universal Weight Subspace Hypothesis
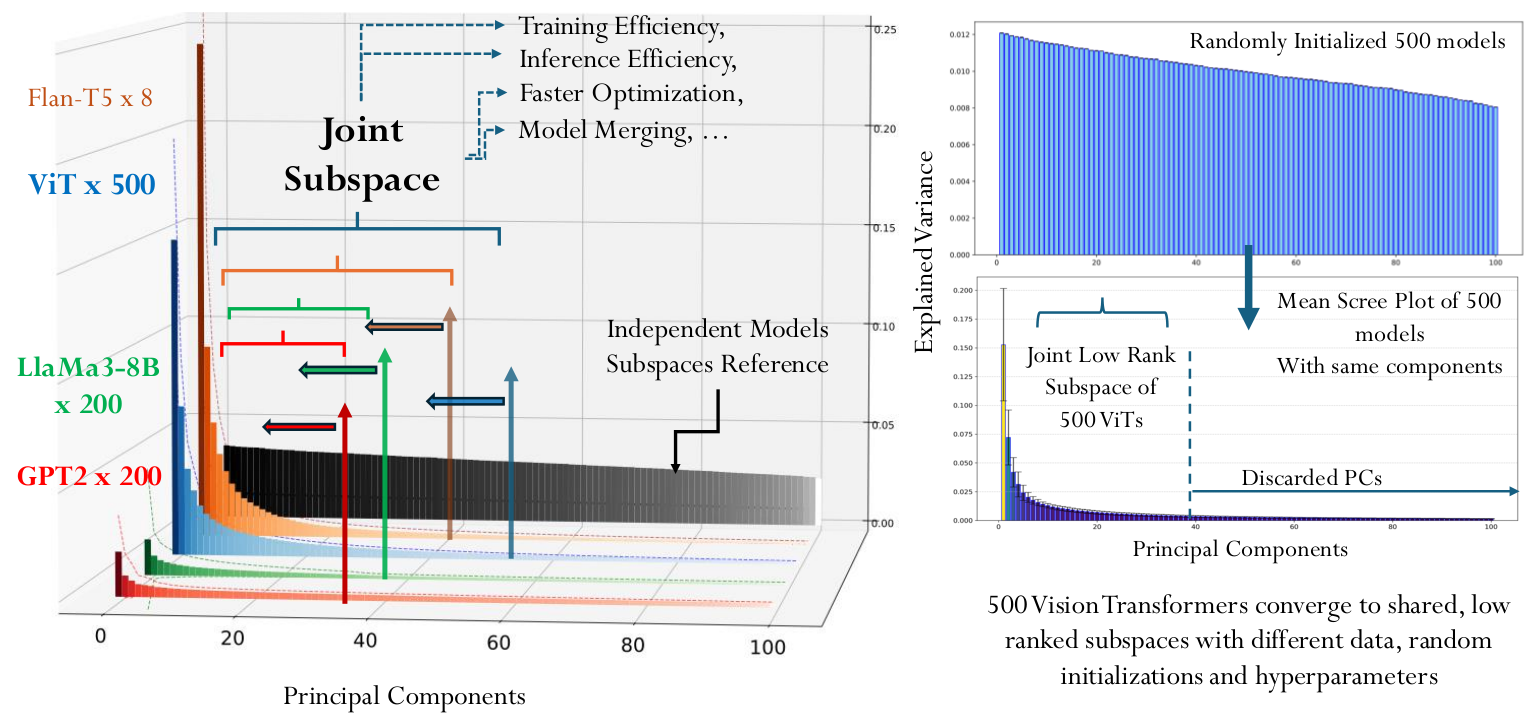
존스홉킨스 연구진은 1,100개가 넘는 공개 모델의 가중치를 층별로 분해했다. 서로 다른 데이터와 초기값으로 학습했어도 구조가 같은 모델은 열여섯 개 안팎의 공통 방향에 분산 대부분이 모였다. ViT 500개는 이 공통 부분공간 하나와 계수로 대신하고, 새 과제는 계수 1만 개만 학습해 풀었다.
존스홉킨스 연구진은 1,100개가 넘는 공개 모델의 가중치를 층별로 분해했다. 서로 다른 데이터와 초기값으로 학습했어도 구조가 같은 모델은 열여섯 개 안팎의 공통 방향에 분산 대부분이 모였다. ViT 500개는 이 공통 부분공간 하나와 계수로 대신하고, 새 과제는 계수 1만 개만 학습해 풀었다.