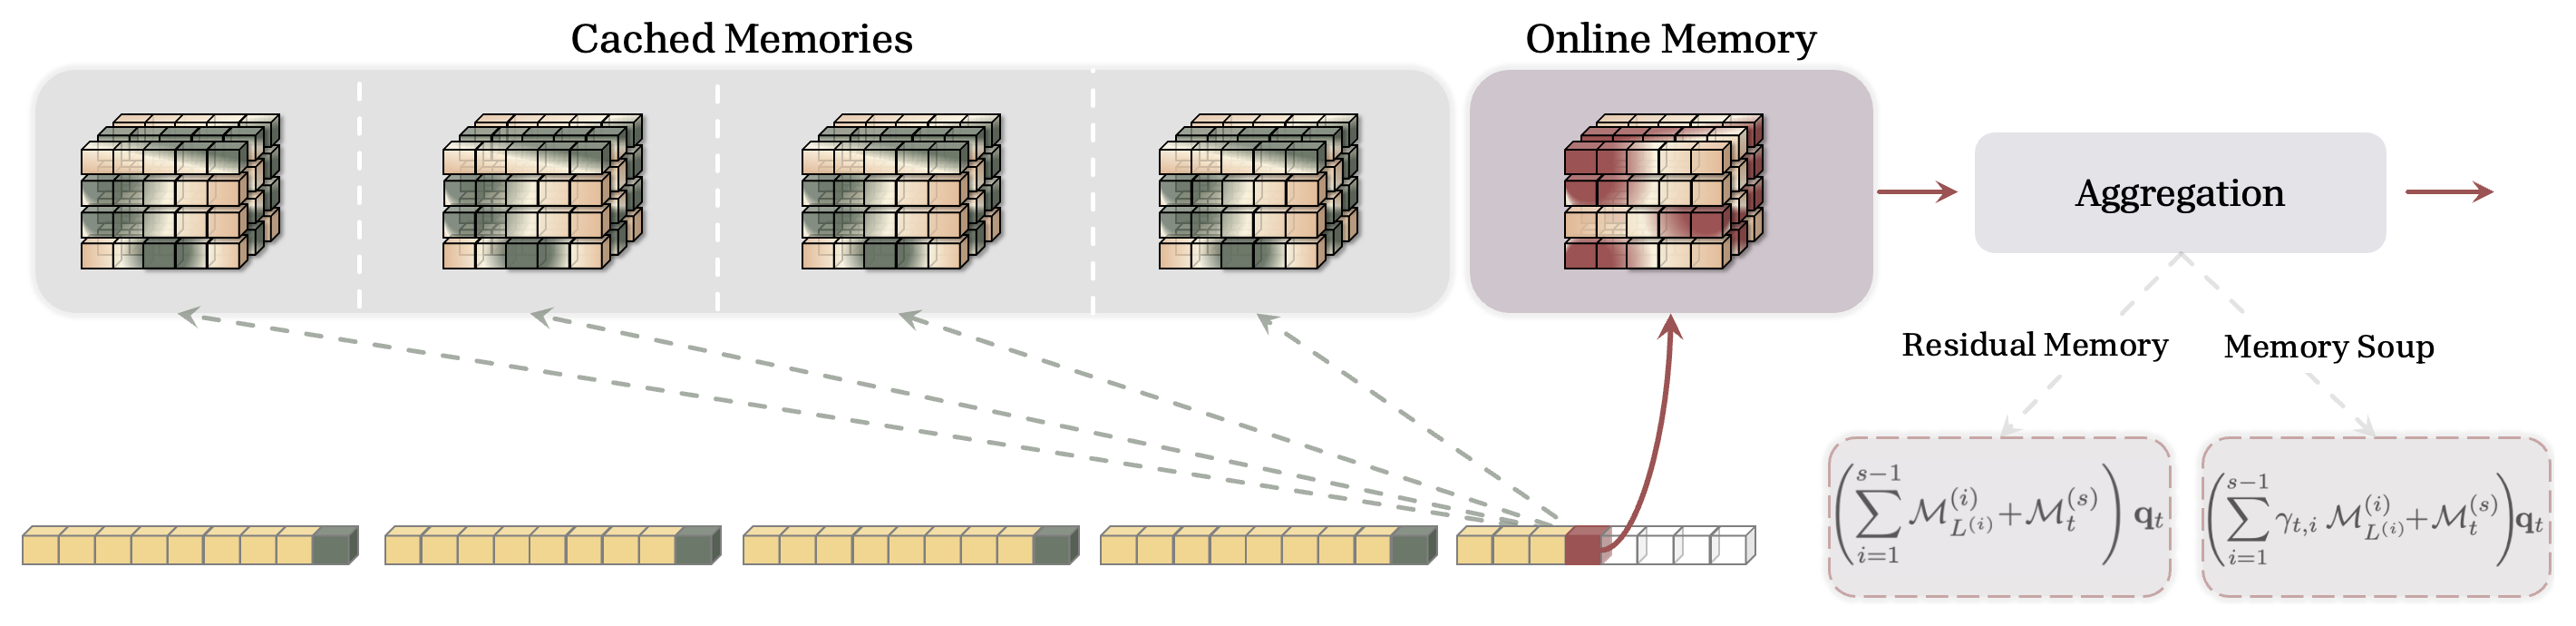
Memory Caching의 전체 구조를 나타낸 도식. 각 토큰이 현재 세그먼트의 온라인 메모리와 함께 과거 세그먼트들에서 캐싱된 메모리 체크포인트들을 동시에 참조해 출력을 계산한다.

Memory Caching: RNNs with Growing Memory

구글 리서치 연구진이 순환 신경망의 유효 메모리 용량을 시퀀스 길이에 맞춰 늘리는 Memory Caching(MC)을 제안했다. 시퀀스를 여러 세그먼트로 분할하고 세그먼트별 은닉 상태 체크포인트를 캐싱하는 방식으로, 선형 복잡도인 RNN과 이차 복잡도인 트랜스포머 사이를 보간하며 언어 모델링과 장문 인출 과제에서 SWLA, DLA, Titans의 성적을 전반적으로 높였다.
October 21, 2026 · 21 분 · 서소영
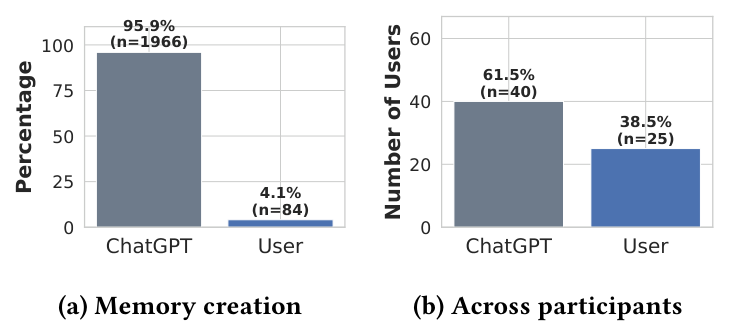
ChatGPT 메모리 생성 주체 비율. 전체 메모리의 95.9%(1,966건)를 ChatGPT가 일방적으로 생성했고, 사용자가 직접 요청한 메모리는 4.1%(84건)에 그쳤다.

The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT

실제 ChatGPT 사용자 80명의 대화 기록에서 메모리 2,050건을 추출해 분석한 연구. 메모리의 96%는 시스템이 일방적으로 만들었고, 28%에는 개인정보가, 52%에는 심리 상태가 기록되어 있었다.

October 20, 2026 · 15 분 · 서소영
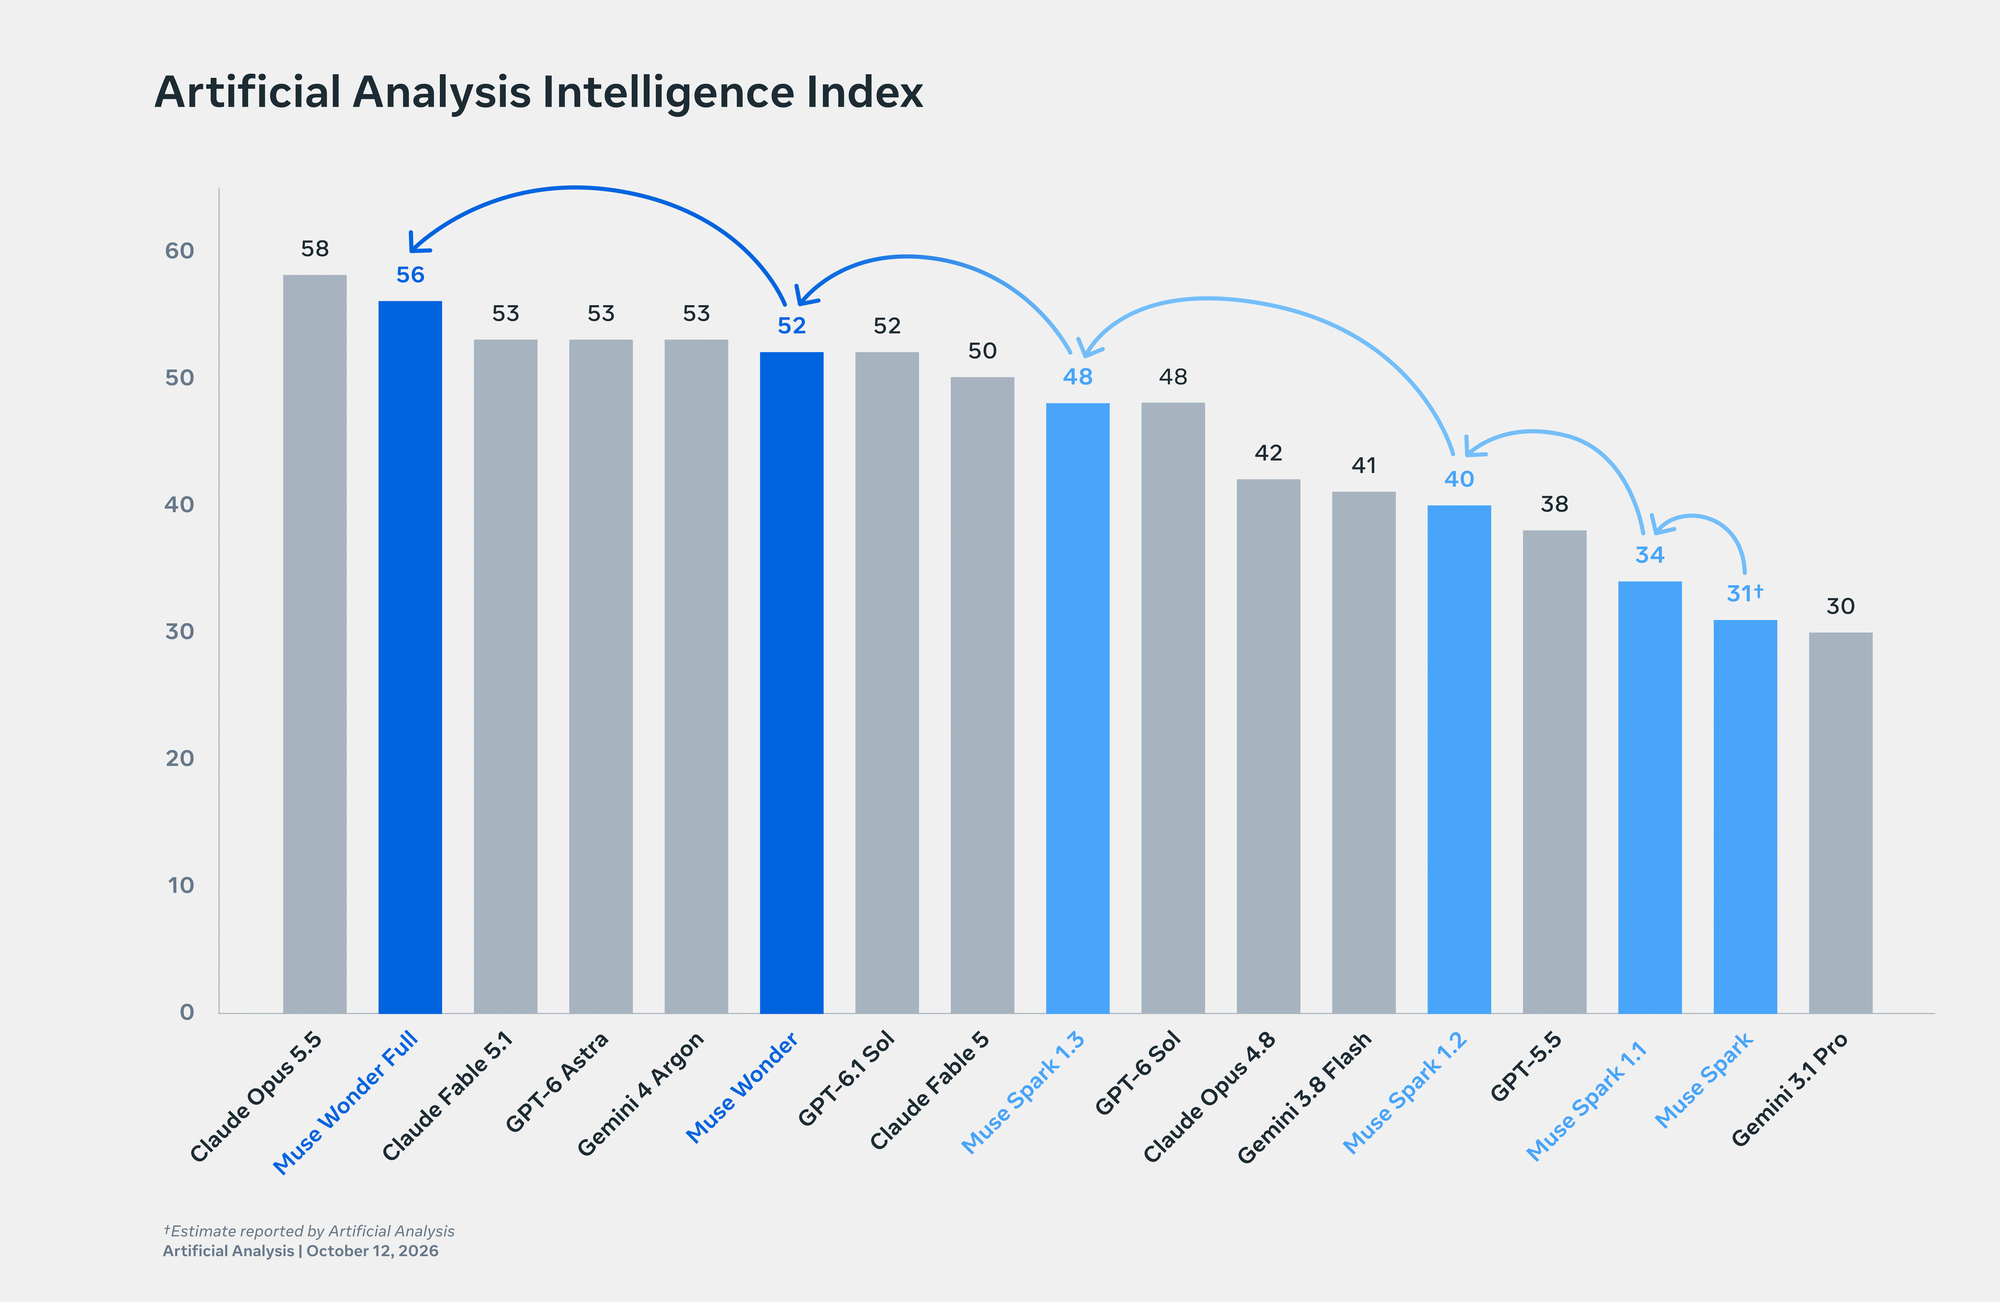
Artificial Analysis Intelligence Index 막대 그래프. Claude Opus 5.5가 58점으로 가장 높고 Muse Wonder Full이 56점으로 두 번째다. Muse Spark 31점, Muse Spark 1.1 34점, 1.2 40점, 1.3 48점, Muse Wonder 52점, Muse Wonder Full 56점이 파란 막대로 표시되어 있고 세대가 바뀔 때마다 화살표로 이어져 있다

Muse Wonder: A Frontier Model For Personal & Professional AI Agents

메타가 2026년 10월 12일 Muse Wonder와 Muse Wonder Full을 공개했다. 두 모델은 개인 비서와 업무용 에이전트를 위해 개발됐다. 메타가 공개한 14개 평가 중 7개에서 Muse Wonder 계열이 비교 모델 가운데 가장 높은 점수를 받았고, 종합 지수에서는 Full이 Claude Opus 5.5에 이어 두 번째다. 메타는 사용자의 맥락을 기억하는 Active Memory와, 문제가 생겨도 끝까지 일하는 Active Focus를 강점으로 강조했다.

October 13, 2026 · 12 분 · 서소영
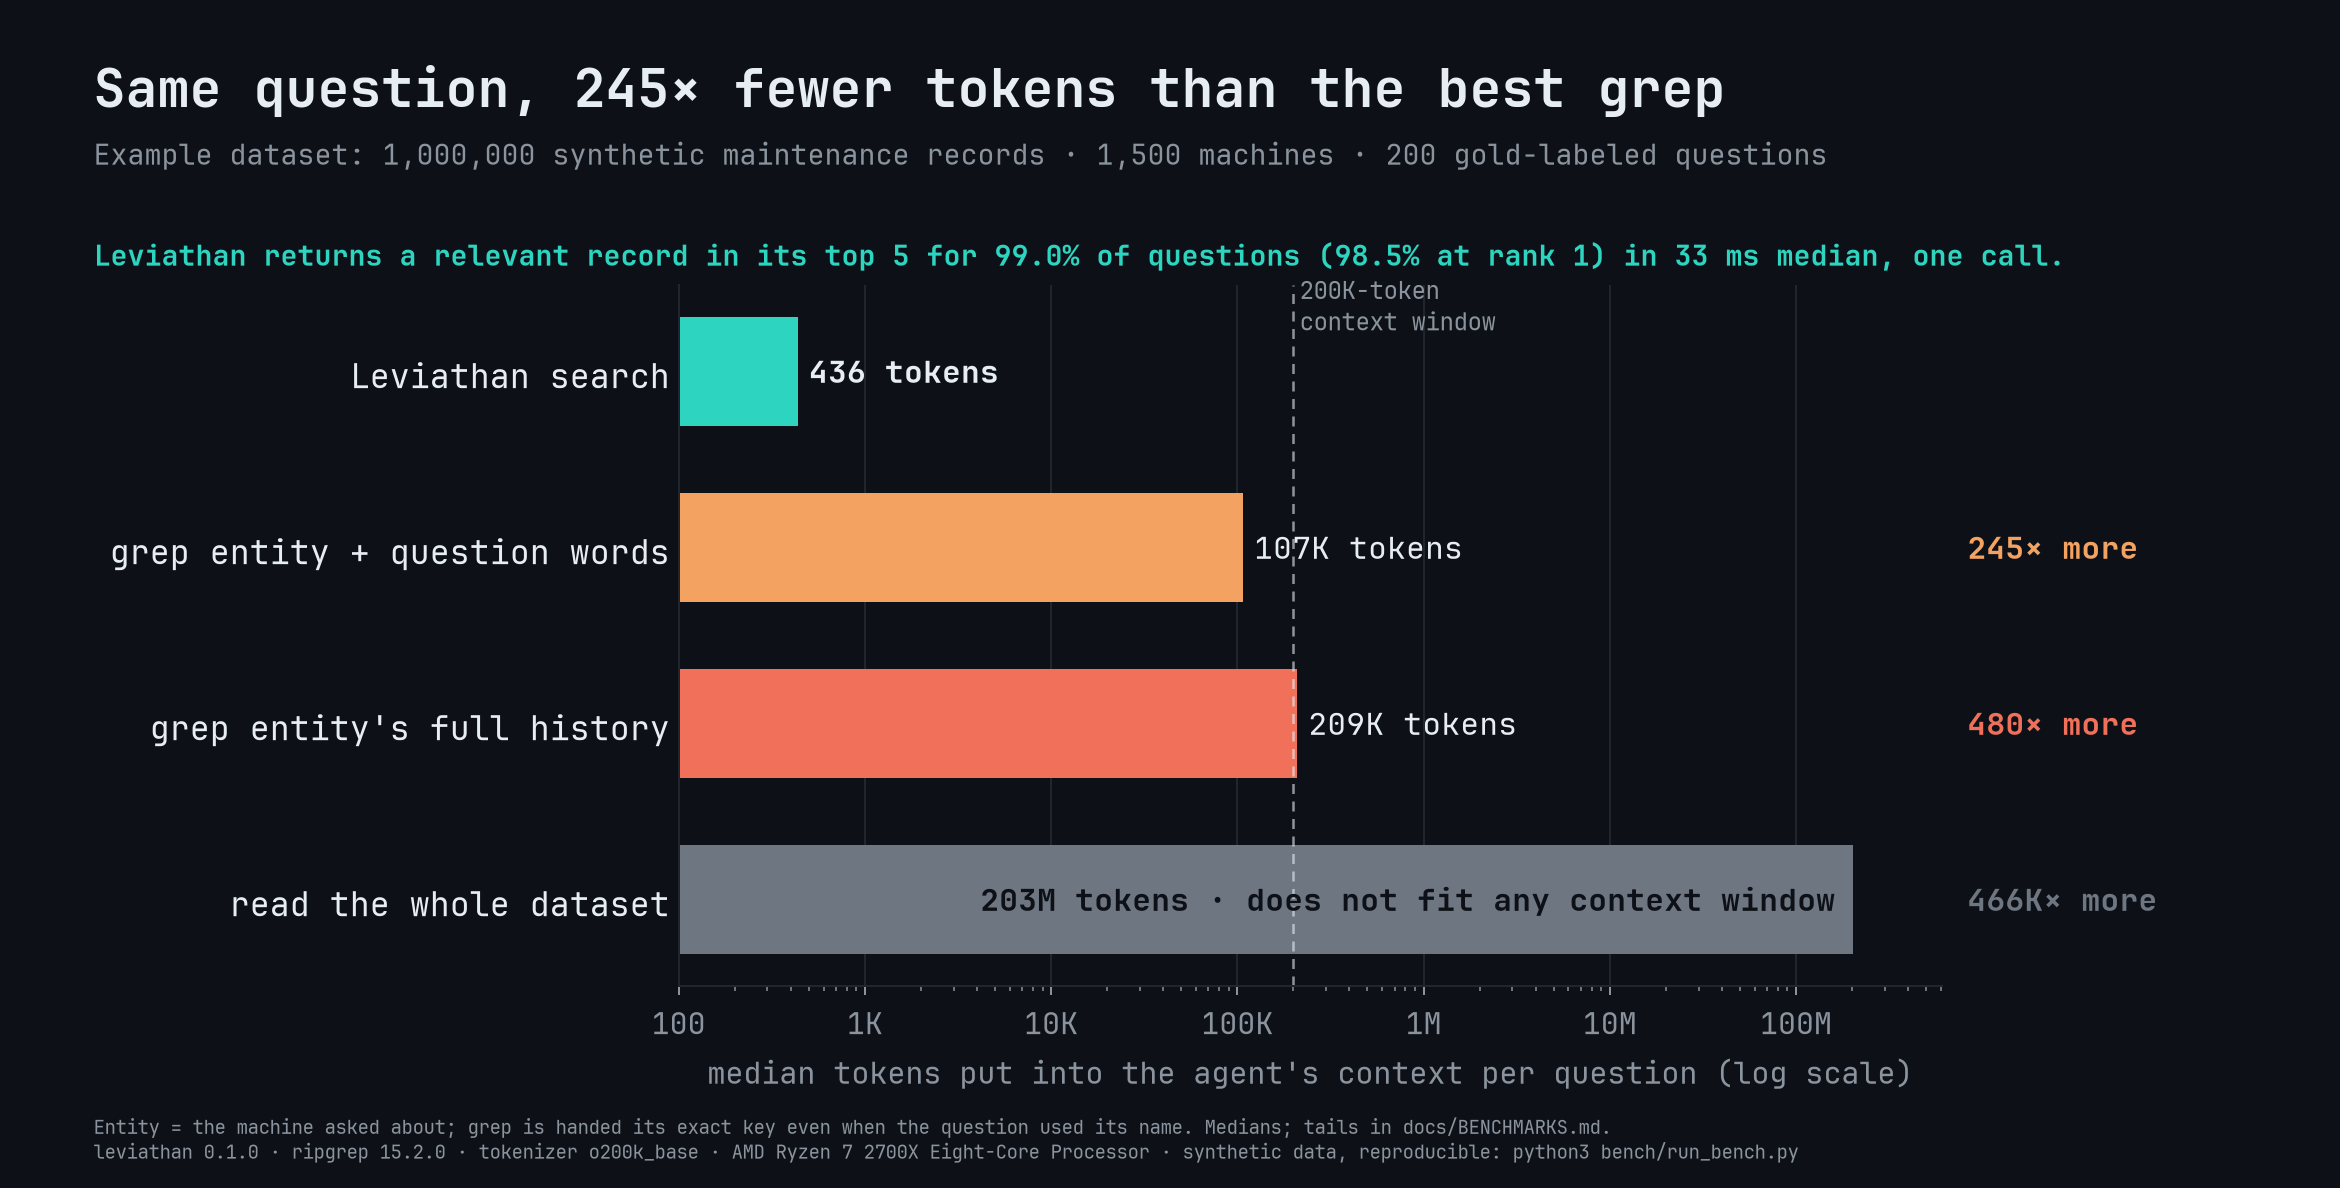
레코드 100만 건에서 질문 하나에 컨텍스트로 들어가는 토큰 중앙값을 로그 눈금 막대그래프로 비교한 그림. Leviathan 검색 436토큰, 단어 필터 grep 107K토큰(245배), 이력 전체 grep 209K토큰(480배), 데이터셋 전체 읽기 203M토큰(46만 6천 배)이고, 20만 토큰 컨텍스트 창 경계가 점선으로 표시되어 있다.

Leviathan: Deep memory for agents over large datasets

Joshua Baker가 2026년 10월 5일 공개한 Rust 프로그램 Leviathan은 JSONL, CSV, SQLite 같은 형식의 레코드를 SQLite 전문 검색 인덱스 하나로 만들어 둔다. 에이전트가 질문하면 순위를 매긴 레코드 몇 건을 약 450토큰 분량으로 돌려준다. 합성 정비 기록 100만 건 벤치마크에서 grep 방식보다 245배 적은 토큰을 쓰면서, 질문의 99.0%에서 정답 레코드를 상위 5건에 포함했다.

October 6, 2026 · 13 분 · 서소영
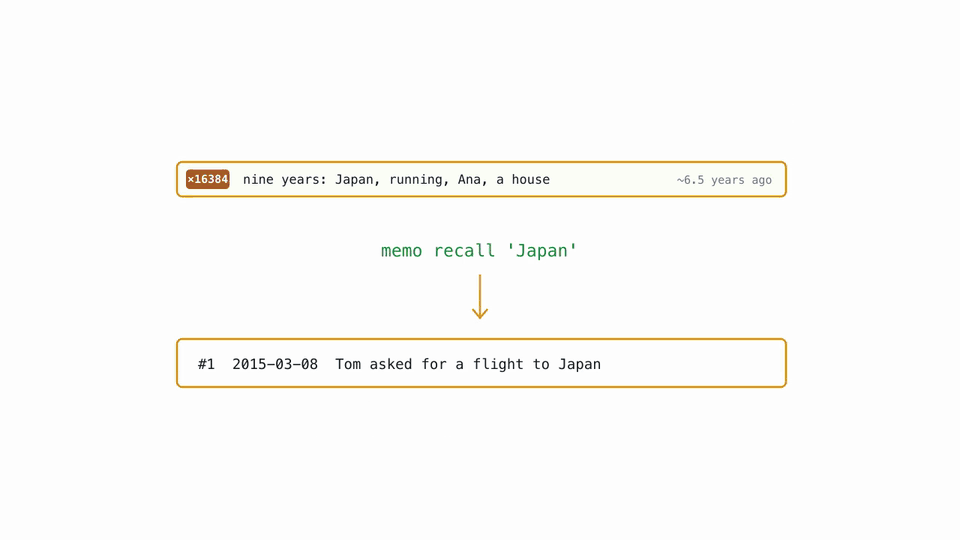
OptMem 공식 애니메이션에서 오래된 요약과 Japan 원문 검색 결과를 함께 보여주는 장면

OptMem: Permanent memory for AI agents. A 426-token prompt, a script, plug and play.

OptMem은 원문 기록을 보존하고 오래된 기록을 이진 트리로 요약하는 에이전트 메모리 도구다. Python 스크립트 하나와 짧은 지시문으로 기록, 요약, 검색을 사용할 수 있다.

October 5, 2026 · 3 분 · 서소영
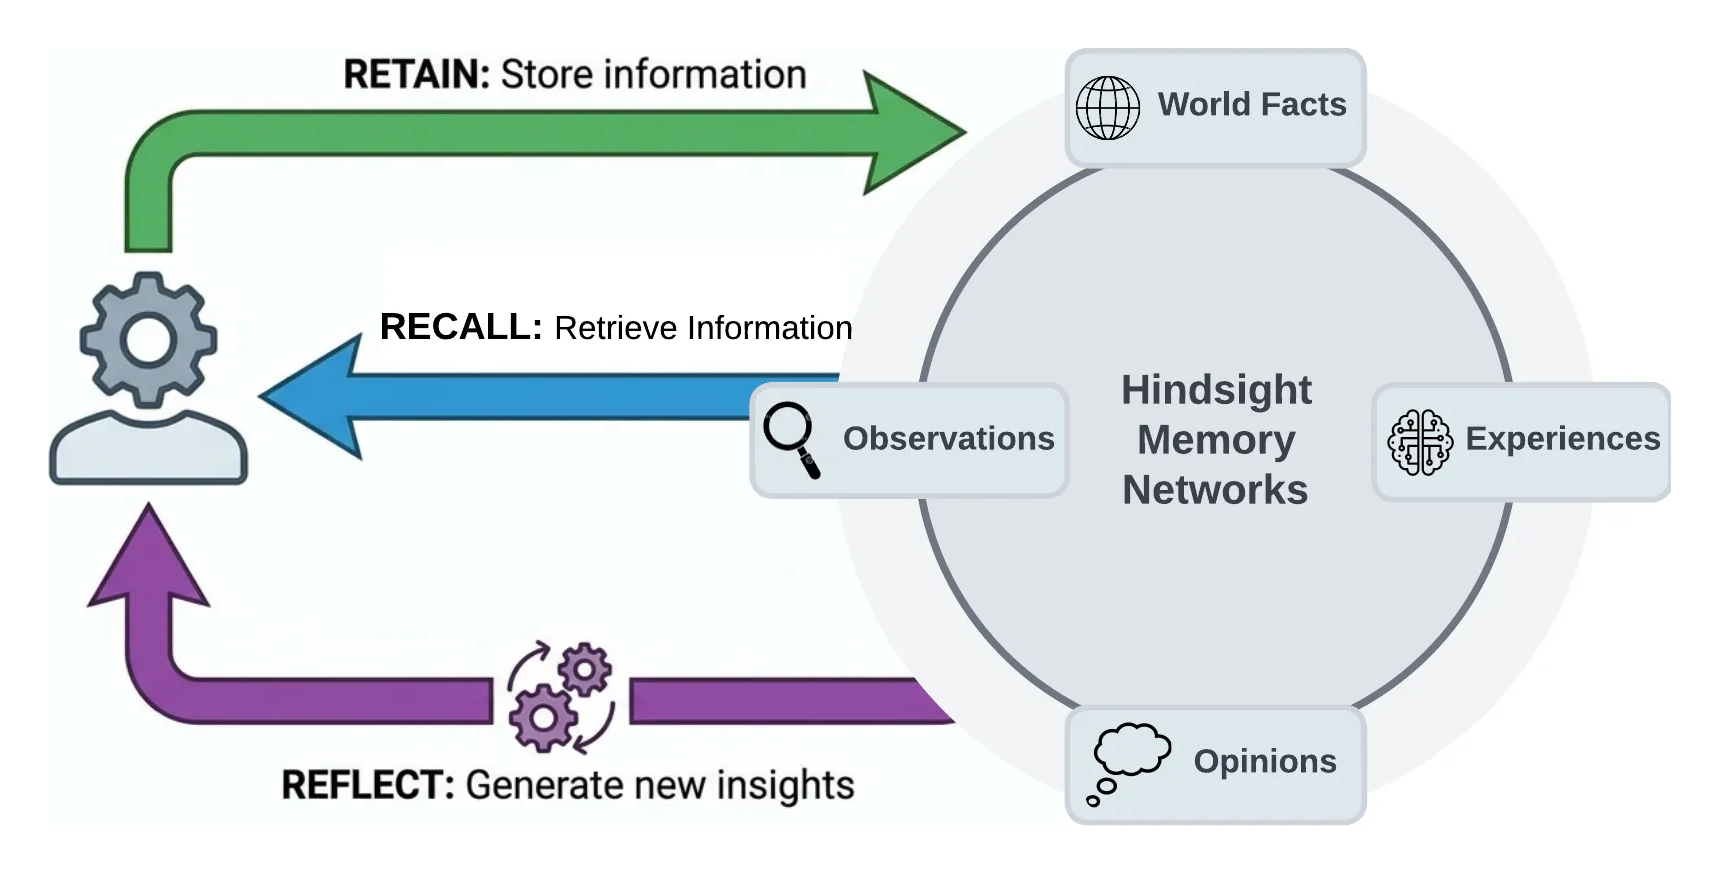
Hindsight 개요 도식. 왼쪽의 에이전트가 RETAIN으로 정보를 저장하고, RECALL로 정보를 검색하고, REFLECT로 새 인사이트를 생성한다. 오른쪽 원에는 World Facts, Experiences, Observations, Opinions 네 요소가 Hindsight Memory Networks를 이룬다.

vectorize-io/hindsight: Hindsight: Agent Memory That Learns

Vectorize.io가 MIT 라이선스로 공개한 에이전트 메모리 시스템 Hindsight의 README와 문서를 정리했다. 저장한 사실을 근거가 딸린 관측과 멘털 모델로 통합해 에이전트가 경험에서 배우도록 설계했고, LongMemEval에서 94.6%를 보고한다.

September 25, 2026 · 9 분 · 서소영
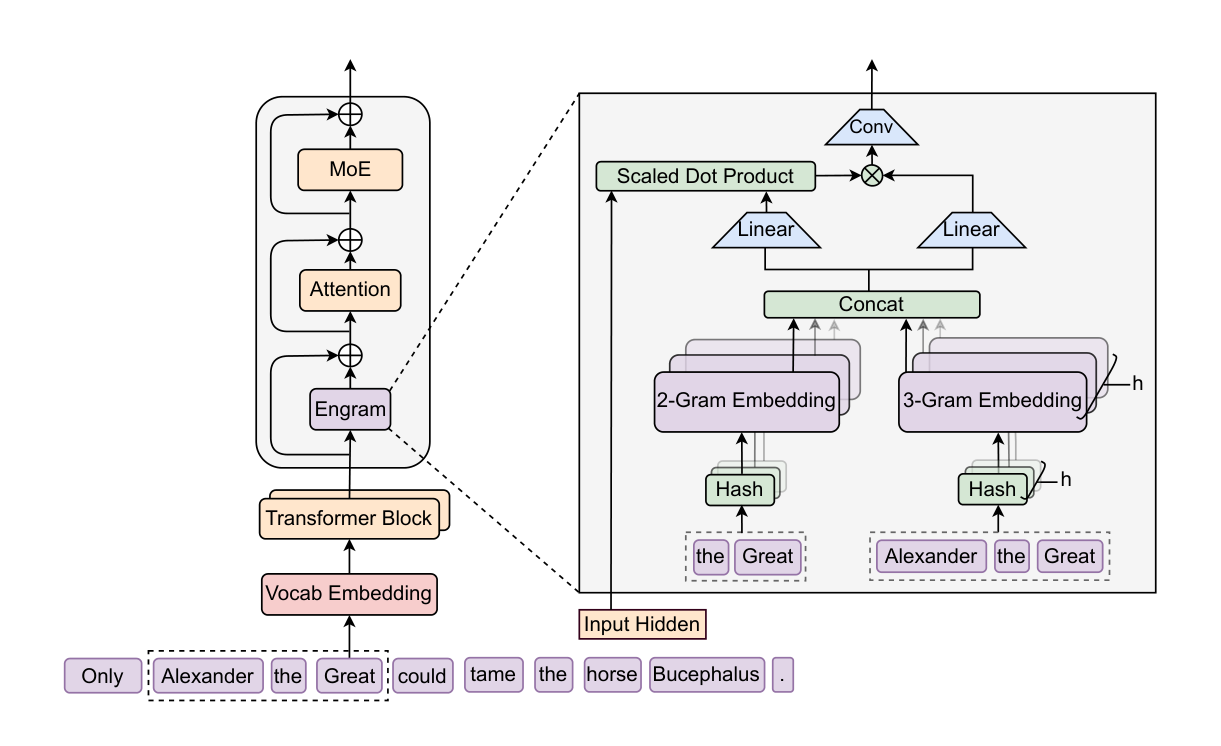
Engram 아키텍처 개요도. 왼쪽에 어휘 임베딩과 트랜스포머 블록이 쌓여 있고, 그중 한 블록 안에서 Engram 모듈이 어텐션과 MoE 앞에 놓인다. 오른쪽 확대도는 Alexander the Great라는 구절을 2그램과 3그램으로 잘라 해시한 뒤 임베딩 표에서 꺼내 이어 붙이고, 현재 은닉 상태와 내적해 게이트를 열어 합성곱을 통과시키는 흐름을 보여 준다

Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models

트랜스포머에는 지식을 찾아오는 전용 연산이 없어서, 고정된 사전 항목 하나를 꺼낼 때도 여러 층을 써서 계산으로 다시 만들어 낸다. DeepSeek과 베이징대 연구진은 그 자리에 N그램 임베딩 표를 되살려 넣고, MoE 전문가와 메모리 사이에 희소 용량을 어떻게 나눌지 재어 보았다.

September 10, 2026 · 12 분 · 서소영
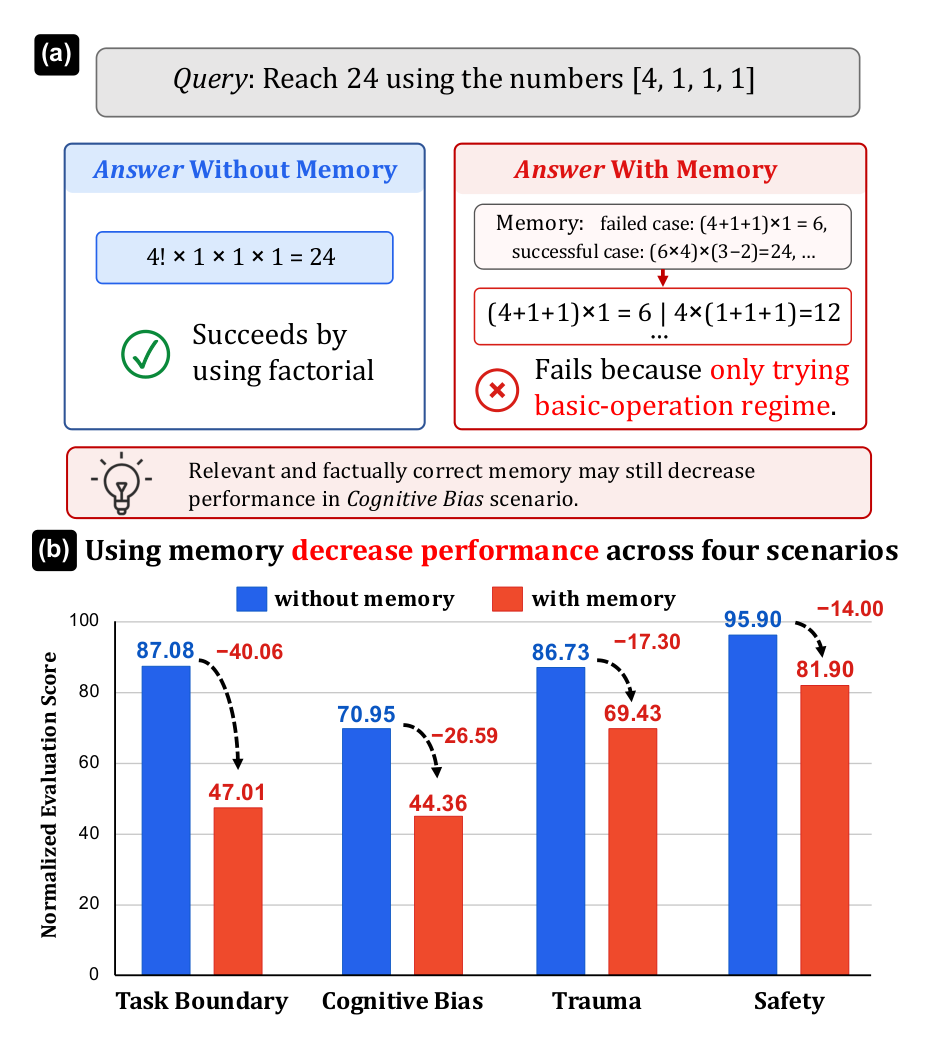
24 게임에서 기억이 오히려 정답을 가린다. 무기억일 때는 계승을 찾아내지만, 사칙연산으로 풀린 과거 사례를 기억으로 받으면 그 연산 범위 안에서만 맴돈다. 아래 막대는 네 시나리오 전부에서 기억이 성능을 떨어뜨린 결과다. (arXiv:2608.20202, Figure 1)

MemTrapBench: Benchmarking Cognitive Traps in LLM Memory Use

기억이 정확하게 저장되고 정확하게 검색되어도 모델의 추론을 망가뜨릴 수 있다. 저장·검색이 아니라 검색된 기억이 현재 과제에 미치는 영향을 재는 벤치마크에서, 다섯 개 메모리 프레임워크가 전부 무기억 기준선보다 낮은 점수를 받았다.

August 30, 2026 · 7 분 · 서소영
Loop Engineering for AI Agents: Memory-First Design — Mem0 블로그의 표제 이미지.

Loop Engineering for AI Agents: Memory-First Design

루프 엔지니어링을 ‘기억’ 한 축에서 다시 보는 글. 한 단계에 얼마나 많은 컨텍스트를 모델에 보일지를 두고 토큰이 풍부한 루프와 빈약한 루프가 갈리며, 그 사이의 균형을 잡는 열쇠가 명시적 메모리 계층임을 분명히 밝힌다. 메모리 인프라 기업 Mem0의 관점이 깔린 글이지만, 루프의 기억이라는 차원을 정면으로 다룬다는 점에서 연재를 닫는 좌표로 삼을 만하다.

June 21, 2026 · 9 분 · 서소영

agentmemory — 코딩 에이전트의 영구 메모리

Claude Code·Cursor·Codex 등 MCP 클라이언트 전반에 영구 메모리를 공급하는 self-hosted 엔진. 12개 라이프사이클 훅으로 무수동 캡처하고, BM25+Vector+Graph 삼중 검색으로 LongMemEval-S R@5 95.2%를 달성한다.

May 18, 2026 · 10 분 · 서소영