倍速で回した一晩
로컬 ComfyUI에서 MiniMax H3의 어텐션 계산을 95% 덜어내고 하룻밤 동안 영상 255편을 생성한 검증 기록이다. 150편 중앙값이 173초에서 78.6초로 줄어 2.2배가 됐다. 발단이 된 AI 층별 삭감률 배정 기법은 질문문에서 설명만 반대로 바꾸자 AI의 배정도 뒤집혀 무효로 판명됐다.
로컬 ComfyUI에서 MiniMax H3의 어텐션 계산을 95% 덜어내고 하룻밤 동안 영상 255편을 생성한 검증 기록이다. 150편 중앙값이 173초에서 78.6초로 줄어 2.2배가 됐다. 발단이 된 AI 층별 삭감률 배정 기법은 질문문에서 설명만 반대로 바꾸자 AI의 배정도 뒤집혀 무효로 판명됐다.
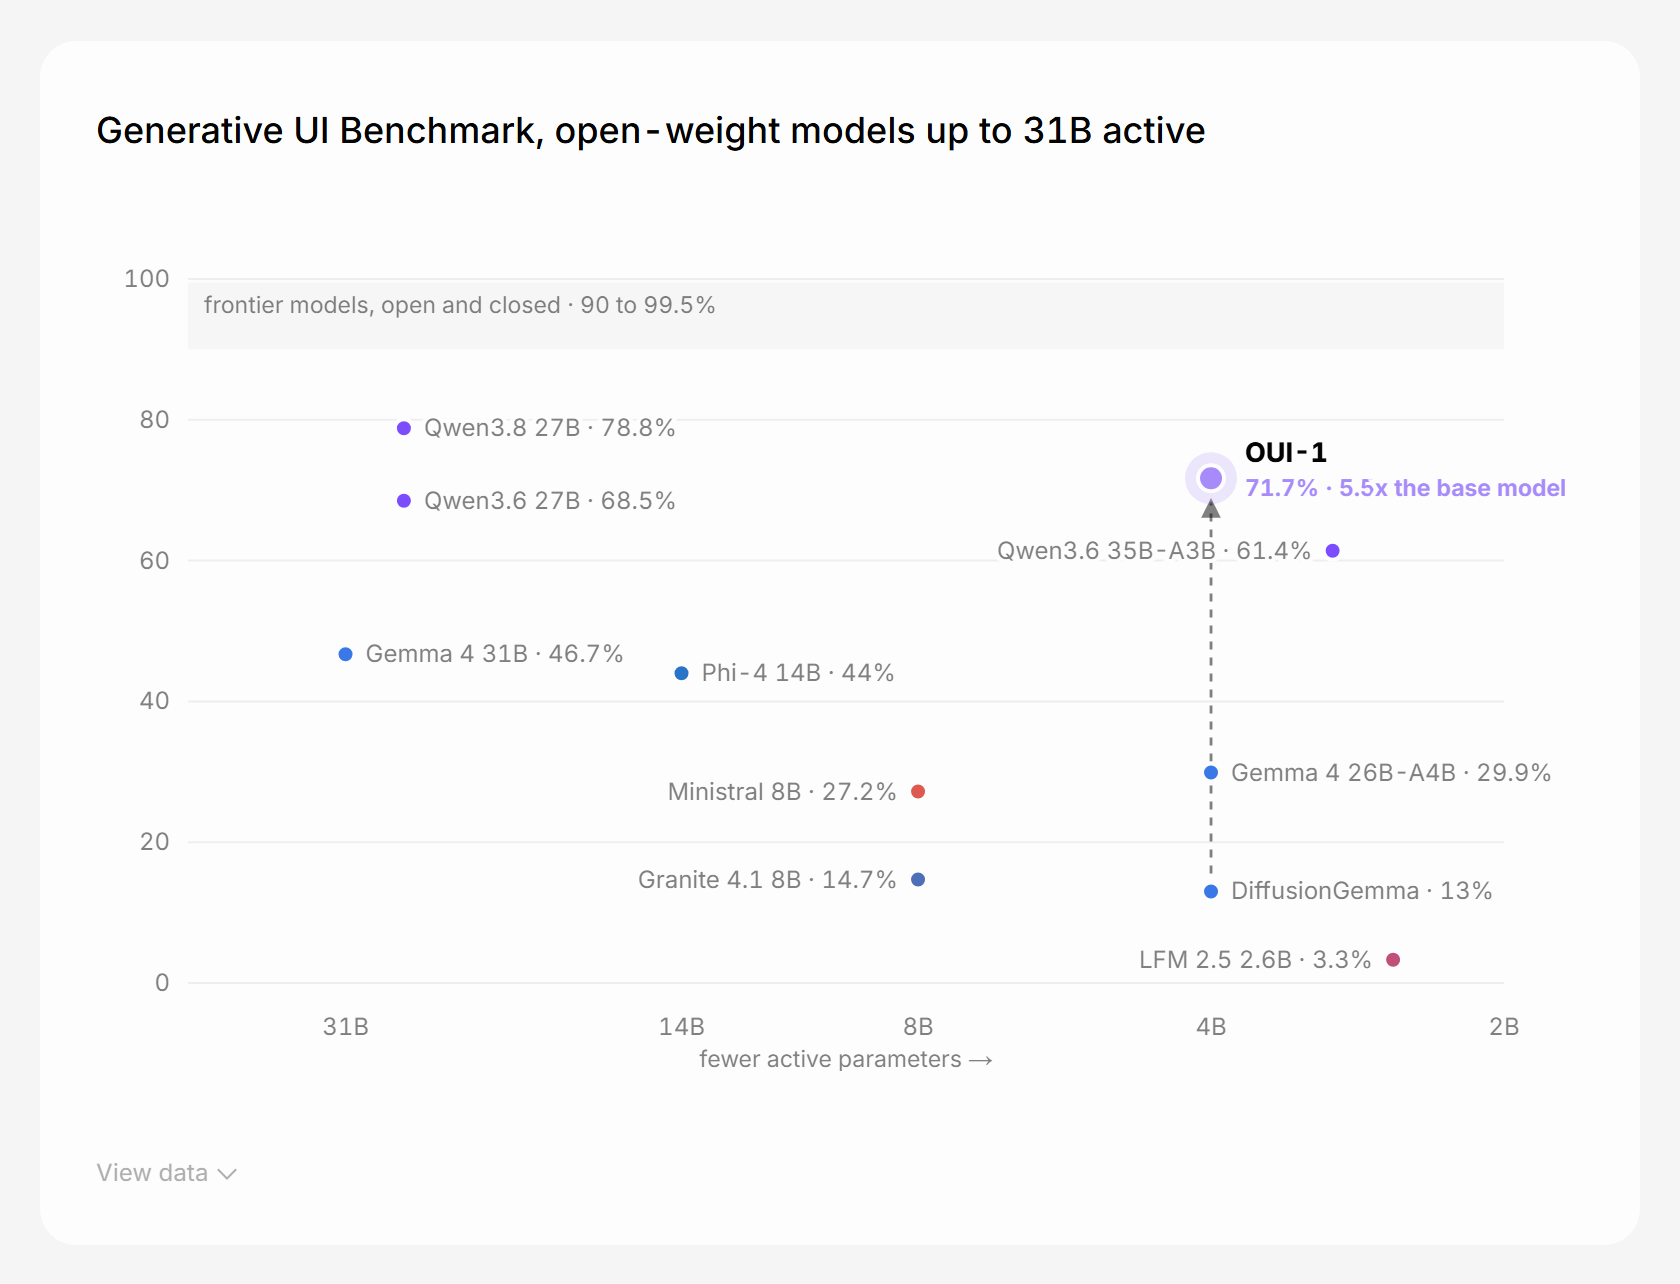
OpenUI가 확산 언어 모델 DiffusionGemma를 파인튜닝해 만든 활성 4B 인터페이스 생성 모델 OUI-1을 Apache 2.0으로 공개했다. 파서를 보상 함수로 쓴 자기 증류로 Generative UI Benchmark 점수를 13.0%에서 71.7%까지 끌어올렸다.
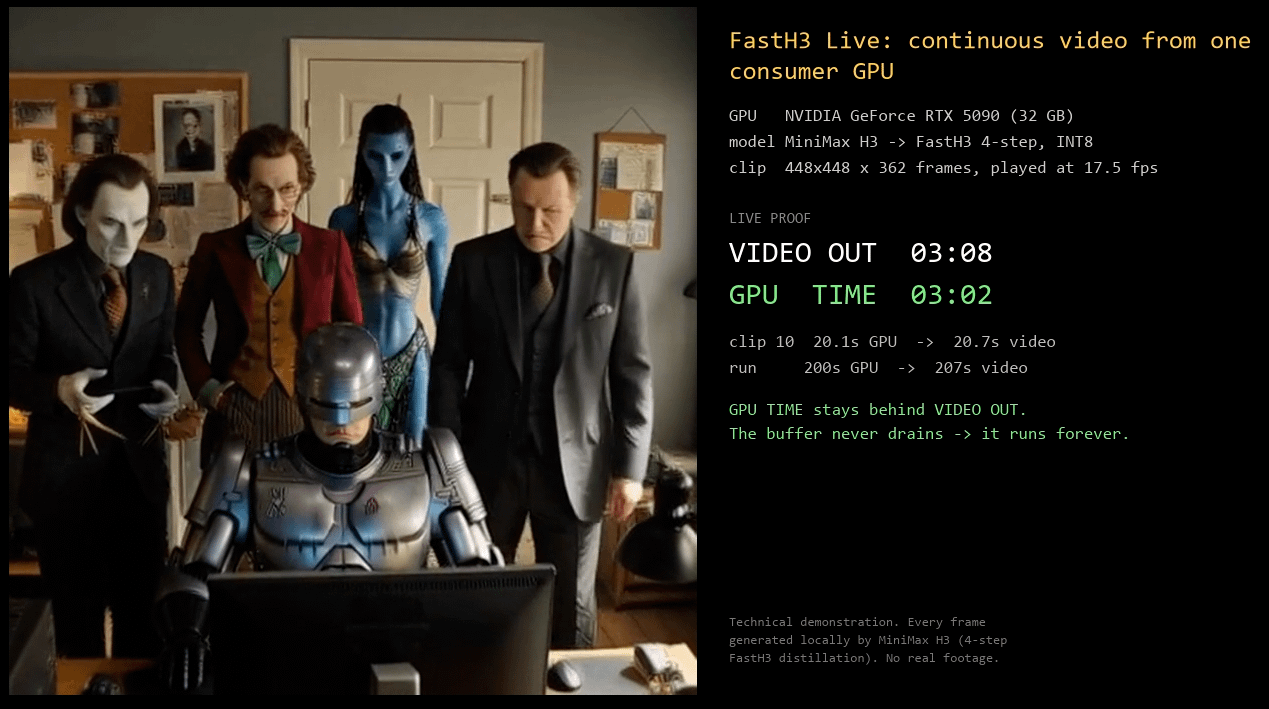
게이밍 GPU 한 장으로 끊기지 않는 AI 영상 채널을 돌린 기록이다. 19.2초의 GPU 시간으로 20.1초 분량의 영상을 만들어 재생 버퍼가 마르지 않게 했고, 모델은 그대로 두고 ComfyUI의 노드별 실행 시간을 계측해 얻은 속도다.
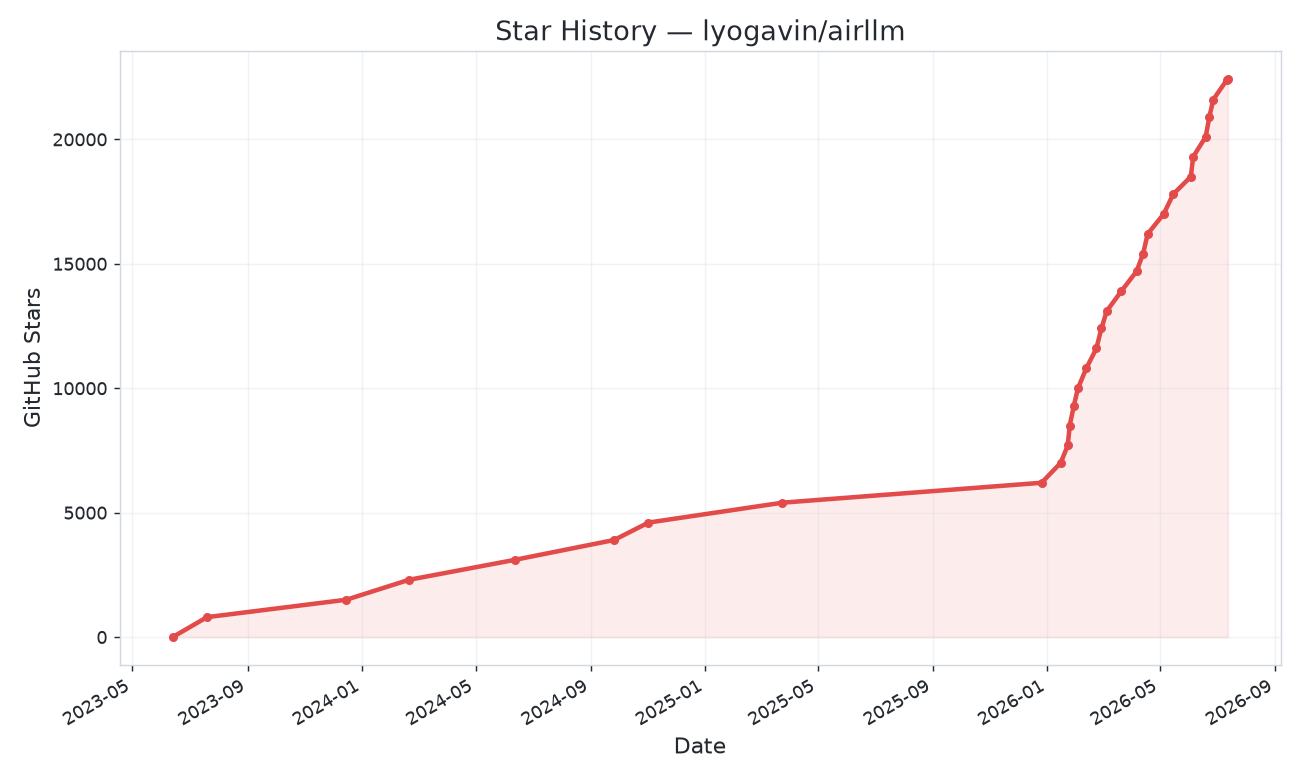
AirLLM은 트랜스포머 레이어를 한 장씩만 GPU에 올리는 방식으로 671B 모델을 12GB 카드에 얹는다. 필요 VRAM을 총 파라미터가 아니라 레이어 크기로 바꾸는 영리한 트릭이지만, 그 대가로 토큰마다 모델 전체를 디스크에서 다시 읽는다.
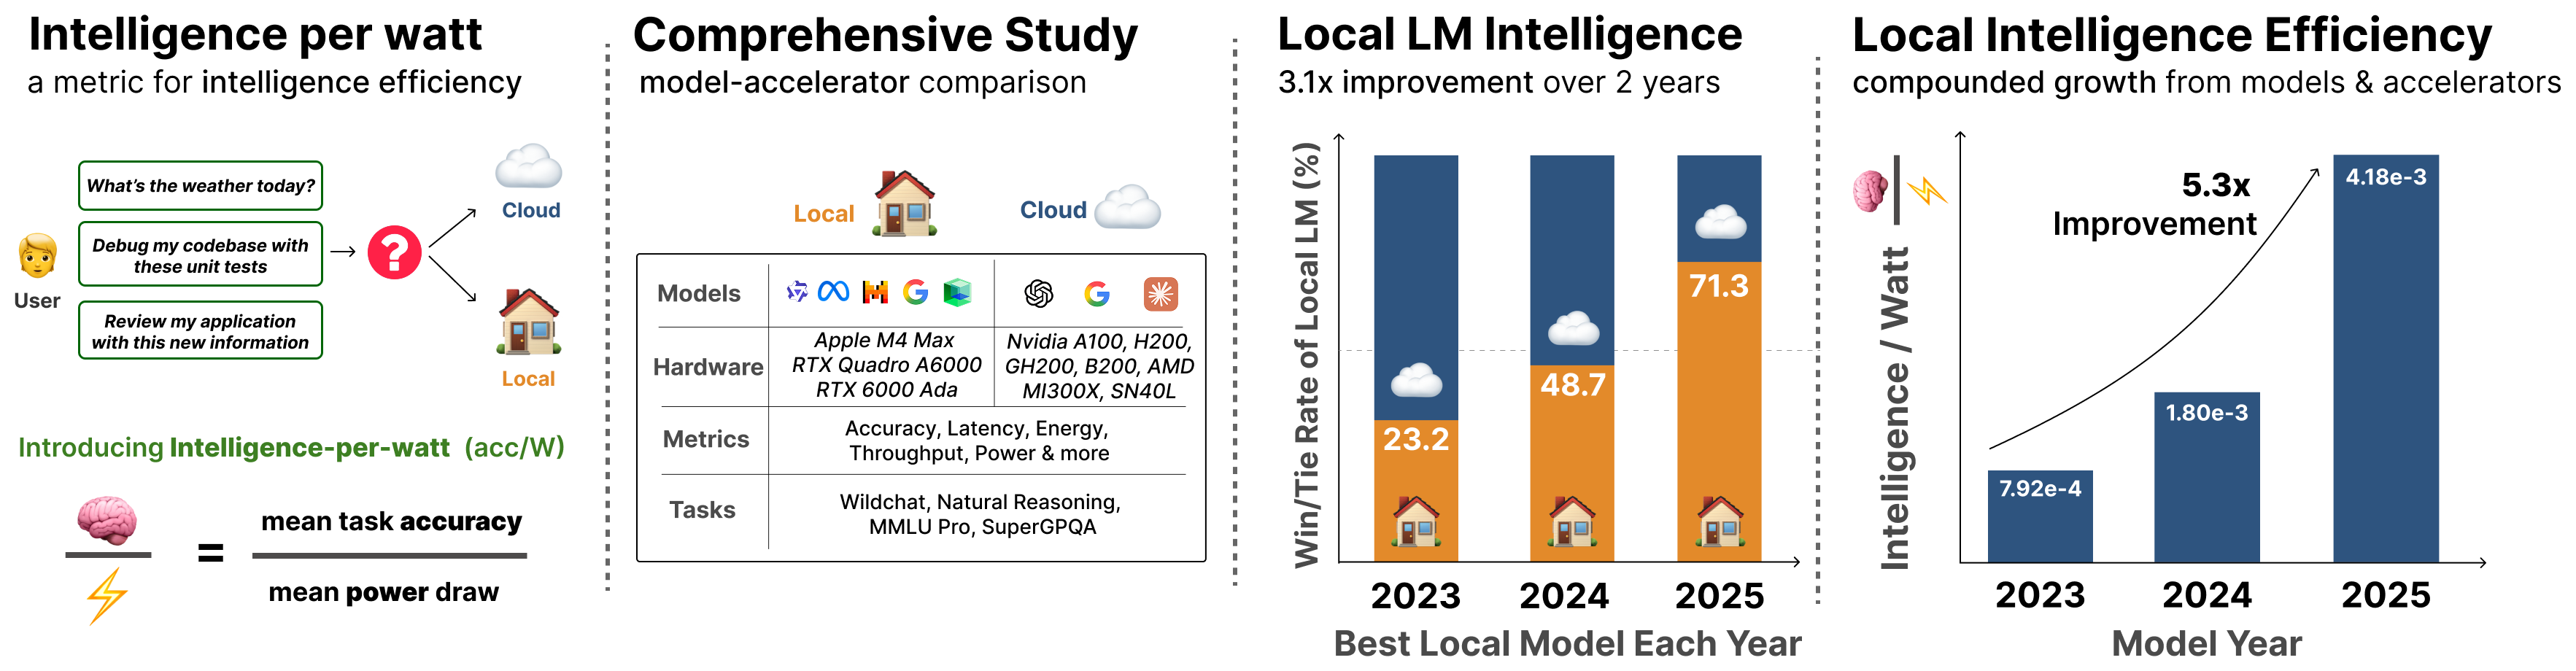
Stanford 팀이 제안한 IPW(intelligence per watt)는 정확도를 전력으로 나눈 단일 지표다. 20+ 로컬 LM과 8종 가속기에 100만 개 실제 쿼리를 돌려, ≤20B active 로컬 모델이 단일턴 쿼리 88.7%를 답하고 IPW가 2023–2025년 5.3배 개선됐음을 보였다.