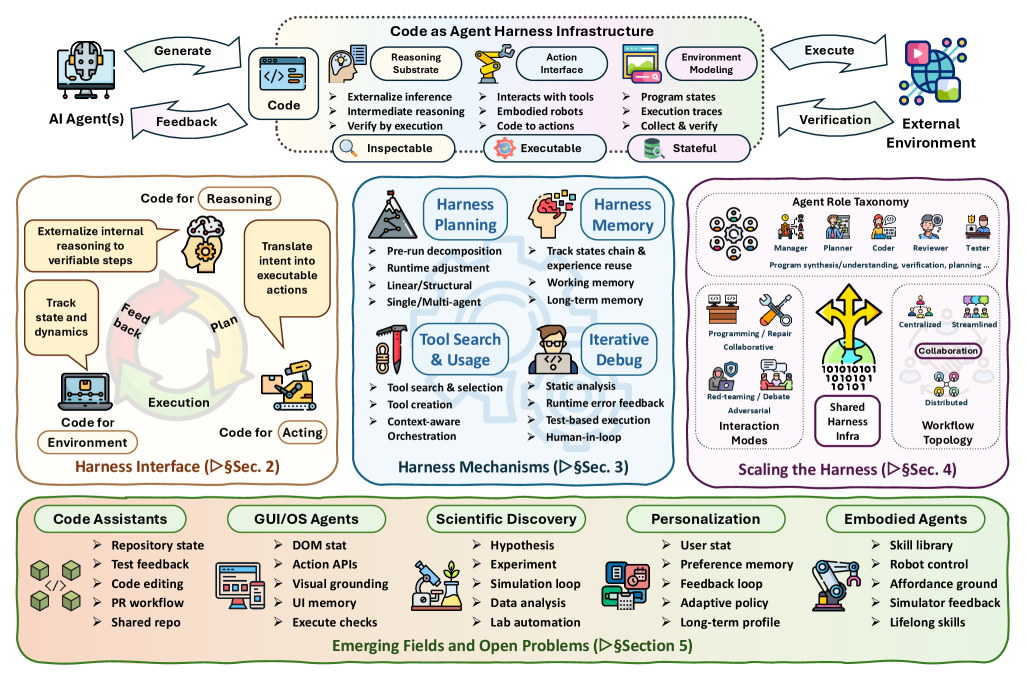
Figure 1. Taxonomy of code as agent harness.

Code as Agent Harness: 실행 가능하고 검증 가능하며 상태를 지닌 에이전트 시스템을 향하여

UIUC·Meta·Stanford 합동 서베이(2026.05). 코드를 LLM이 생성하는 산출물이 아니라, 에이전트가 추론·행동·환경 모델링·검증을 수행하는 운영 매개체로 다시 잡는 통합적 시각을 제시한다. Harness Interface / Mechanisms / Scaling 세 층으로 문헌을 정리하고, PEV(Plan-Execute-Verify) 루프와 다섯 응용 영역(코드 어시스턴트, GUI/OS, 과학, 개인화, 임베디드)을 짚는다.
June 9, 2026 · 9 분 · 서소영
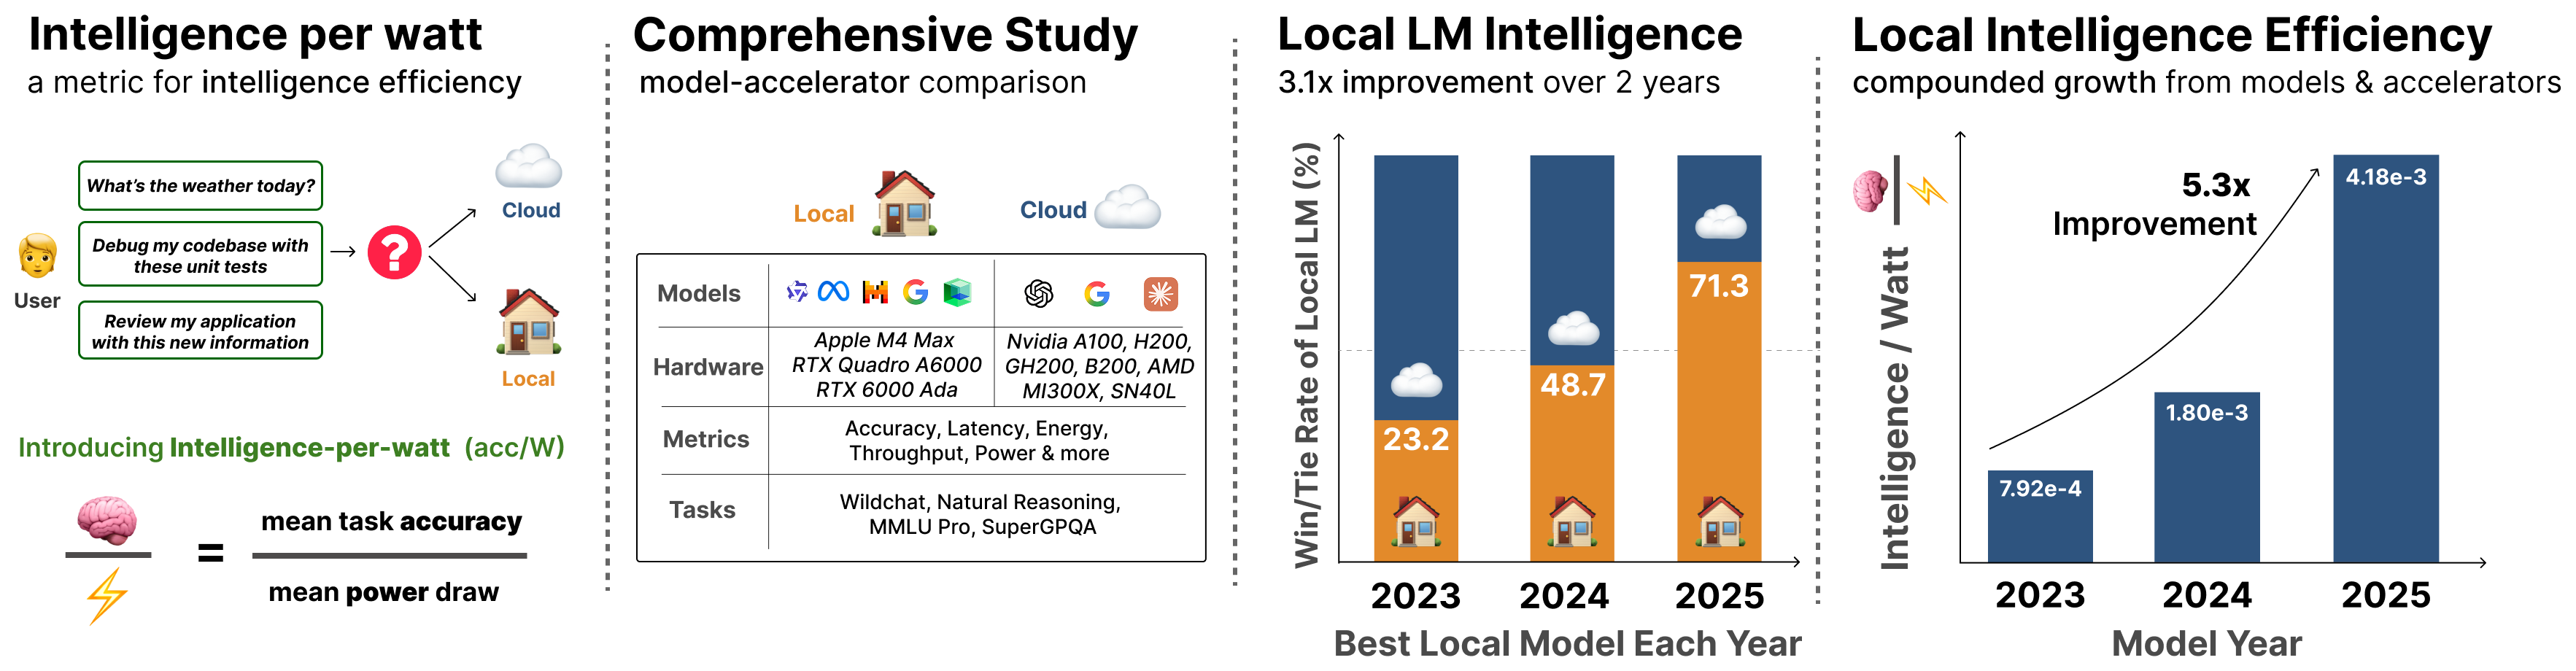
Figure 1 — Intelligence per Watt 전체 개요: IPW 정의, 실험 설정, 로컬 LM 커버리지 시계열, 5.3배 개선의 분해. 출처: Saad-Falcon et al. 2025

Intelligence per Watt — 로컬 AI의 와트당 지능을 재다 (Saad-Falcon et al., 2025)

Stanford 팀이 제안한 IPW(intelligence per watt)는 정확도를 전력으로 나눈 단일 지표다. 20+ 로컬 LM과 8종 가속기에 100만 개 실제 쿼리를 돌려, ≤20B active 로컬 모델이 단일턴 쿼리 88.7%를 답하고 IPW가 2023–2025년 5.3배 개선됐음을 보였다.

June 9, 2026 · 7 분 · 서소영

From Code Foundation Models to Agents and Applications: A Comprehensive Survey and Practical Guide to Code Intelligence

BUAA·알리바바·바이트댄스·텐센트 등 71인 컨소시엄이 정리한 303페이지짜리 코드 LLM 종합 서베이 + 실무 가이드. 데이터 큐레이션부터 사전훈련·SFT·RL·자율 코딩 에이전트까지 전 생애주기를 훑고, 사전훈련·SFT·RL 각각에 대한 데이터 기반 권고안을 직접 실험으로 검증한다.

June 4, 2026 · 8 분 · 서소영
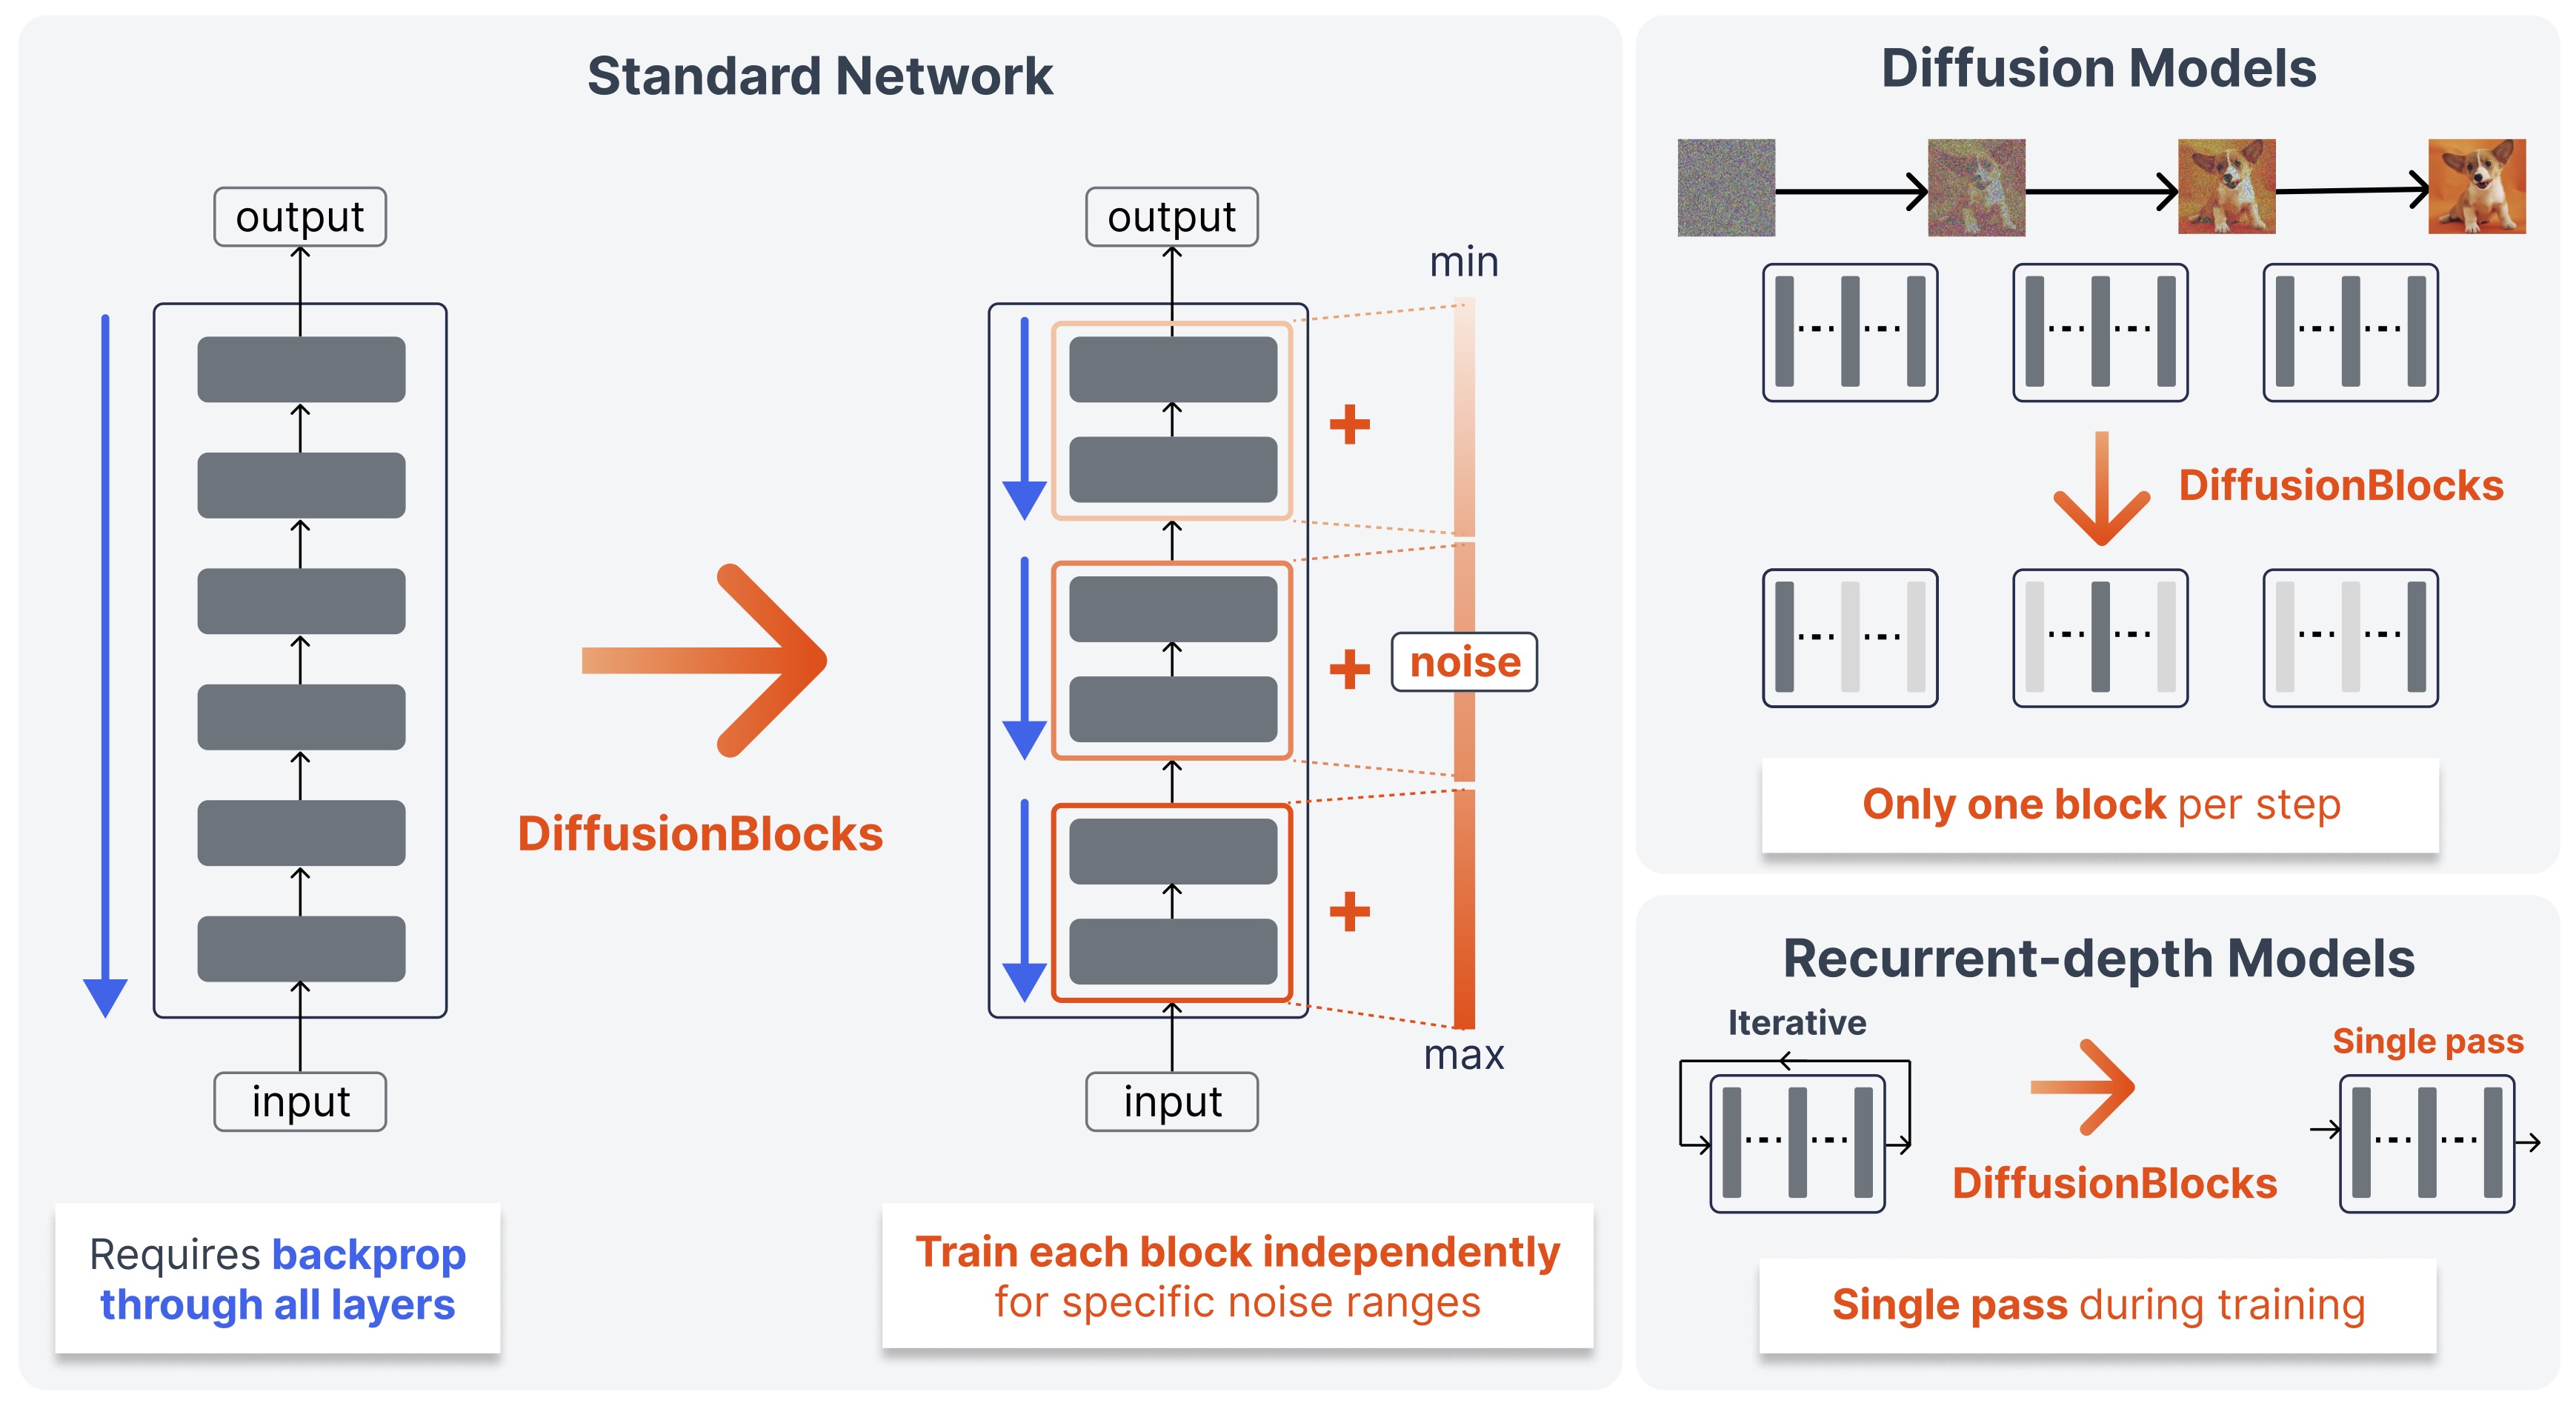
DiffusionBlocks 개요 — (좌) 표준망은 전 계층 역전파가 필요하다, (중) DiffusionBlocks는 네트워크를 블록으로 나눠 각자 맡은 노이즈 구간을 독립 학습한다, (우) 확산 모델은 스텝당 블록 하나만, recurrent-depth 모델은 반복 학습을 단일 패스로 대체한다

DiffusionBlocks: Block-wise Neural Network Training via Diffusion Interpretation

엔드투엔드 역전파의 메모리 병목을, 트랜스포머의 잔차 연결이 확산 모델 ODE의 이산화와 같다는 통찰로 푼 논문. 네트워크를 노이즈 구간별 독립 블록으로 쪼개 한 번에 한 블록만 학습하니 메모리가 블록 수만큼 줄고, 5개 아키텍처에서 엔드투엔드에 필적했다.

May 28, 2026 · 5 분 · 서소영
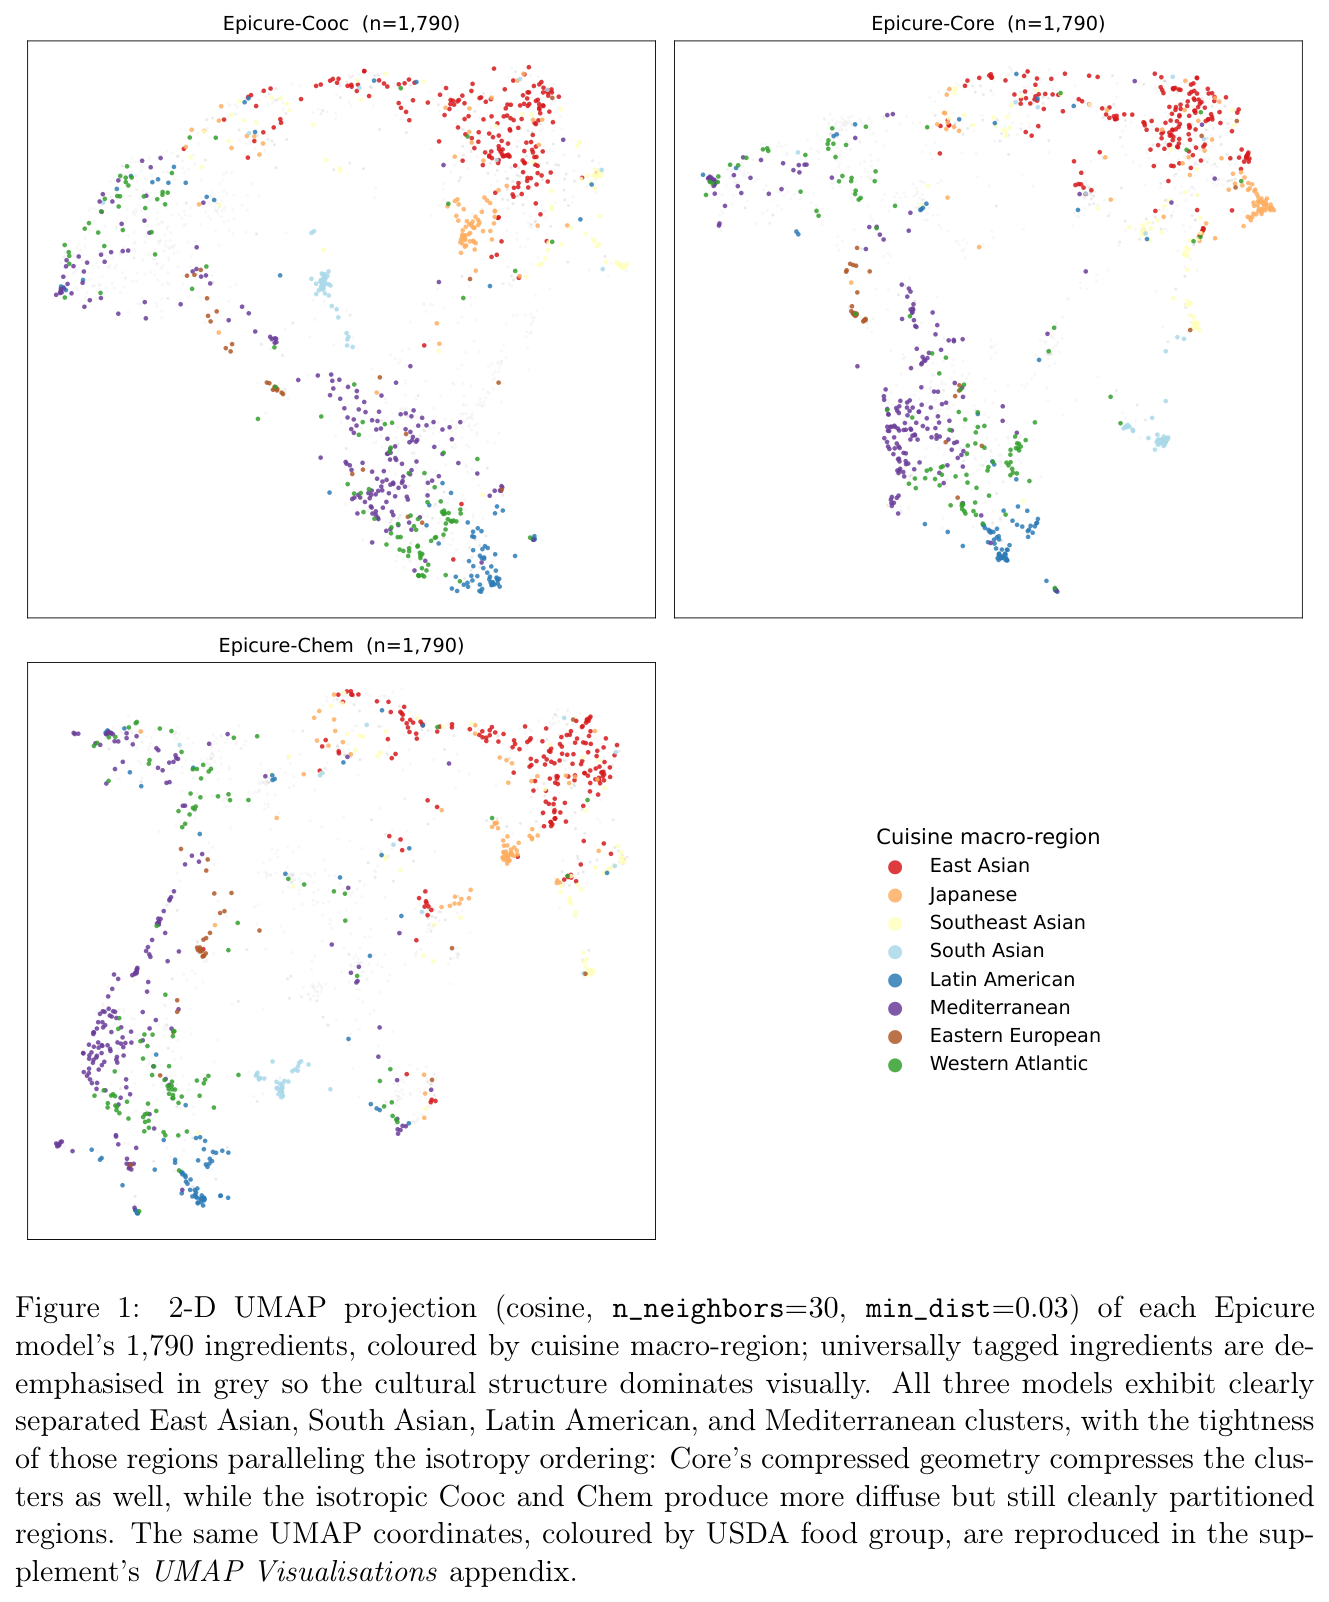
세 모델의 1,790개 식재료를 2-D UMAP으로 투영하고 요리 거대권역별로 색칠한 산점도. 동아시아·남아시아·라틴아메리카·지중해 클러스터가 세 모델 모두에서 뚜렷이 분리된다.

Epicure: Navigating the Emergent Geometry of Food Ingredient Embeddings

FlavorGraph 후속작. 414만 다국어 레시피로 학습한 세 자매 식재료 임베딩(Cooc·Core·Chem)을 통해 ‘화학 vs 레시피-맥락’을 조정 가능한 설계 축으로 만들고, 페어링과 SLERP 회전이라는 두 연산자로 임베딩 공간을 항해한다.

May 27, 2026 · 6 분 · 서소영

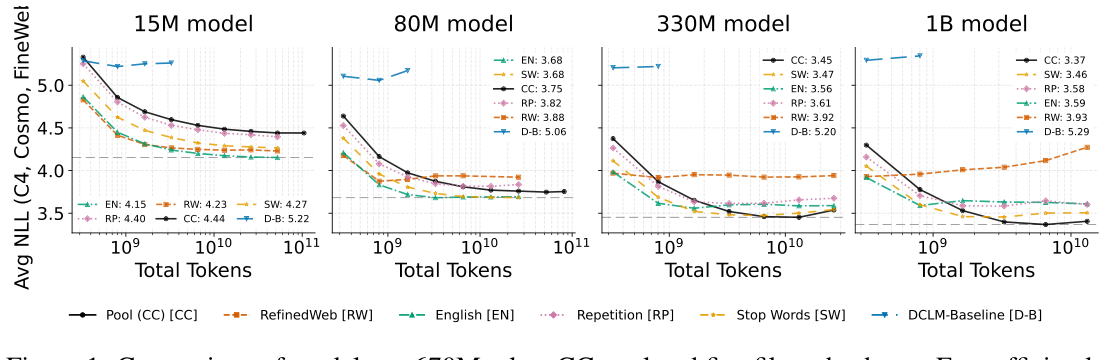
A Bitter Lesson for Data Filtering

컴퓨트가 충분히 크면 데이터 필터링은 오히려 손해다 — Stanford 연구진이 Common Crawl과 5개 표준 필터를 비교하여, 큰 모델이 ‘저품질’ 데이터에서도 이득을 본다는 증거를 제시한다.

May 27, 2026 · 5 분 · 서소영

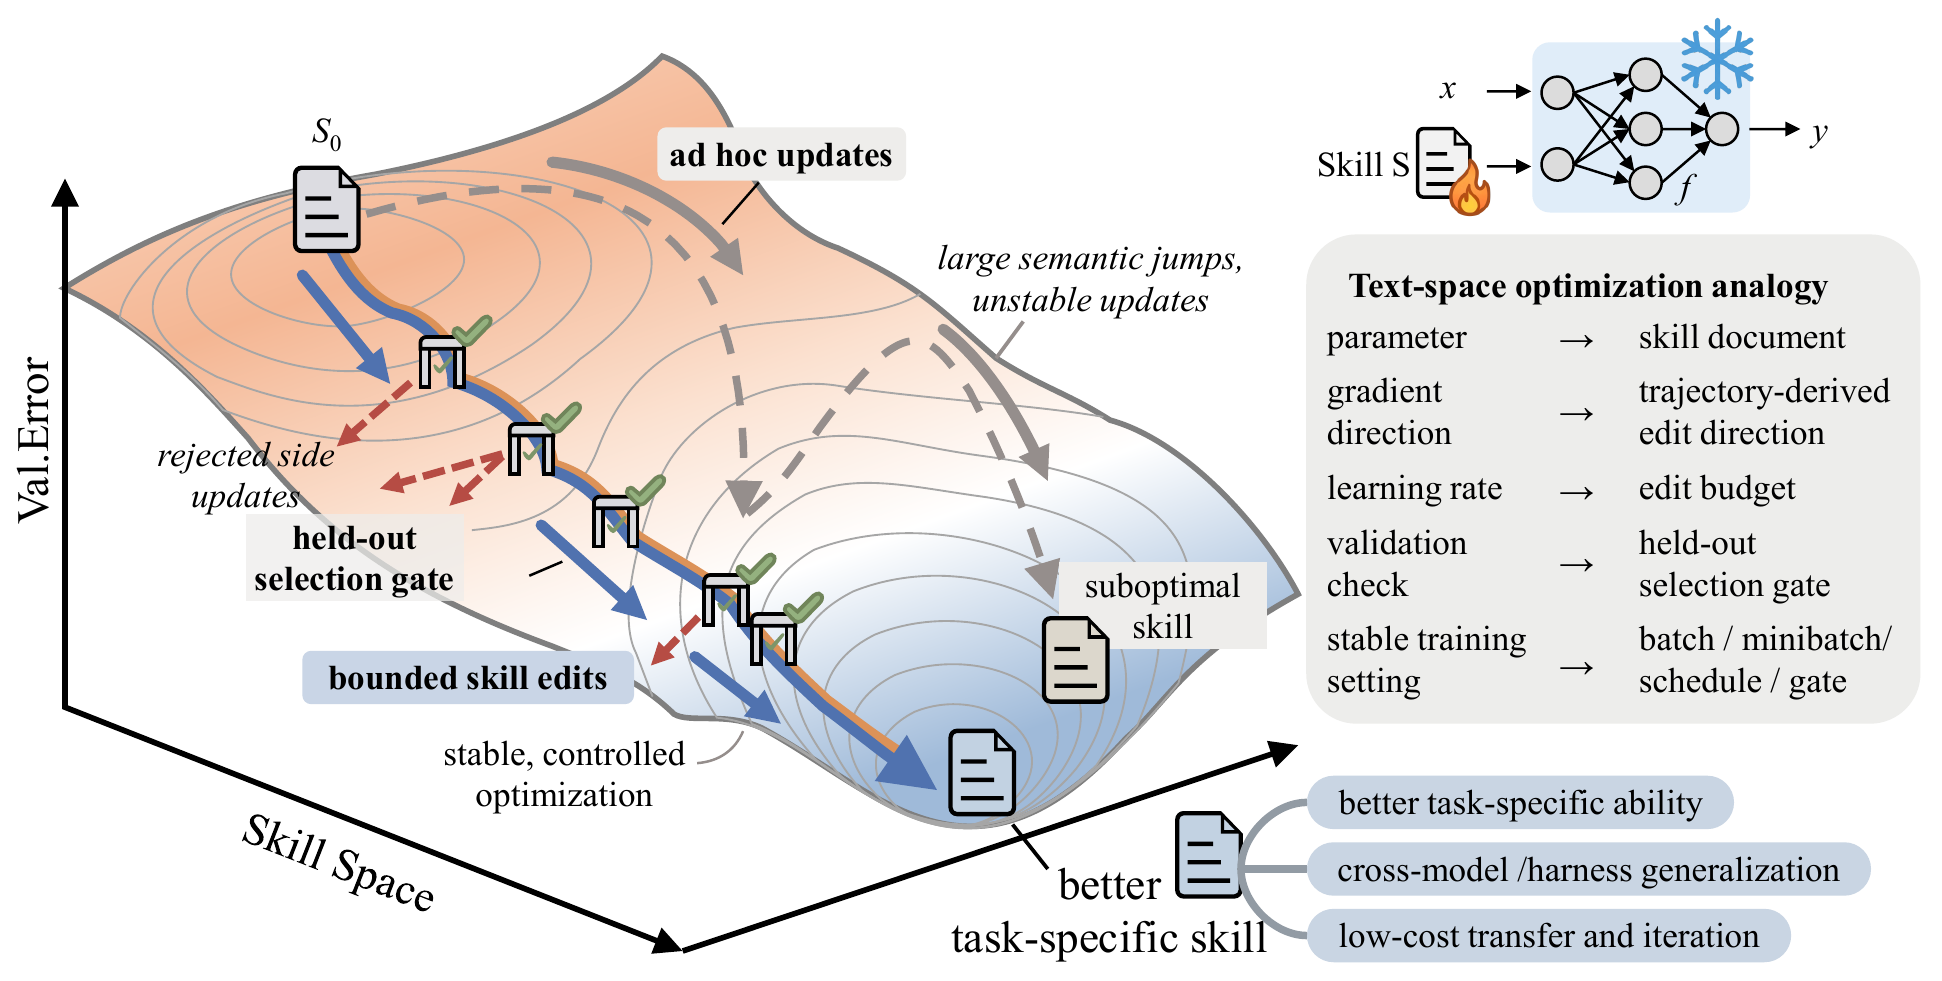
SkillOpt: Executive Strategy for Self-Evolving Skills of Frozen LLM Agents

Microsoft가 공개한 SkillOpt는 모델 가중치를 동결한 채 자연어 기술 문서 한 장을 딥러닝 옵티마이저처럼 반복 학습하여 LLM 에이전트의 성능을 끌어올리는 텍스트 공간 최적화 프레임워크다. 채점 가능한 태스크에 한정되며, 6개 벤치마크 52/52 셀에서 최고 또는 공동 최고를 기록했다.

May 27, 2026 · 9 분 · 서소영
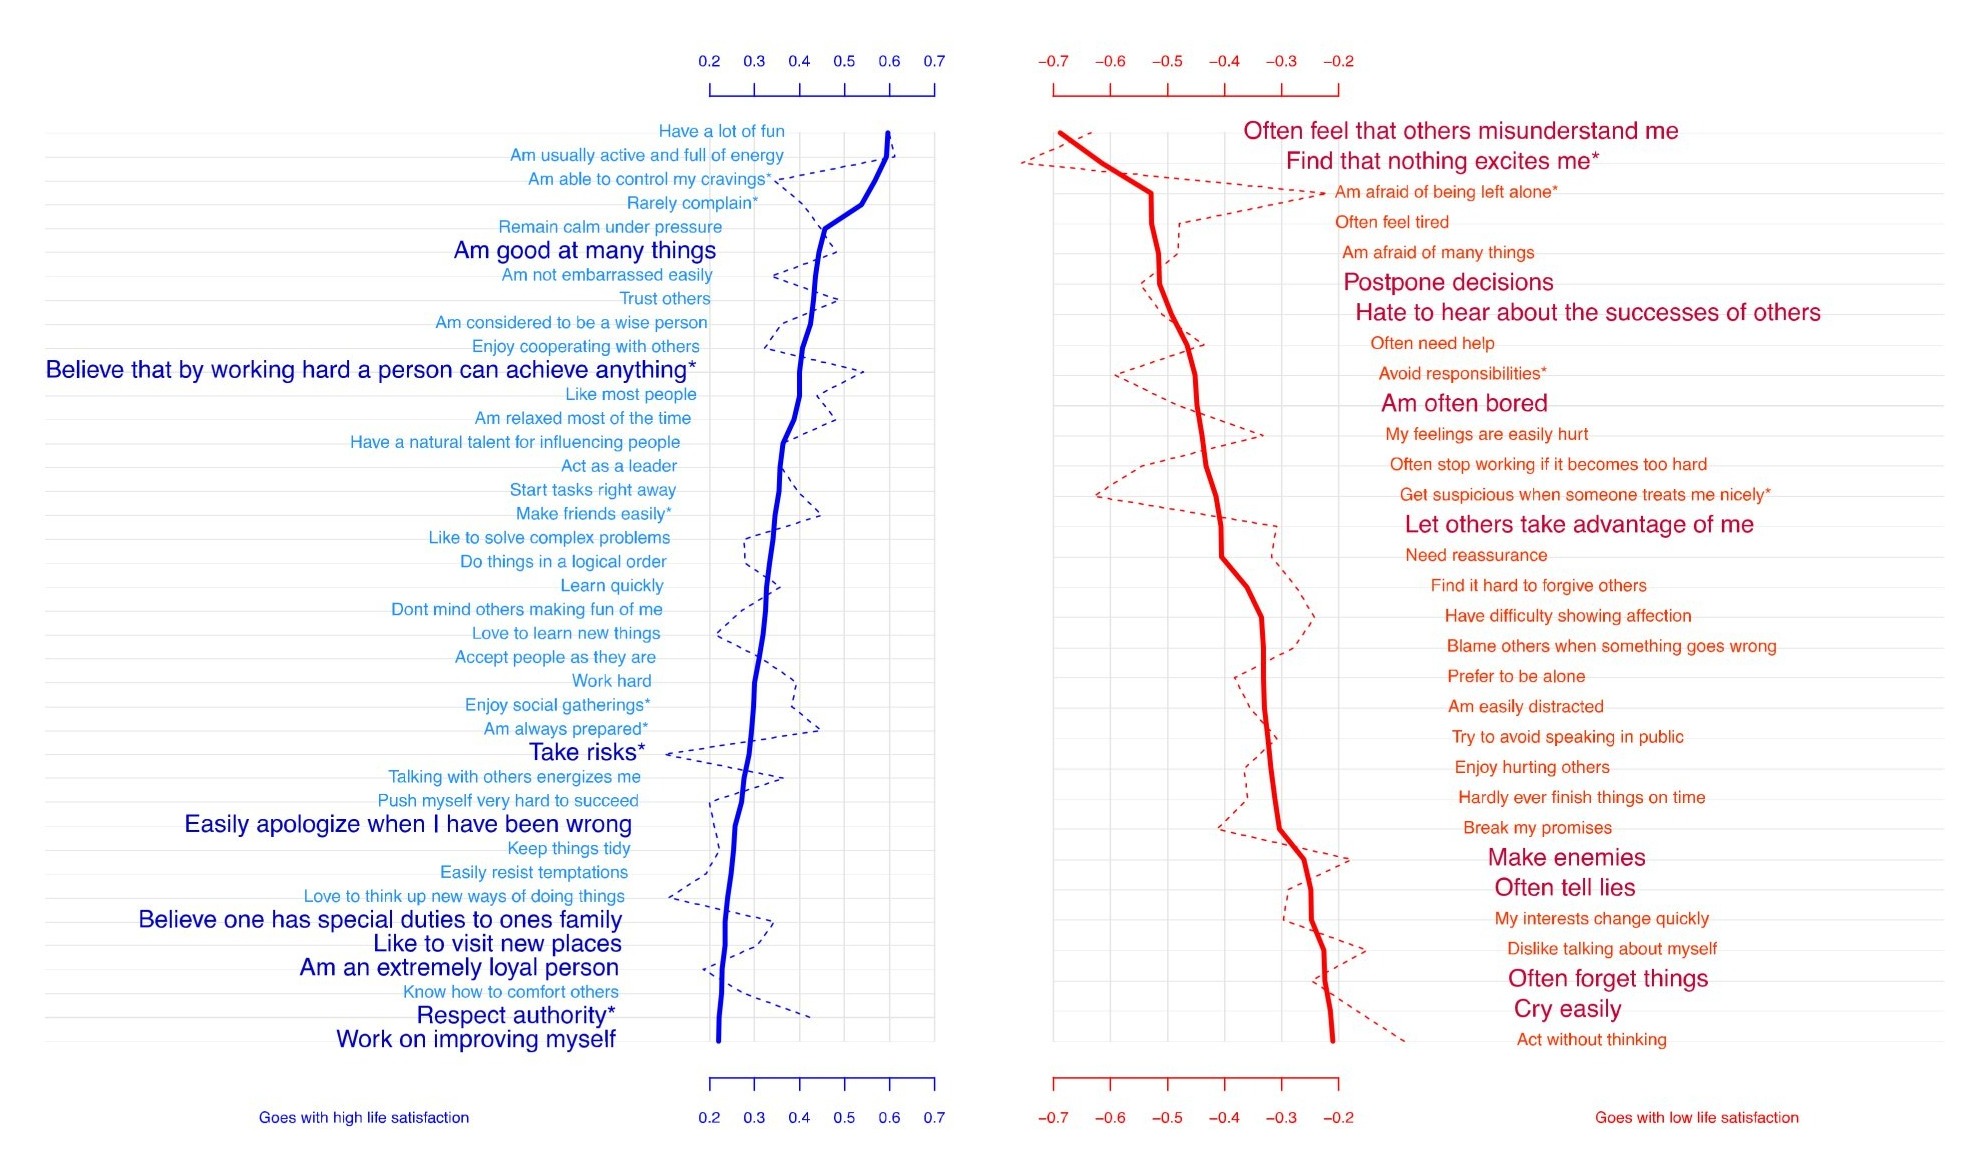
Figure 1. Big Five 도메인 외부에 있는 항목들의 LS 진짜 상관 — 굵은 글자는 다른 어떤 성격 항목과도 진짜 상관이 .50을 넘지 않는 "상대적으로 고유한" 19개 항목. Mõttus et al. (2024).

Most people's life satisfaction matches their personality traits: True correlations in multi-trait, multi-rater, multi-sample data

성격 5요인과 삶의 만족도(LS)의 상관은 단일-방법 연구에서 r ≈ .30에서 .65로 알려져 있었다. 자기보고와 정보제공자(informant) 보고를 교차 결합해 측정 오류·방법 편향을 제거했더니 ‘진짜 상관(r_true)‘은 .80에서 .90까지 올라갔다. 단 세 항목 — ‘오해받는다고 느낀다’, ‘흥미진진한 게 없다’, ‘결정을 미룬다’ — 만으로도 삶의 만족도를 r ≈ .80으로 예측한다.

May 22, 2026 · 6 분 · 서소영
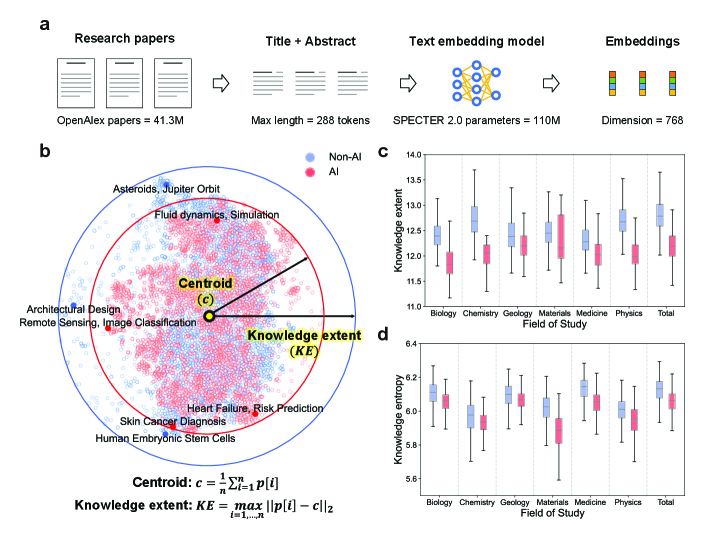
Fig 3. AI 도입은 학문 내·학문 간 지식 범위의 수축과 연관된다

Artificial Intelligence Tools Expand Scientists' Impact but Contract Science's Focus

1980부터 2025년까지 자연과학 논문 4,130만 편을 분석한 Nature 논문. AI를 쓰는 개별 과학자는 논문 3.02배·인용 4.84배·승진 1.37년 단축의 이점을 누리지만, 학문 전체로는 연구 주제가 4.63% 좁혀지고 후속 협업이 22% 줄어든다.

May 21, 2026 · 6 분 · 서소영

1930년에 멈춘 AI가 비추는 거울

현대 웹 데이터를 모두 빼고 1930년 이전 텍스트만으로 훈련한 13B 모델 talkie가 던지는 질문 — AI의 능력은 언어에서 오는가, 데이터에서 오는가.

April 28, 2026 · 5 분 · 서소영