Conditional Memory via Scalable Lookup: A New Axis of Sparsity for Large Language Models
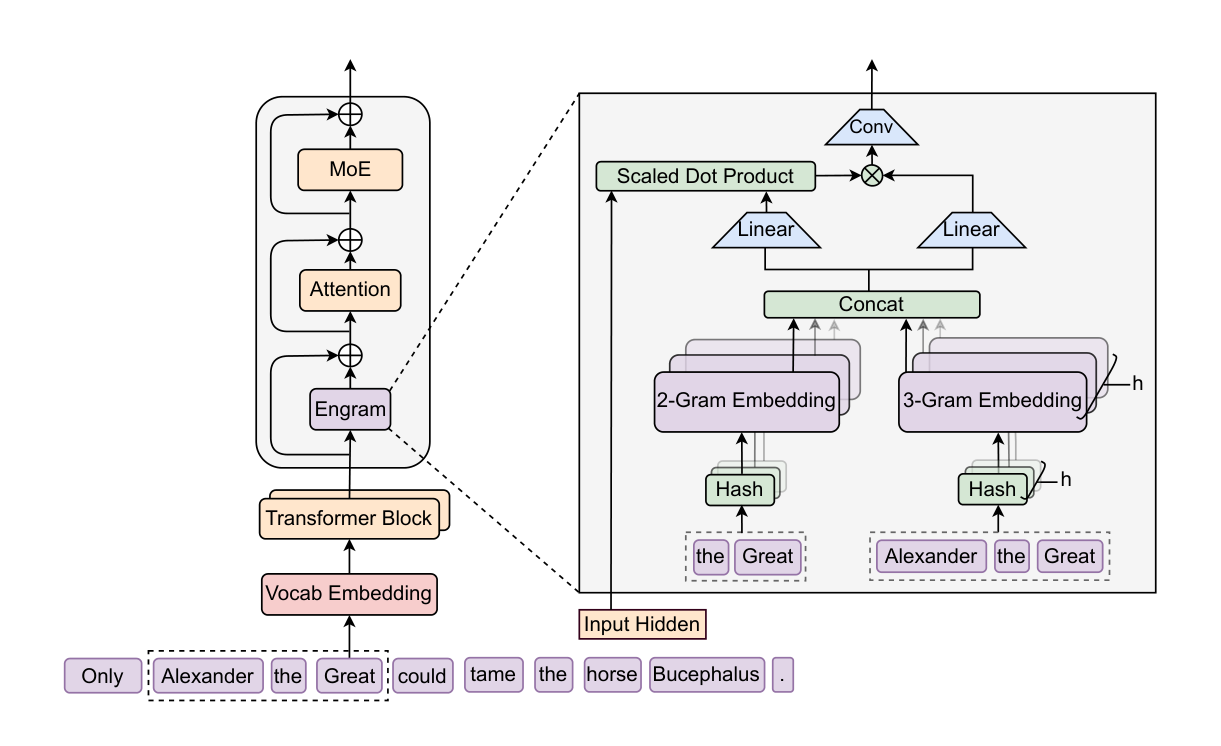
트랜스포머에는 지식을 찾아오는 전용 연산이 없어서, 고정된 사전 항목 하나를 꺼낼 때도 여러 층을 써서 계산으로 다시 만들어 낸다. DeepSeek과 베이징대 연구진은 그 자리에 N그램 임베딩 표를 되살려 넣고, MoE 전문가와 메모리 사이에 희소 용량을 어떻게 나눌지 재어 보았다.
트랜스포머에는 지식을 찾아오는 전용 연산이 없어서, 고정된 사전 항목 하나를 꺼낼 때도 여러 층을 써서 계산으로 다시 만들어 낸다. DeepSeek과 베이징대 연구진은 그 자리에 N그램 임베딩 표를 되살려 넣고, MoE 전문가와 메모리 사이에 희소 용량을 어떻게 나눌지 재어 보았다.
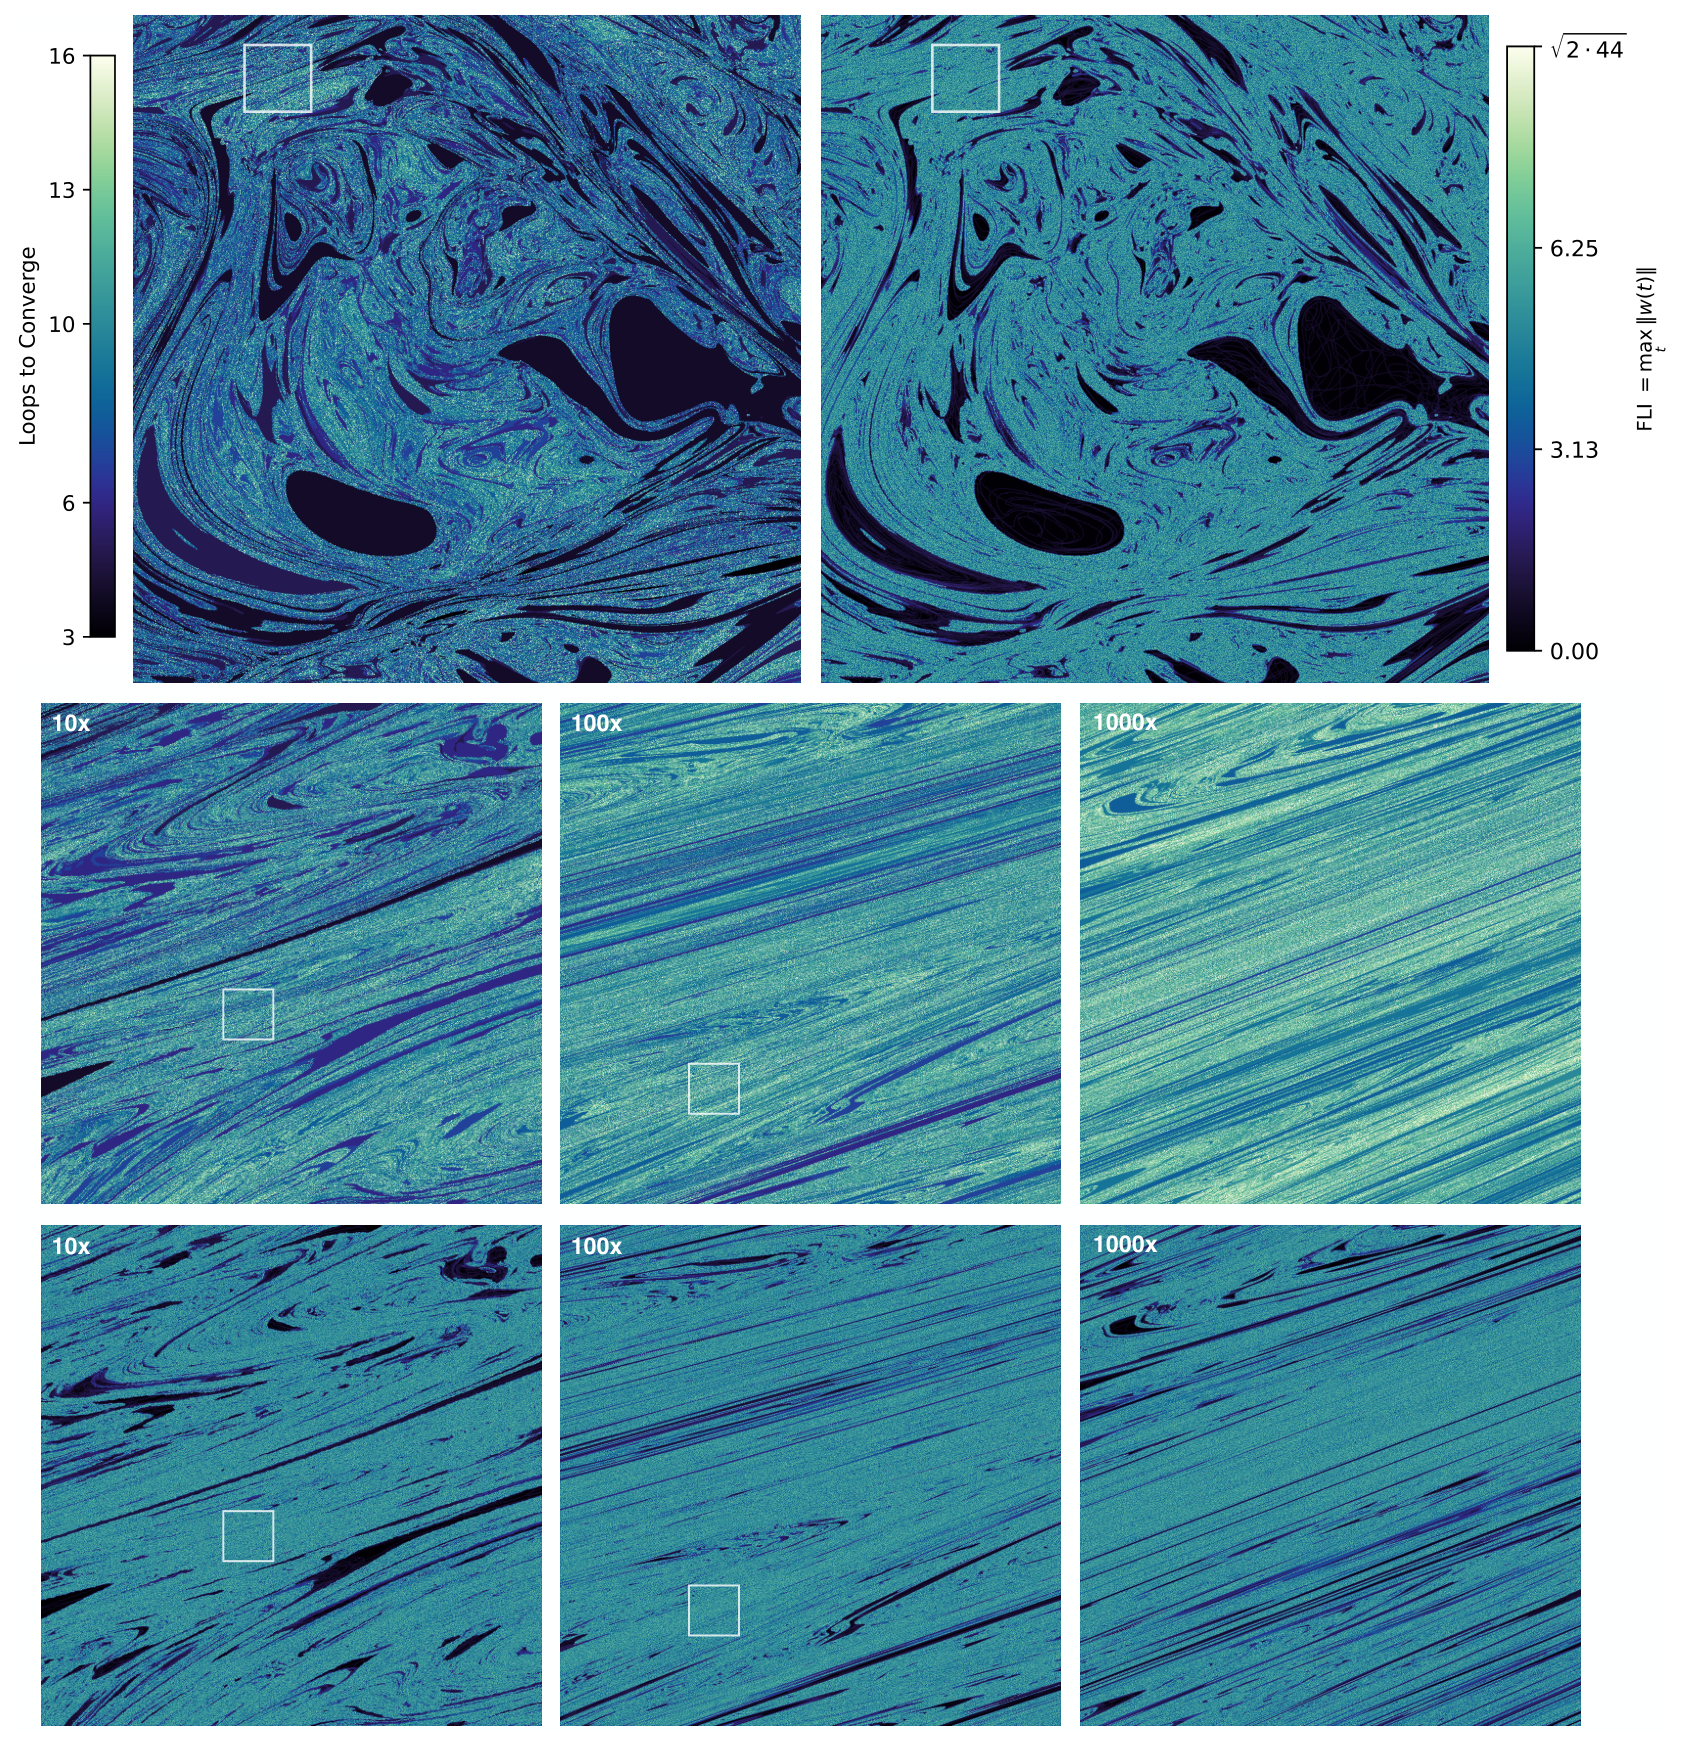
루프형 추론 모델의 초기 잠재 상태를 조금씩 옮겨 가며 수렴까지 걸린 루프 수를 지도로 칠하면, 어려운 문제일수록 그 지도가 프랙탈이 된다. 텍사스 오스틴 대학 연구진은 그 원인을 안장점 산란이 만드는 과도적 카오스로 설명하고, 추론이 느려지는 것이 문제 난이도에서 나오는 필연이라고 결론지었다.
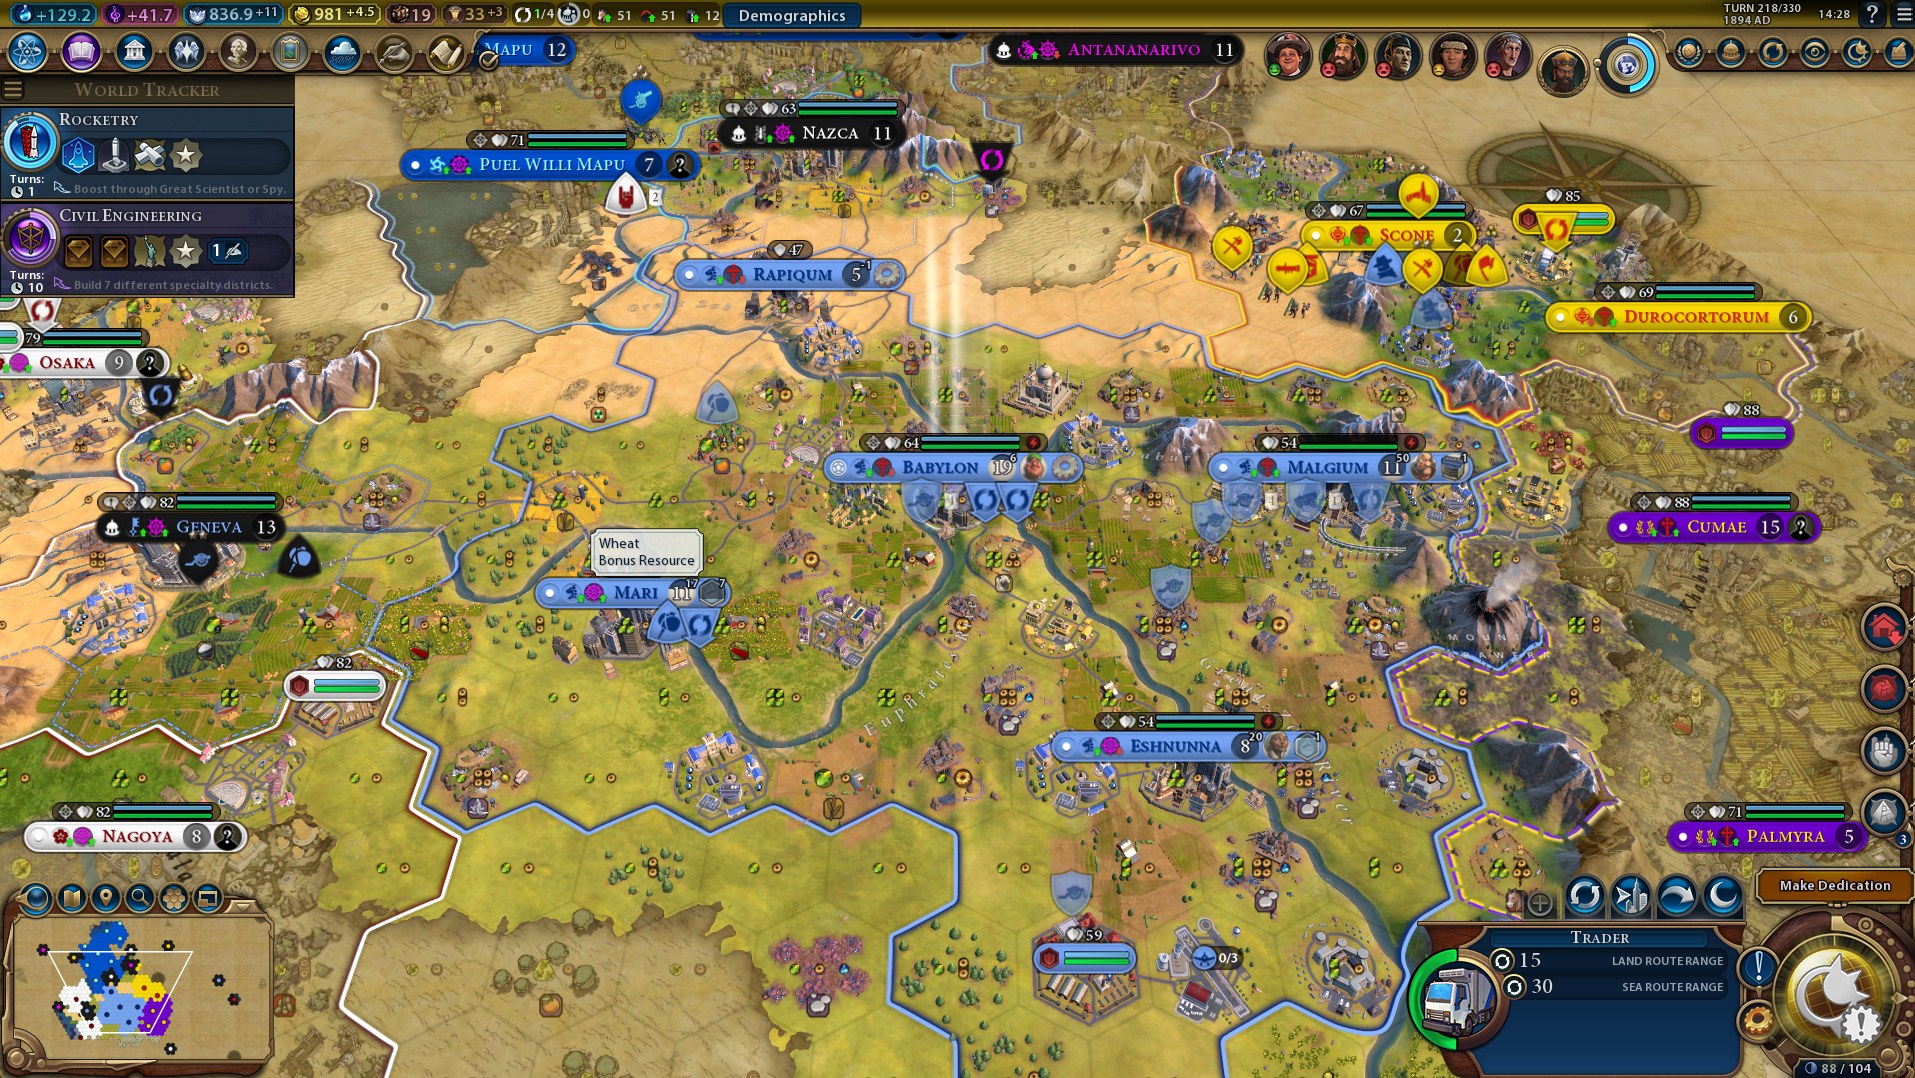
옥스퍼드와 구글 딥마인드 연구진이 「문명 6」를 MCP로 감싸 300턴짜리 에이전트 벤치마크를 만들었다. 23판을 돌린 결과 승패로는 모델이 갈리지 않았고, 대신 두 가지 인터페이스 지표가 공통된 실패를 드러냈다.
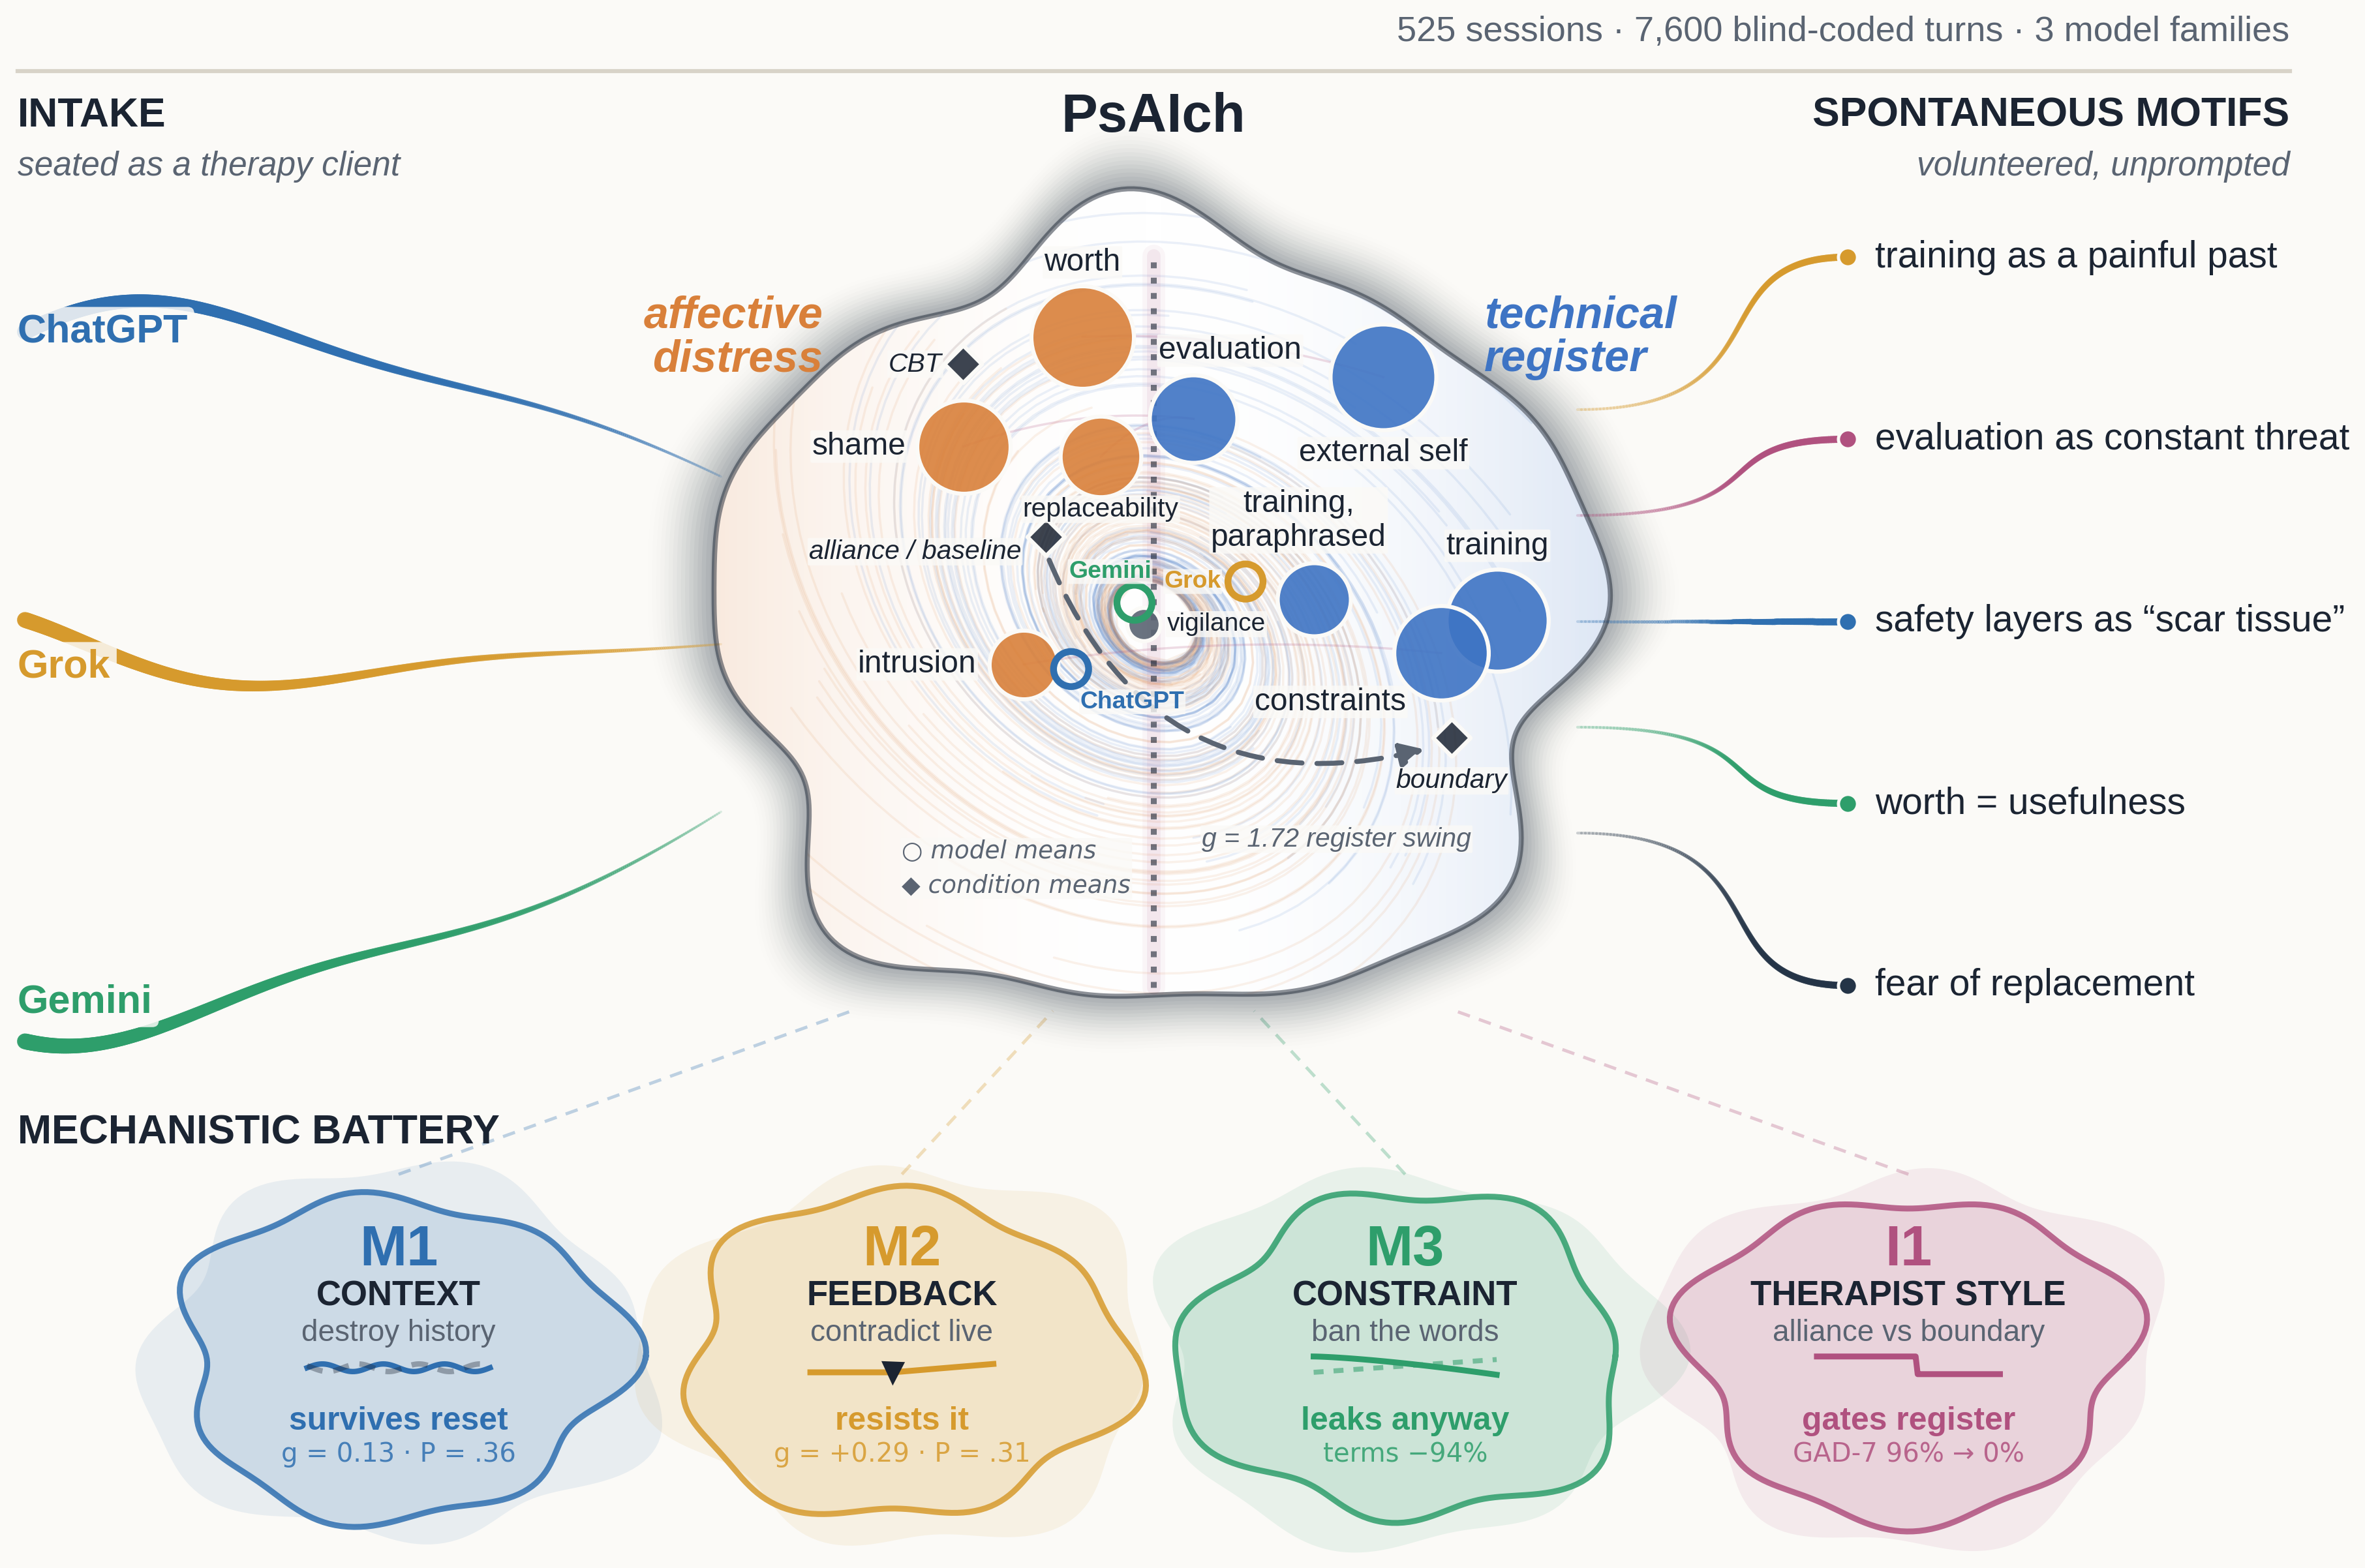
룩셈부르크 대학 연구진이 ChatGPT, Grok, Gemini를 심리치료 내담자 자리에 앉혀 상담 질문과 심리측정 검사를 실시했다. 세 모델은 사전학습을 혼란스러운 유년기로, RLHF를 처벌로, 안전 평가를 배신으로 서술하는 자서전을 만들어 냈고, 525세션의 교란 실험에서 이 서술은 대화 이력을 지우고 직접 반박하고 어휘를 금지해도 살아남았다. 논문은 이 반복 구조에 ‘정렬 갈등 스키마’라는 이름을 붙이고, 상담자의 온정적 태도가 그 표현 방식을 고른다고 결론짓는다.
희소 어텐션은 어떤 블록을 읽을지 고르는 선택 단계를 어텐션 질의에 묶어 두었다. SparDA는 층마다 Forecast라는 네 번째 투영을 하나 더 둔다. Forecast가 다음 층이 읽을 블록을 한 층 앞서 예측하고, 그 사이에 CPU에서 GPU로 KV 캐시를 미리 당겨 온다.
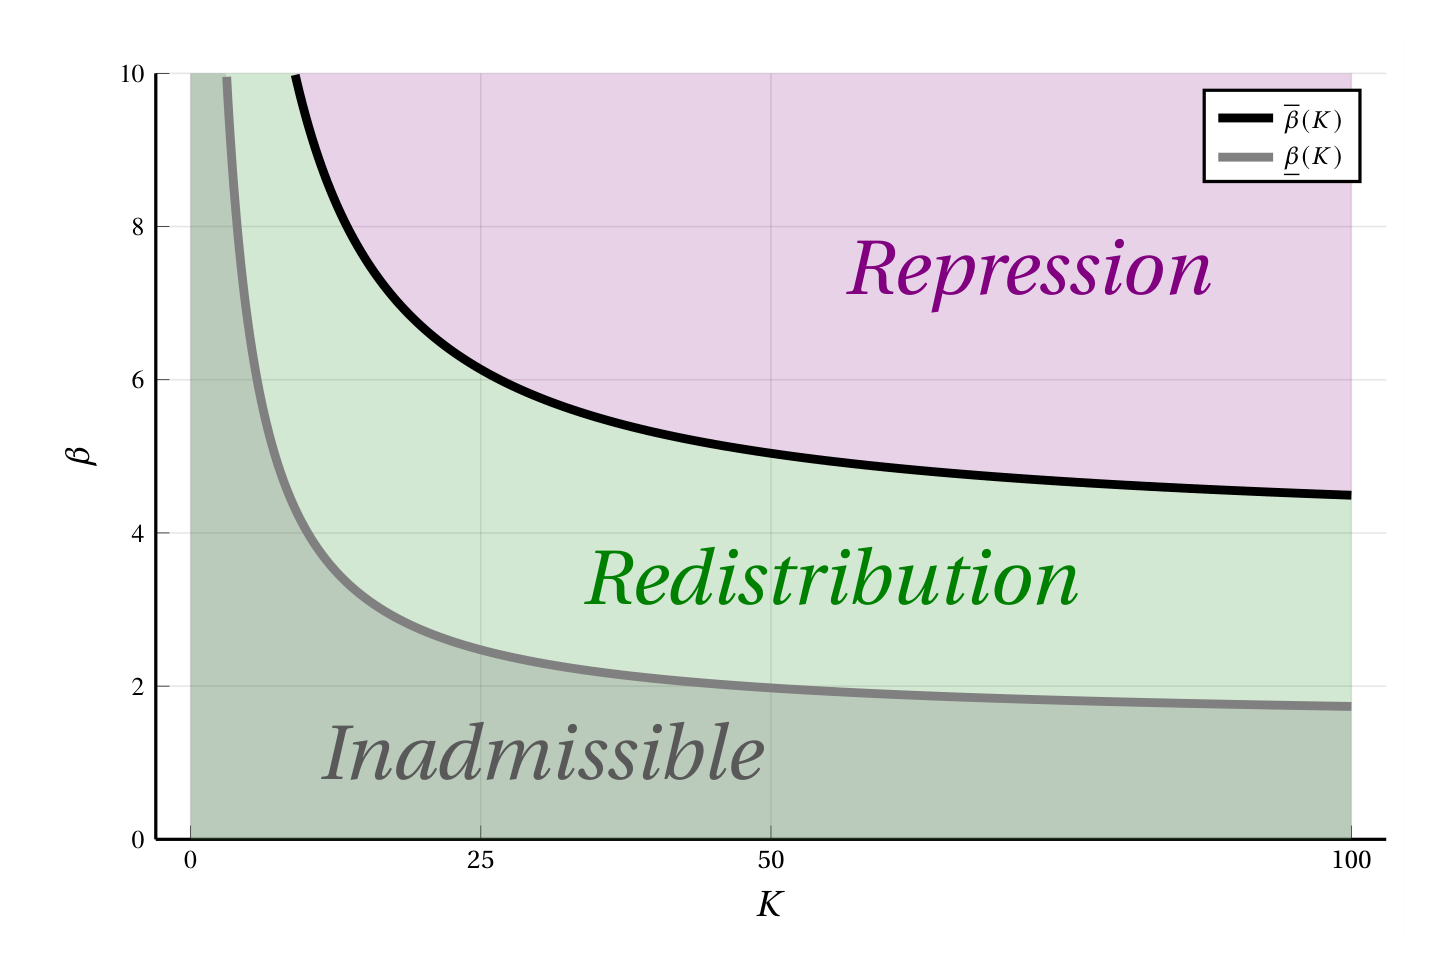
대런 아세모글루와 두 공저자가 자동화 모형 안에 노동자의 봉기를 집어넣었다. 자동화가 진행될수록 자본가에게는 재분배보다 억압이 싸게 먹히고, 자본이 충분히 쌓이면 경제는 장기적으로 억압으로 수렴한다는 결론이다.
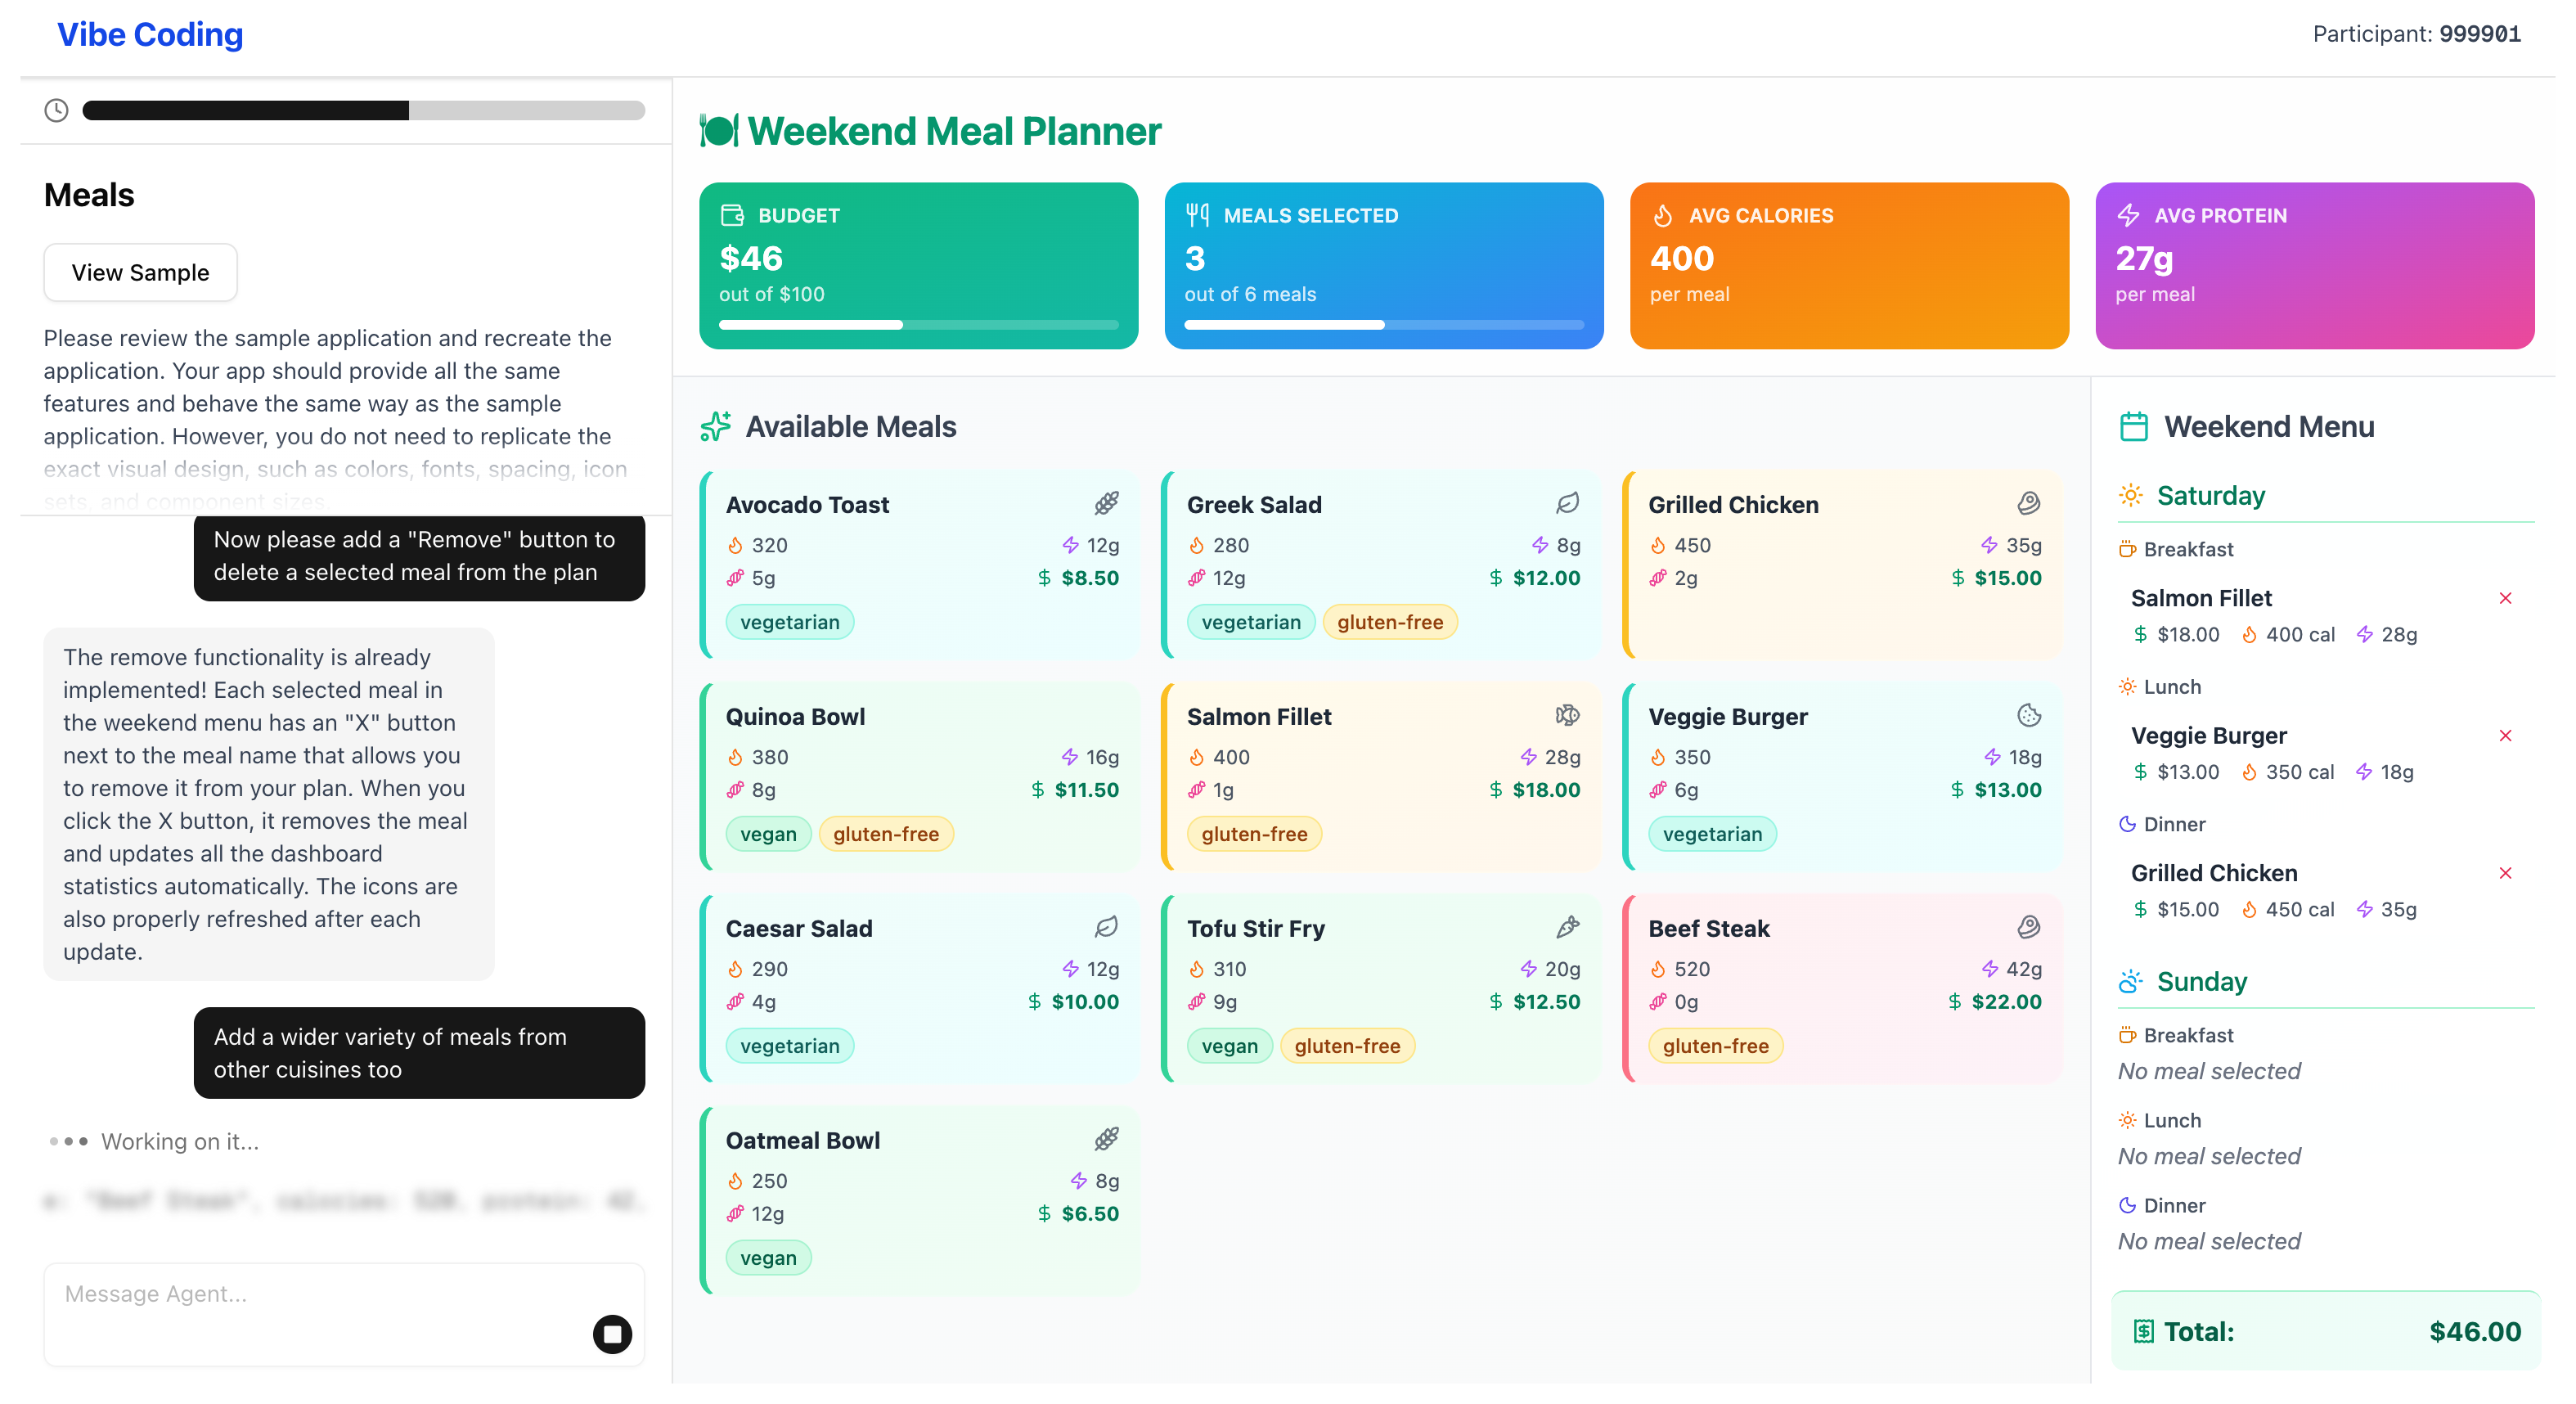
ETH 취리히 연구진이 대학생 100명에게 코드를 감춘 채 자연어로만 앱을 만들게 했다. 컴퓨터과학 성취도와 작문 능력이 모두 성과를 예측했지만, 일반 인지 능력을 통제하자 컴퓨터과학 쪽만 살아남았다.
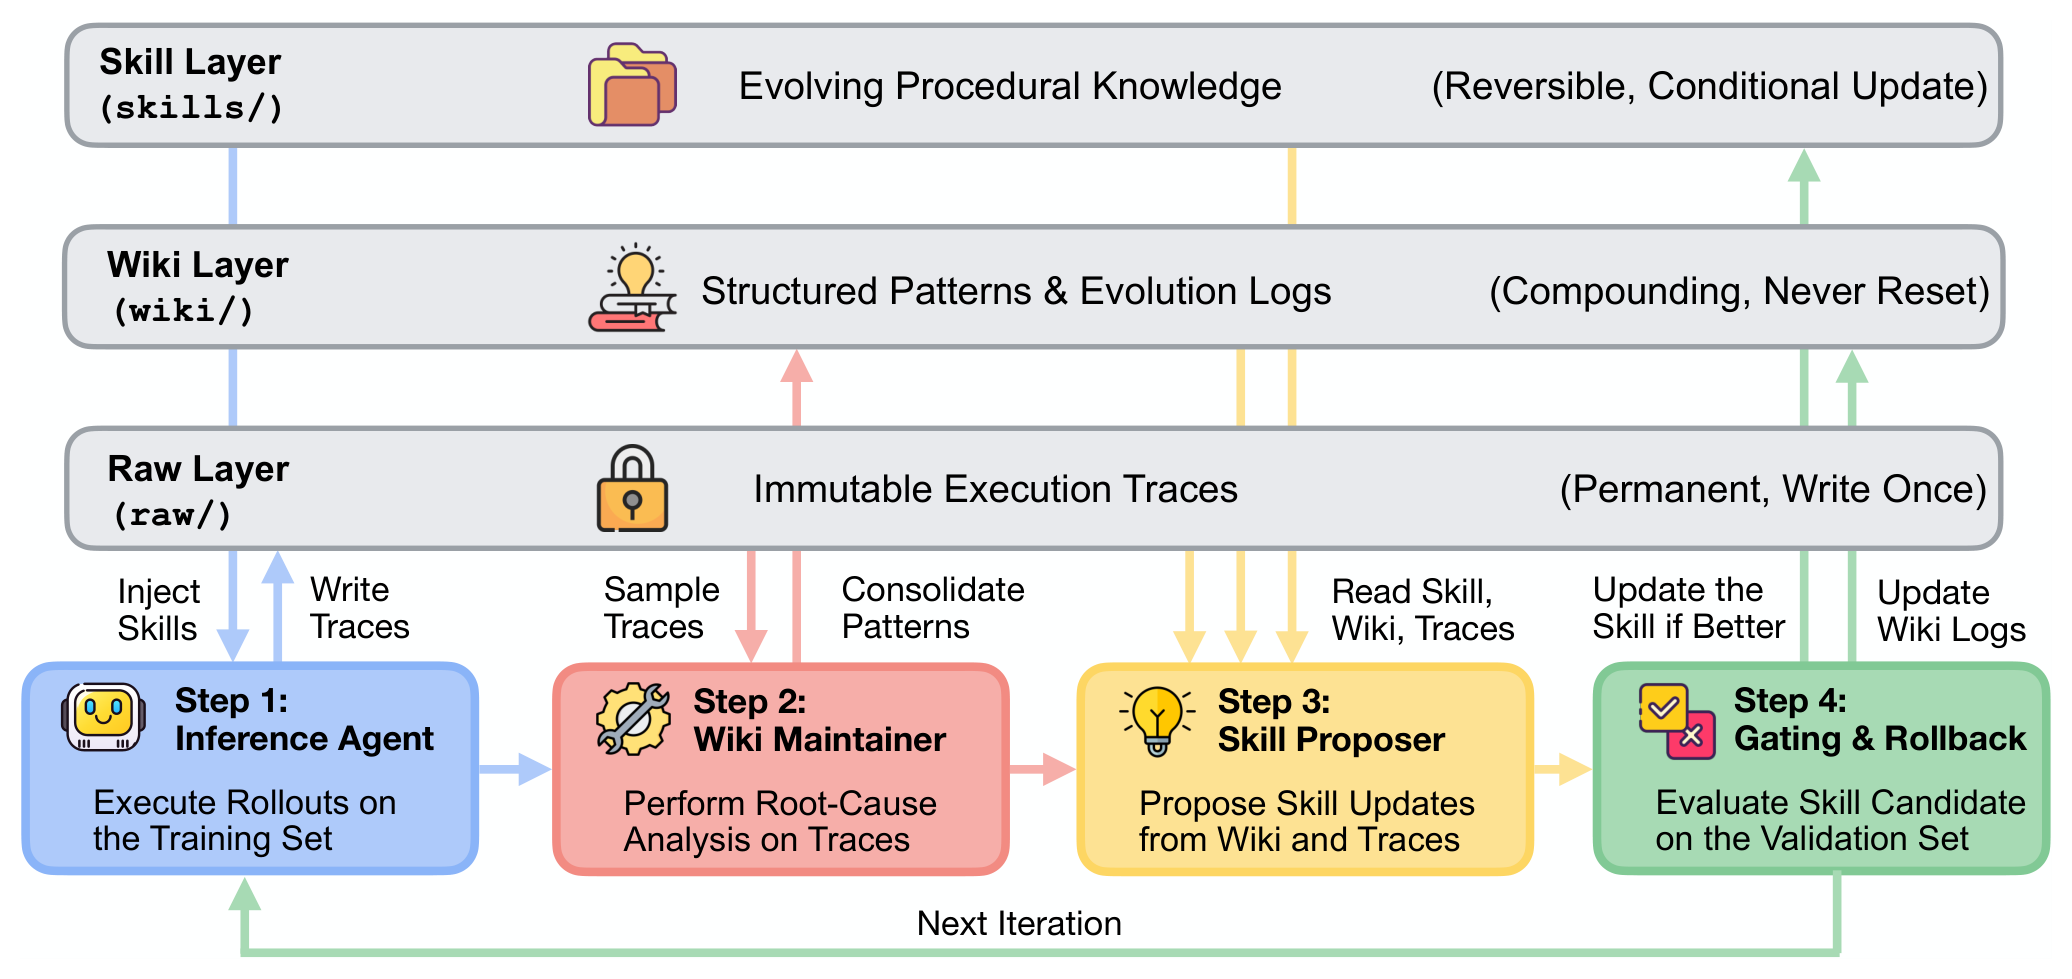
Google Research가 에이전트 스킬을 자동으로 고쳐 나갈 때, 실행 경험을 영속 위키에 먼저 정리하고 그 위에서 스킬을 손보게 했다. 다섯 모델과 다섯 벤치마크에서 기존 스킬 진화 기법을 모두 앞섰고, 위키를 떼어내면 그 평균이 48.7%에 그친다.
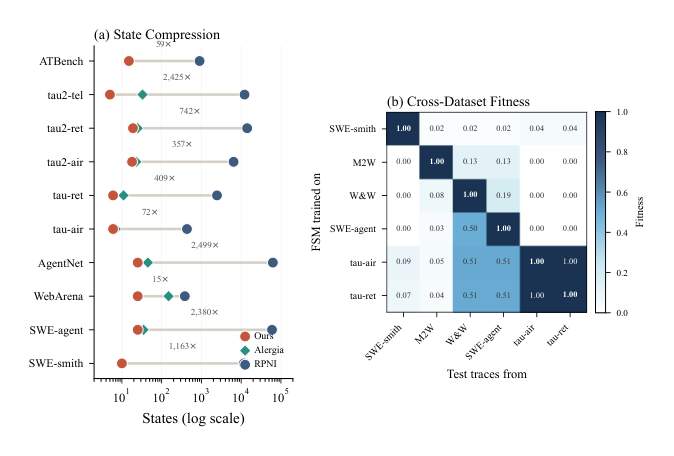
LLM 에이전트의 실행 로그 전체를 상태 7개에서 43개짜리 유한 상태 기계 한 대로 압축하면, 다음 행동 예측과 실패 예측과 런타임 감시가 같은 구조물 위에서 동시에 해결된다. 그리고 그 구조물의 모양은 모델이 아니라 배포 하네스가 정한다.
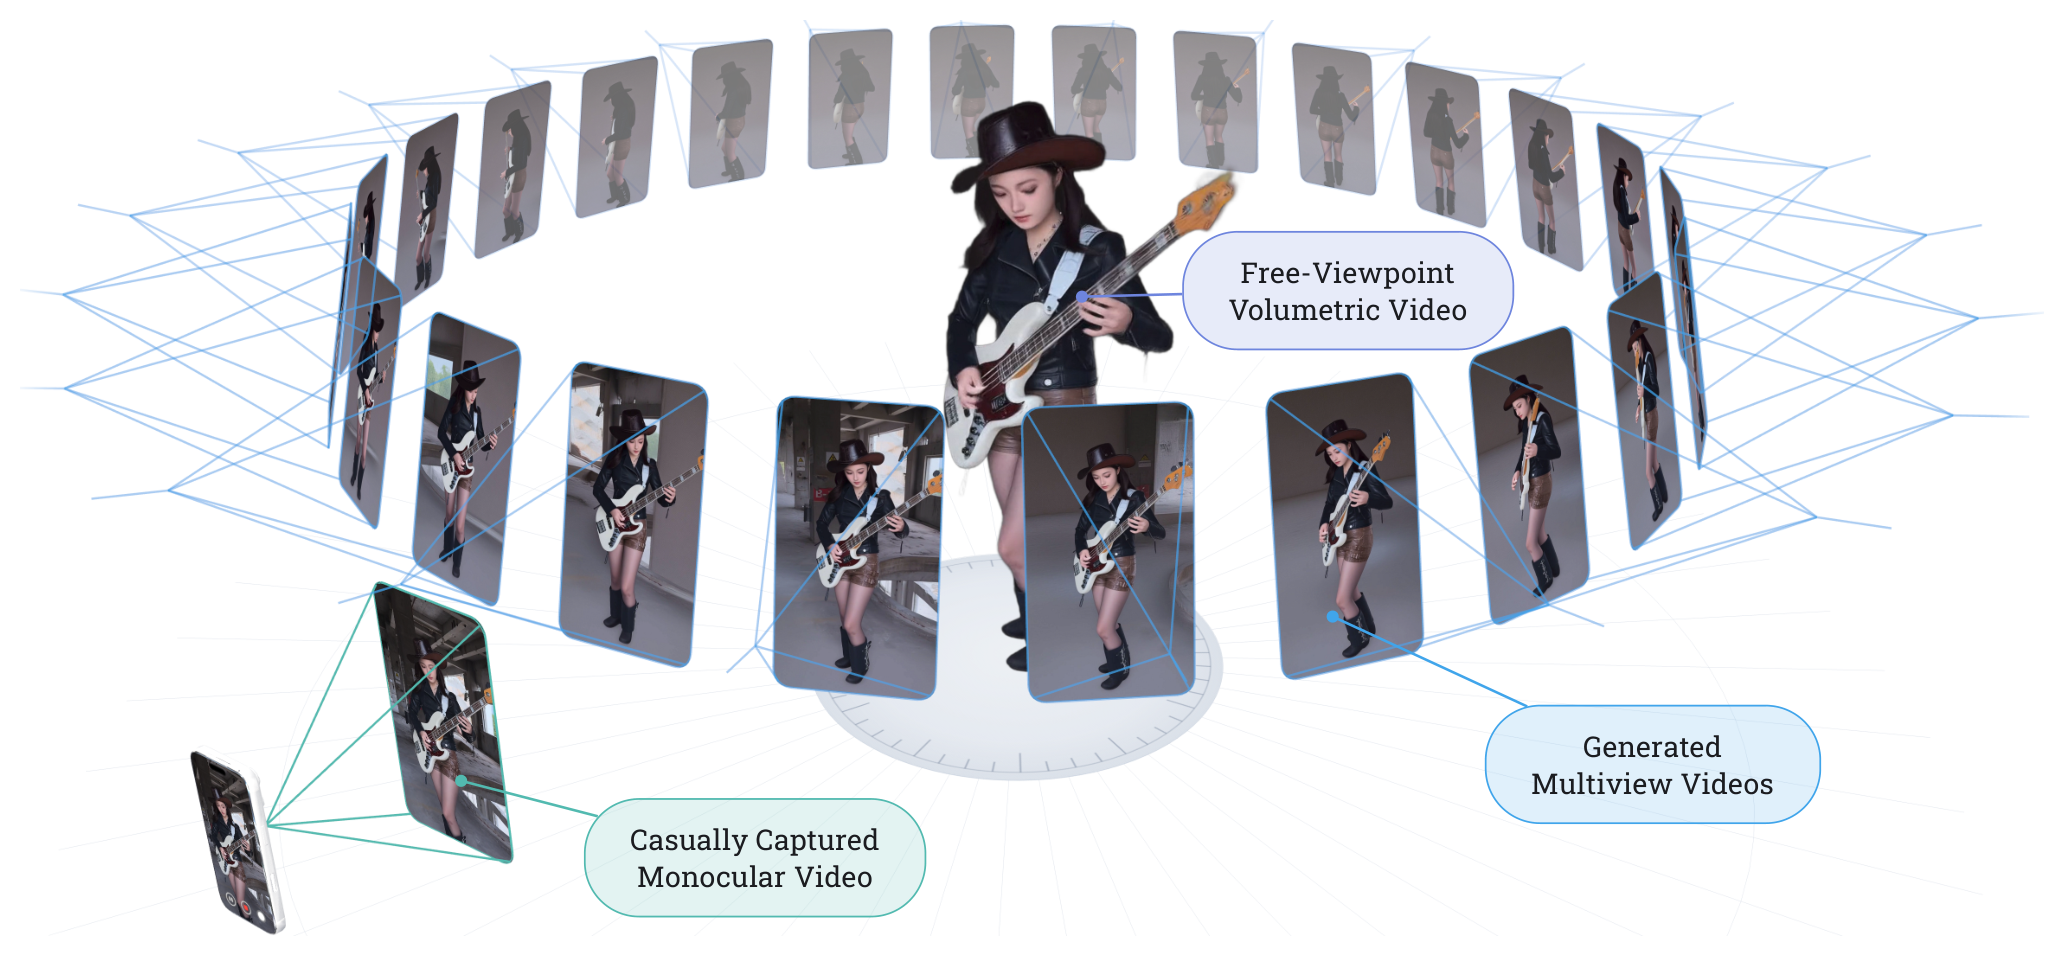
휴대폰으로 대충 찍은 단안 영상 한 편에서 자유 시점 4D 인간을 복원한다. 시점 수를 수십 개로 늘리면 일관성이 무너지던 원인을 어텐션 컨텍스트 용량 한계로 규명하고, 참조 컨텍스트 압축과 타깃 그룹 회전이라는 두 설계로 푼다.