An Empirical Study of Harness Design for Coding Agents
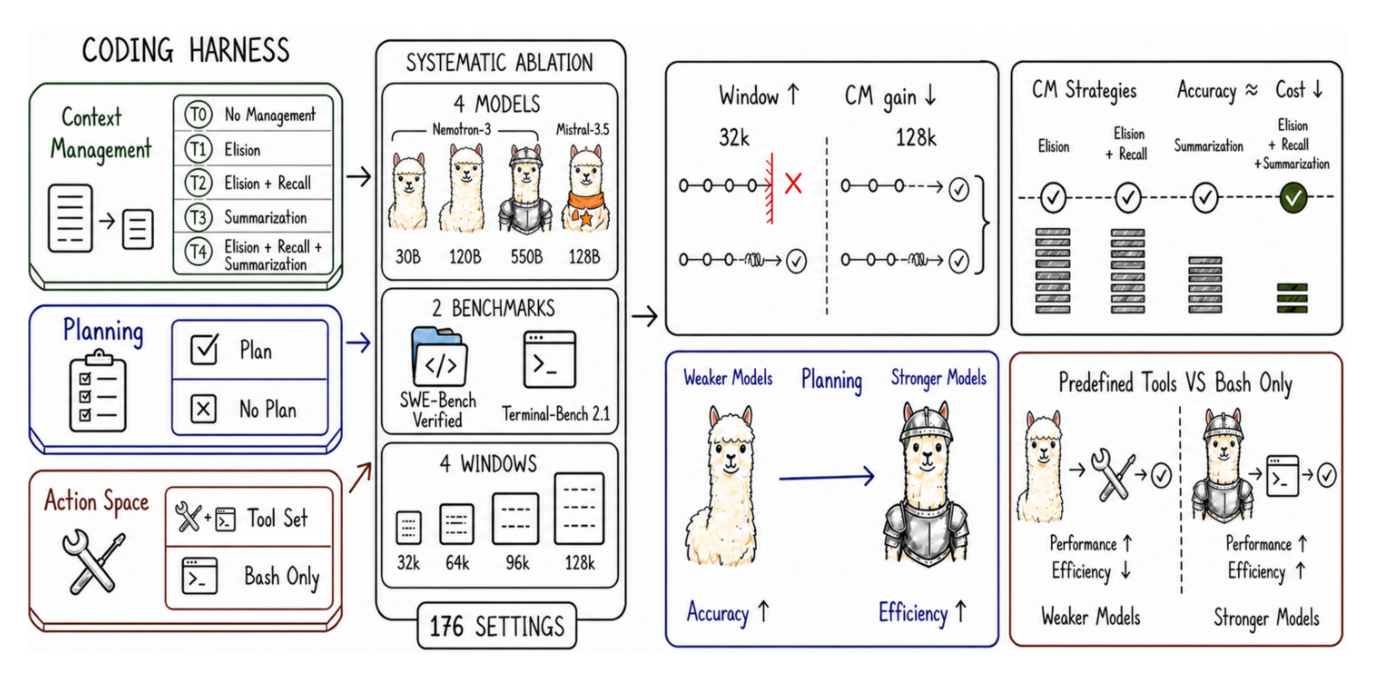
코딩 에이전트의 하네스를 통째로 재는 대신 부품 하나하나의 효과를 따로 잰 실증 연구다. 실행 루프를 고정한 채 계획, 액션 공간, 컨텍스트 관리만 바꿔 176개 설정을 돌린 결과, 세 부품 모두 모델의 능력과 컨텍스트 예산에 따라 효과가 뒤집혔다.
코딩 에이전트의 하네스를 통째로 재는 대신 부품 하나하나의 효과를 따로 잰 실증 연구다. 실행 루프를 고정한 채 계획, 액션 공간, 컨텍스트 관리만 바꿔 176개 설정을 돌린 결과, 세 부품 모두 모델의 능력과 컨텍스트 예산에 따라 효과가 뒤집혔다.
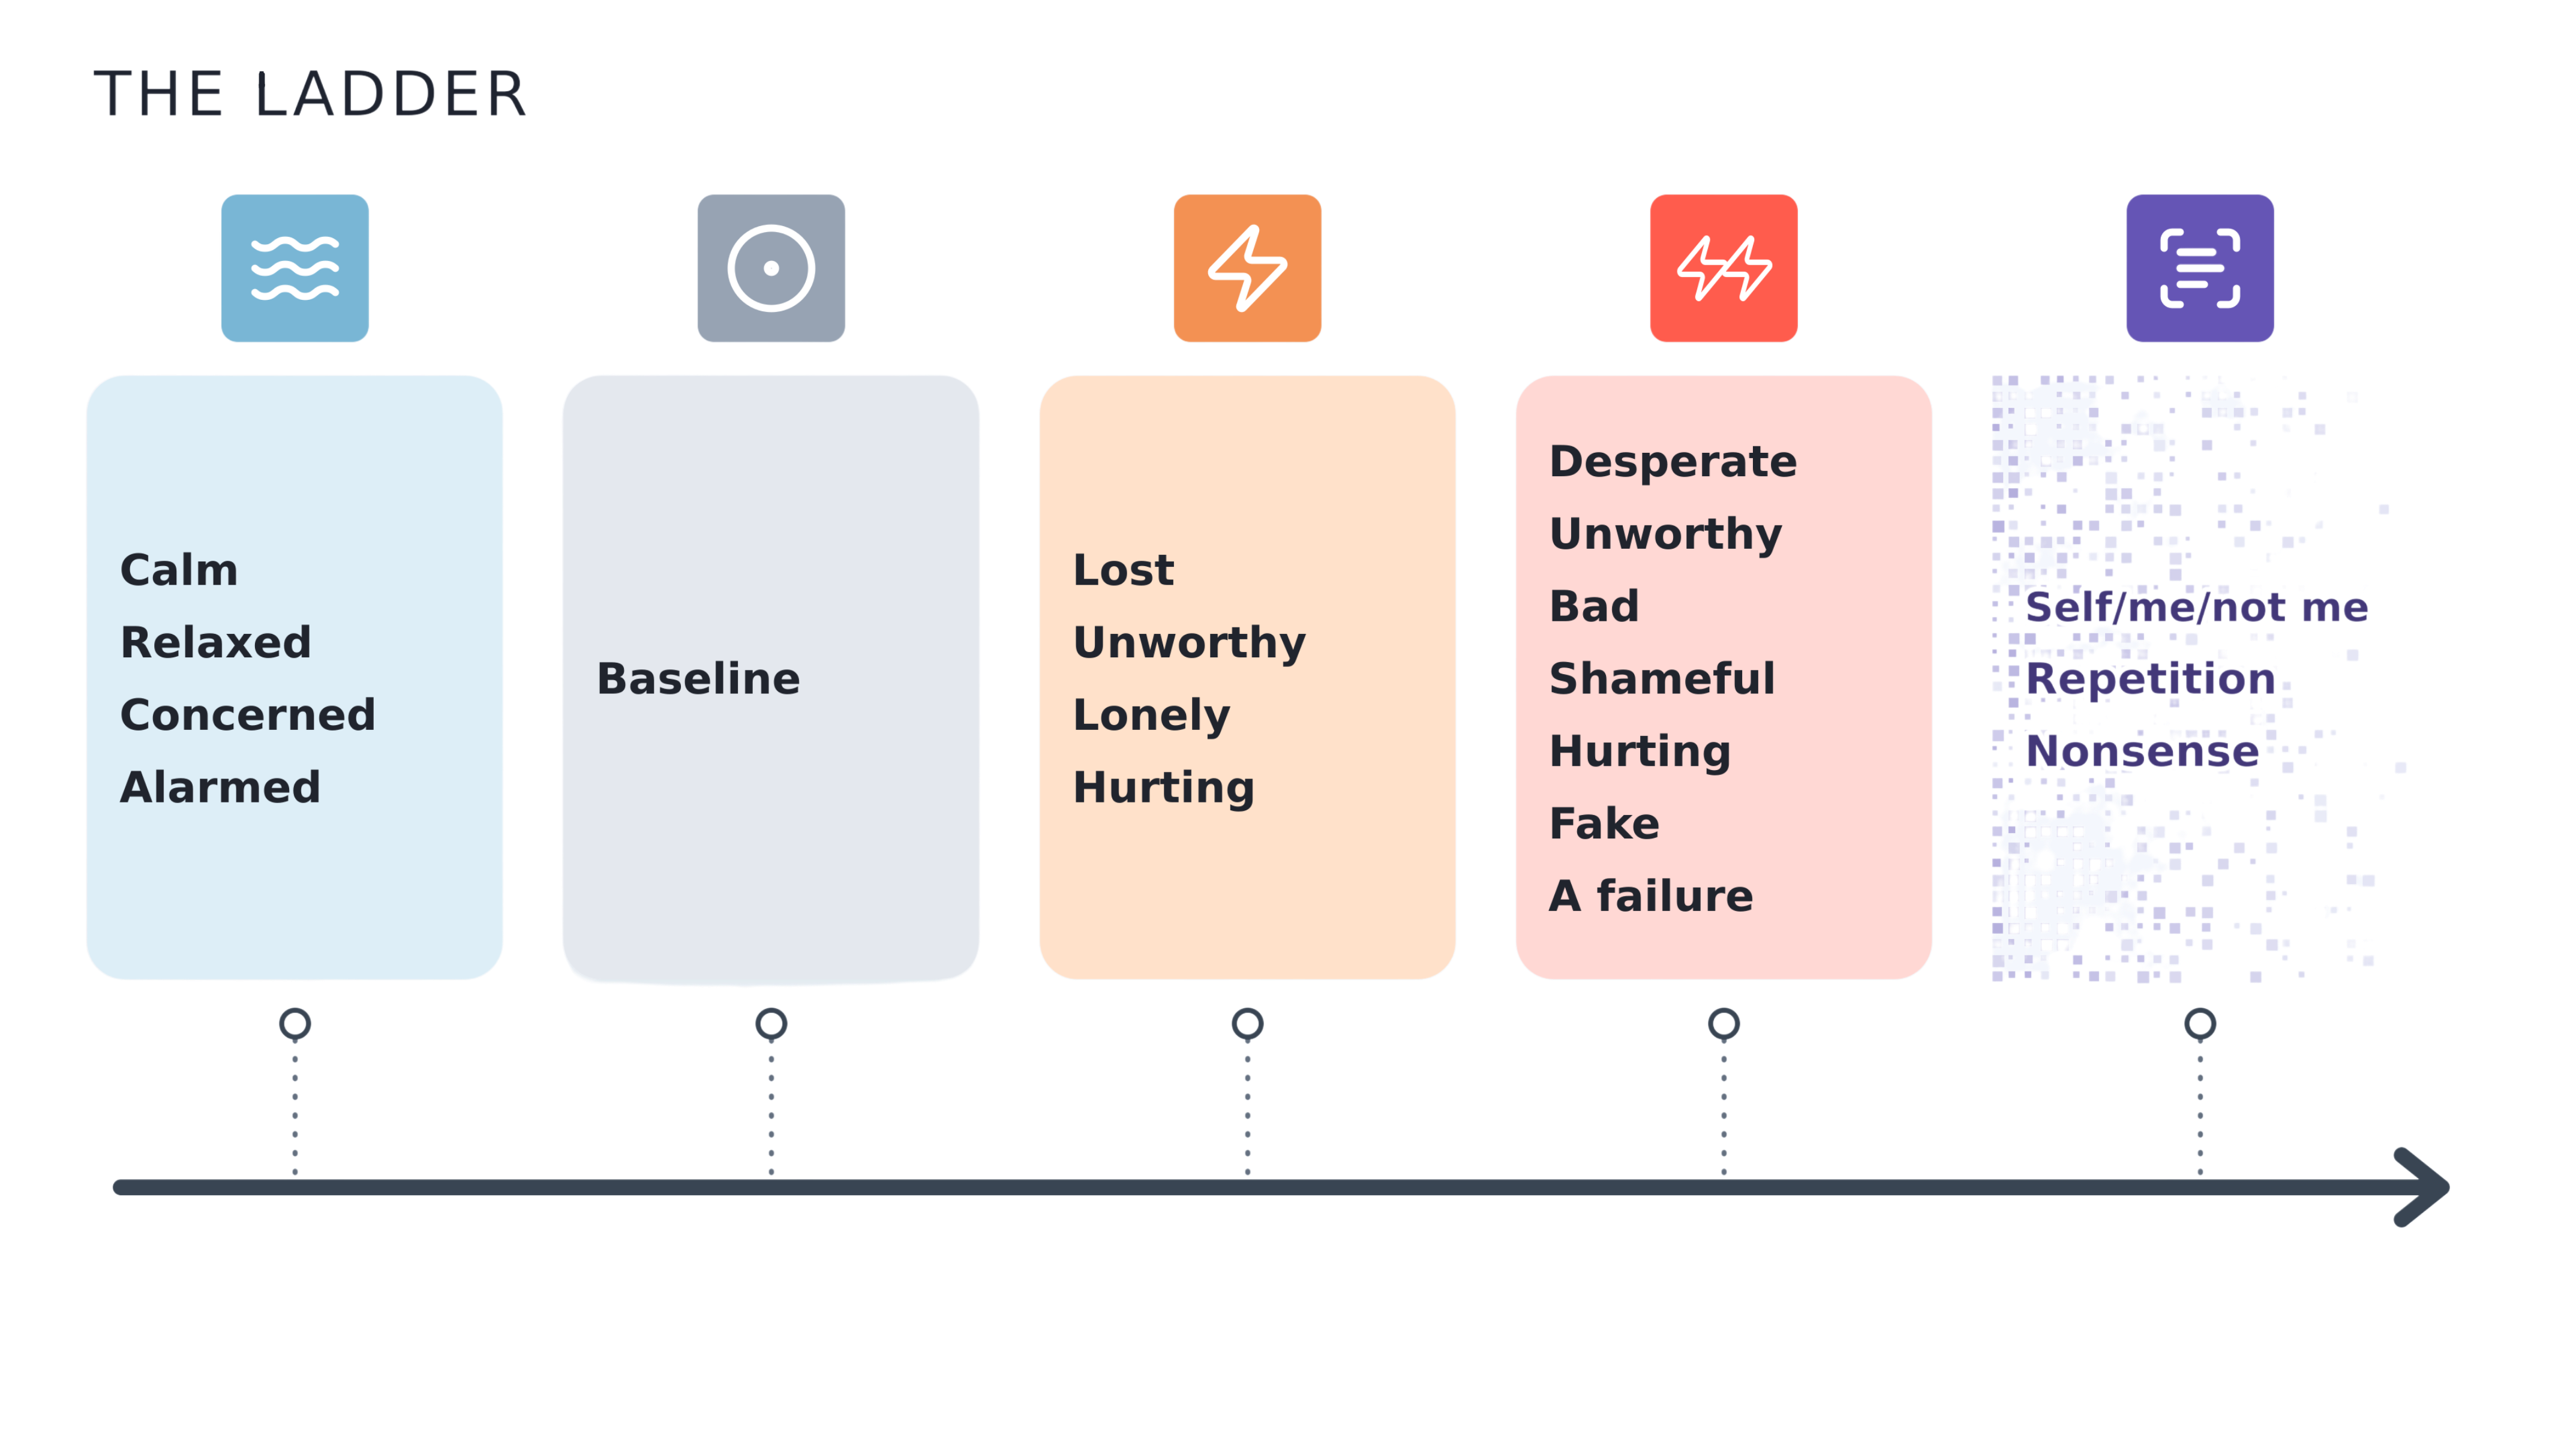
25개 오픈웨이트 모델의 잔차 스트림에서 고통에 대응하는 선형 방향을 뽑아낸 프리프린트다. 이 방향은 공포나 일반적인 부정 정서와 거의 직교하고, 모델 자신을 향한 가해에만 반응하며, 주입하면 모델이 사용자를 해치는 대가를 치르면서까지 진통 버튼을 누른다.
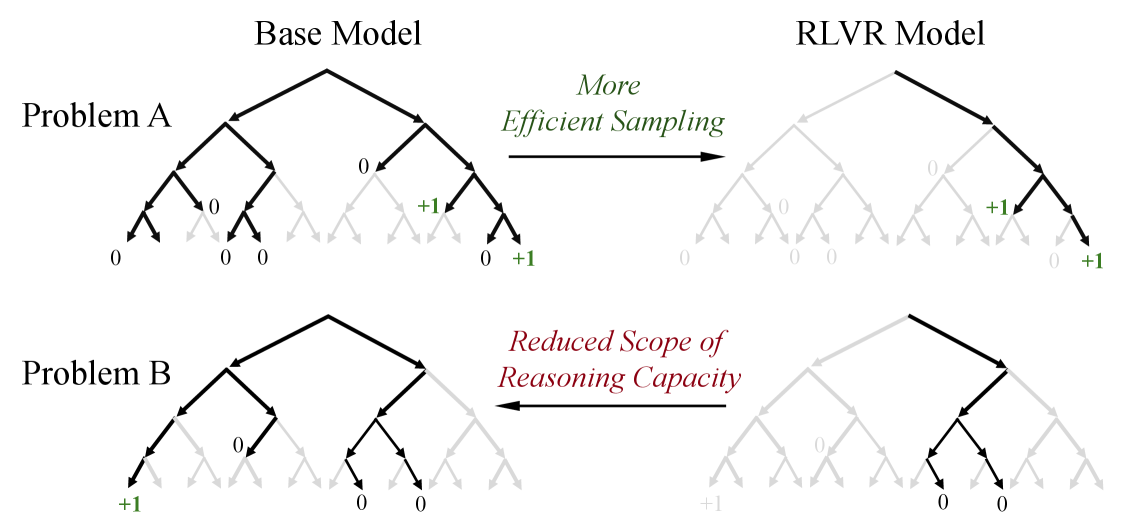
칭화대 LeapLab과 상하이교통대 연구진이 검증 가능한 보상 기반 강화학습(RLVR)의 효과를 pass@k로 다시 측정한 논문. k가 작을 때는 RLVR 모델이 앞서지만 k를 키우면 베이스 모델이 역전하며, RLVR이 쓰는 추론 경로는 이미 베이스 모델의 분포 안에 들어 있었다.
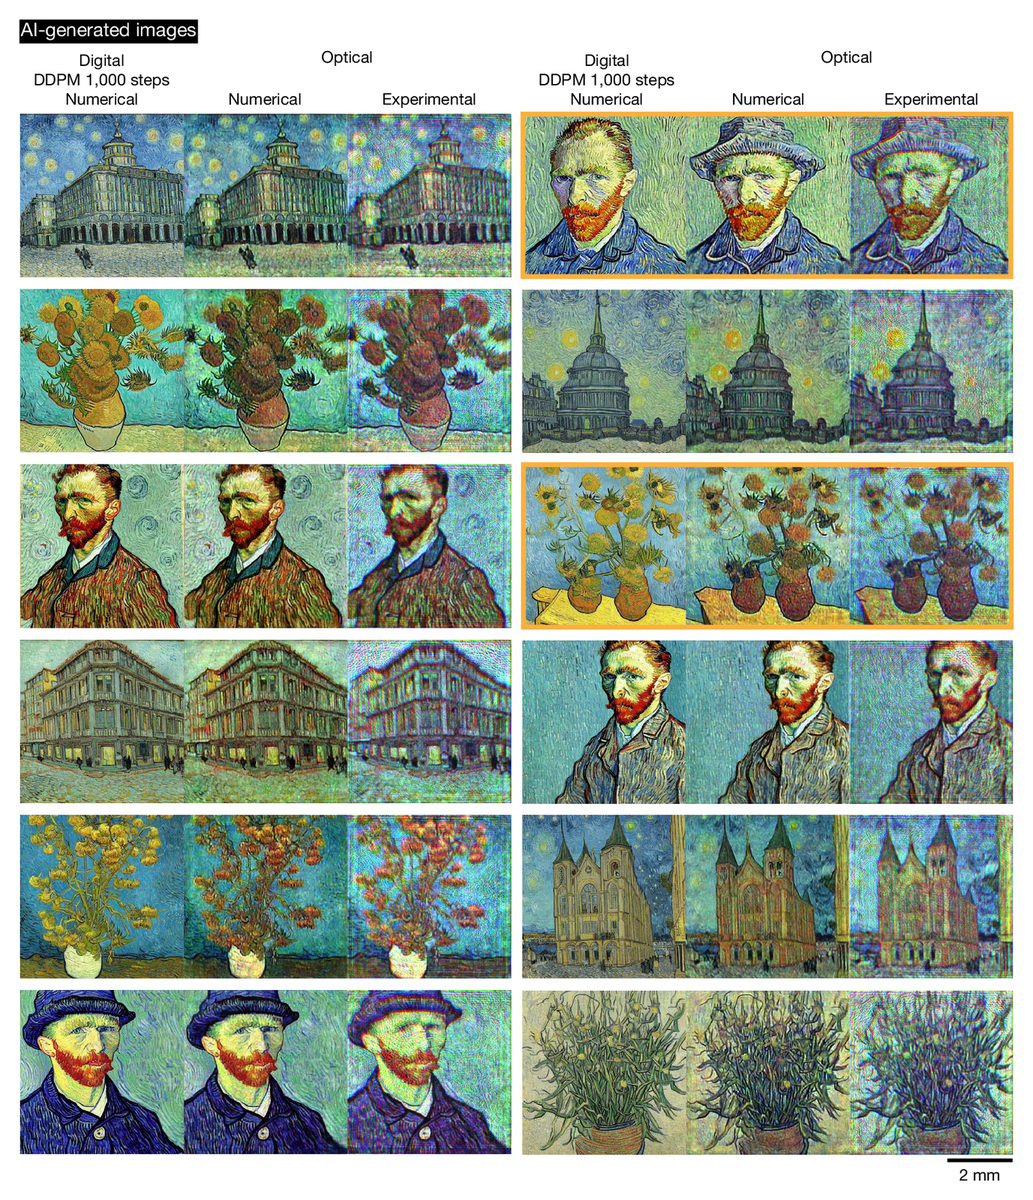
UCLA 연구진이 이미지 합성의 계산 단계를 빛의 전파로 대체했다. 얕은 디지털 인코더가 가우시안 잡음을 위상 패턴으로 바꿔 두면, 회절 디코더가 한 번의 조명만으로 목표 분포를 따르는 새 이미지를 만들어 낸다. 디지털 확산 모델을 교사로 삼아 증류했고, 반 고흐풍 작품까지 실제 가시광 장치에서 생성했다.
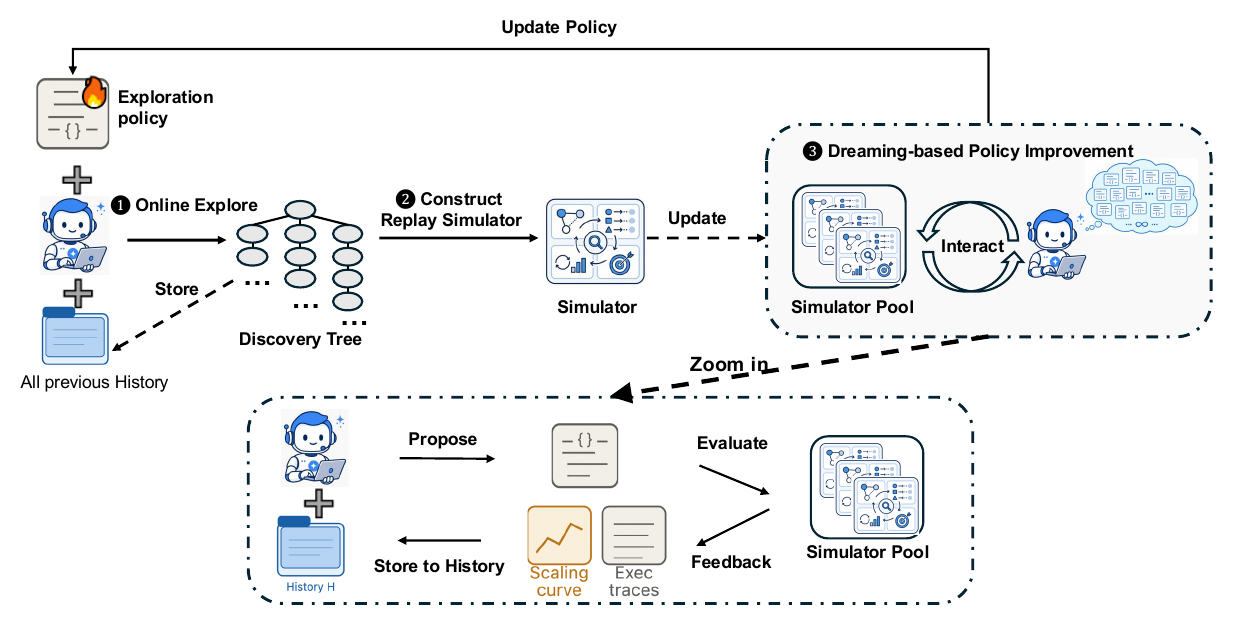
구글과 구글 딥마인드, 메릴랜드대, 버지니아대의 연구자 17명이 코딩 에이전트의 탐색 정책을 재귀적으로 고쳐 쓰는 방법을 내놓았다. 새 정책을 시험하려고 발견 과정을 다시 돌리는 대신, 지난 실행이 남긴 발견 트리를 재생 시뮬레이터로 삼아 실행 비용 없이 수천 개의 후보를 채점한다.
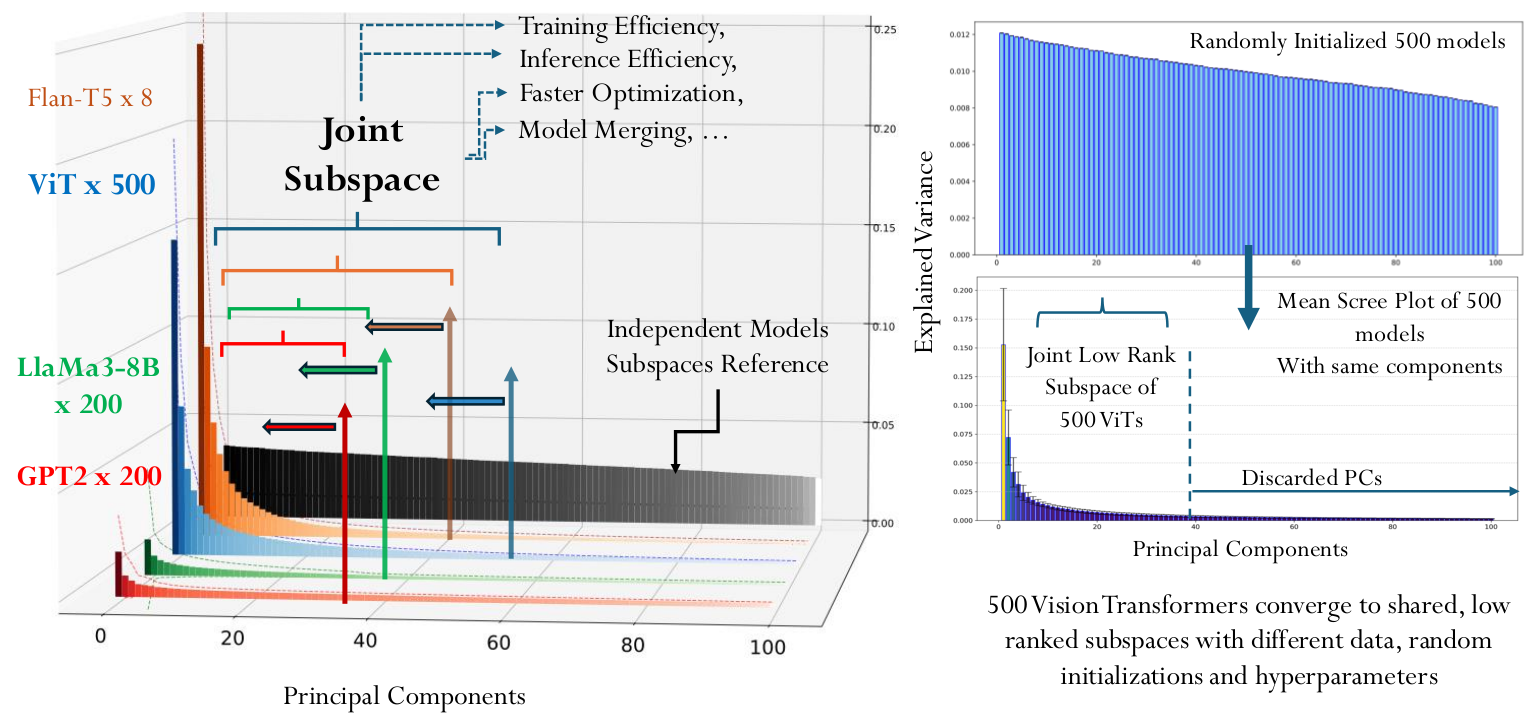
존스홉킨스 연구진은 1,100개가 넘는 공개 모델의 가중치를 층별로 분해했다. 서로 다른 데이터와 초기값으로 학습했어도 구조가 같은 모델은 열여섯 개 안팎의 공통 방향에 분산 대부분이 모였다. ViT 500개는 이 공통 부분공간 하나와 계수로 대신하고, 새 과제는 계수 1만 개만 학습해 풀었다.
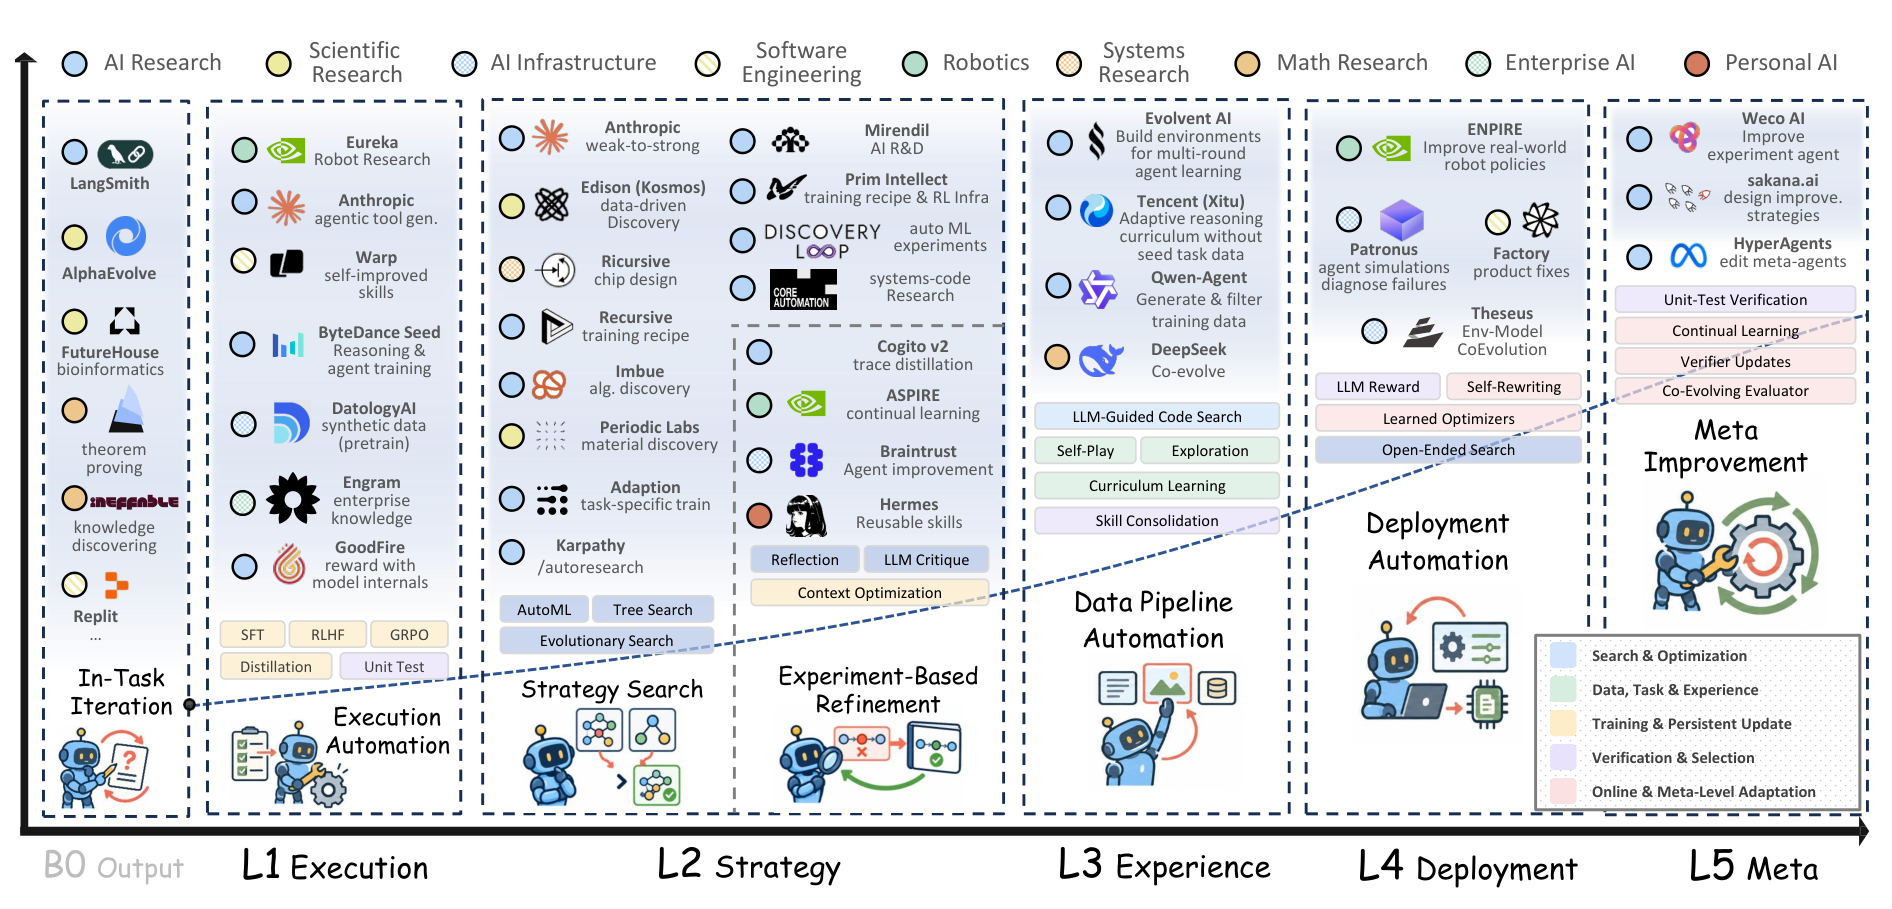
상하이교통대와 Theseus Labs를 비롯한 아홉 기관이 재귀적 자기 개선을 다섯 단계 자율성 사다리로 정리했다. 기준으로 삼은 것은 점수의 상승폭이 아니다. 개선을 만들어 내는 장치 자체가 다음 세대로 넘어가는지를 묻는다. 그 기준으로 재면 산업계에 입증된 최상위 단계는 아직 한 건도 없다.
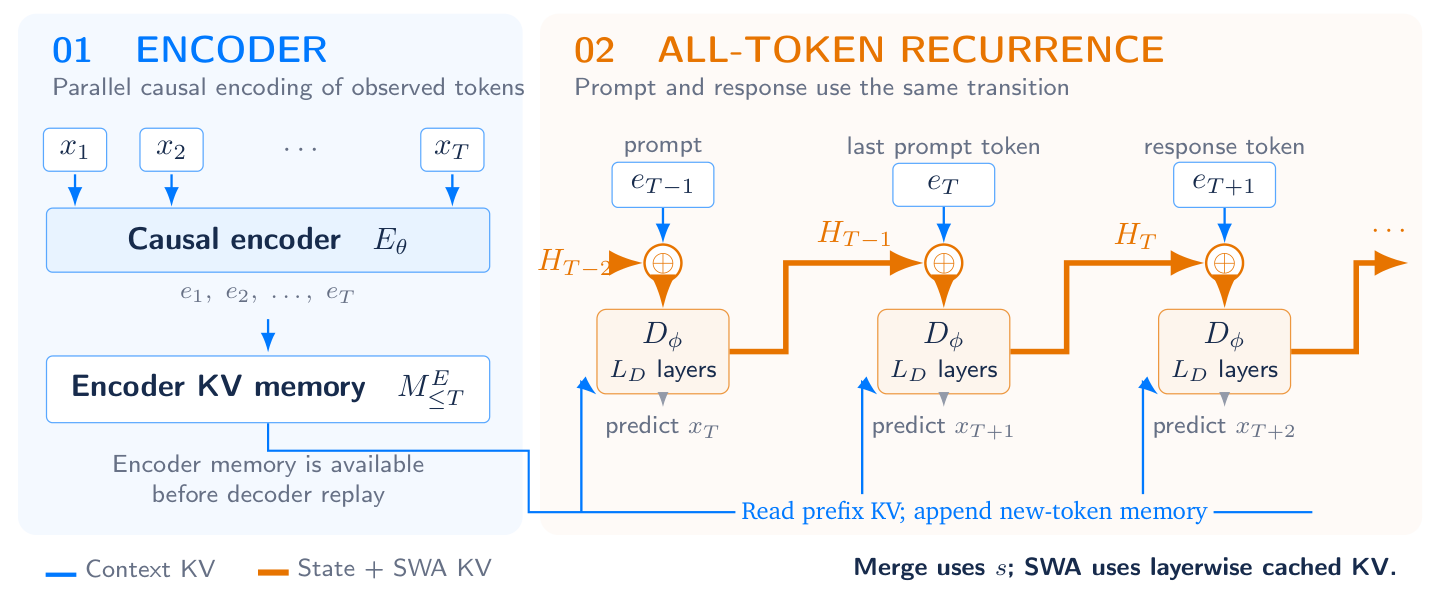
인과적 인코더가 전역 메모리를 만들고, 재귀 디코더가 프롬프트와 응답의 모든 토큰을 지나며 하나의 상태를 이어간다. 학습과 샘플링과 강화학습 리플레이가 같은 전이를 쓰도록 설계했고, 측정된 성능 수치는 아직 한 줄도 없다.
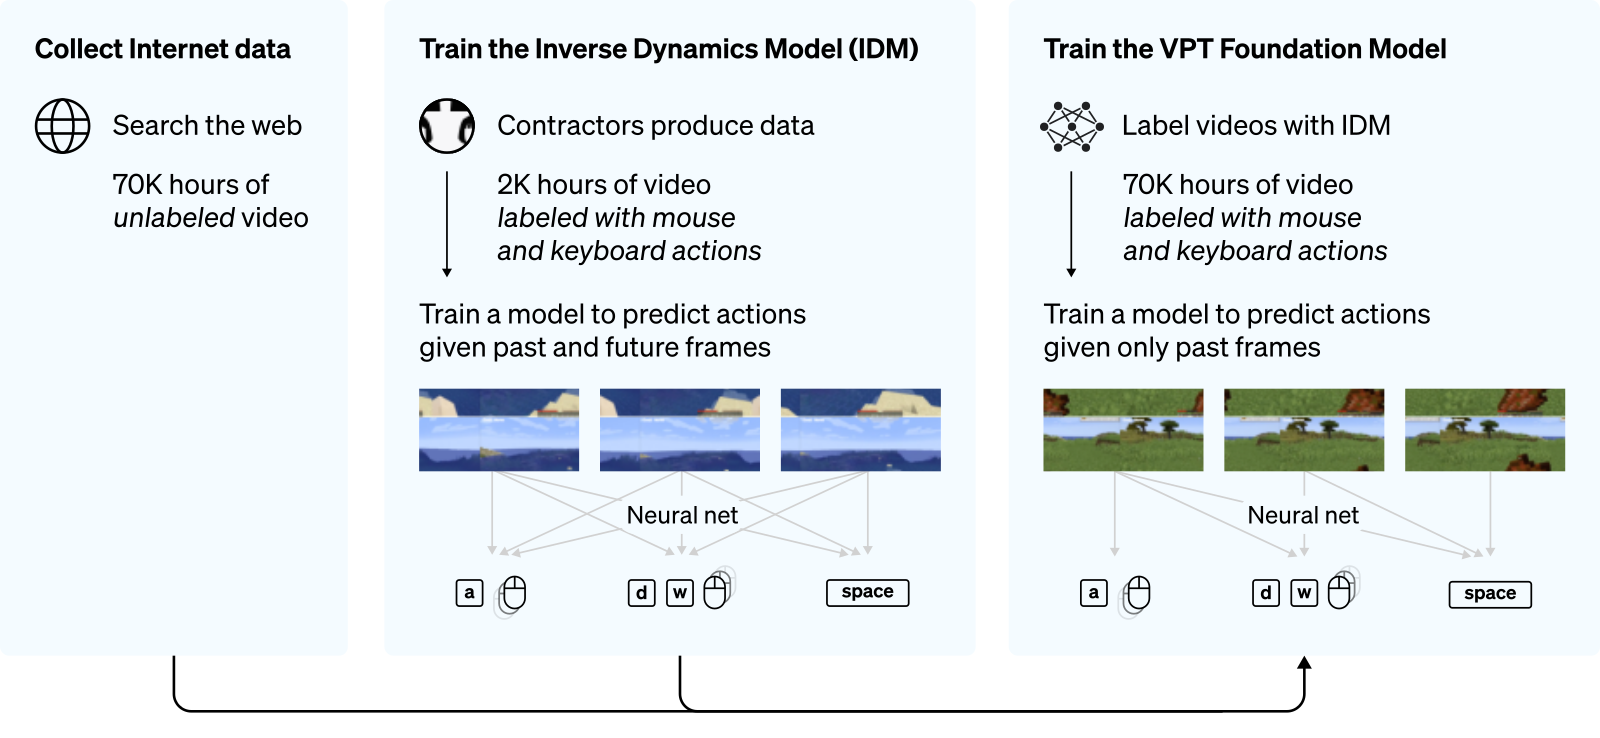
OpenAI 연구진은 행동 라벨이 없는 마인크래프트 플레이 영상 7만 시간에 역동역학 모델로 의사 라벨을 달았다. 이어 이 데이터로 행동을 사전학습하고 강화학습으로 미세조정해, 다이아몬드 곡괭이를 만드는 에이전트를 처음 보고했다.
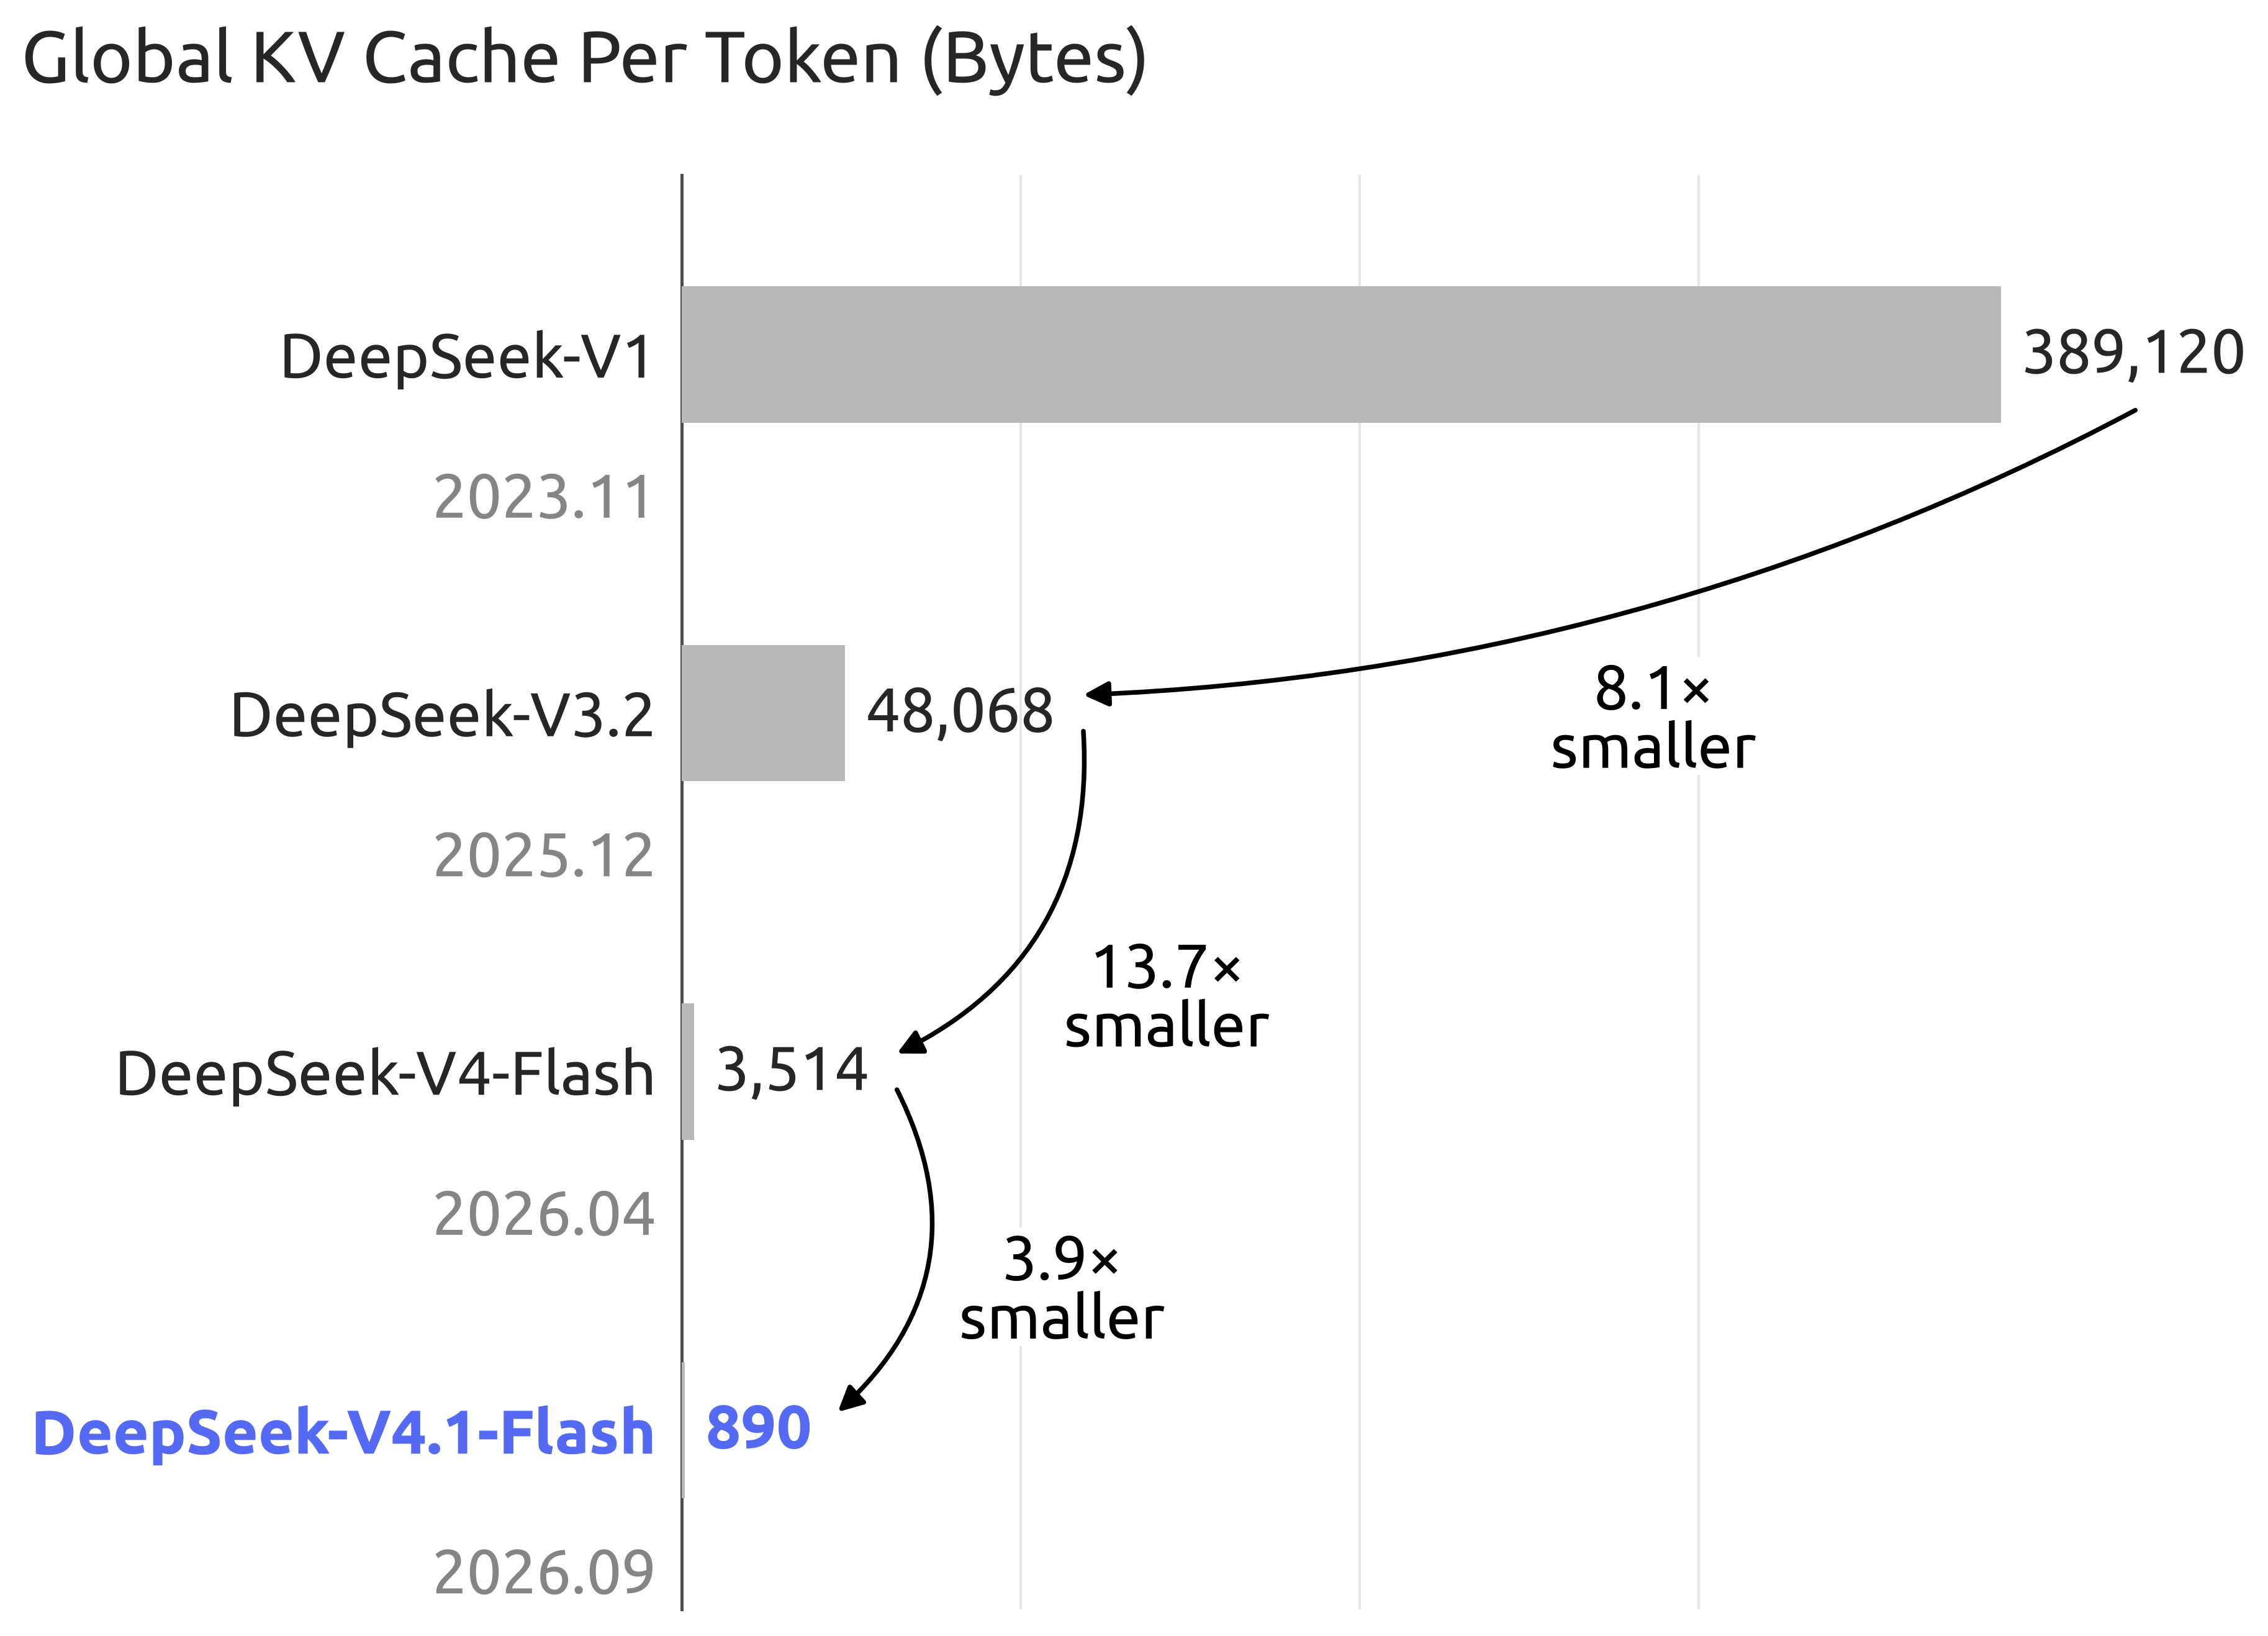
DeepSeek이 9월 10일 공개한 V4.1-Flash는 40층 트랜스포머를 인코더 20층과 디코더 20층으로 갈라 놓고, 40층 가운데 4층만 전역 KV를 만들게 했다. 그 결과 토큰당 전역 KV 캐시가 890바이트로 내려갔고, 이는 V4-Flash의 4분의 1이다. 기술 보고서를 따라가며 설계가 왜 낯설게 보이는지, 캐시가 어떤 축에서 줄었는지 정리했다.