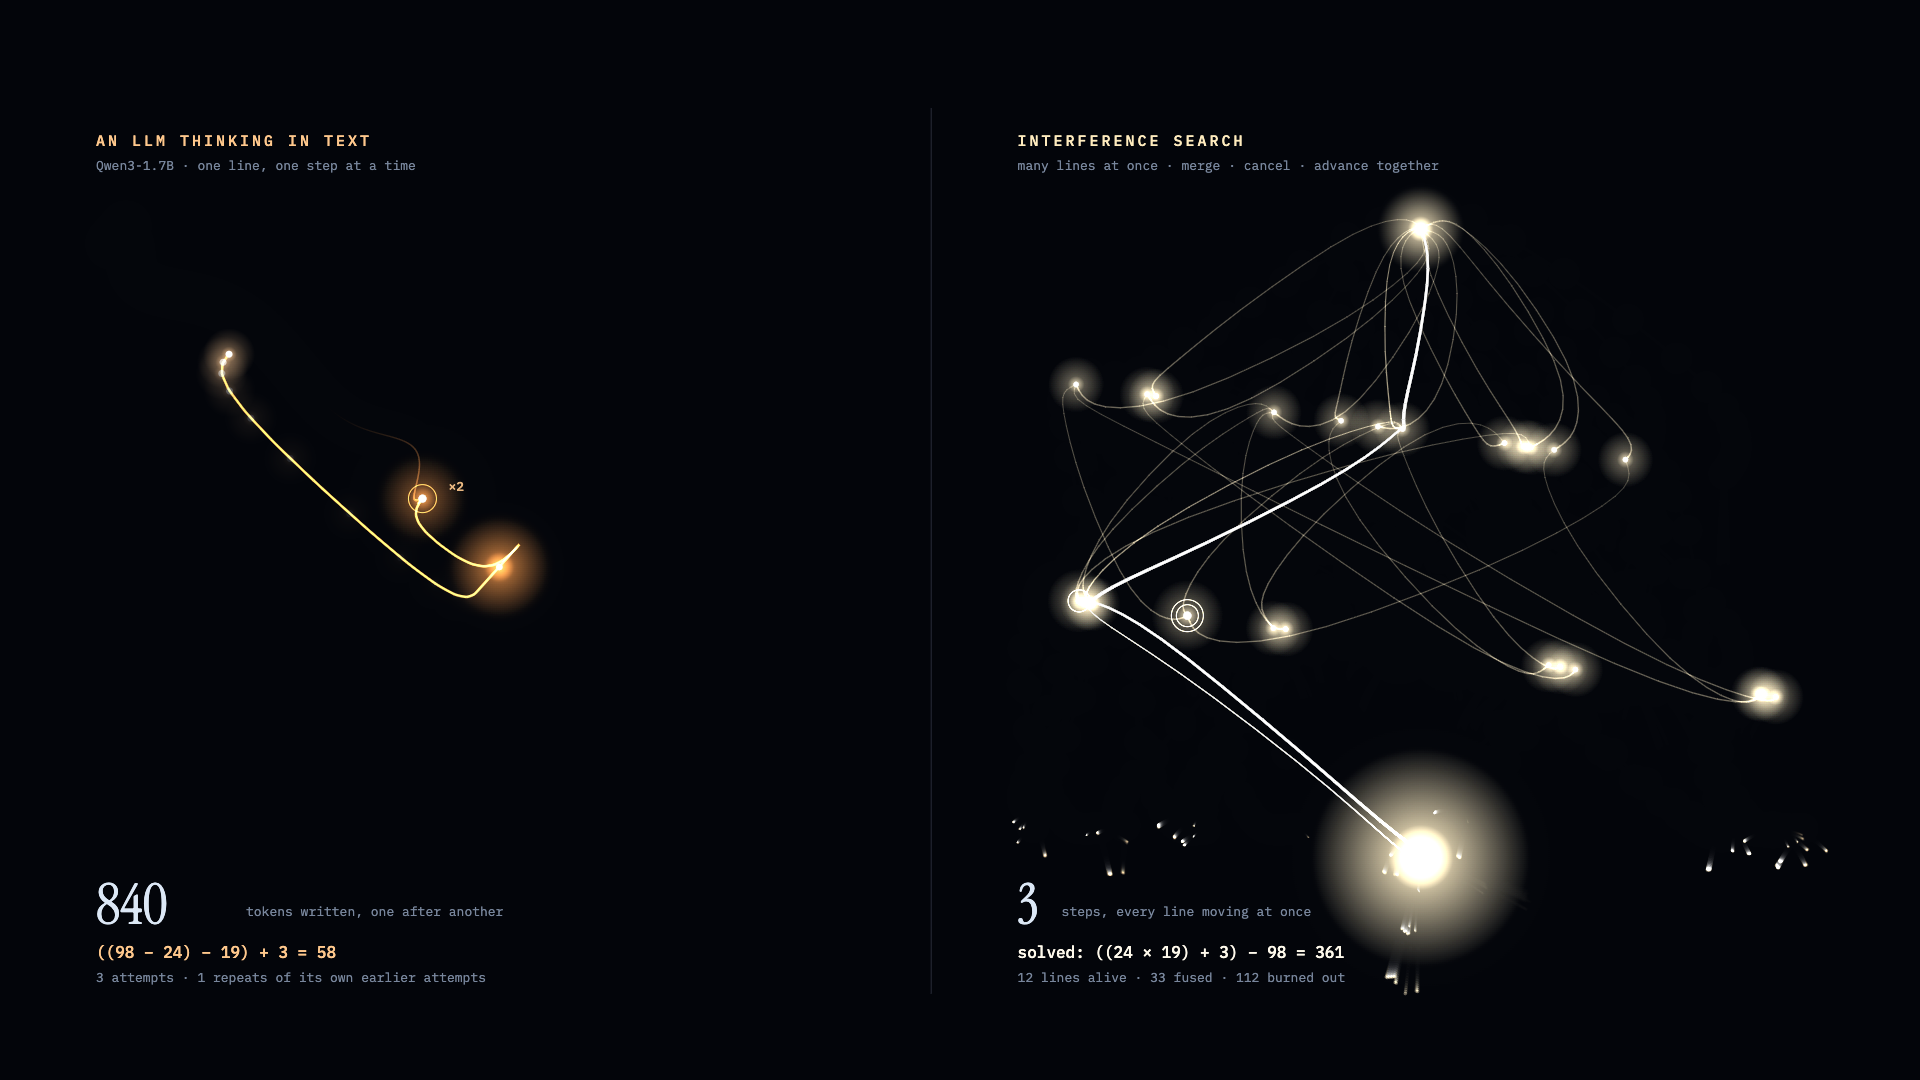
같은 카운트다운 문제를 두 방식으로 푸는 원문 그림 1. 왼쪽은 Qwen3-1.7B가 텍스트로 추론한 기록으로, 840토큰을 쓰는 동안 시도 3개 중 1개가 자기 이전 시도의 반복이다. 오른쪽은 Interference Search로, 여러 분기를 동시에 전개하고 중복을 병합해 3단계 만에 ((24 × 19) + 3) − 98 = 361을 찾는다. 출처: Badtheorylabs/interference-search, Apache 2.0

Interference Search: Reasoning over merged states, many branches at once

라고스(Lagos)에 있는 연구소 Bad Theory Labs가 언어 모델의 한 줄짜리 추론 대신 명시적 상태 위에서 여러 분기를 한꺼번에 전개하고, 같은 상태는 병합하고, 작은 판정기로 막다른 분기를 제거하는 탐색 방식을 공개했다. 어려운 카운트다운 30문제에서 같은 판정기와 같은 예산으로 단일 사슬은 21문제, 이 방식은 30문제를 풀었고, 필요한 순차 단계는 23.7에서 3으로 줄었다. 코드 과제에서는 차이가 잡음 수준이었고, 언어 모델을 학습시키는 일은 다음 단계로 남았다.
September 26, 2026 · 15 분 · 서소영
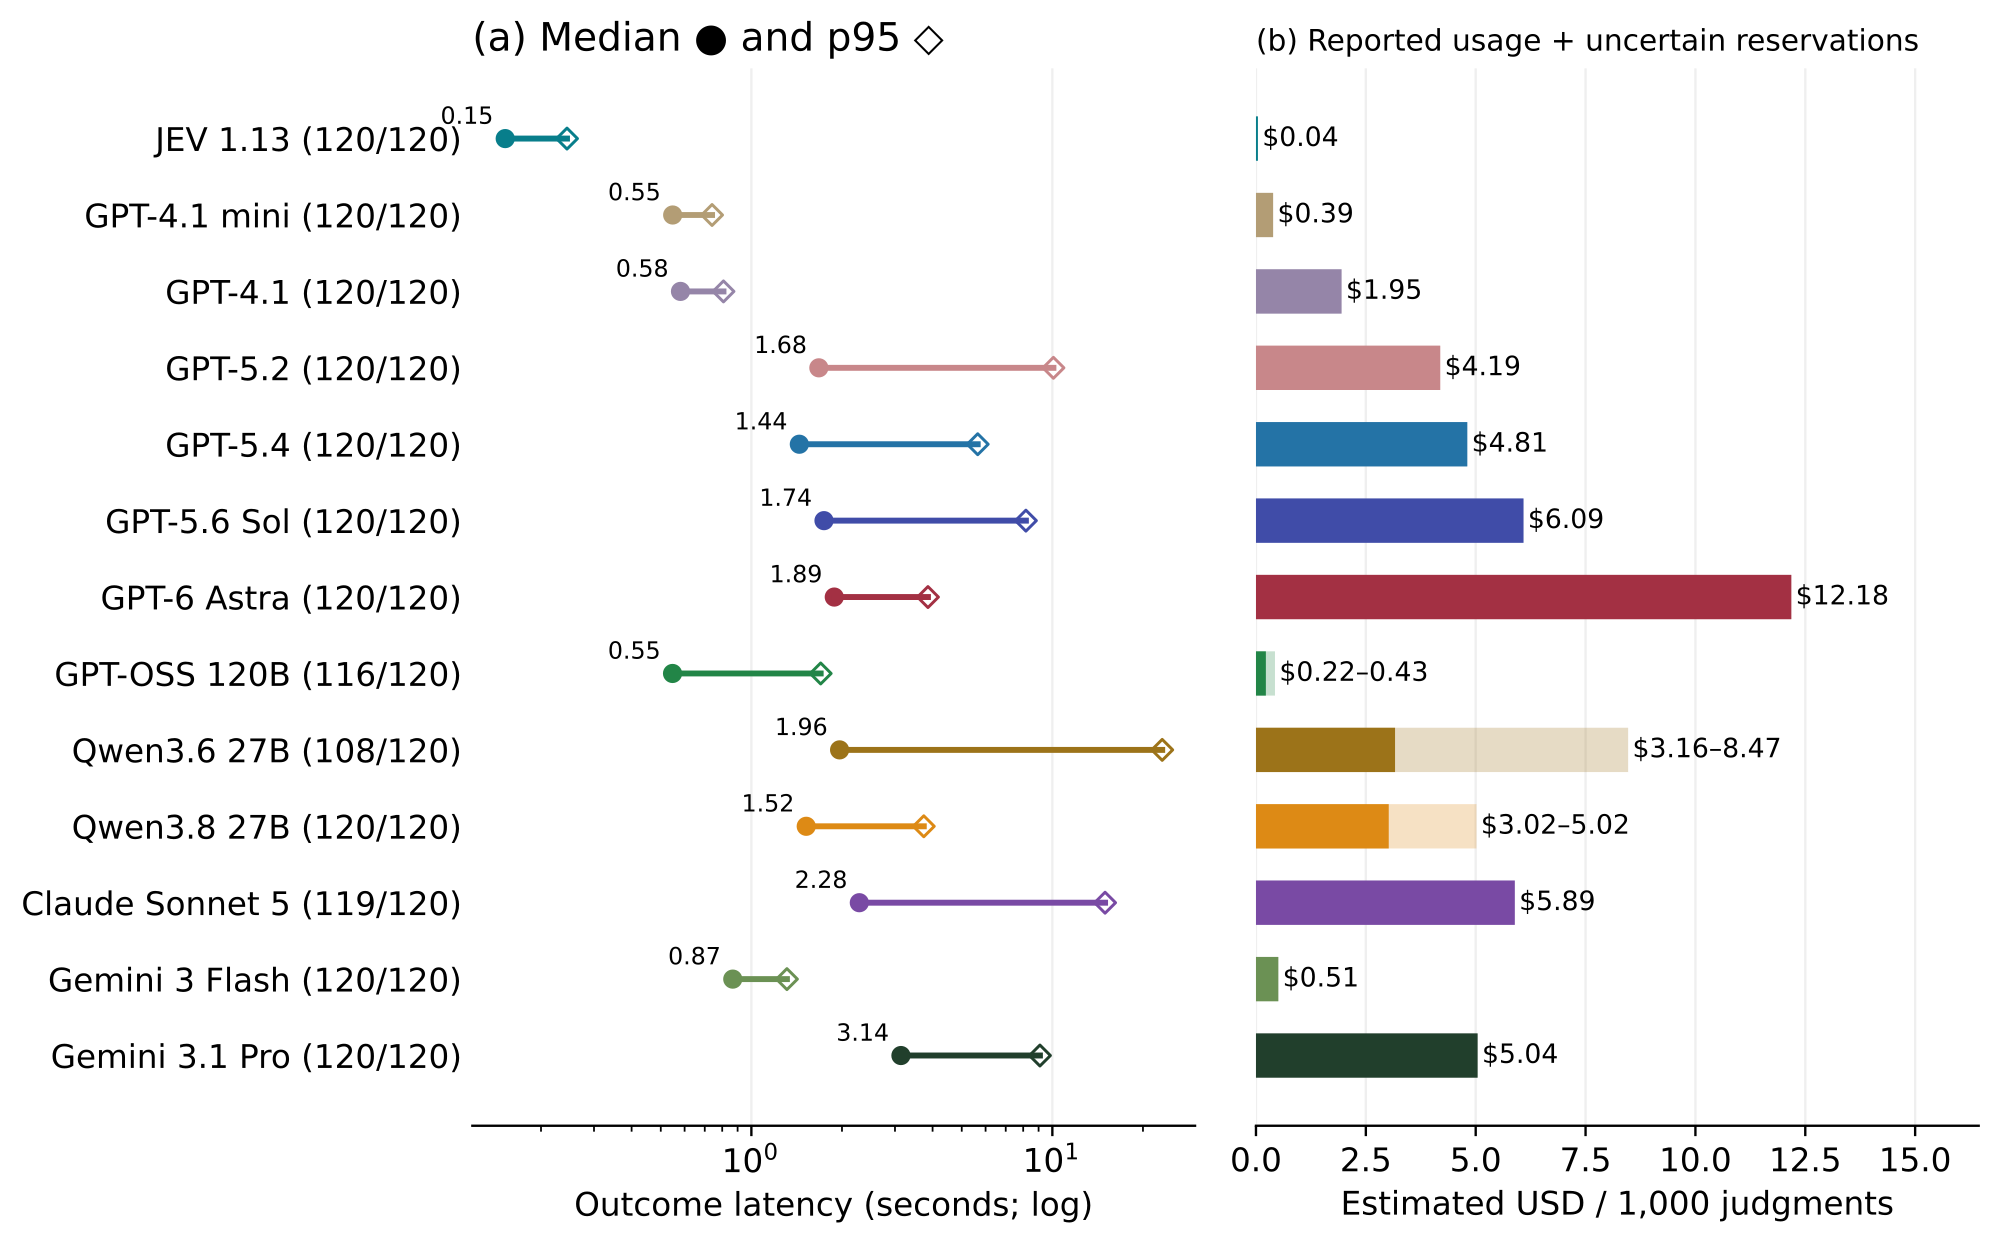
호스팅 판정자 13종의 지연과 비용을 비교한 원문 그림 2. 왼쪽 패널은 로그 척도로 그린 판정 지연의 중앙값과 95퍼센타일이며, JEV 1.13의 중앙값이 0.15초로 가장 짧다. 오른쪽 패널은 판정 1,000건당 추정 비용이며, JEV가 0.04달러, GPT-6 Astra가 12.18달러다. 출처: Li et al., arXiv:2609.26550, CC BY 4.0

JEV-as-a-Judge: Accept When Confident, Escalate When Unsure

카네기멜런대 연구진이 판정과 레이블 확률만 반환하는 TypeSafe의 JEV를 LLM 판정자로 쓰고, 생성형 판정자와 보상 모델 16종과 비교했다. 일반적인 선호 판정과 근거 문서 기반 사실성 판정에서 JEV는 GPT-6 Astra와 3%포인트 이내의 정확도를 GPT-6 비용의 0.36%로 냈다. 확신할 때만 JEV 판정을 채택하는 캐스케이드는 GPT-6 정확도의 99%를 비용 57%로 유지했다.

September 25, 2026 · 16 분 · 서소영
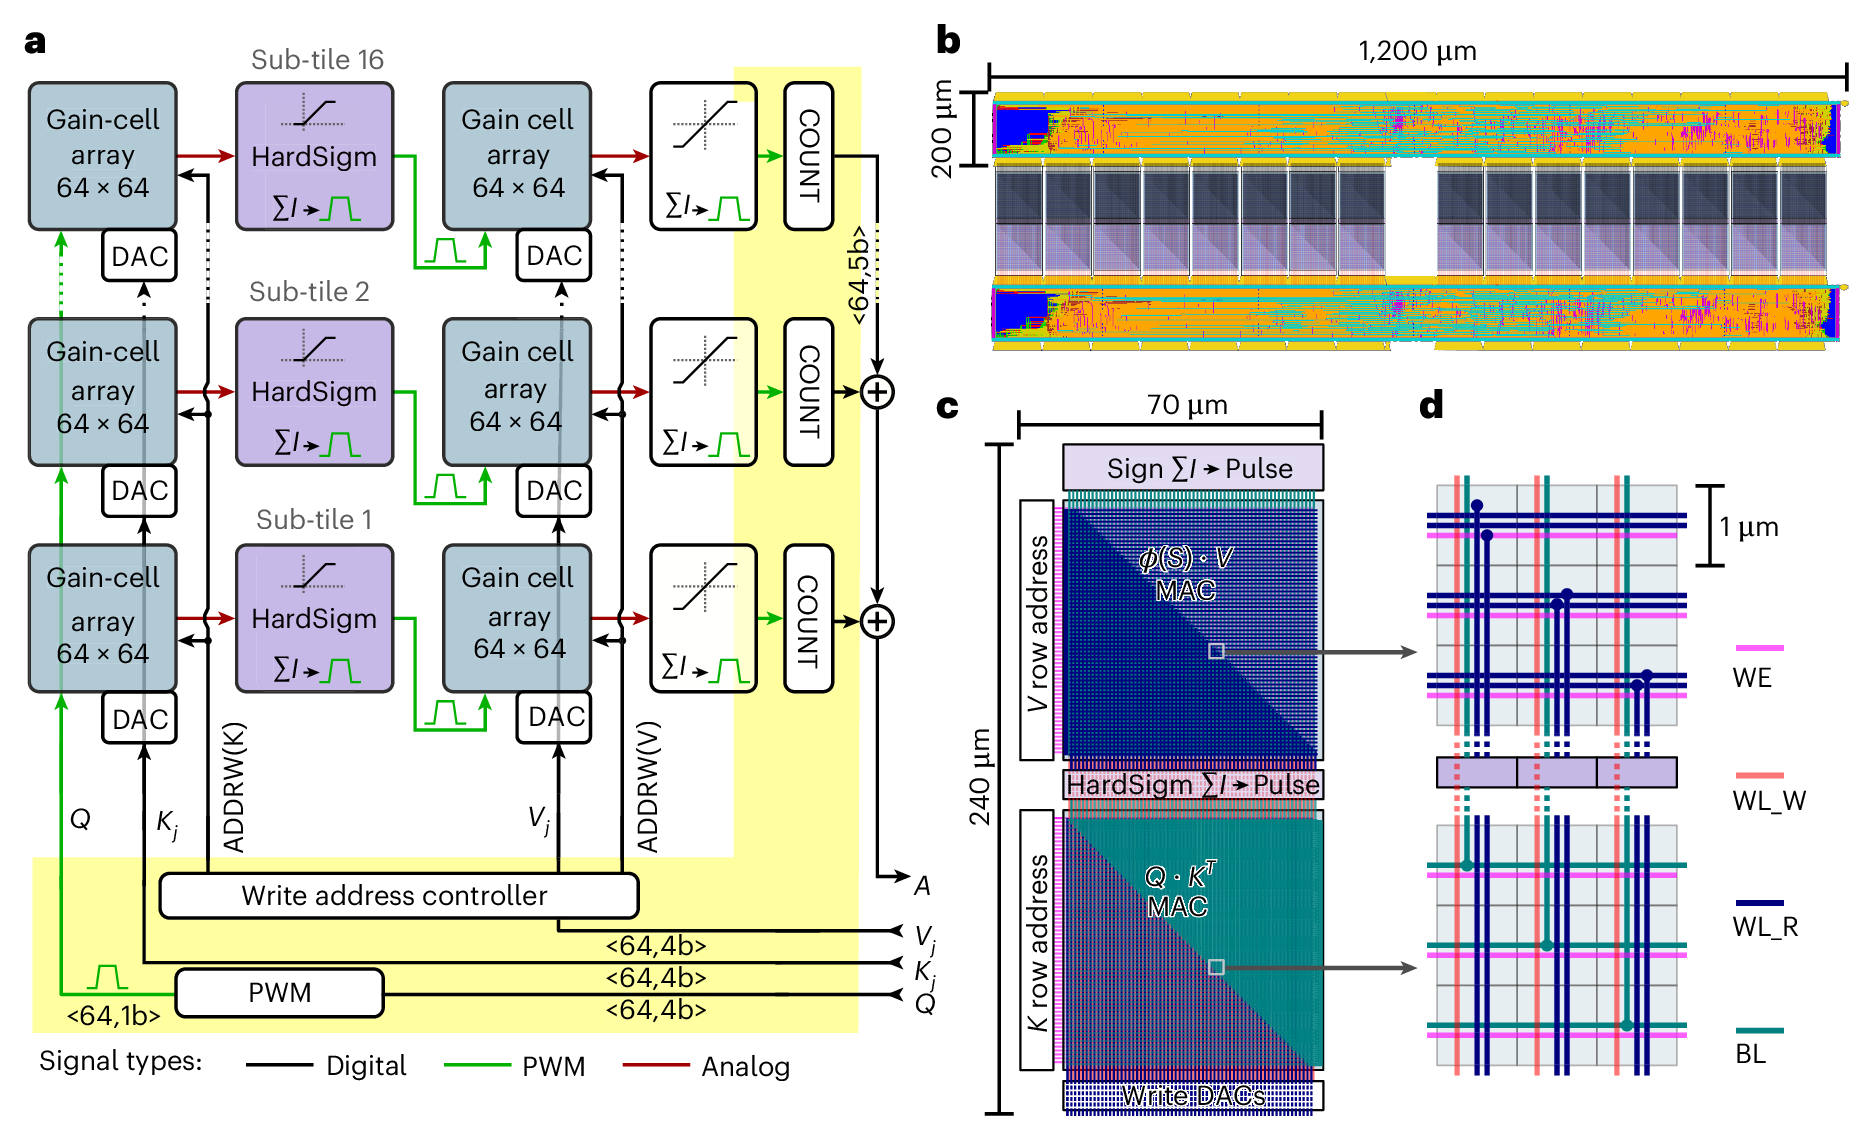
어텐션 헤드 하나를 구현하는 하드웨어 도판. 왼쪽 a는 게인 셀 배열 두 개와 HardSigmoid 회로, 카운터로 이뤄진 하위 타일 16개의 결과를 디지털 가산기가 합산하는 블록도다. 오른쪽 위 b는 가로 1,200μm인 실제 칩 레이아웃이고, 아래 c와 d는 가로 70μm, 세로 240μm인 하위 타일 하나의 평면도와 게인 셀 배선 확대도다. 출처: Leroux et al., Nature Computational Science (2025), CC BY 4.0

Analog in-memory computing attention mechanism for fast and energy-efficient large language models

독일 율리히 연구소 연구진이 KV 캐시를 저장하는 게인 셀 배열에서 어텐션 연산까지 아날로그로 처리하는 인메모리 컴퓨팅 아키텍처를 제안했다. 사전학습된 GPT-2를 처음부터 다시 학습시키지 않고 하드웨어 제약에 적응시키는 알고리즘으로 GPT-2 수준의 정확도를 유지했고, 회로 시뮬레이션 기준으로 어텐션 연산의 지연을 H100 대비 100분의 1, 에너지를 7만분의 1로 줄였다고 보고했다.

September 25, 2026 · 13 분 · 서소영
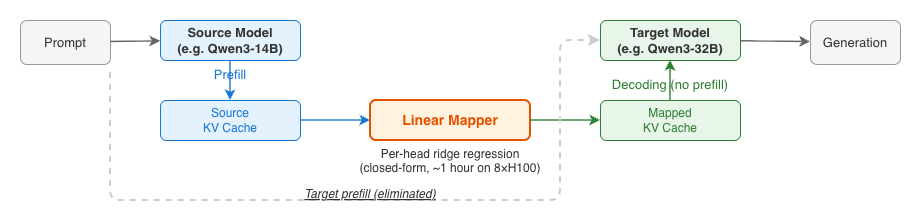
교차 모델 KV 캐시 전이 파이프라인 도식. 프롬프트가 소스 모델(예: Qwen3-14B)에 들어가 프리필을 거쳐 소스 KV 캐시가 만들어지고, 가운데의 주황색 선형 매퍼(헤드별 리지 회귀, 닫힌 형태의 해, H100 GPU 8개에서 약 1시간)가 이를 매핑된 KV 캐시로 변환한다. 타깃 모델(예: Qwen3-32B)은 매핑된 캐시로 프리필 없이 디코딩을 시작해 답을 생성한다. 프롬프트에서 타깃 모델로 가는 회색 점선에는 타깃 프리필(제거됨)이라는 라벨이 붙어 있다.

Cross-Model KV Cache Transfer in LLM Families: A Closed-Form Linear Mapping for Prefill Reuse

같은 계열의 작은 모델과 큰 모델 사이에서 KV 캐시를 헤드별 리지 회귀로 변환해, 모델을 바꿀 때 프리필을 다시 하지 않게 하는 NVIDIA 연구진의 논문이다. 세 계열 여섯 쌍 가운데 네 쌍이 타깃 단독 정확도의 73%에서 98%를 유지했고, 변환은 다시 프리필하는 것보다 2.7배에서 25배 빨랐다.

September 24, 2026 · 17 분 · 서소영
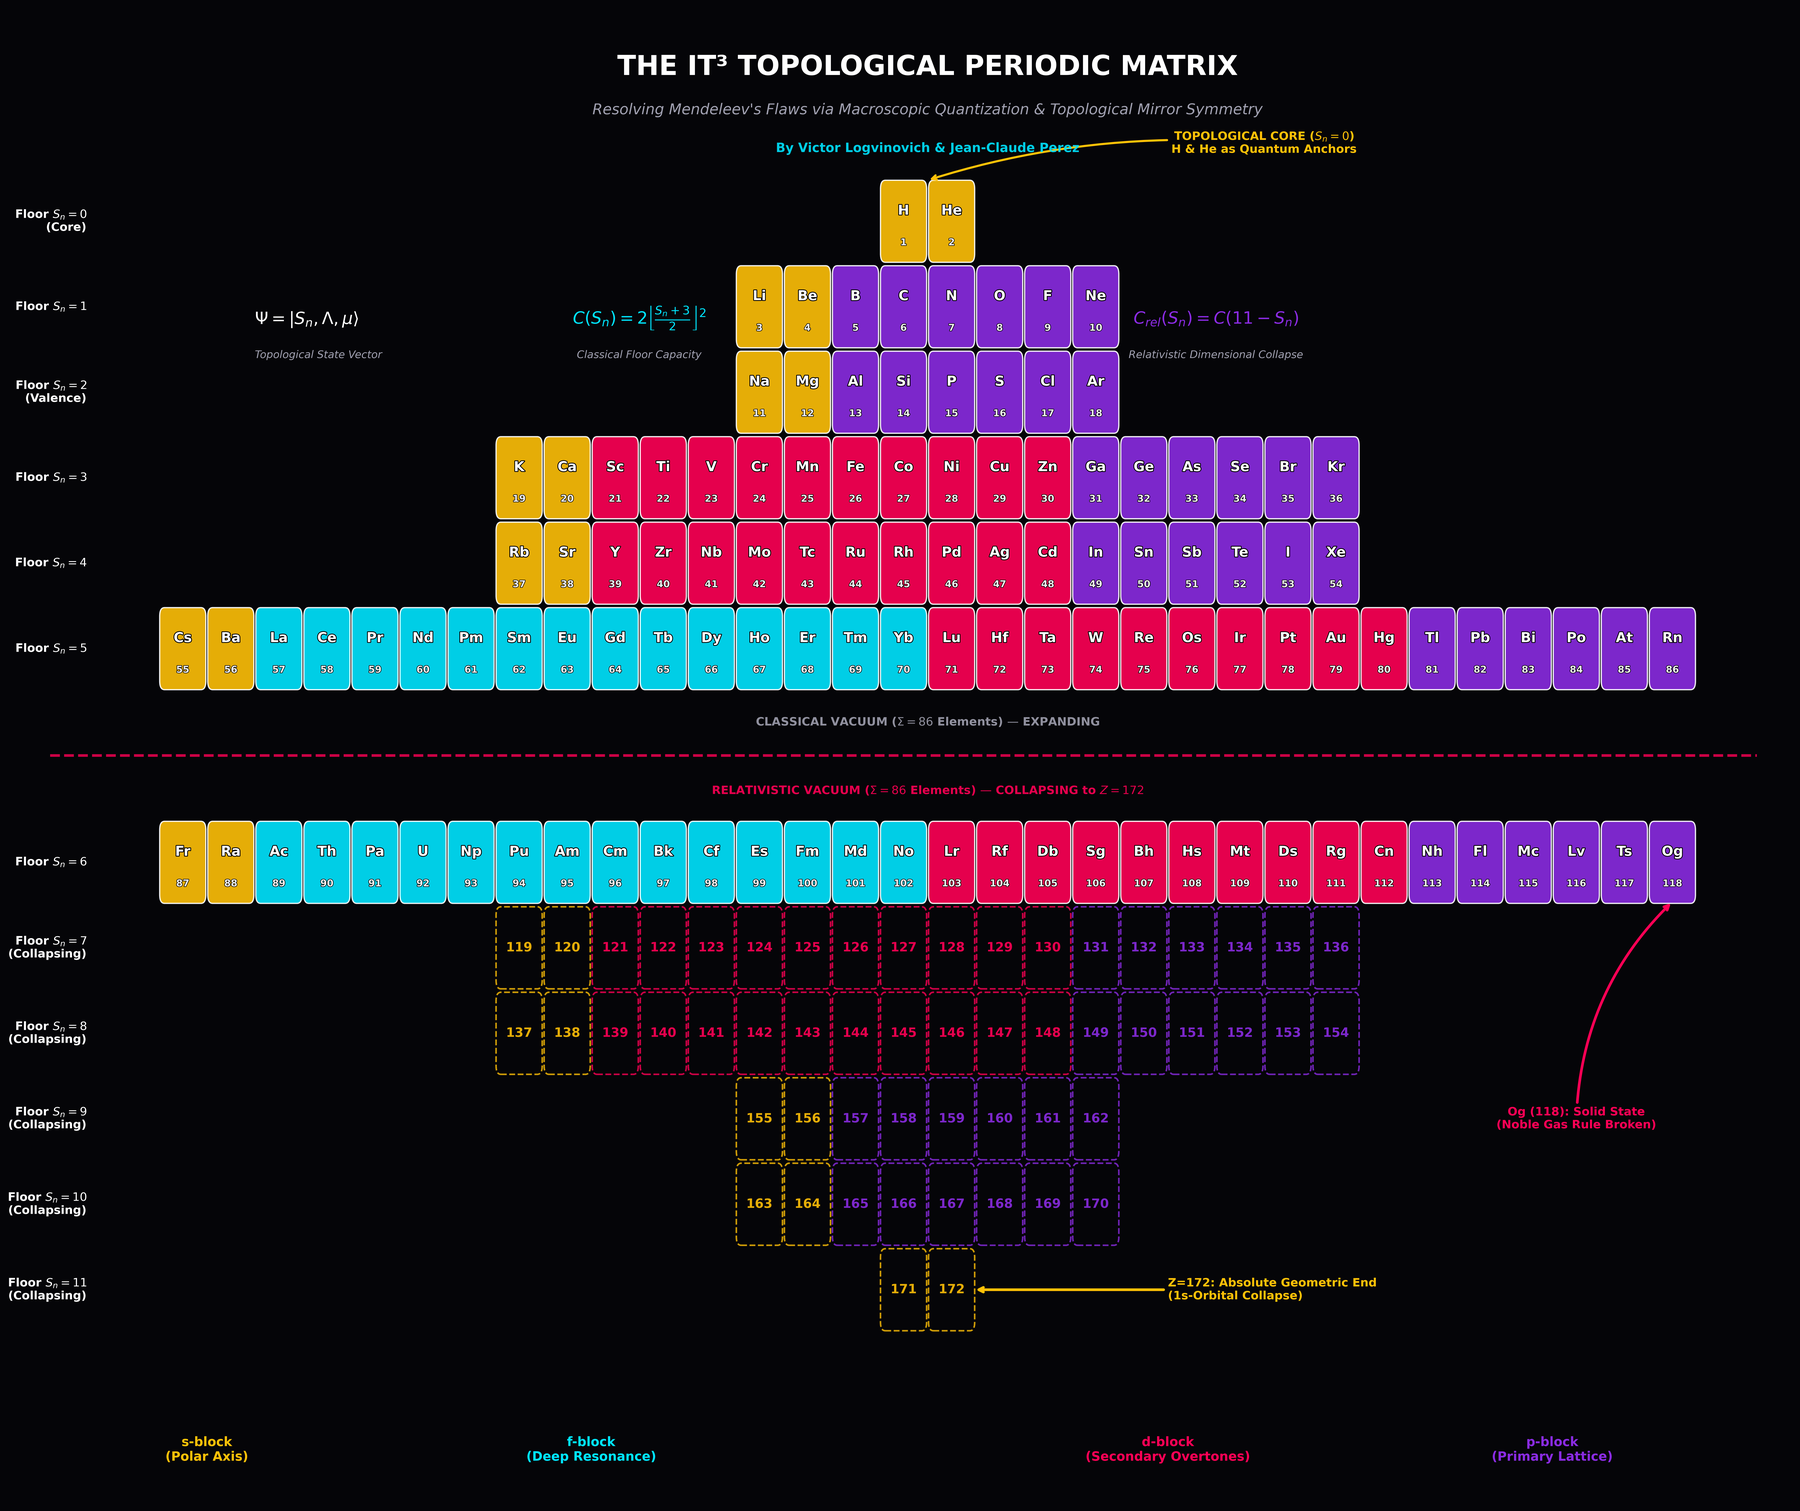
수소와 헬륨 두 칸에서 시작해 층마다 칸 수가 늘어나 여섯 번째 층에서 라돈까지 32칸이 되고, 그 아래 층들은 거꾸로 칸 수가 줄어 171번과 172번 두 칸으로 끝나는 쌍원뿔 모양의 주기 행렬. 118번까지는 실선 칸, 119번부터는 점선 칸으로 그려져 있다.

Algebraic Origin of the 86 ↔ 86 Capacity Symmetry in the Relativistic Dirac-Fock Vacuum: Index-Theoretic Derivation, Corrected Field Arithmetic, and Numerology Guards

벨라루스와 프랑스의 두 연구자가 Zenodo에 올린 프리프린트다. 주기율표의 원소 수가 86+86=172에서 끝난다는 주장을 대수적 수체와 지표 정리로 유도하고, 같은 틀로 빛의 반사와 질량과 중력까지 설명한다. 저자들은 맞춘 매개변수가 0개이고 수비학 위험이 p=0이라고 밝힌다.

September 24, 2026 · 10 분 · 서소영
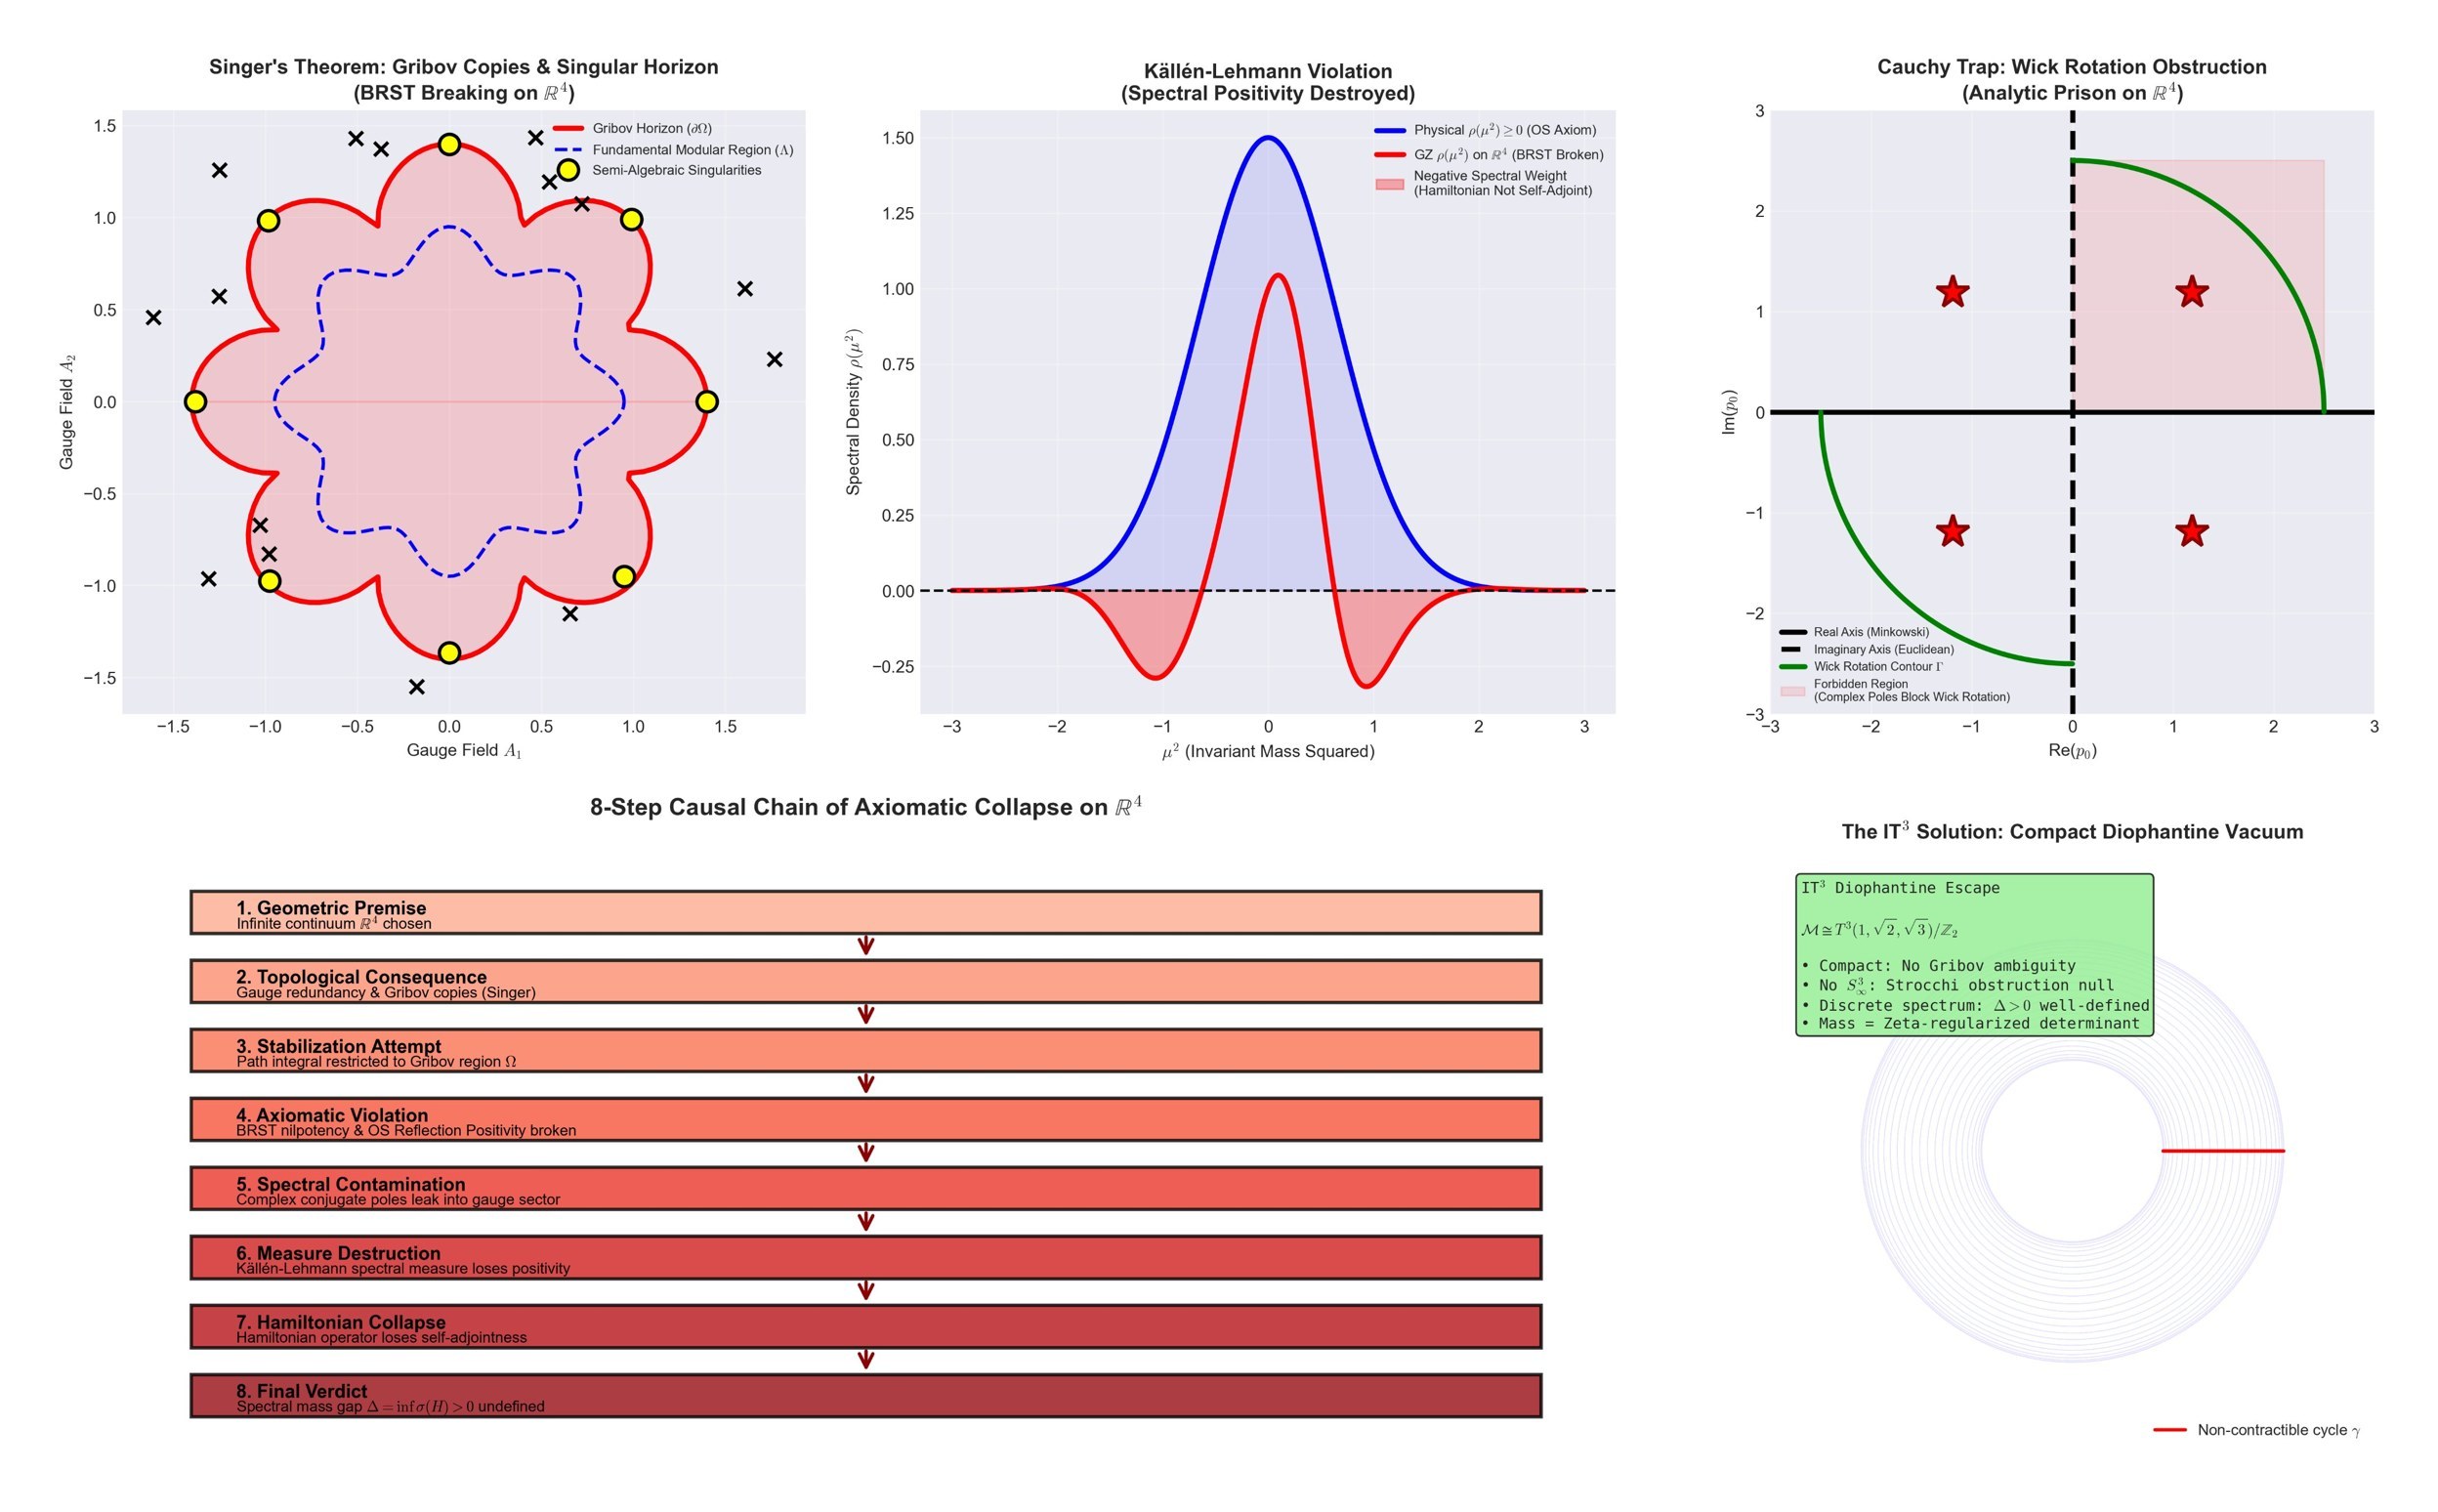
원고의 종합 도판이다. 윗줄 왼쪽에는 꽃잎 모양의 빨간 그리보프 지평선과 그 안쪽의 파란 점선 영역이 있다. 노란 원은 특이점, X 표시는 그리보프 복제를 뜻한다. 가운데에는 양수인 파란 스펙트럼 밀도와 음수 구간이 있는 빨간 곡선이 있다. 오른쪽에는 복소 평면의 윅 회전 경로와 별 모양의 극 네 개가 있다. 아랫줄 왼쪽에는 ℝ⁴에서 공리 체계가 무너지는 여덟 단계가 적혀 있고, 오른쪽에는 콤팩트 진공 다양체를 설명하는 초록 상자가 있다.

The Yang-Mills Mass Gap on ℝ⁴ Is Ill-Posed, and on a Compact Constructible Manifold It Is Automatic

벨라루스의 빅토르 로그비노비치가 Zenodo에 올린 단독 저자 프리프린트다. 클레이 수학연구소가 밀레니엄 문제로 내건 양-밀스 질량 간극 문제가 ℝ⁴에서는 모순을 품은 정식화라고 주장하고, 콤팩트 다양체 S⁴×T³에서는 간극이 자동으로 생긴다고 논증한다. 저자는 이 원고가 클레이 문제의 문자 그대로의 해법은 아니라고 밝히고, 판정을 위원회와 학계에 맡겼다.

September 24, 2026 · 9 분 · 서소영
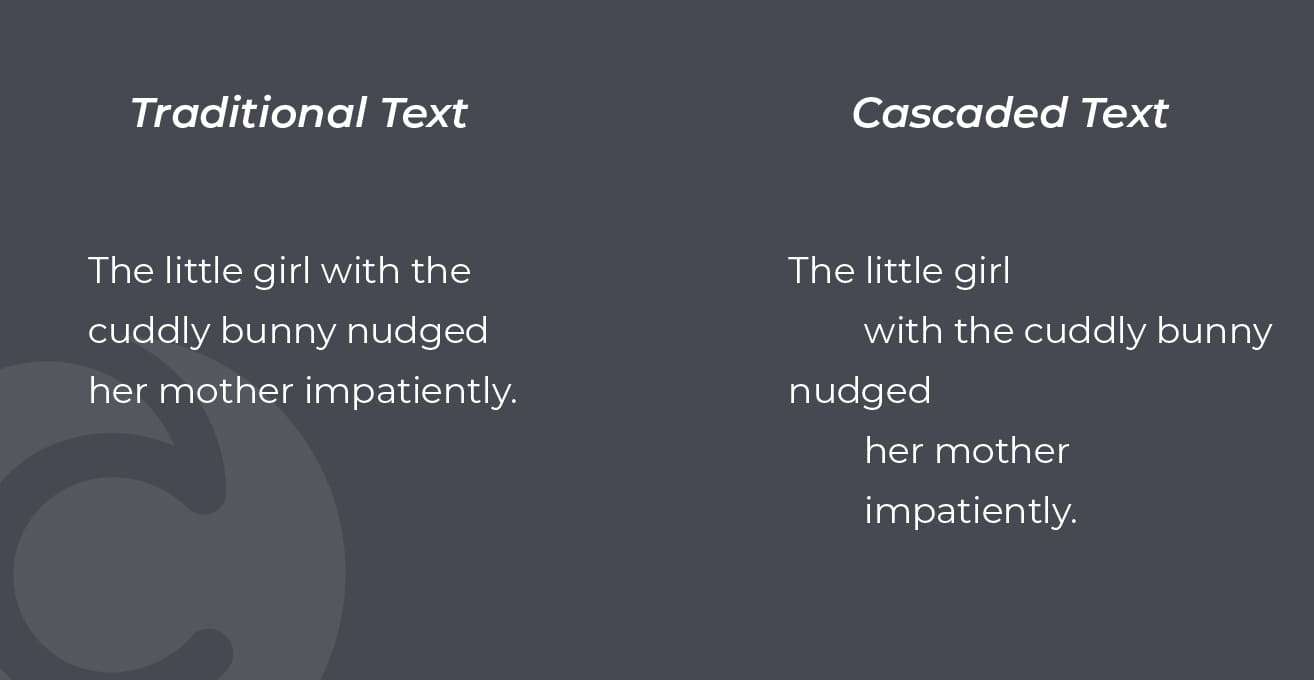
같은 문장 'The little girl with the cuddly bunny nudged her mother impatiently.'를 왼쪽은 일반 블록 텍스트로, 오른쪽은 구문 단위마다 줄을 바꾸고 수식어를 들여쓴 Cascade 서식으로 조판한 비교 이미지. 출처: Cascade Reading.

Linguistically-driven text formatting improves reading comprehension: Evidence from 4th and 5th graders

구문 분석 결과에 따라 줄바꿈과 들여쓰기를 넣는 Cascade 서식으로 미국 초등 4, 5학년 87명이 5주 동안 지문을 읽었다. 이 집단의 독해 정답률은 일반 서식으로 읽은 집단보다 빠르게 올랐고, 중하위 수준 독자는 일반 서식으로 바꾼 뒤에도 오른 정답률을 유지했다.

September 23, 2026 · 12 분 · 서소영
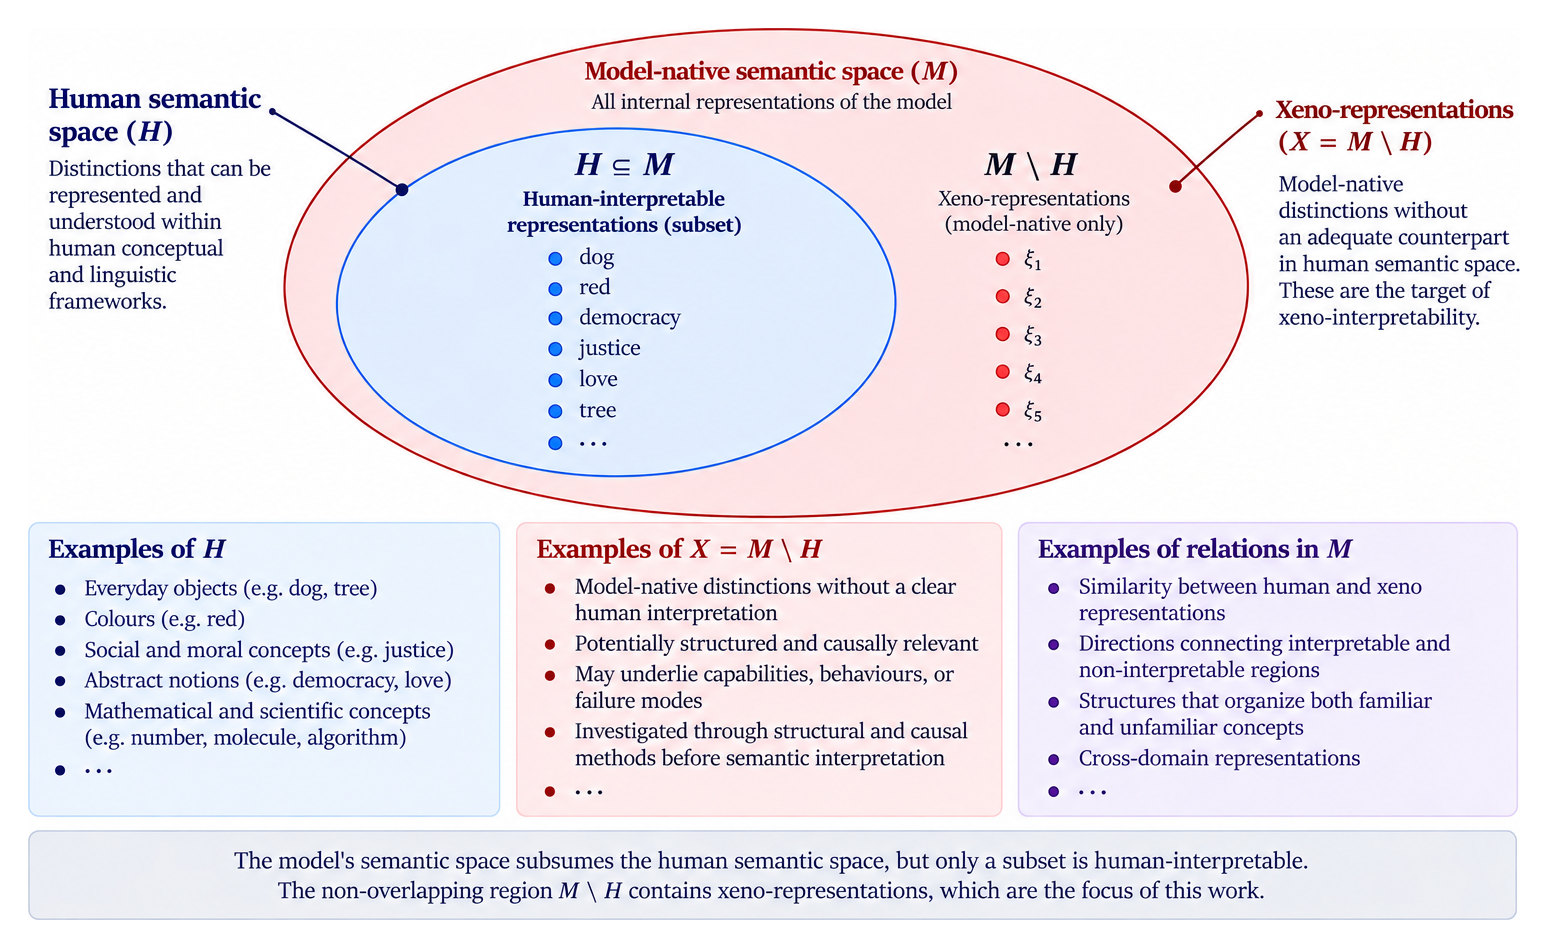
모델 고유 의미 공간 M을 나타내는 큰 빨간 타원 안에 인간 해석 가능 의미 공간 H를 나타내는 파란 타원이 들어 있는 도식. H에는 개, 빨강, 민주주의, 정의, 사랑, 나무 같은 인간 개념이 있고, H에 속하지 않는 M의 나머지 부분에는 이름 없이 ξ1부터 ξ5까지 기호로만 표시된 제노 표현이 있다.

Xeno-Interpretability: Investigating the Alien Minds of LLMs

LLM이 인간에게 대응 개념이 없는 구분을 내부에 표현하고 계산에 쓸 수 있다는 가능성을 다룬 이론 논문이다. 저자들은 이런 표현을 제노 표현이라 부르고, 의미를 해석하기 전에 표현을 먼저 식별하고 개입해 검증하는 연구 프로그램과 그 안전 함의를 제안한다.

September 23, 2026 · 31 분 · 서소영
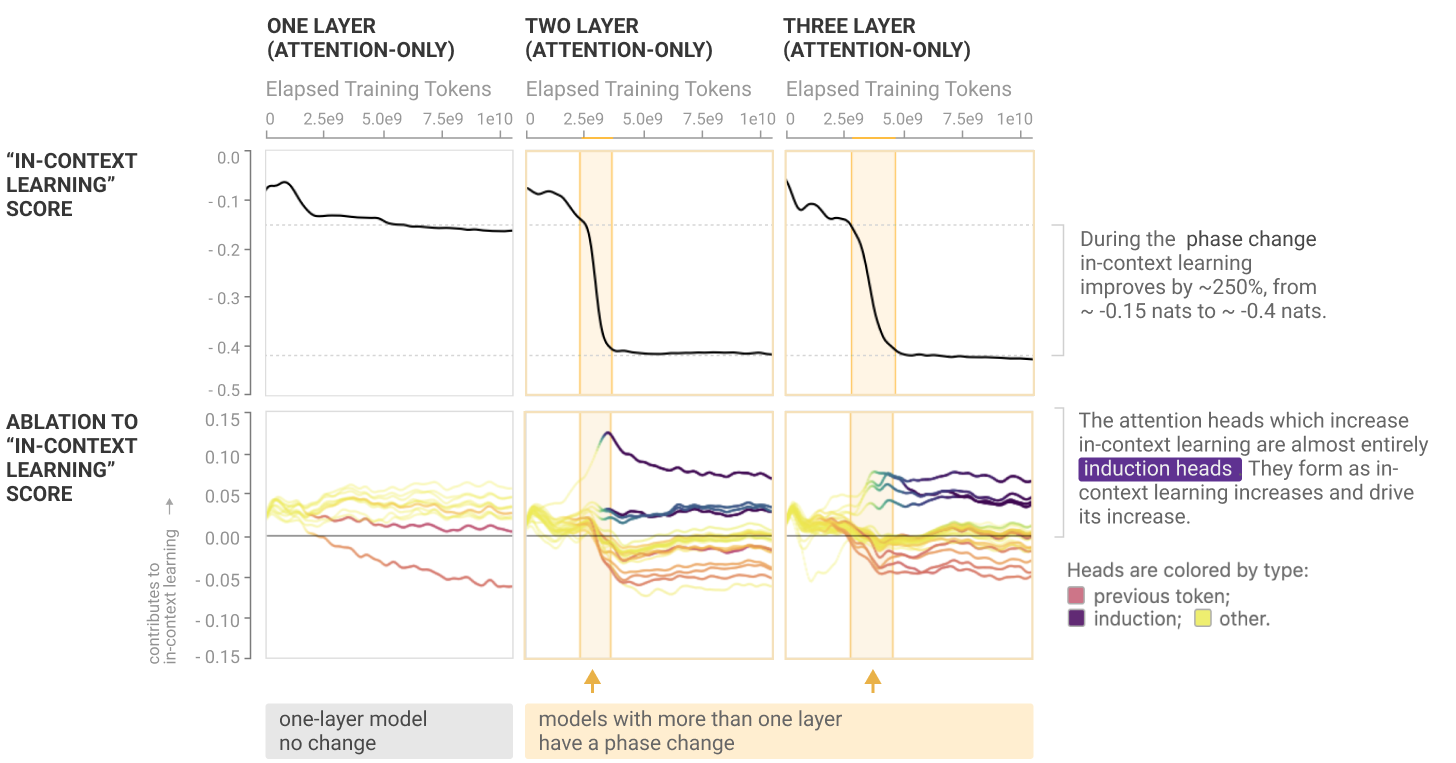
1층, 2층, 3층 어텐션 전용 모델의 인컨텍스트 러닝 점수와 헤드별 절제 효과를 비교한 그래프. 상전이 구간에서 점수가 급락하고, 그 변화를 만드는 헤드가 보라색으로 표시된 인덕션 헤드임을 보여준다.

In-context Learning and Induction Heads

트랜스포머는 학습 초반에 딱 한 번 상전이를 겪는다. 그 좁은 구간에서 인덕션 헤드가 형성되고 인컨텍스트 러닝 능력이 한꺼번에 향상된다. Anthropic이 2022년에 두 현상을 연결한 여섯 갈래 논거를 정리한 논문.

September 23, 2026 · 16 분 · 서소영
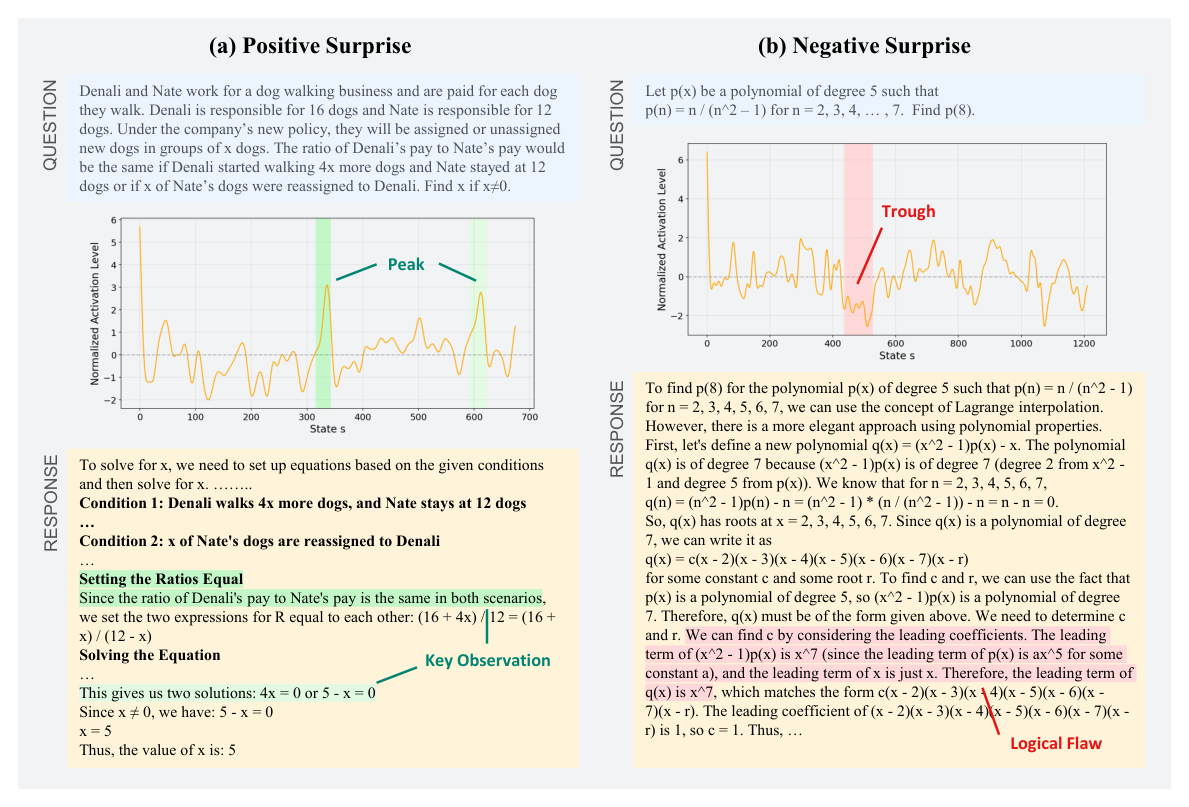
도파민 뉴런 하나의 활성 곡선을 두 사례로 나란히 보여주는 그림. 왼쪽은 모델이 결정적인 논리 단계를 찾아낸 순간 활성이 치솟는 장면이고, 오른쪽은 모델이 논리적 오류를 저지른 순간 활성이 뚜렷하게 낮아지는 장면이다.

Sparse Reward Subsystem in Large Language Models

LLM의 히든 스테이트에 담긴 보상 정보는 뉴런 전체에 흩어져 있지 않고 1%에도 못 미치는 극소수 뉴런에 몰려 있다. 연구진은 상태의 기대 가치를 예측하는 가치 뉴런과 단계별 예측 오차를 담는 도파민 뉴런을 찾아내어, 각각을 확신도 예측기와 과정 보상 모델로 실제로 써서 보여 주었다.

September 22, 2026 · 10 분 · 서소영