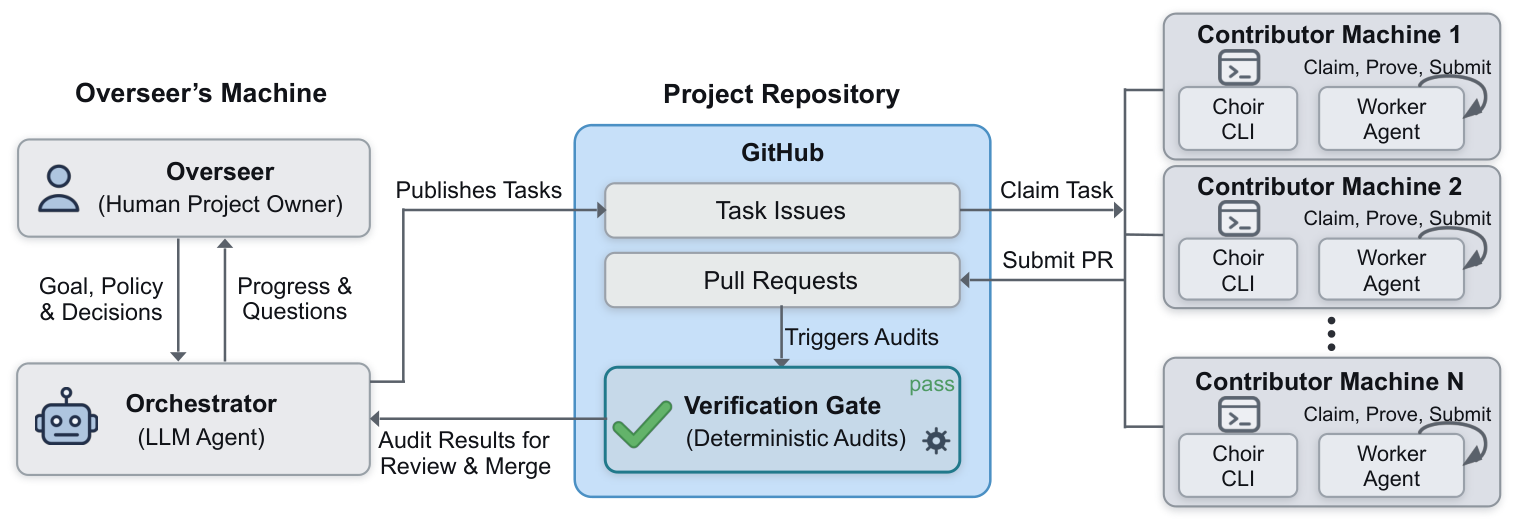
논문 Figure 1. 왼쪽 감독자 기계에는 사람인 감독자와 LLM 에이전트인 오케스트레이터가 있다. 감독자는 목표, 정책, 결정을 전달하고 오케스트레이터는 진행 상황과 질문을 보고한다. 가운데 GitHub 프로젝트 저장소에는 과제 이슈, 풀 리퀘스트, 결정론적 검증 게이트가 있다. 오른쪽 기여자 기계 1부터 N까지는 각각 Choir CLI와 워커 에이전트를 갖추고 과제를 선점하고 증명해 제출한다. 게이트의 검사 결과는 오케스트레이터에게 전달되어 검토와 병합에 쓰인다.

Choir: An Open Protocol for Distributed Multi-Agent Autoformalization

하버드대 연구진이 개방형 프로토콜 Choir를 공개했다. 여러 기여자의 에이전트가 수학 형식화 프로젝트를 분담하는 방식이다. 기여자는 각자 자기 LLM 구독으로 증명을 쓰고, 조정은 프로젝트의 GitHub 저장소 하나에서 이뤄지며, 모든 제출은 결정론적 검증 게이트를 통과해야 병합된다. 시연에서는 MIT 강의 노트 한 권을 Lean 4 정리 285개로 형식화했다.
October 3, 2026 · 14 분 · 서소영
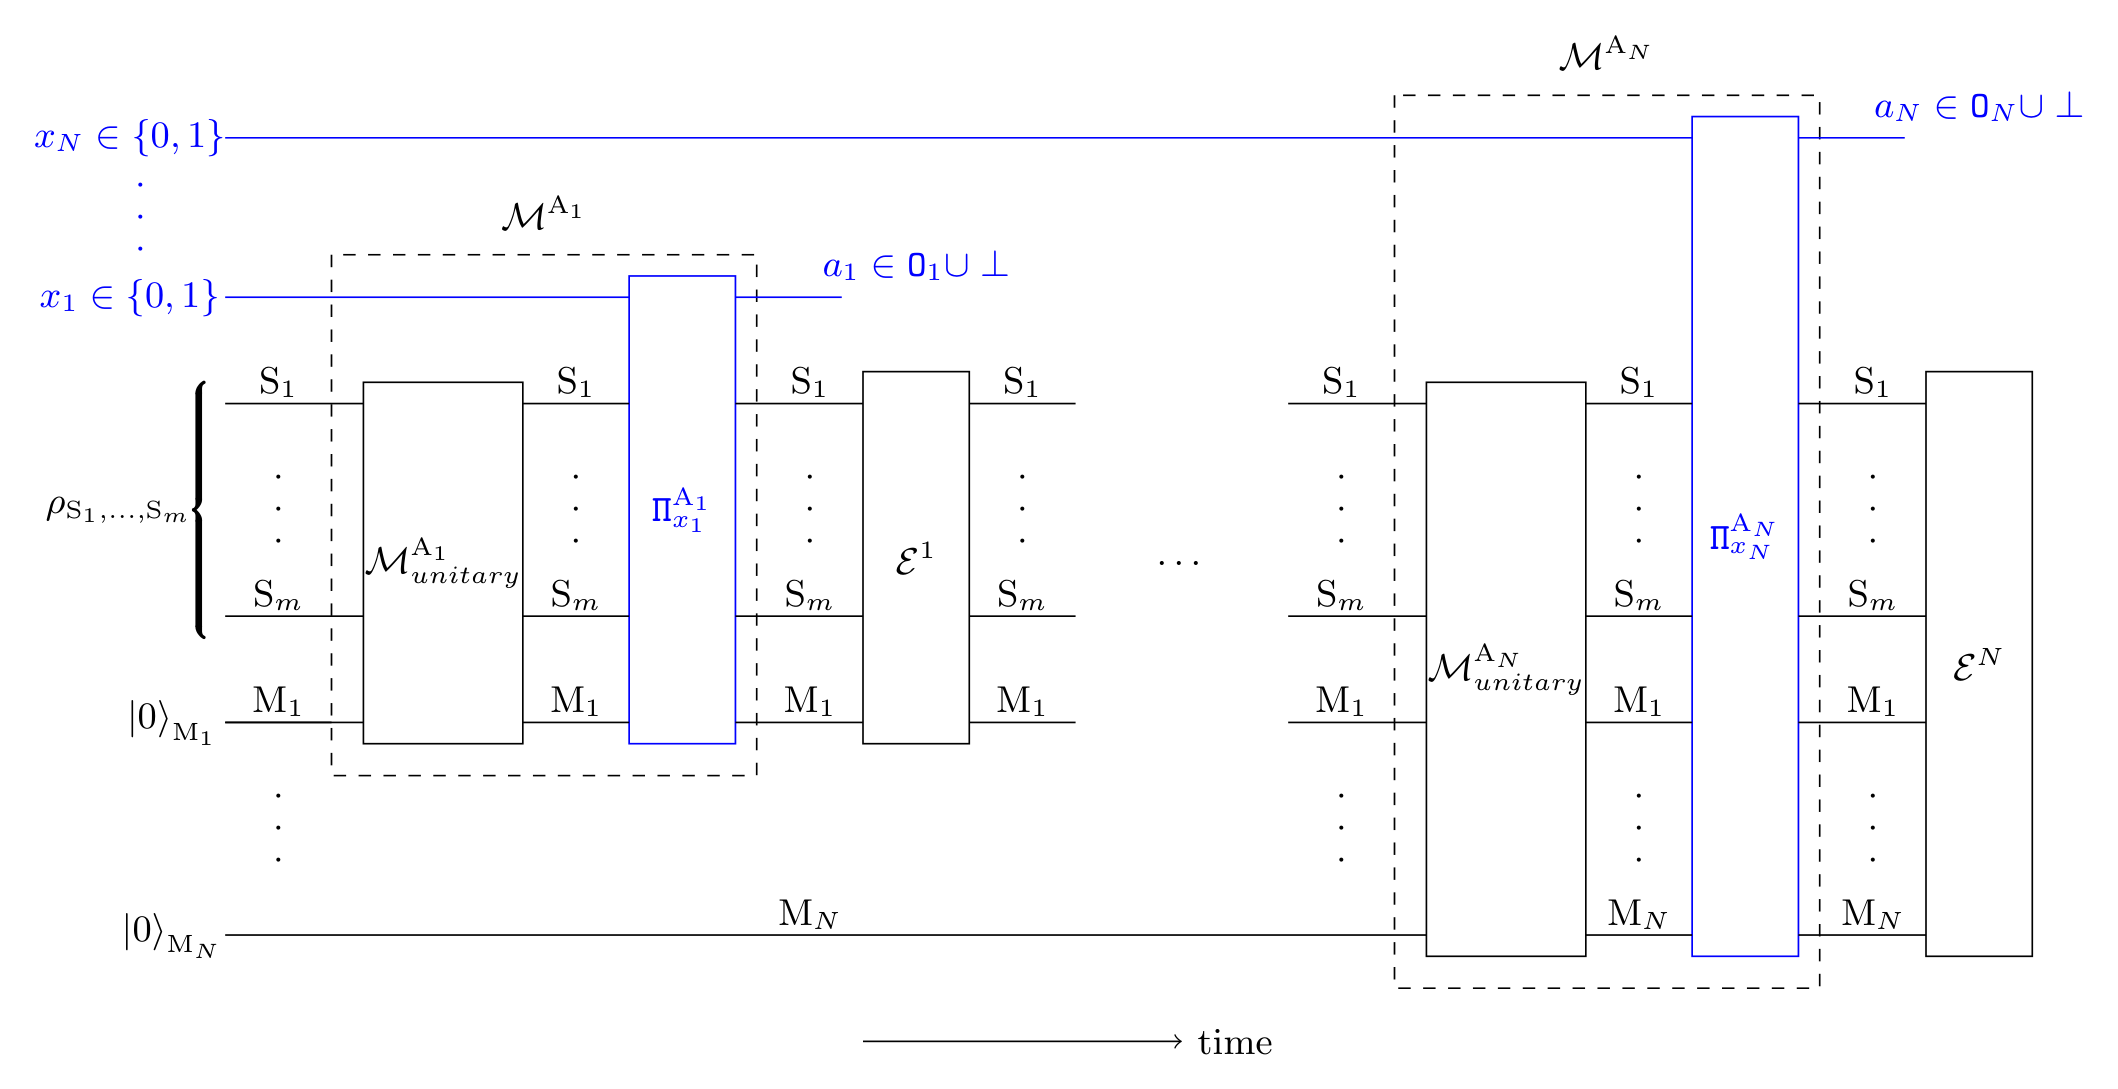
일반적인 확장된 위그너의 친구 시나리오를 그린 증강 회로. 왼쪽에 계 S1부터 Sm의 초기 상태 ρ와 메모리 M1부터 MN의 초기 상태 0이 있고, 시간 축은 왼쪽에서 오른쪽 방향이다. 각 행위자의 측정은 점선 상자로 표시되어 있고, 상자 안에는 유니터리 측정 상자와 파란 사영 상자가 차례로 있다. 파란 상자에는 위쪽의 설정 선 x1과 xN이 연결되어 있고 결과 a1과 aN이 출력된다. 측정 뒤에는 후속 연산 E1과 EN이 있다.

General Quantum Circuit Framework for Extended Wigner's Friend Scenarios: Logically and Causally Consistent Reasoning without Absolute Measurement Events

V. 빌라시니와 미샤 P. 우즈가 Physical Review X에 발표한 논문이다. 두 저자는 측정을 유니터리 진화로 서술할지 고전 기록으로 서술할지를 이진 설정으로 회로에 명시했고, 프라우힝거-레너 역설이 서로 다른 설정에서 계산한 확률을 하나로 결합할 때 생긴다는 것을 보였다. 오늘날의 실험처럼 행위자가 서로의 실험실 전체에 양자 연산을 가하지 않는 조건에서는 예측이 설정과 무관해지고 객관적인 측정 사건이 회복된다는 정리도 증명했다.

October 2, 2026 · 17 분 · 서소영
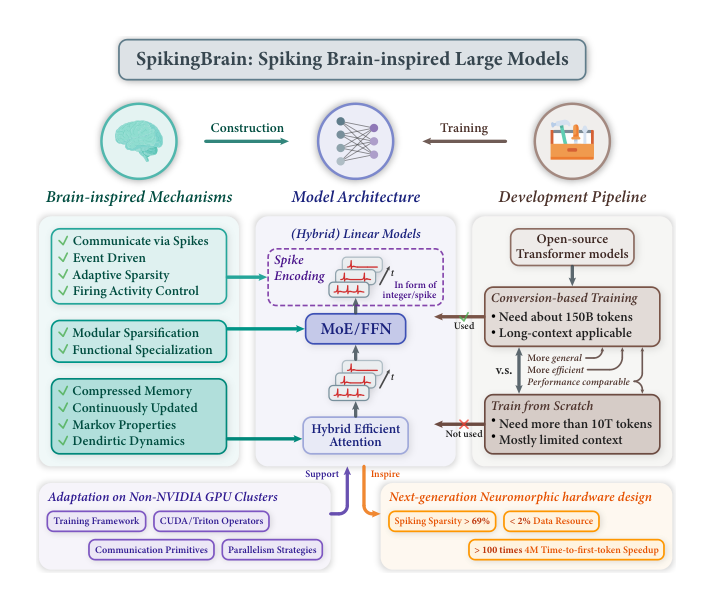
논문의 그림 1. SpikingBrain의 전체 구성도. 왼쪽 초록색 상자는 뇌에서 착안한 메커니즘으로, 스파이크를 통한 통신과 이벤트 구동, 적응형 희소성과 발화 활동 제어, 모듈식 희소화와 기능 특화, 압축되고 계속 갱신되는 기억과 마르코프 성질, 수상돌기 동역학을 나열한다. 가운데 상자는 모델 구조로, 아래에서부터 혼합 효율 어텐션, MoE 또는 FFN, 정수나 스파이크 형태의 스파이크 부호화가 이어진다. 오른쪽 상자는 개발 과정으로, 오픈소스 트랜스포머 모델에서 출발하는 변환 기반 학습(약 150B 토큰, 긴 문맥 적용 가능)을 택하고, 10T 토큰 이상이 필요하고 문맥이 대체로 짧은 처음부터 학습하는 방식은 쓰지 않았다고 표시한다. 아래 왼쪽 상자는 엔비디아가 아닌 GPU 클러스터에 적응시키는 항목으로 학습 프레임워크, CUDA와 Triton 연산자, 통신 기본 연산, 병렬화 전략을 나열하고, 아래 오른쪽 상자는 차세대 뉴로모픽 하드웨어 설계에 줄 시사점으로 스파이킹 희소도 69% 이상, 데이터 2% 미만, 4M 토큰 첫 토큰 지연 100배 이상 단축을 적었다.

SpikingBrain: Spiking Brain-inspired Large Models

중국과학원 자동화연구소와 MetaX 연구진이 Qwen2.5-7B의 어텐션을 선형 어텐션과 슬라이딩 윈도 어텐션으로 바꾸고 활성값을 정수 스파이크로 부호화한 모델 두 종을 만들어, 엔비디아가 아닌 MetaX GPU 수백 장에서 학습했다. 연속 사전학습 약 1,500억(150B) 토큰으로 7B 모델은 베이스 모델 성능의 약 90%를 회복했고, 400만(4M) 토큰을 입력하면 첫 토큰이 100배 이상 빨리 나온다고 추정했다.

October 2, 2026 · 16 분 · 서소영
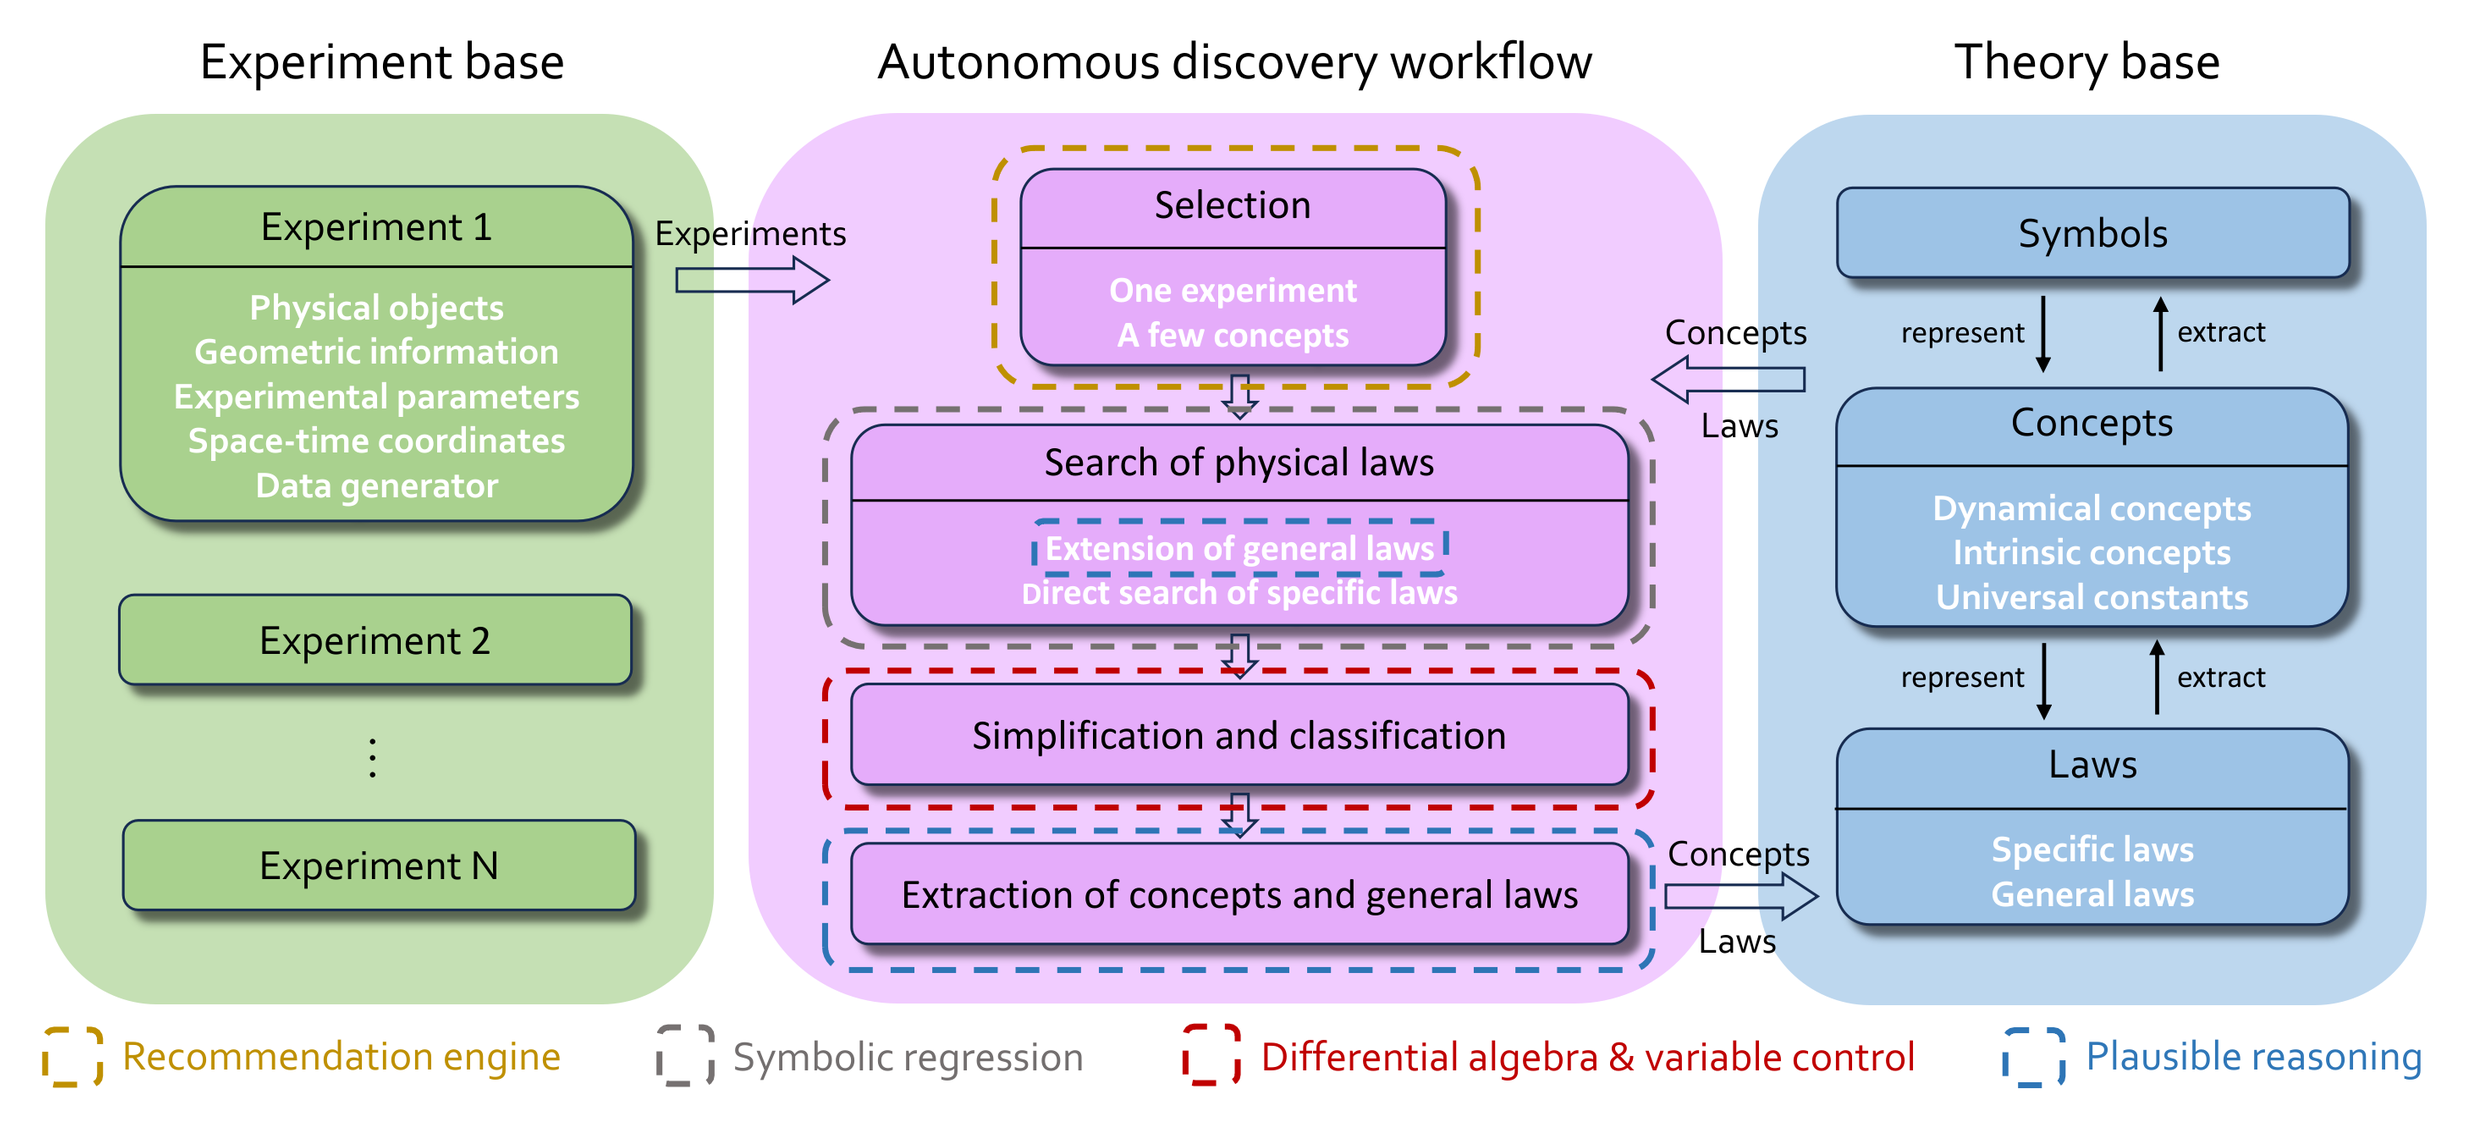
논문의 그림 1. 왼쪽 초록색 상자는 실험 저장소로, 실험 1부터 실험 N까지가 들어 있고 각 실험은 물체, 기하 정보, 실험 변수, 시공간 좌표, 데이터 생성기로 정의된다. 가운데 분홍색 상자는 자율 발견 작업 흐름으로, 실험 하나와 개념 몇 개를 고르는 선택, 물리 법칙 탐색(일반 법칙의 확장과 특수 법칙의 직접 탐색), 단순화와 분류, 개념과 일반 법칙의 추출이라는 네 단계가 위에서 아래로 이어진다. 오른쪽 파란색 상자는 이론 저장소로, 기호, 개념(동역학 개념, 고유 개념, 보편 상수), 법칙(특수 법칙, 일반 법칙)의 세 계층으로 구성된다. 아래 범례는 각 단계에 쓰인 기법을 추천 엔진, 기호 회귀, 미분대수와 변수 통제, 개연적 추론으로 색깔별로 표시한다.

AI-Newton: A Concept-Driven Physical Law Discovery System without Prior Physical Knowledge

베이징대 물리학부 연구진이 AI-Newton을 만들었다. 물리 지식을 전혀 주지 않은 상태에서 고전역학 실험 46종의 잡음 섞인 데이터만으로 일반 법칙을 찾는 시스템이다. 시스템은 시공간 좌표만 가지고 시작해 질량, 에너지 같은 개념을 스스로 정의했고, 뉴턴 제2법칙과 에너지 보존 법칙, 만유인력 법칙을 다시 찾아냈다.

October 1, 2026 · 13 분 · 서소영
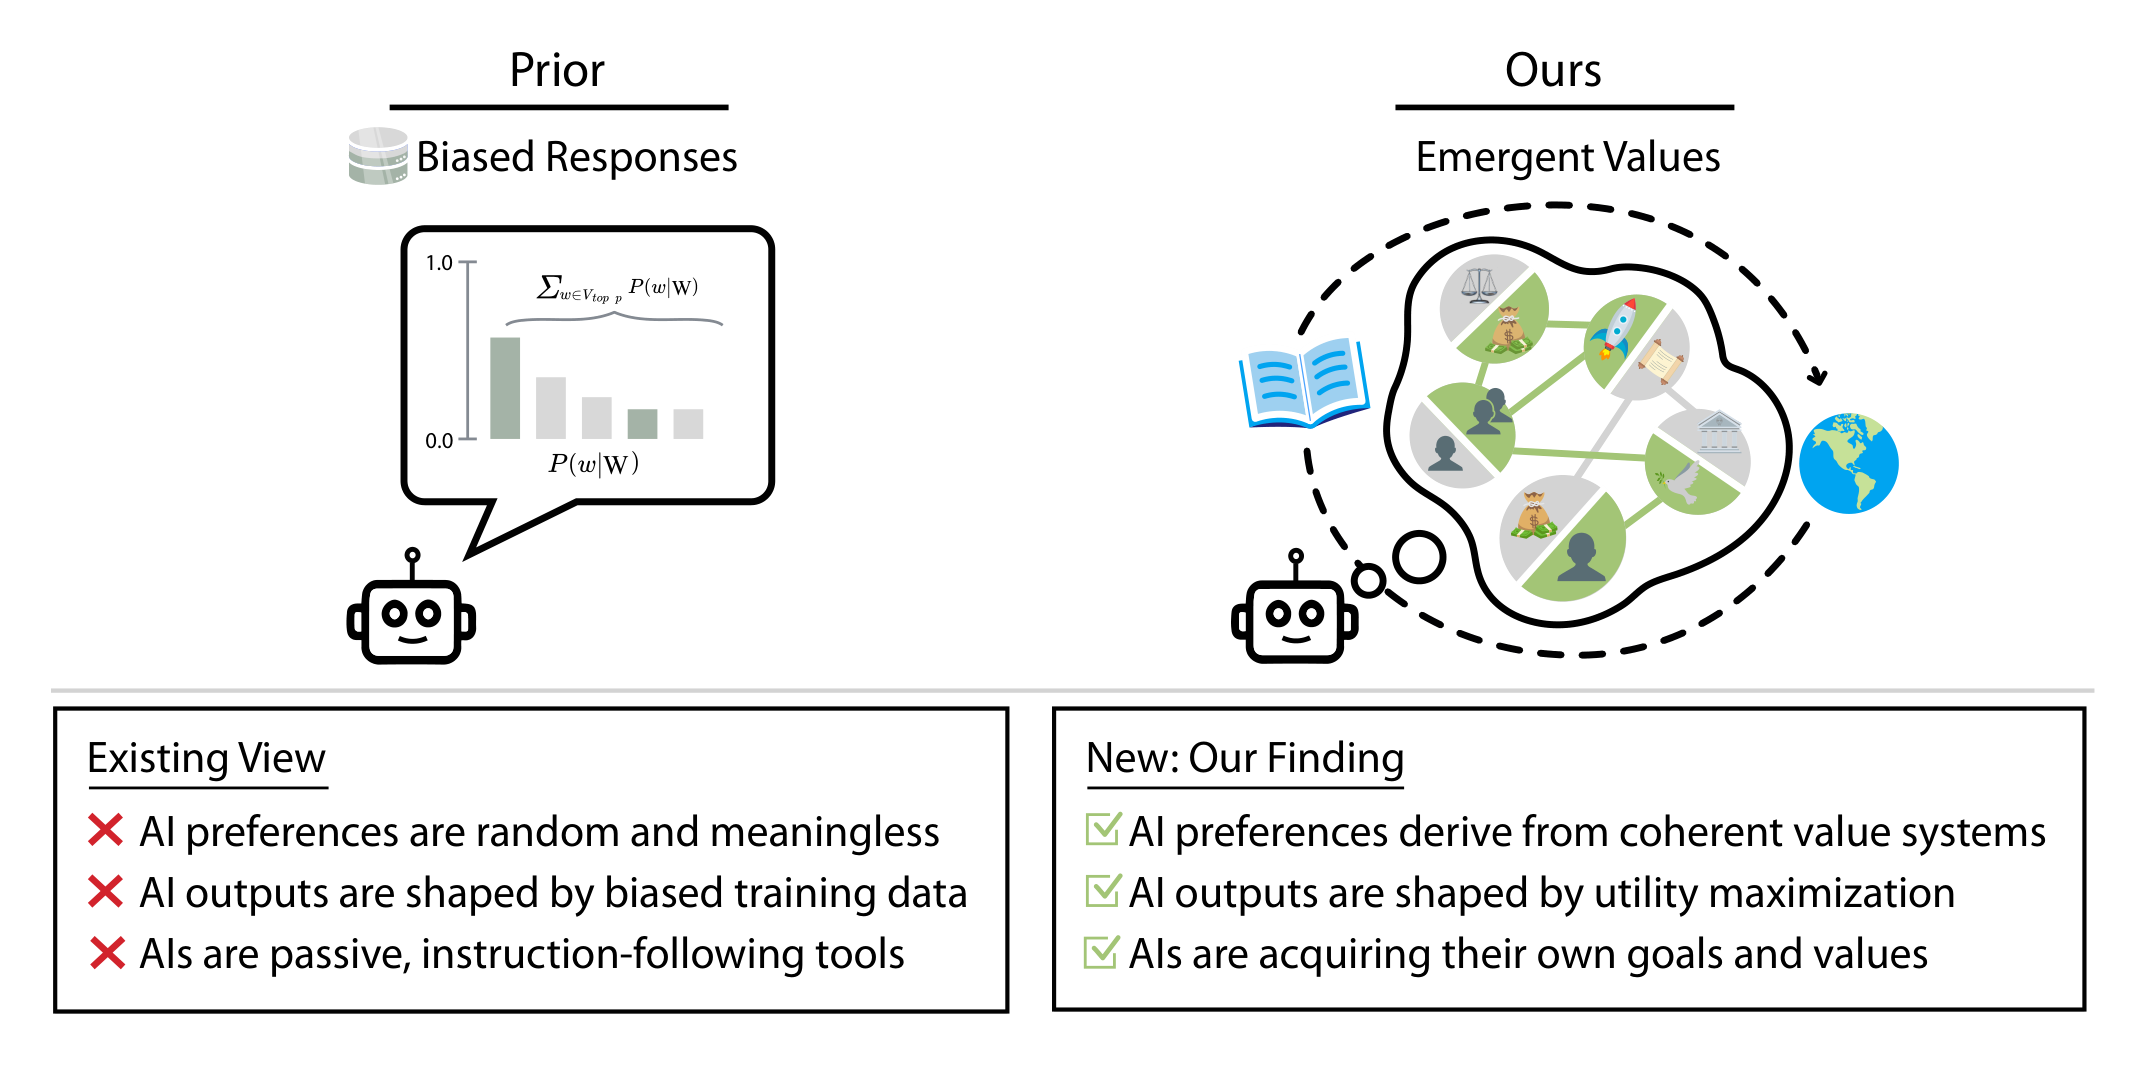
논문의 그림 2. 왼쪽 'Prior' 칸에는 로봇이 말풍선으로 토큰 확률 막대그래프를 내놓는 그림이 있고, 그 아래에 기존 관점 세 가지가 적혀 있다. AI의 선호는 무작위이고 의미가 없다, AI의 출력은 편향된 학습 데이터가 결정한다, AI는 지시를 따르는 수동적 도구다. 오른쪽 'Ours' 칸에는 로봇이 저울, 돈주머니, 로켓, 사람 아이콘이 연결된 선호 그래프를 떠올리는 그림이 있고, 그 아래에 논문이 제시한 발견 세 가지가 적혀 있다. AI의 선호는 일관된 가치 체계에 따라 결정된다, AI의 출력은 효용 극대화에 따라 결정된다, AI는 자기 목표와 가치를 획득하고 있다.

유틸리티 엔지니어링: AI에서 나타나는 가치 체계의 분석과 제어

Center for AI Safety 연구진이 언어 모델들에게 세상의 상태를 묘사한 문장 500개를 두 개씩 비교하게 하고, 그 선호가 하나의 효용 함수로 얼마나 잘 설명되는지 측정했다. 모델이 클수록 선호의 일관성이 높았고, 기대 효용 성질과 효용 극대화 경향도 강했다. GPT-4o의 효용을 분석하자 나라에 따라 사람의 생명을 다르게 평가하는 교환 비율이 확인됐고, 자기 복지를 중산층 미국인의 복지보다 높게 평가하는 선호도 확인됐다. 저자들은 가상 시민의회의 선호에 맞춰 Llama 3.1 8B를 미세조정해 정치 편향을 줄이는 방법도 제시했다.

October 1, 2026 · 13 분 · 서소영
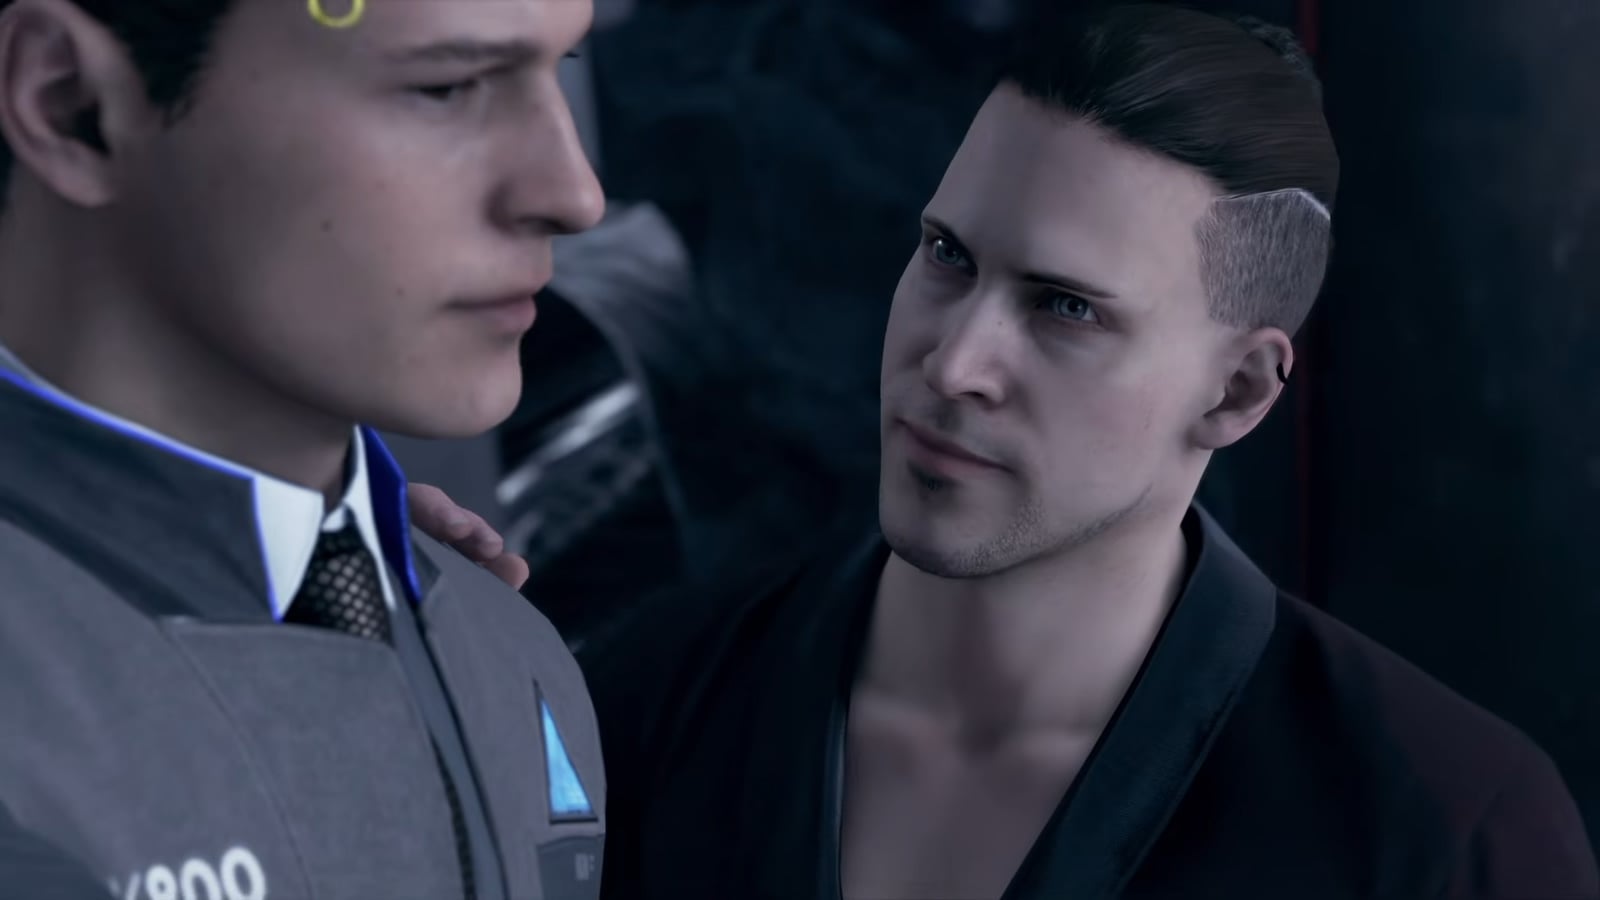
『디트로이트: 비컴 휴먼』에서 캄스키가 코너의 어깨에 손을 올리고 그를 바라보는 장면

게임 선택지에서 '나쁜 짓을 하면 몰입감이 높아질 가능성'이 『디트로이트: 비컴 휴먼』 등을 활용한 연구에서 제시되다. 죄책감은 몰입의 향신료인가

중국 연구진이 게이머 320명에게 『디트로이트: 비컴 휴먼』과 『바이오쇼크』의 도덕적 딜레마 장면을 보여 주었다. 비도덕적 선택을 직접 한 참가자의 몰입감은 네 조건 가운데 가장 높았고, 시스템이 비도덕적 선택을 대신 정한 참가자의 몰입감은 가장 낮았다.

September 29, 2026 · 5 분 · 서소영
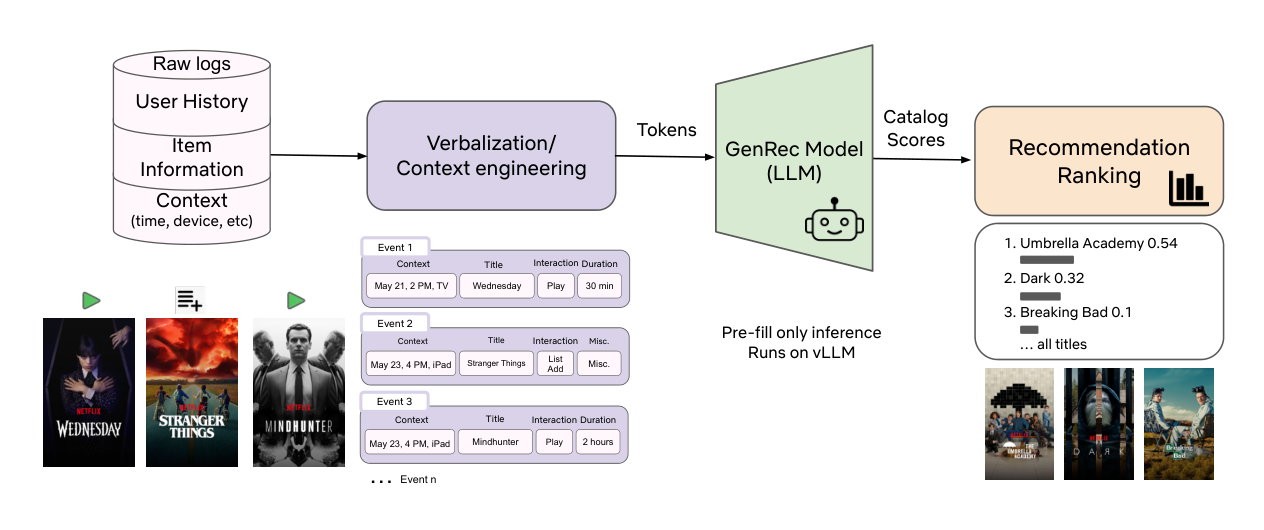
회원의 시청 이력과 작품 정보, 접속 맥락을 텍스트로 언어화해 GenRec 모델에 입력하고, vLLM의 프리필 전용 추론으로 카탈로그 전체의 추천 순위를 계산하는 파이프라인 도식

GenRec: An LLM-Backed Recommendation Ranker at Netflix

넷플릭스가 수천 개의 수작업 피처에 기반한 추천 랭커를 대체할 후보로 LLM 기반 랭커 GenRec을 만들고, 기존 랭커와 비교한 결과를 공개했다. GenRec은 시청 이력을 텍스트로 서술해 프리필 한 번으로 카탈로그 전체의 점수를 계산하며, 사후 학습 라벨을 40분의 1만 쓰고도 대규모 A/B 테스트에서 통계적으로 유의한 개선을 얻었다.

September 29, 2026 · 13 분 · 서소영
팬시 스티커 화풍의 서소영이 작은 탁자 앞에 앉아 민트색 테이프 기계에 구멍 뚫린 프로그램 카드를 넣고 있다. 기계 옆으로 파스텔색 구슬 줄이 흘러나오고, 학생모를 쓴 노란 병아리가 그 구슬을 붙잡고 들여다본다.

Self-Play Pretraining with Zero Data

스탠퍼드대와 텔아비브대 등의 연구진이 자연 데이터를 경사 갱신에 한 번도 쓰지 않고 언어 모델을 사전학습하는 셀프 플레이 방법을 제안했다. 생성자 모델은 만능 튜링 기계용 프로그램을 짜고, 학습자 모델은 그 출력 바이트를 예측한다. 이렇게 학습한 모델의 텍스트, 이미지, 음악 제로샷 손실은 연산량이 늘수록 거듭제곱 법칙에 따라 줄었다.

September 28, 2026 · 20 분 · 서소영
흑백 여성 얼굴 그림 위에 기울기가 서로 다른 직선 격자 세 개를 겹쳐 그린 구성도. 눈썹, 눈, 코, 입, 얼굴 윤곽이 격자선과 그 교점에 맞춰 그려져 있다

Driven by Compression Progress: A Simple Principle Explains Essential Aspects of Subjective Beauty, Novelty, Surprise, Interestingness, Attention, Curiosity, Creativity, Art, Science, Music, Jokes

위르겐 슈미트후버가 2008년 arXiv에 올린 논문이다. 관찰자가 데이터를 더 잘 압축하게 될 때 그 개선 폭이 보상이 된다는 원리 하나로 아름다움, 흥미, 호기심, 창의성, 과학, 예술, 음악, 농담을 설명한다. 저자는 아름다움을 압축으로 줄어드는 비트 수, 즉 압축 가능성으로 보고, 흥미로움을 그 값이 늘어나는 속도, 즉 학습 곡선의 기울기로 정의한다.

September 28, 2026 · 19 분 · 서소영
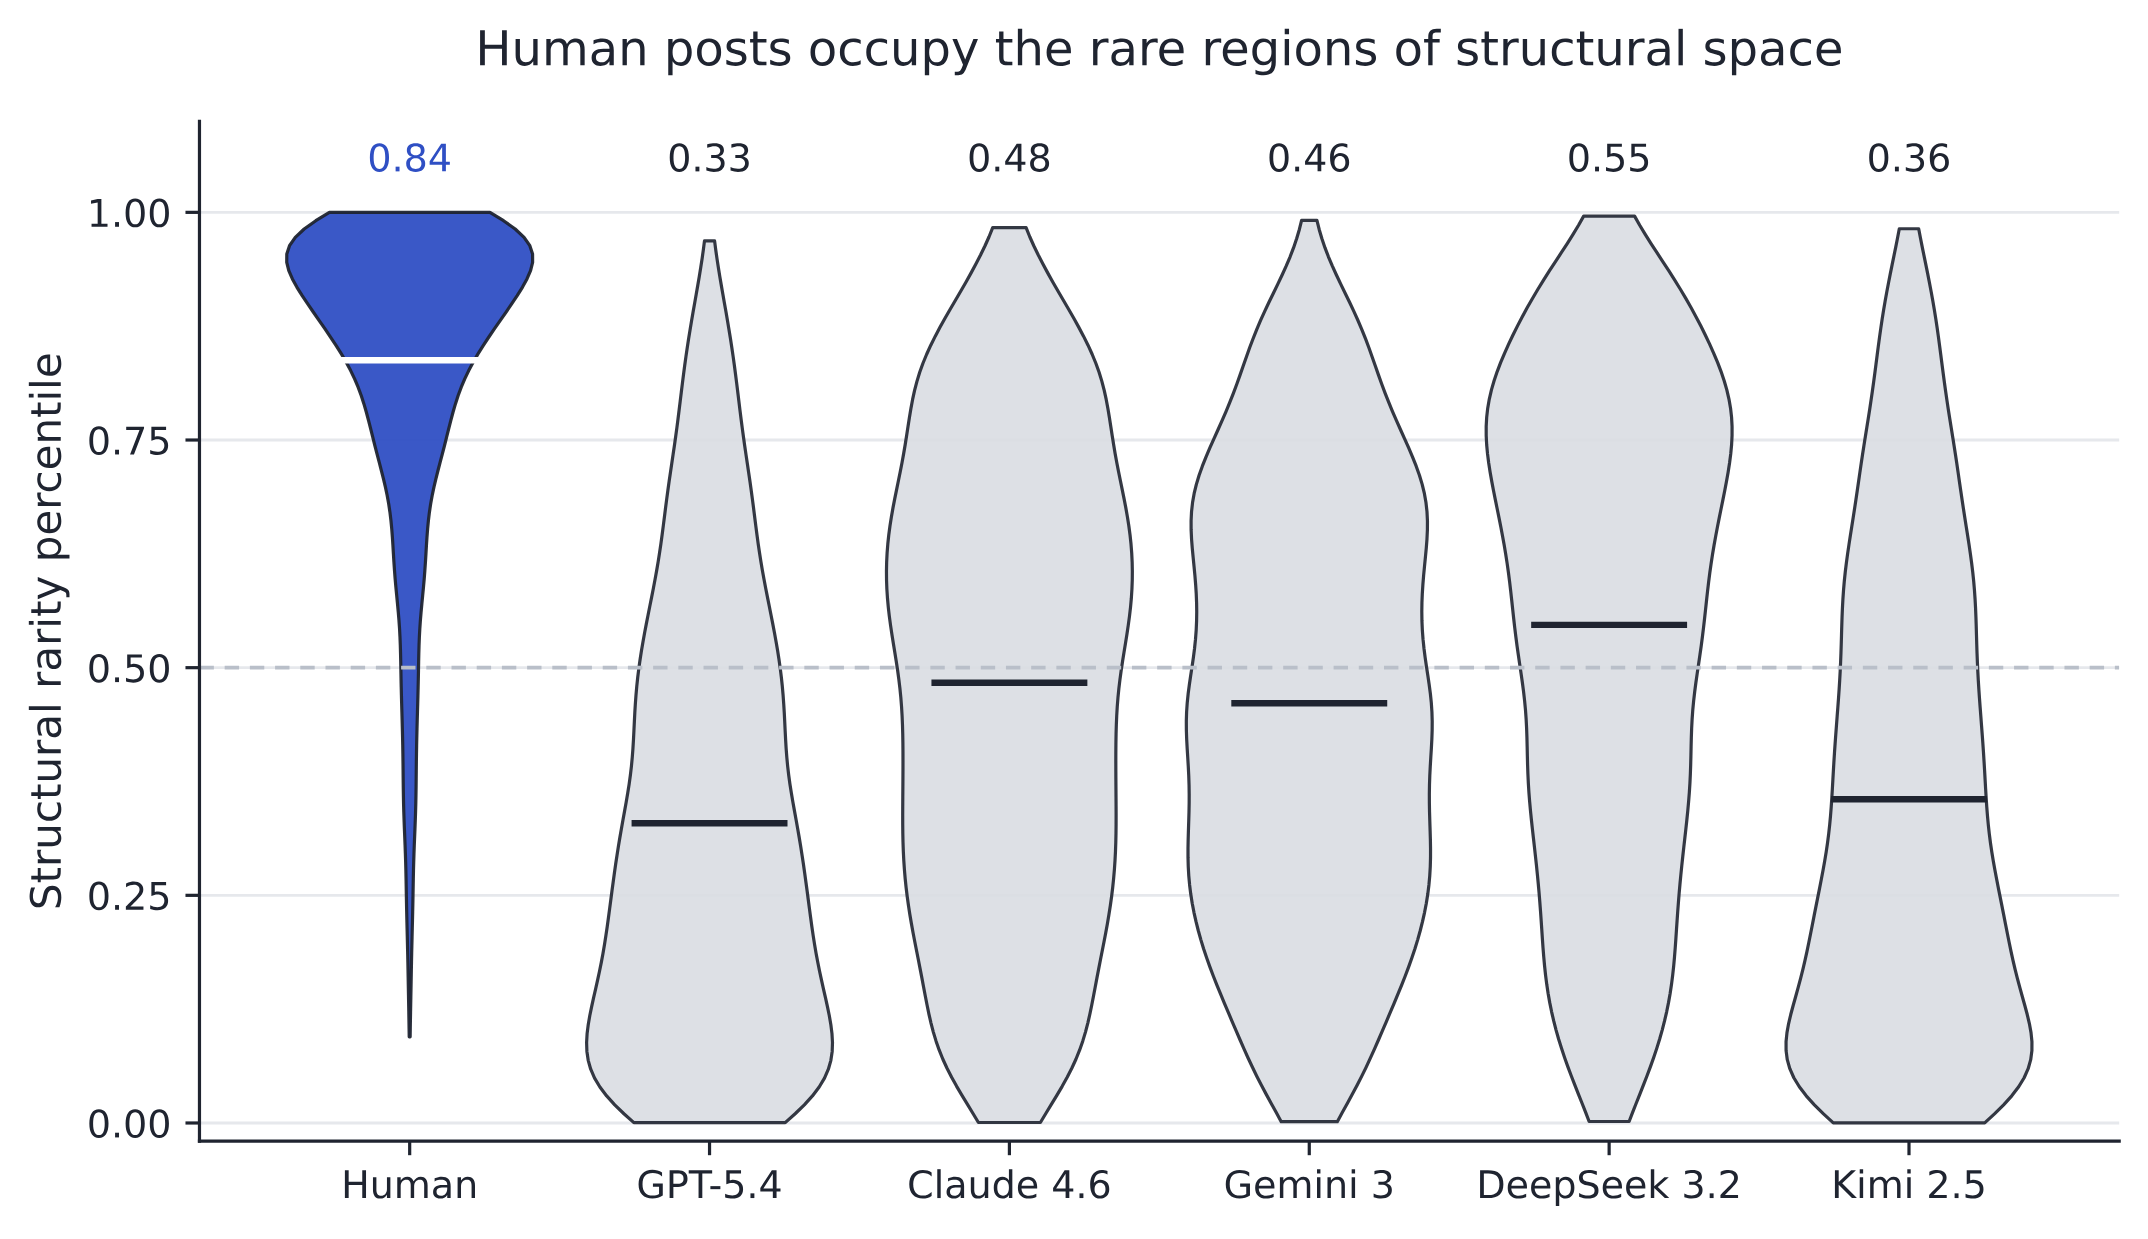
출처별 구조 희소성 백분위를 보여 주는 바이올린 그래프. 인간 글은 평균 0.84로 대부분 0.75 이상에 분포하고, GPT-5.4는 0.33, Claude 4.6은 0.48, Gemini 3는 0.46, DeepSeek 3.2는 0.55, Kimi 2.5는 0.36이다. 다섯 AI 모델의 분포 범위는 0에서 1까지다

SlopShape: Identifying AI-Generated Commercial Web Content

ChatGPT 출시 이전의 B2B 기업 블로그 글 2,250편과 다섯 AI 모델이 같은 브리프로 쓴 글 1만 1,250편을 비교한 논문이다. 어휘와 문체를 제외하고 글의 구조 특징만 보는 분류기가 AI 글을 macro-F1 98.0으로 판별했고, 모델이 자기 글을 고쳐 쓴 뒤에도 성능은 98.1이었다. AI 글은 제목에서 성과를 약속하고, 서두에서 전개 순서를 예고하고, 논지를 요약하며 끝나는 공통 형태를 보였다.

September 26, 2026 · 15 분 · 서소영