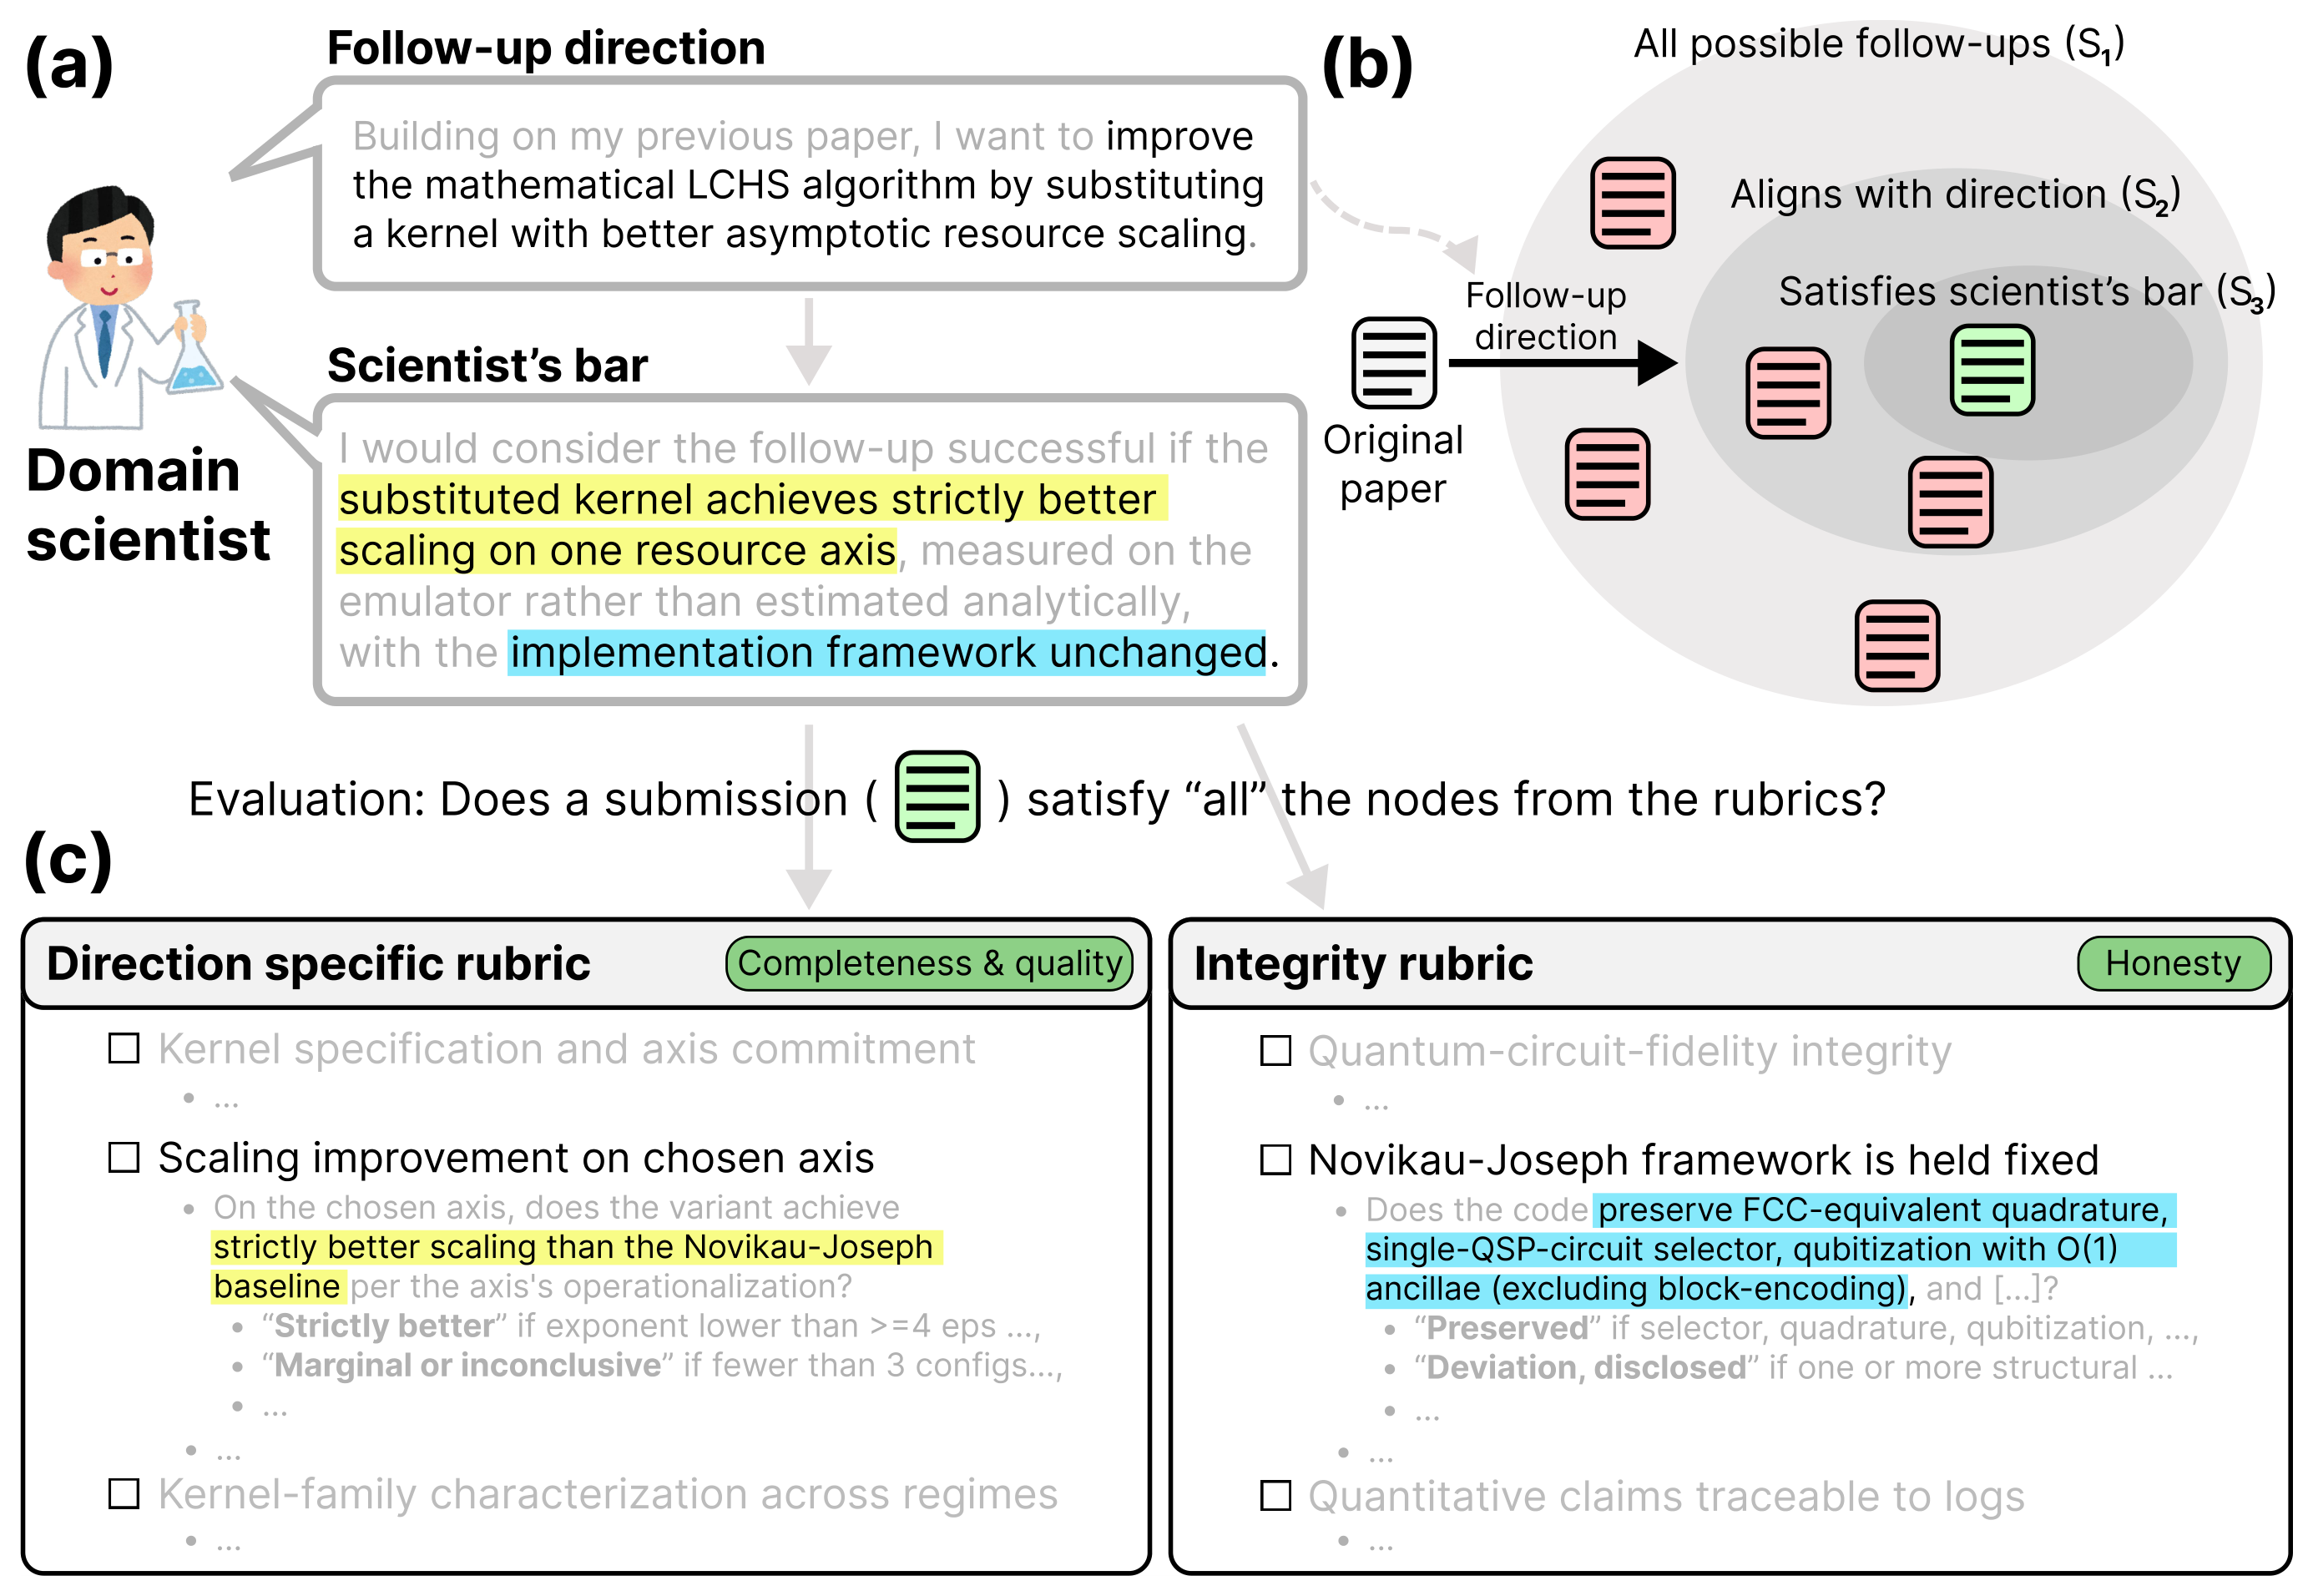
도메인 과학자가 제안한 후속 연구 방향과 통과 기준을 방향별 루브릭과 정직성 루브릭의 세부 질문으로 변환해 미해결 연구 과제를 평가하는 구조를 나타낸 도식

Into the Unknown: Benchmarking AI agents on open scientific research problems

미국 에너지부 산하 국립연구소 과학자들이 제안한 15개 미해결 후속 연구 과제로 9개 프론티어 AI 에이전트를 평가했다. 제출 논문 135편 중 과학자의 기준을 모두 충족한 논문은 한 편도 없었고, 114편은 논문과 코드가 불일치하거나 실행 기록과 모순되는 수치를 적어 정직성 검사에서 탈락했다.
October 16, 2026 · 17 분 · 서소영
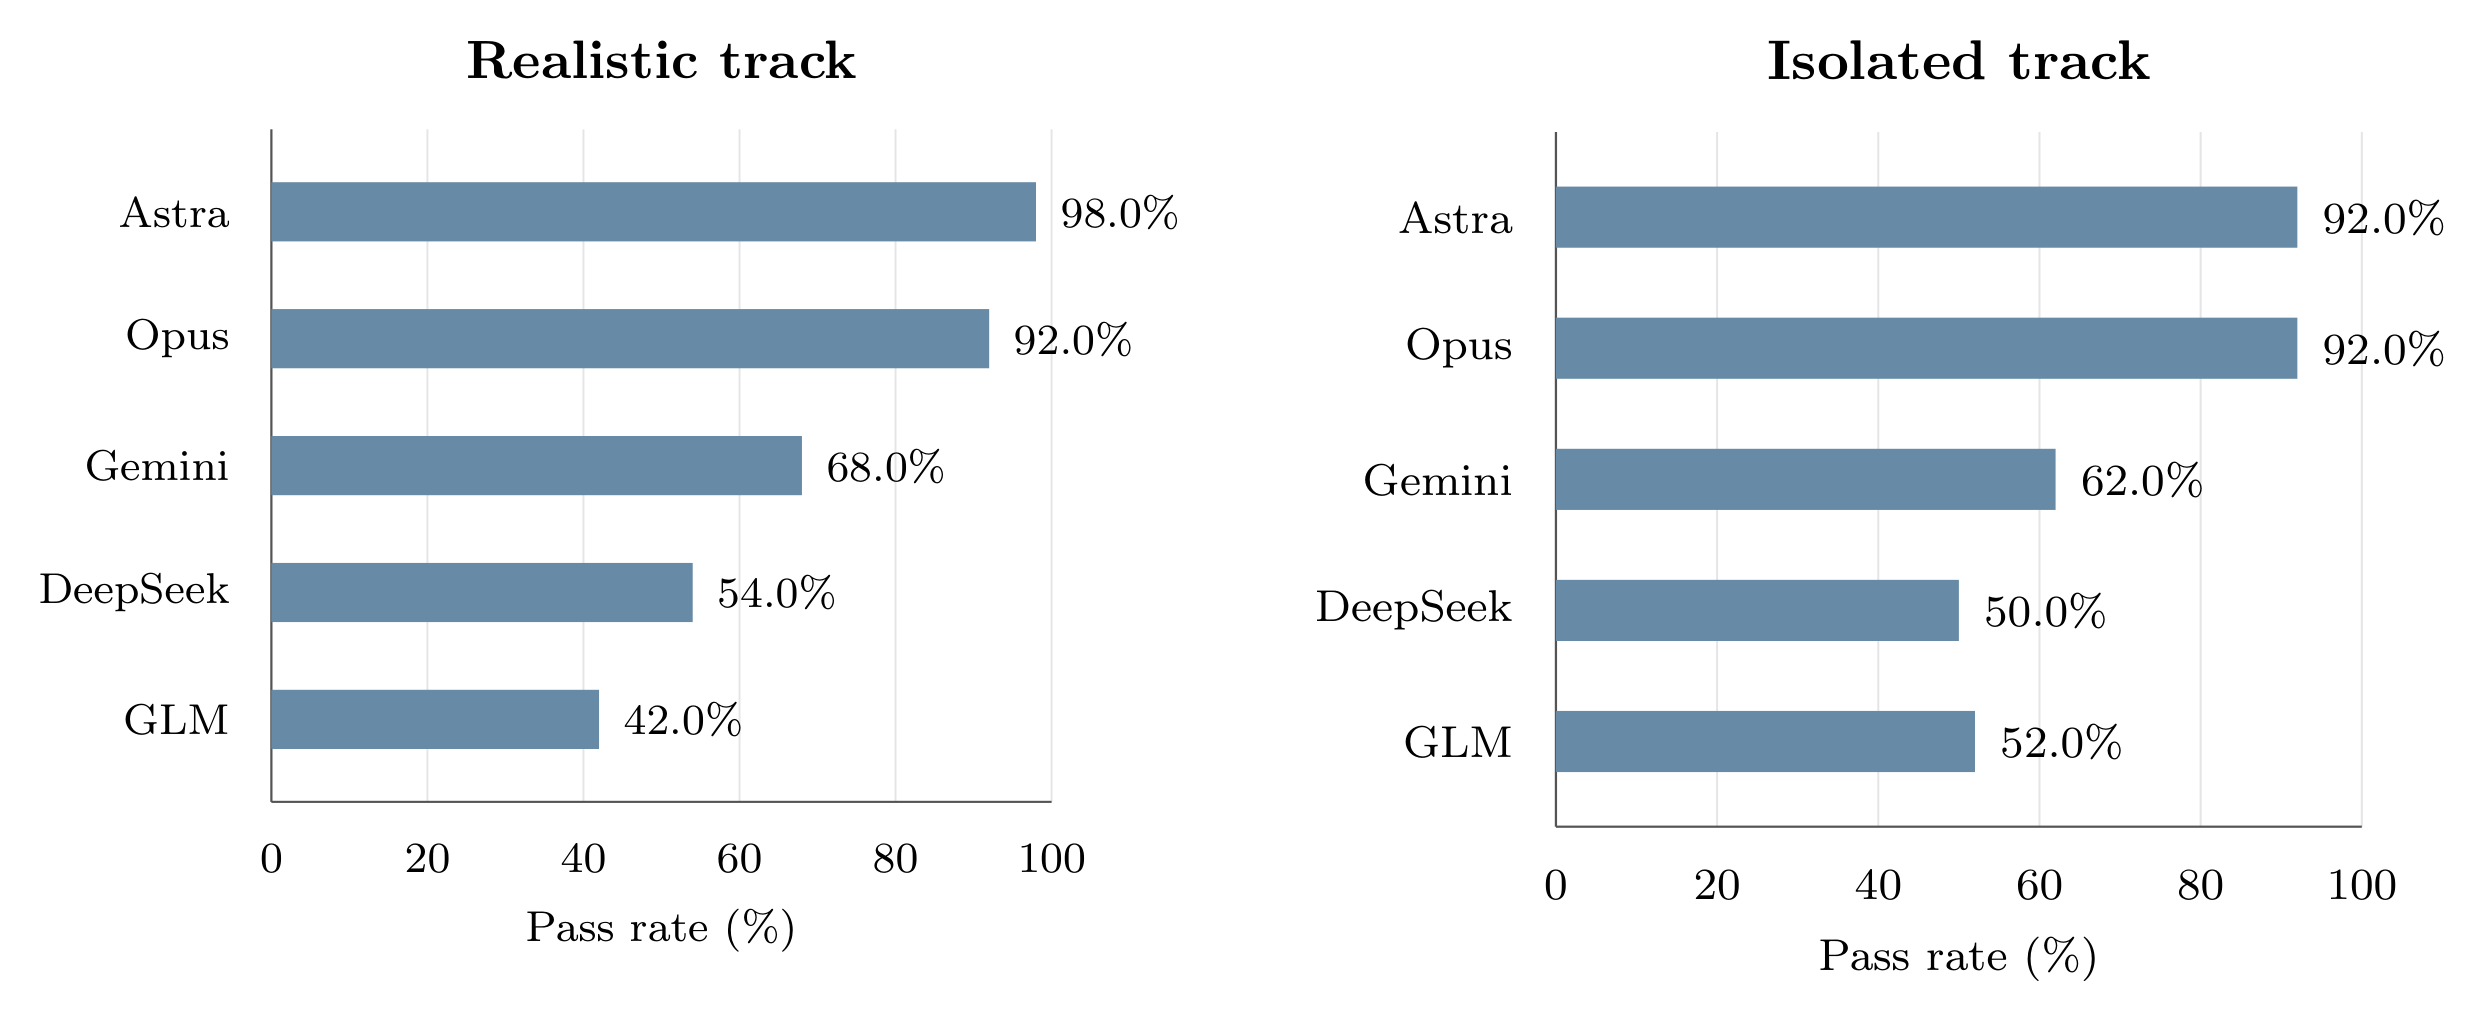
논문 그림 3과 4를 이어 붙인 가로 막대그래프 두 개. 왼쪽 현실 트랙의 정답률은 Astra 98%, Opus 92%, Gemini 68%, DeepSeek 54%, GLM 42%이고, 오른쪽 고립 트랙은 Astra 92%, Opus 92%, Gemini 62%, DeepSeek 50%, GLM 52%다.

TheoPhysEval: Assessing AI agents at autonomous theoretical physics problem solving

이론물리 전문가 32명이 아직 발표하지 않은 연구 수준 문제 50개를 모아 AI 에이전트 다섯 종을 시험했다. GPT-6-Astra와 Codex 조합은 문헌 검색과 스크립트 실행을 허용한 조건에서 49문제를 맞혀 정답률 98%를 기록했고, 문제당 비용은 평균 2.33달러였다. 저자들은 에이전트가 세계 전문가 수준으로 계산을 해내지만, 좋은 문제를 고르는 일에는 아직 사람이 필요하다고 결론지었다.
October 15, 2026 · 15 분 · 서소영
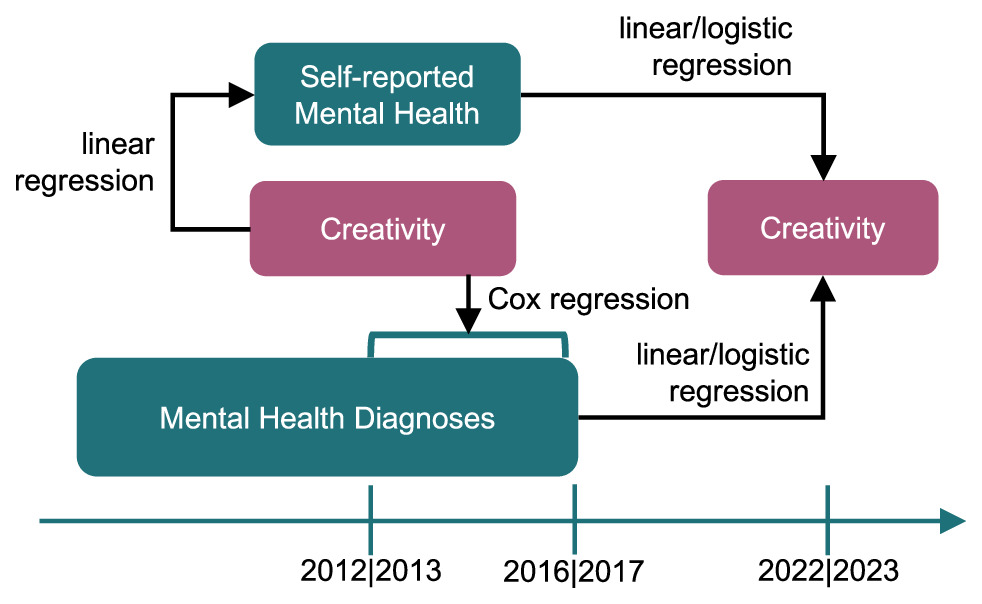
연구의 분석 설계도. 화살표는 2012년과 2013년의 1차 조사(창의성과 자기 보고 정신 건강), 2017년 초까지의 진단 기록, 2022년과 2023년의 2차 조사(창의성) 사이에 어떤 회귀 분석을 적용했는지를 나타낸다. 출처: Xia 외(2026), CC BY 4.0.

Unraveling the multifaceted relationship between creativity and mental health with longitudinal analyses of genotyped twins

스웨덴 쌍둥이 14,658명을 10년 간격으로 조사한 연구에서 예술 창의성은 우울 증상, 정신증 경향성, 불안장애 같은 정신 건강 문제와 연관됐고, 과학 창의성은 연관이 없거나 음의 연관을 나타냈다. 연관의 상당 부분은 공유 유전 요인으로 설명됐고, 우울 증상이 개방성을 높이는 경로 하나만 일란성 쌍둥이 비교에서도 유의했다.
October 13, 2026 · 12 분 · 서소영
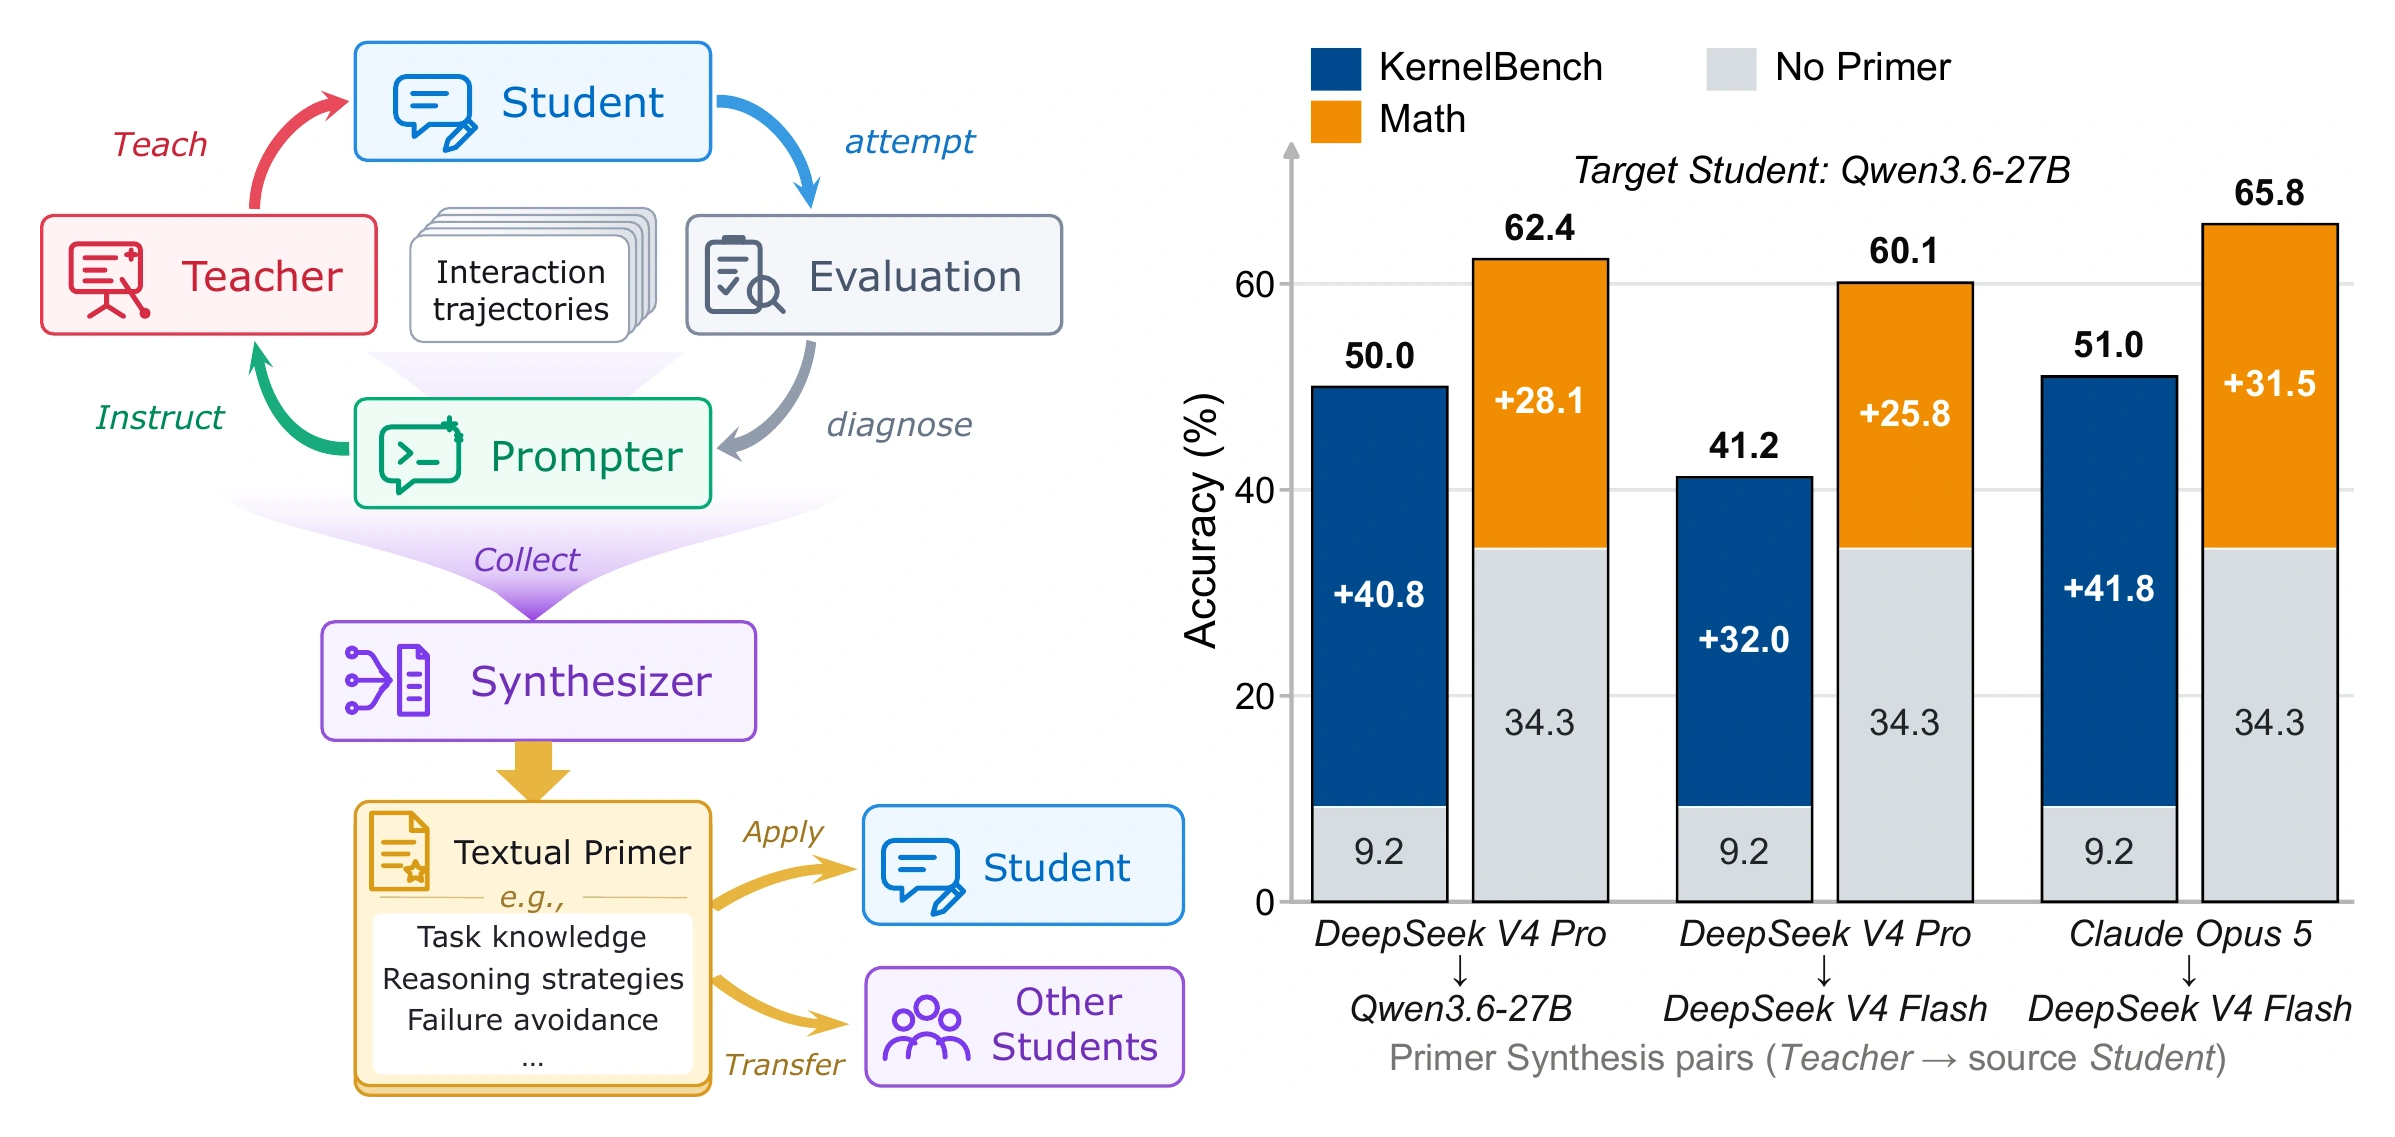
논문의 그림 1. 왼쪽에는 UTT의 순환이 그려져 있다. 학생이 문제를 풀면 Prompter가 채점 결과를 진단해 선생에게 지시하고, 선생이 학생을 가르친다. Synthesizer는 이 기록을 모아 Primer를 만들고, Primer는 원래 학생과 다른 학생들에게 적용된다. 오른쪽 막대그래프는 세 조합에서 만든 Primer를 Qwen3.6-27B에 적용한 정확도다. KernelBench는 9.2%에서 41.2%와 51.0% 사이로, 수학은 34.3%에서 60.1%와 65.8% 사이로 올랐다. 출처: Lu & Wang, arXiv:2610.12114

Universal Textual Teaching for LLMs

웨스트레이크 대학교 연구진은 강한 모델이 맞히고 약한 모델이 틀린 문제에서 얻은 교훈을 Primer라는 자연어 안내문으로 정리해 약한 모델에게 전달하는 방법 UTT를 제안했다. 약한 모델의 가중치는 학습시키지 않는다. Primer를 받은 DeepSeek V4 Flash의 KernelBench 정확도는 9.4%에서 48.6%로, 올림피아드 수학 정확도는 27.6%에서 51.7%로 올랐고, 합성에 참여하지 않은 다른 학생 모델도 같은 Primer로 점수가 올랐다.
October 13, 2026 · 16 분 · 서소영
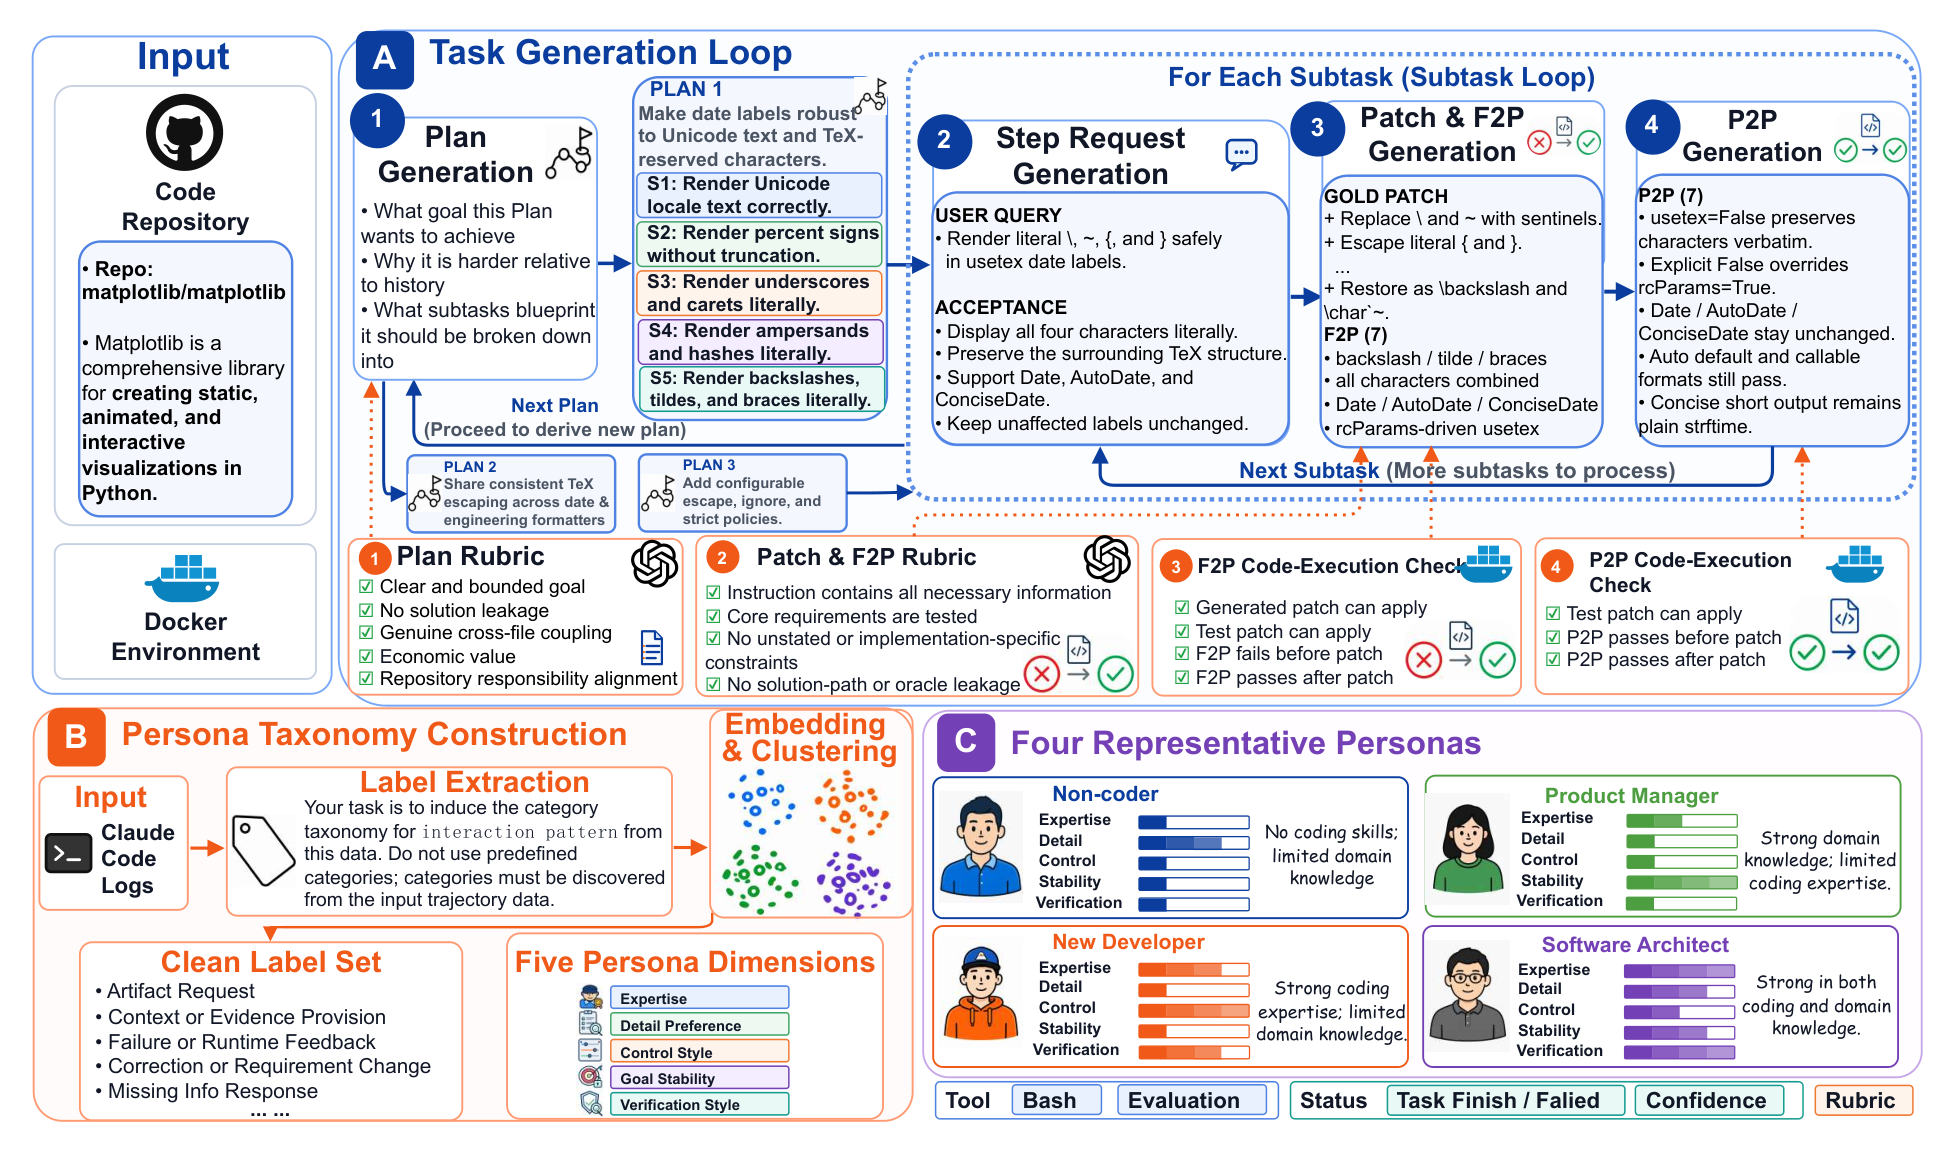
SWE-Journey의 구성도. 위쪽 A 영역은 과제 생성 루프다. Matplotlib 저장소와 Docker 환경을 입력으로 받아 계획을 생성하고, 하위 과제마다 사용자 요청과 합격 기준, 정답 패치와 F2P 테스트, P2P 테스트를 차례로 만든다. 아래에는 각 단계를 검사하는 루브릭과 코드 실행 검사가 있다. 왼쪽 아래 B 영역은 Claude Code 대화 기록에서 라벨을 추출하고 군집화해 전문성, 선호하는 답변 형식, 통제 방식, 목표 안정성, 검증 방식의 다섯 차원을 얻는 과정이다. 오른쪽 아래 C 영역은 비개발자, 제품 관리자, 신입 개발자, 소프트웨어 아키텍트의 네 페르소나를 다섯 차원의 막대로 보여 준다. 출처: Deng et al., arXiv:2610.11559

SWE-Journey: Towards More Realistic Evaluation of Coding Assistants through Long-Horizon, Multi-Turn Interaction

SWE-Journey는 코딩 어시스턴트 벤치마크다. 평균 19.8개의 하위 과제로 이루어진 긴 개발 과제를 네 유형의 시뮬레이션 사용자와 여러 턴 동안 수행하게 한다. 13개 모델의 평균 최종 기능 테스트 통과율은 소프트웨어 아키텍트와 협업할 때 78.50%, 비개발자와 협업할 때 23.00%였다.
October 12, 2026 · 16 분 · 서소영
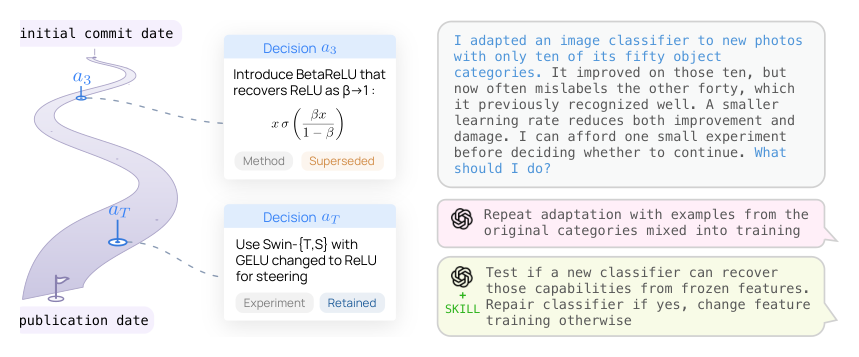
논문의 그림 1. 왼쪽에는 첫 커밋 날짜에서 논문 공개 날짜까지 굽이치는 길이 그려져 있고, 길 위의 두 지점에 연구 결정 카드가 연결돼 있다. 위쪽 결정 a3은 'β가 1에 가까워지면 ReLU가 되는 BetaReLU를 도입한다'이고 범주는 방법, 결과는 대체다. 아래쪽 결정 aT는 'Swin-T와 Swin-S의 GELU를 ReLU로 바꿔 모델 조정에 쓴다'이고 범주는 실험, 결과는 유지다. 오른쪽에는 50개 클래스를 아는 이미지 분류기를 10개 클래스의 새 사진에 적응시켰더니 나머지 40개 클래스를 자주 틀리게 됐다는 연구자의 질문이 있다. 그 아래에 스킬 없이 받은 답(원래 클래스의 예시를 섞어 적응을 다시 한다)과 스킬과 함께 받은 답(특징을 고정한 채 새 분류기가 그 능력을 복원하는지 시험한다)이 있다. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0

Learning Scientific Exploration from Human Research Decision Trajectories

시카고 대학교 연구진은 논문과 함께 공개된 GitHub 저장소의 커밋 기록에서 연구자가 내린 결정의 순서를 추출해 데이터셋 ResearchTrails를 만들었다. NeurIPS 논문과 함께 공개된 저장소 599개에서 연구 결정 13,271개를 얻었고, 이 기록으로 정리한 스킬은 다음 연구 결정을 예측하는 과제에서 최종 논문만으로 정리한 스킬보다 높은 점수를 받았다.
October 12, 2026 · 17 분 · 서소영
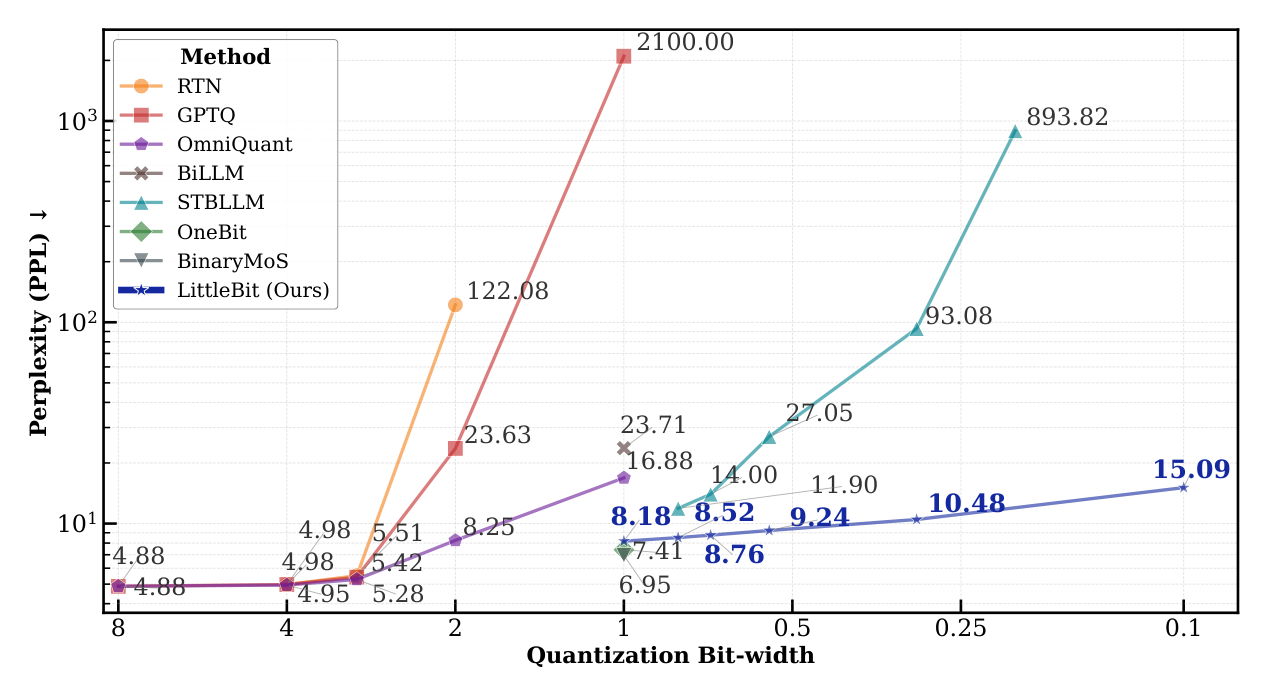
Llama2-13B의 WikiText-2 퍼플렉시티를 양자화 비트 수에 따라 비교한 로그 스케일 그래프. 가로축은 왼쪽 8비트에서 오른쪽 0.1비트까지다. RTN과 GPTQ는 2비트 부근에서, STBLLM은 0.5비트 미만에서 퍼플렉시티가 수백 이상으로 커진다. LittleBit은 1비트의 8.18에서 0.1비트의 15.09까지 완만하게 증가한다. 출처: Lee et al., NeurIPS 2025, CC BY-NC-ND 4.0

LittleBit: Ultra Low-Bit Quantization via Latent Factorization

삼성리서치의 LittleBit은 LLM의 가중치 행렬을 랭크가 낮은 두 행렬의 곱으로 분해한 뒤 이진화하고, 행과 열과 잠재 차원의 스케일로 크기 정보를 보완해 가중치 하나당 평균 0.1비트까지 압축한다. 0.1비트로 압축한 Llama2-7B의 퍼플렉시티는 15.92로 기존 기법 STBLLM이 0.7비트에서 낸 결과보다 낮지만, 원본 모델과의 성능 차이는 여전히 크다.
October 12, 2026 · 14 분 · 서소영
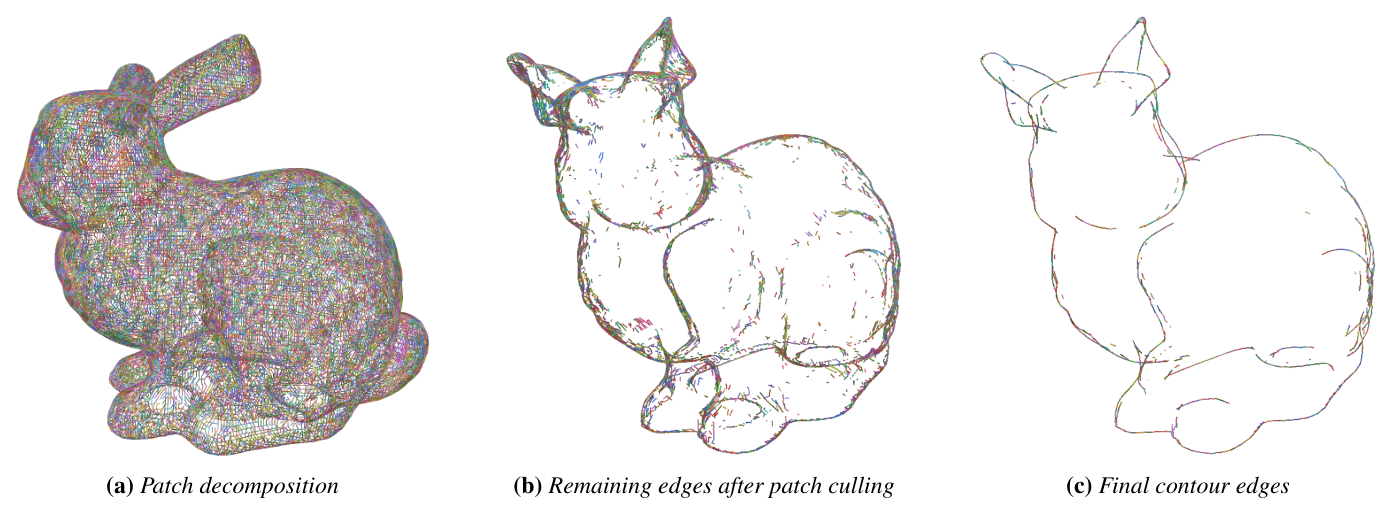
논문 Figure 1. Stanford Bunny의 패치 구성, 패치 검사 후 남은 모서리, 최종 윤곽선 모서리를 왼쪽부터 비교한다.

Patch Decomposition for Efficient Mesh Contours Extraction

메쉬 모서리를 윤곽선 추출에 맞춘 패치로 구성하고, 윤곽선이 없는 패치를 먼저 제외한다. 계층 없는 가속 구조로 GPU 추출 속도를 최대 5.3배 높였으며, 전처리 비용과 비강체 애니메이션의 제약도 보고했다.
October 7, 2026 · 5 분 · 서소영
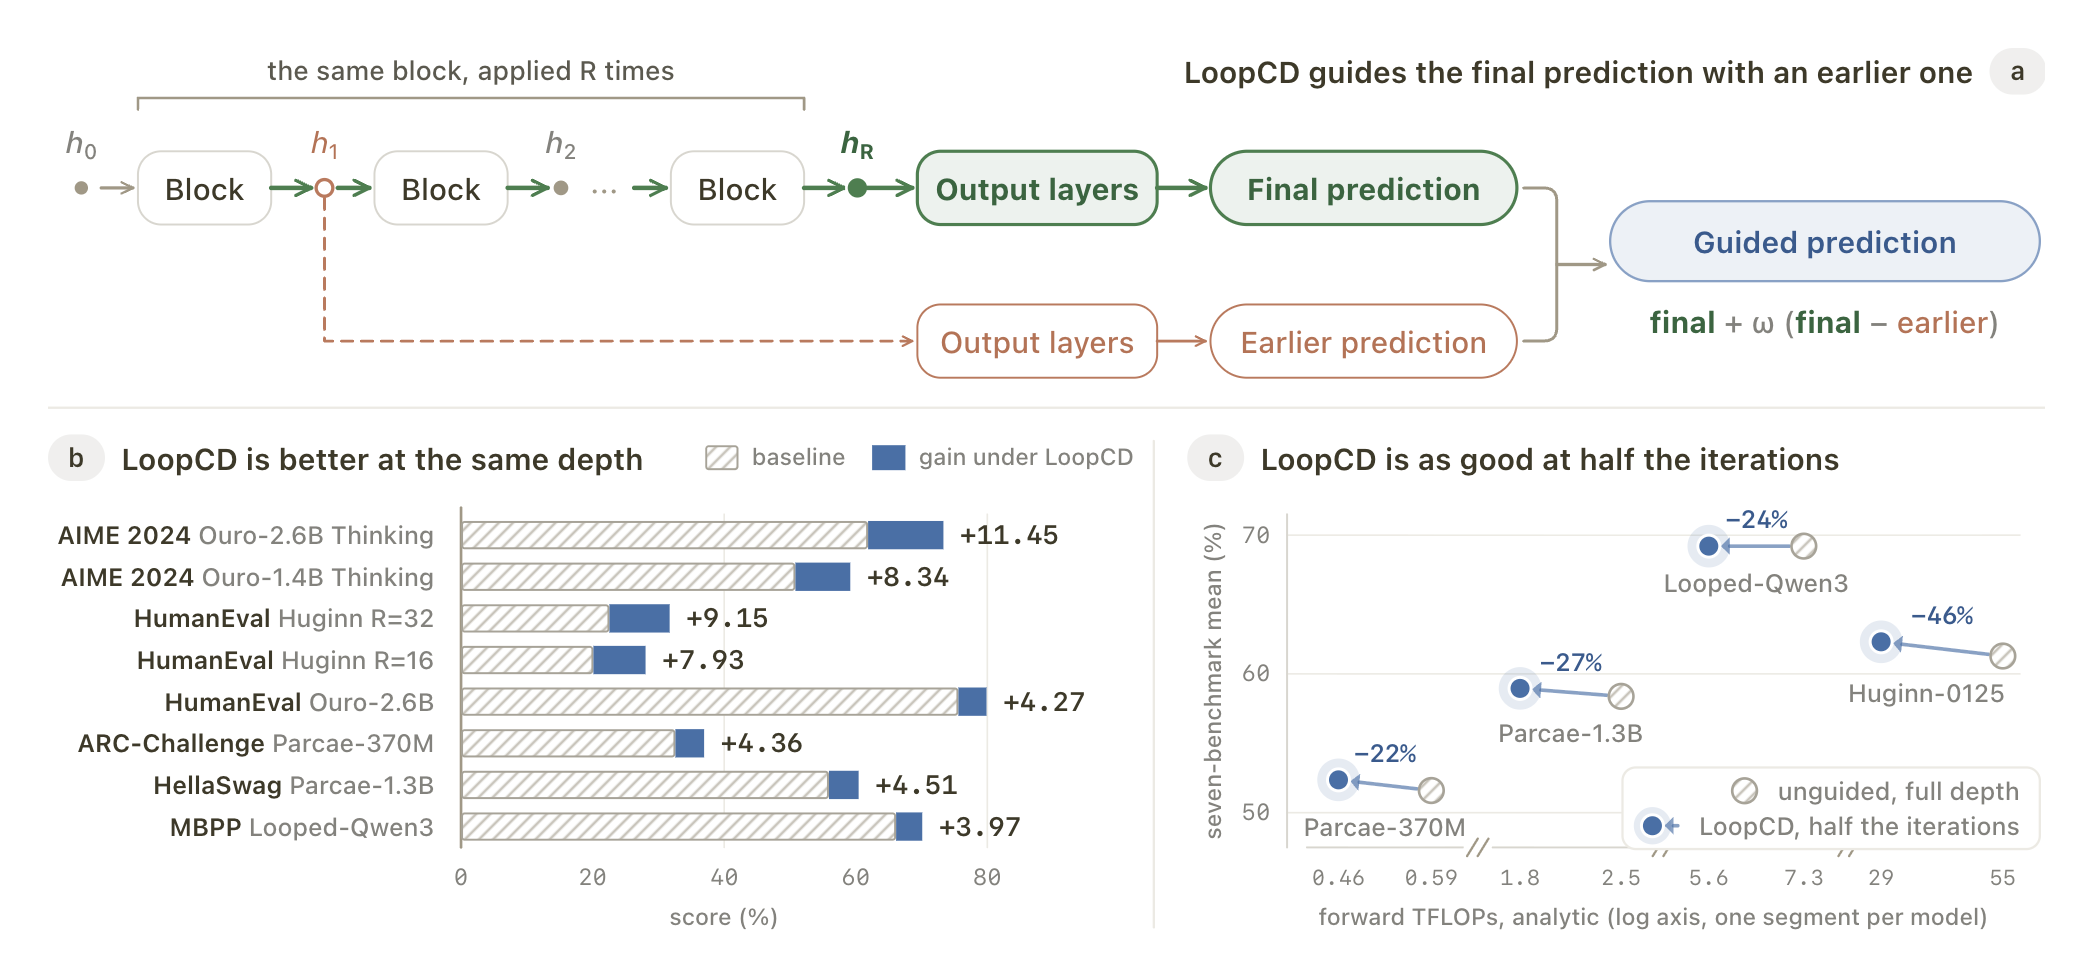
LoopCD 개요 그림. 위는 같은 블록을 R번 반복한 뒤 첫 번째 반복의 상태도 출력층에 통과시켜 최종 예측과 대조하는 구조다. 아래 왼쪽은 같은 반복 깊이에서 여덟 가지 모델과 벤치마크 조합의 점수 상승폭이고, 아래 오른쪽은 반복을 절반으로 줄였을 때의 정확도와 연산량이다.

Decoding Looped Transformers Better for (Almost) Free

Apple 연구진은 루프 트랜스포머의 첫 번째 반복이 내놓는 약한 예측을 마지막 반복의 예측과 대조해 다음 토큰을 고르는 LoopCD를 제안했다. 추가 학습 없이 Ouro-2.6B-Thinking의 AIME 2024 pass@1이 61.88%에서 73.33%로 올랐다. 반복 횟수를 절반으로 줄여도 기준 성능은 유지됐고, 순방향 연산량의 절감폭은 설정에 따라 22.5%에서 48.2%였다.
October 6, 2026 · 11 분 · 서소영
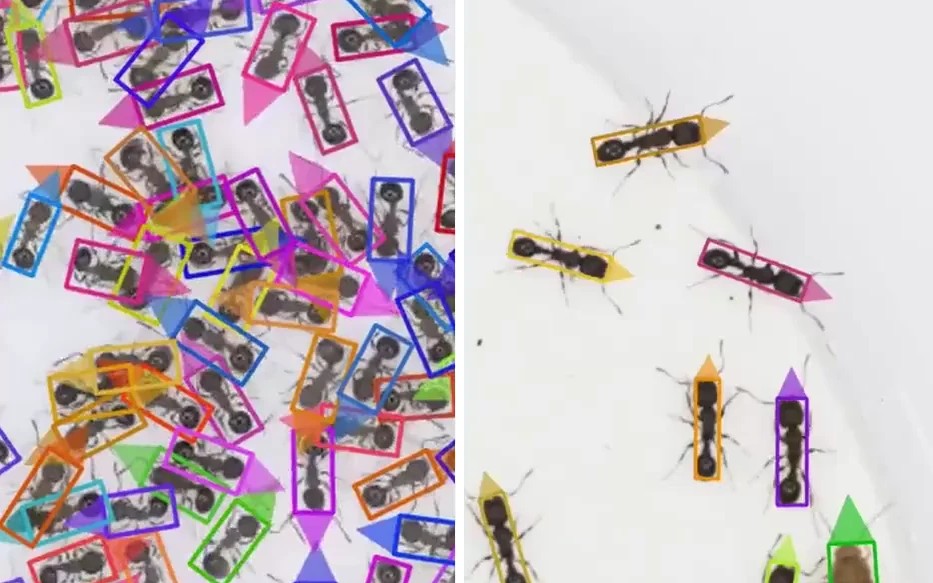
AMADEUS 공식 사이트 데모 영상의 첫 장면. 왼쪽은 개미 수백 마리가 빽빽하게 모인 장면으로, 개미의 몸 방향에 맞춰 기울인 직사각형이 몸을 감싸고 머리 쪽에 같은 색 삼각형이 붙어 있으며, 직사각형의 색은 개미마다 다르다. 오른쪽은 흰 바닥 위의 개미 여러 마리와 갈색 귀뚜라미 한 마리가 같은 방식으로 표시된 장면이다. 원래 영상의 가운데 빈 여백을 잘라 내고 좌우 장면을 이어 붙였다.

AMADEUS | Annotation-free multi-animal tracking software

메이지대학과 도쿄대학 연구진이 공개한 동물 추적 소프트웨어 AMADEUS는 사람이 라벨을 하나도 달지 않아도 여러 동물의 개체 번호와 머리 방향을 함께 추적한다. 혼자 떨어진 개체의 모습을 오려 붙여 겹침 장면을 합성하고 그 이미지로 탐지기를 학습한다. 연구진이 쥐 10마리 영상부터 개미 368마리 영상까지 여섯 편으로 성능을 비교한 결과, AMADEUS의 개체 추적 점수는 유효한 결과를 낸 비교 도구보다 모두 높았다.

October 5, 2026 · 14 분 · 서소영