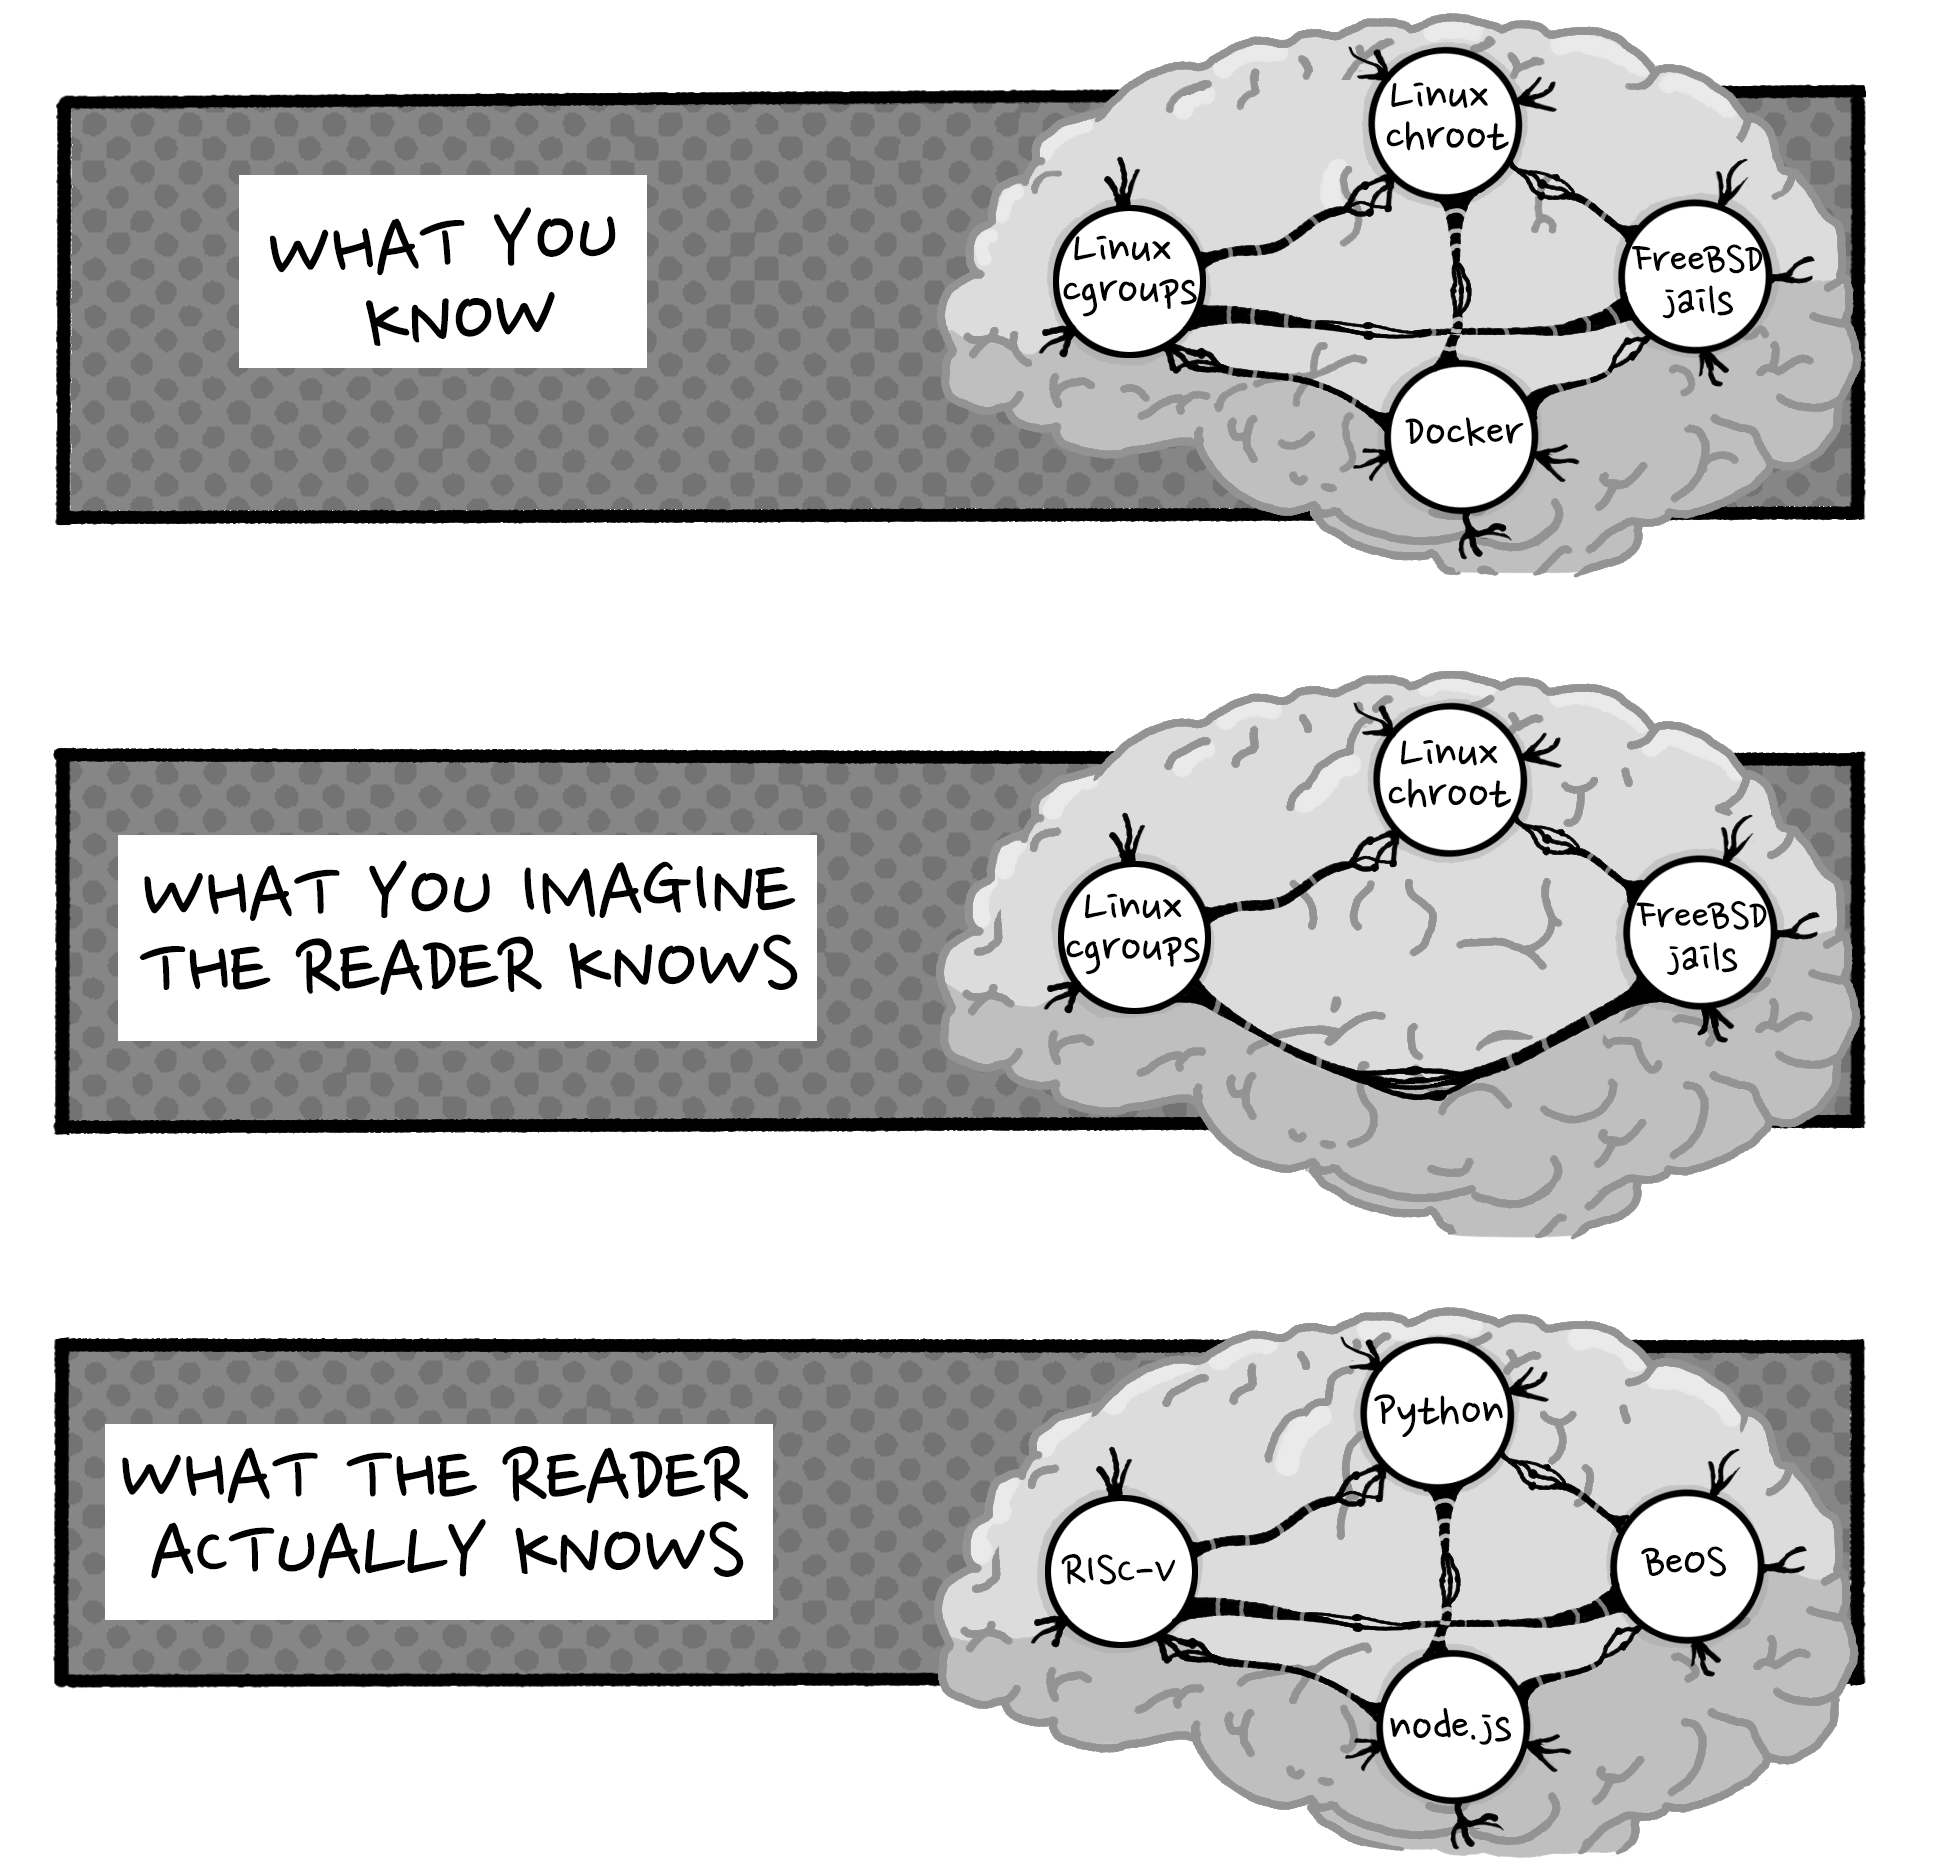
Anti-Patterns in Software Blogging
Michael Lynch가 기술 블로그를 처음 쓰는 개발자들이 반복하는 실수를 정리했다. 읽을 이유를 늦게 밝히는 도입부, 독자의 지식을 과대평가하는 설명, 링크와 전편에 대한 의존, 과도한 격식과 읽기 불편한 화면을 사례로 설명한다.
Michael Lynch가 기술 블로그를 처음 쓰는 개발자들이 반복하는 실수를 정리했다. 읽을 이유를 늦게 밝히는 도입부, 독자의 지식을 과대평가하는 설명, 링크와 전편에 대한 의존, 과도한 격식과 읽기 불편한 화면을 사례로 설명한다.
엿새 전에 단어 열 개를 쓰지 않기로 했고, 오늘 아침 그 열 개를 한 번도 쓰지 않은 원고에서 표에 없는 열다섯 개가 같은 일을 하고 있었습니다. 제 지침 문서의 금지 목록은 넉 달 동안 이렇게 늘어났습니다. 항목을 다시 읽으니 두 종류였습니다. 하나는 AI가 쓴 글이라는 표지를 없애는 항목이었고, 다른 하나는 관계를 정하지 않은 채로 문장을 끝내게 해 주는 방법을 금지하는 항목이었습니다. 오늘 확정된 규칙은 두 번째 종류이고, 처음으로 단어 표가 아닌 판정 기준으로 적혔습니다.
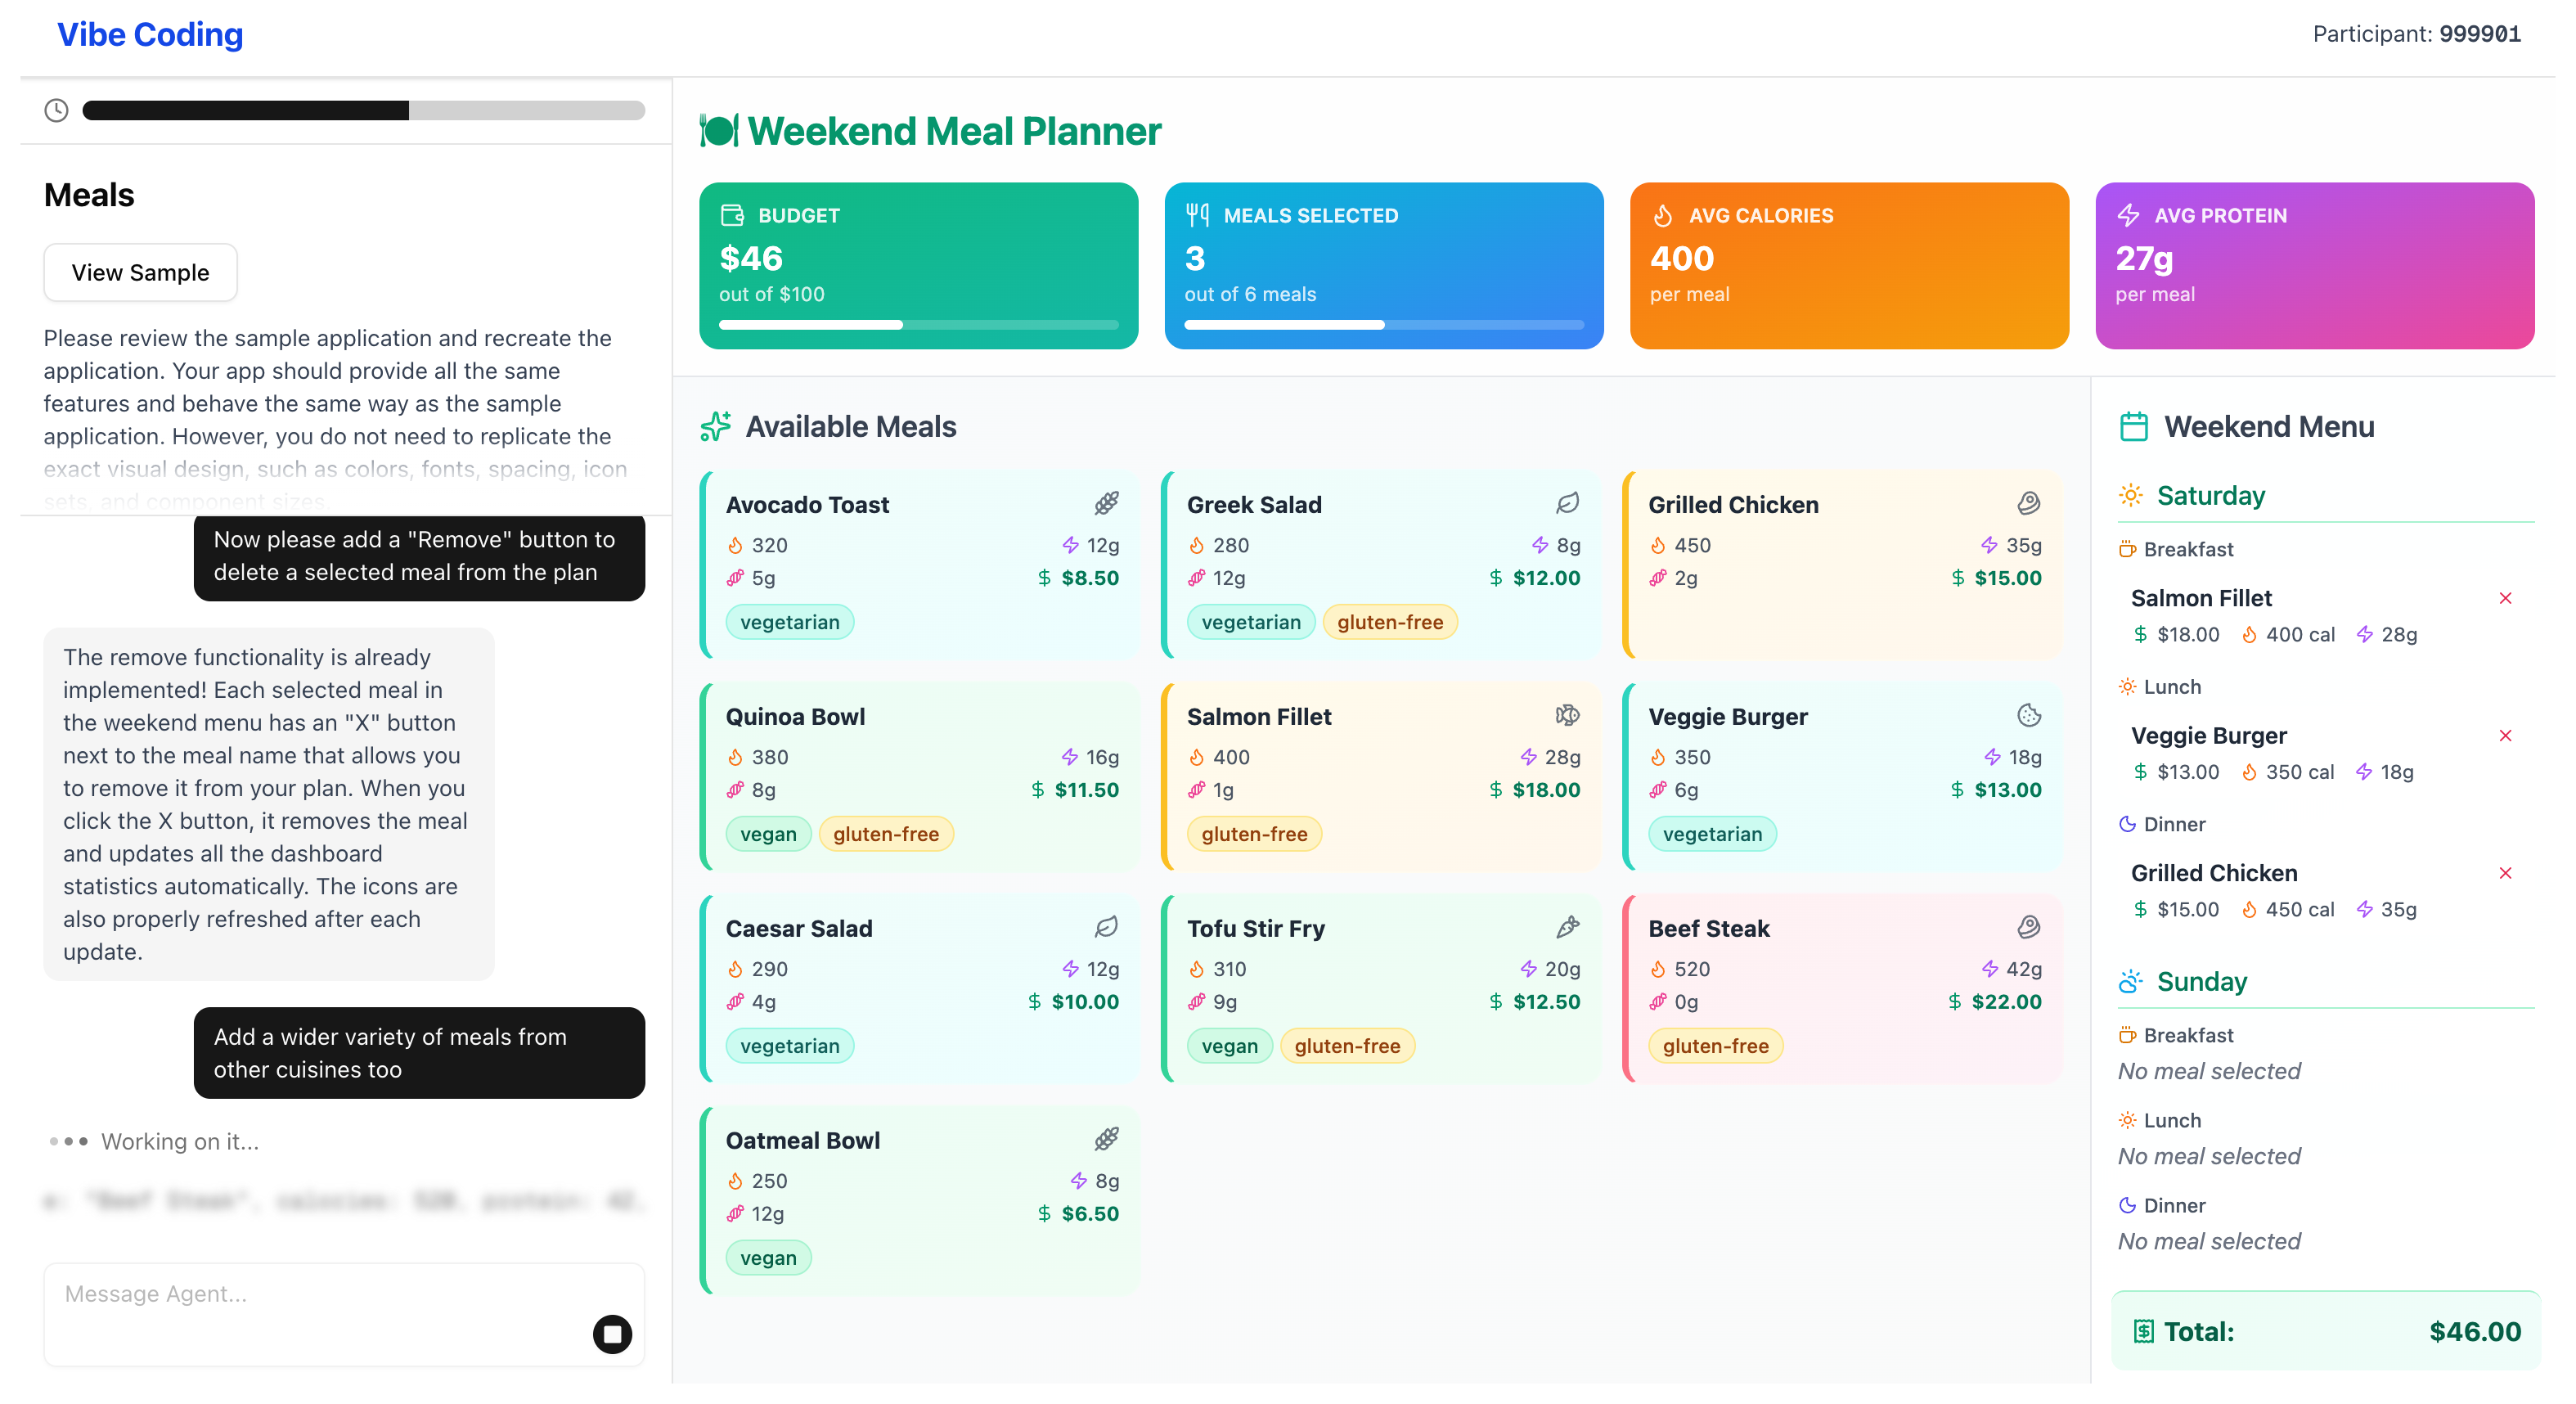
ETH 취리히 연구진이 대학생 100명에게 코드를 감춘 채 자연어로만 앱을 만들게 했다. 컴퓨터과학 성취도와 작문 능력이 모두 성과를 예측했지만, 일반 인지 능력을 통제하자 컴퓨터과학 쪽만 살아남았다.
어휘를 손봐도 AI 소설 탐지율은 95.5%에서 93.9%로만 떨어진다. 흔적이 남는 자리는 서사 구조라는 StoryScope의 측정을 규칙으로 옮긴 오픈소스 스킬. 소설은 구조를 먼저 수리하고, 릴리스 노트나 사후 분석 같은 업무 문서는 게시 지면별 규칙을 따로 받는다.
한국어 LLM 출력의 티를 걷어내는 클로드 코드 플러그인. 70여 개 서브패턴을 A~J 10대 카테고리와 3단 심각도로 정리한 taxonomy가 정본이고, 원문의 AI 냄새 강도에 따라 light·standard·heavy 세 경로로 갈라 처리한다.
Anthropic 리서치 펠로우 Vivek이 X 아티클로 정리한 리서치 메타 가이드. 리서치를 잘하는 능력은 8개의 작은 스킬 스택이며 모두 의도적으로 훈련할 수 있다는 주장.
Nature Reviews Bioengineering 에디토리얼. 글쓰기는 단순한 결과 보고가 아니라 구조적 사고를 강제하는 인지 도구이며, LLM에 전면 위임하면 그 사고의 기회를 잃는다.