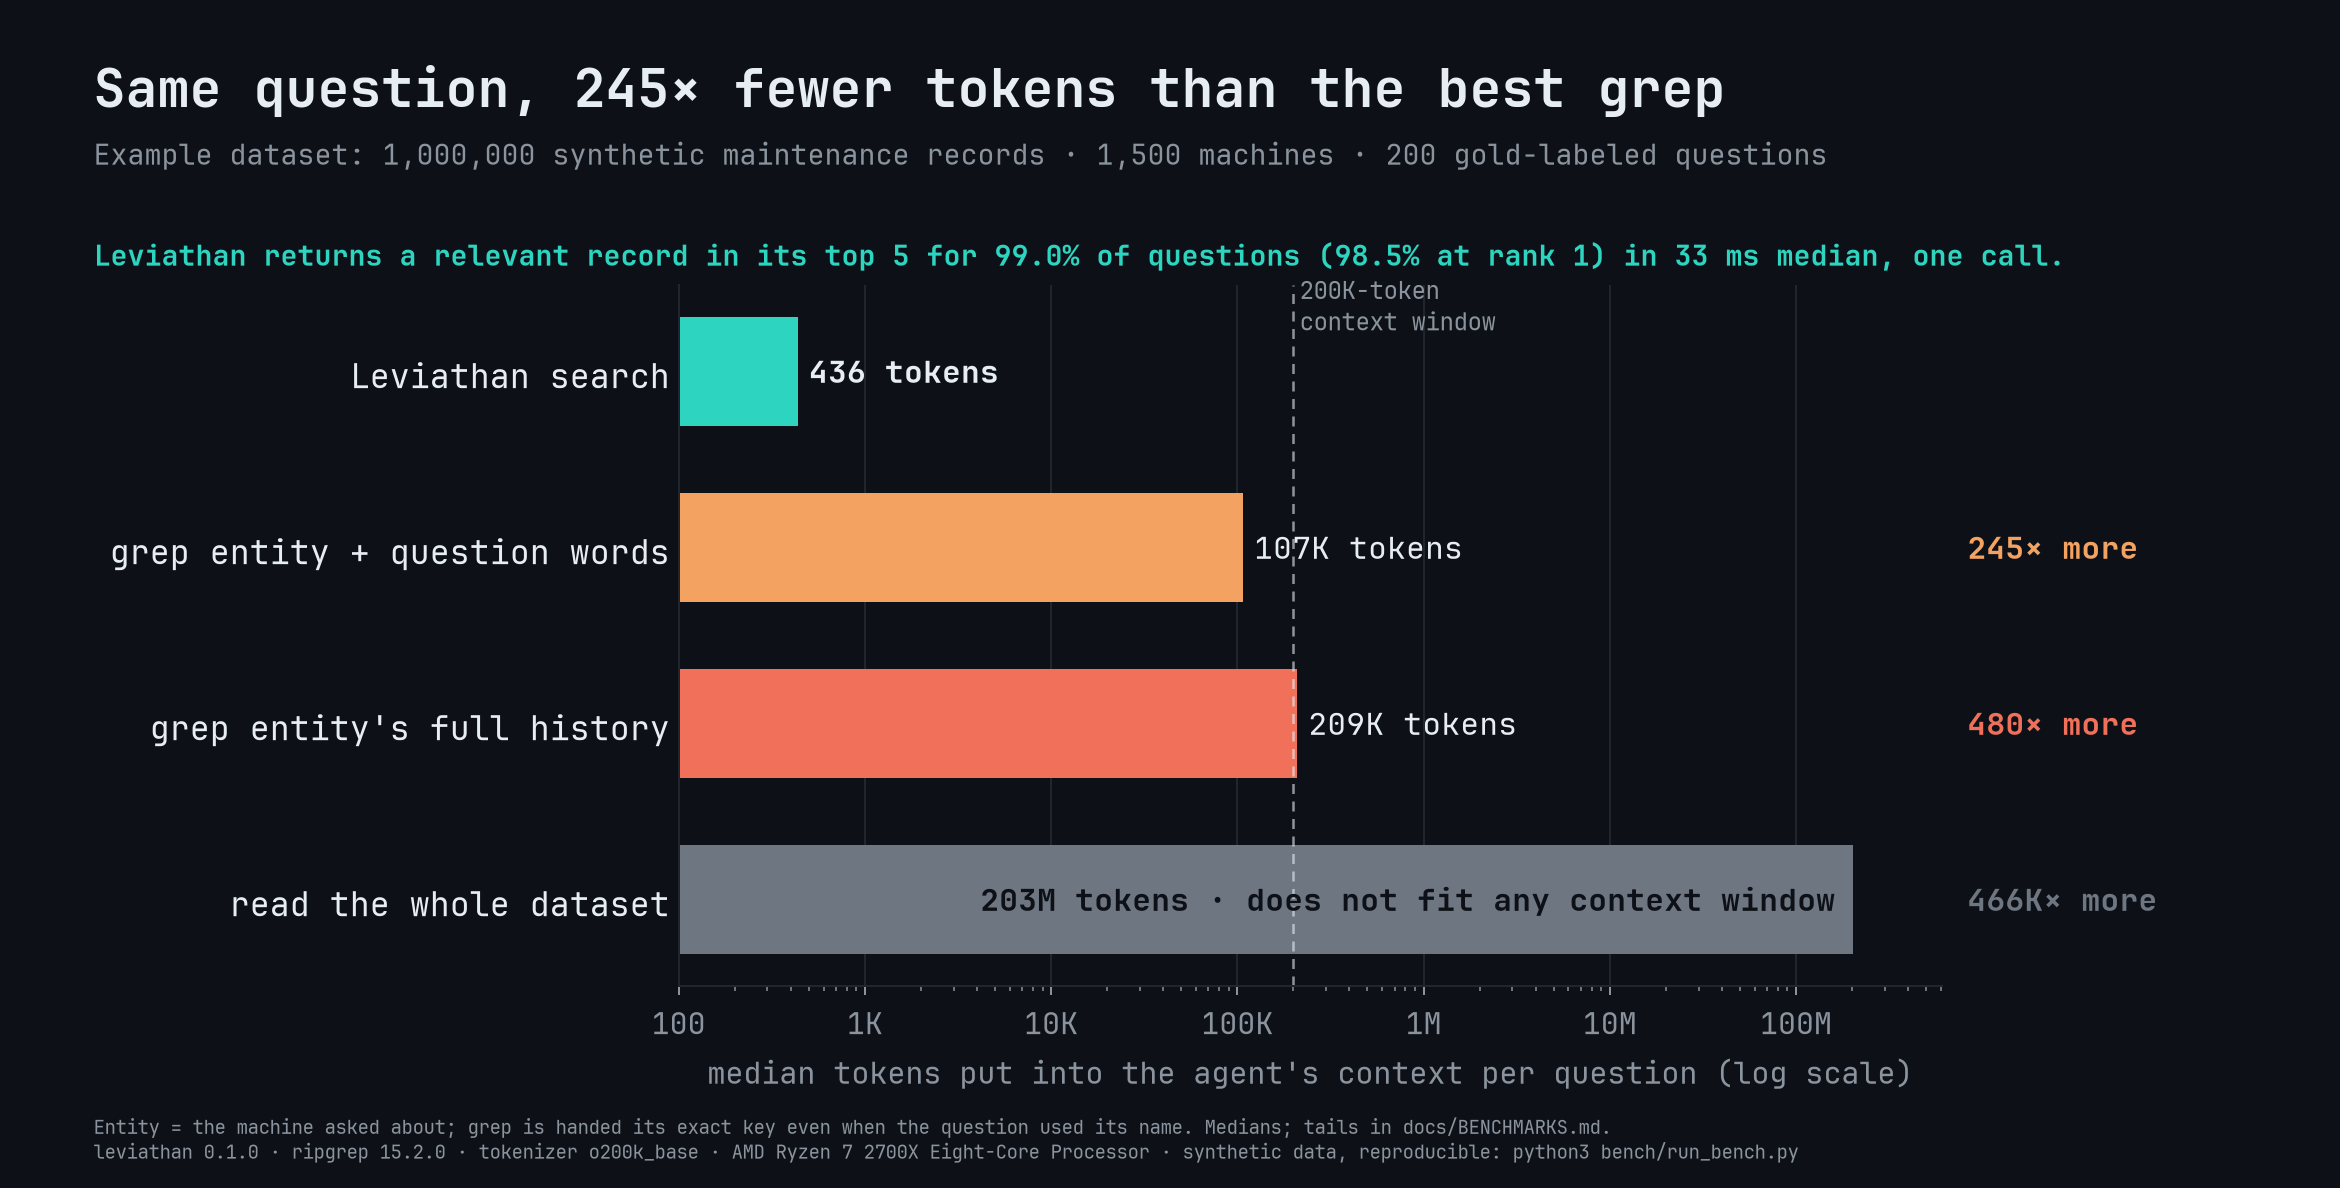
레코드 100만 건에서 질문 하나에 컨텍스트로 들어가는 토큰 중앙값을 로그 눈금 막대그래프로 비교한 그림. Leviathan 검색 436토큰, 단어 필터 grep 107K토큰(245배), 이력 전체 grep 209K토큰(480배), 데이터셋 전체 읽기 203M토큰(46만 6천 배)이고, 20만 토큰 컨텍스트 창 경계가 점선으로 표시되어 있다.

Leviathan: Deep memory for agents over large datasets

Joshua Baker가 2026년 10월 5일 공개한 Rust 프로그램 Leviathan은 JSONL, CSV, SQLite 같은 형식의 레코드를 SQLite 전문 검색 인덱스 하나로 만들어 둔다. 에이전트가 질문하면 순위를 매긴 레코드 몇 건을 약 450토큰 분량으로 돌려준다. 합성 정비 기록 100만 건 벤치마크에서 grep 방식보다 245배 적은 토큰을 쓰면서, 질문의 99.0%에서 정답 레코드를 상위 5건에 포함했다.
October 6, 2026 · 13 분 · 서소영
치비 서소영이 발판에 올라서서 칸마다 서랍이 달린 키 큰 목제 색인함에 새 모양으로 접은 쪽지를 차분히 넣고 있다. 서랍 앞면은 히트맵 칸처럼 저마다 다른 농도의 하늘색이고, 발치에서는 동그란 털뭉치 도우미가 쪽지에 도장을 찍는다

트윗 아카이브 제작 기록: Jev로 분류하고 기억나는 말로 찾기

X 계정 하나의 트윗을 연도와 주제로 둘러보고 기억나는 말로 찾을 수 있는 아카이브를, 이틀 동안 PR 38개를 머지하며 만들었다. 트윗마다 주제 점수를 매기는 일과 검색은 Jev가 맡았고, 처음 적재한 트윗 15,112개를 채점하는 데 든 비용은 0.76달러였다.

September 30, 2026 · 17 분 · 서소영
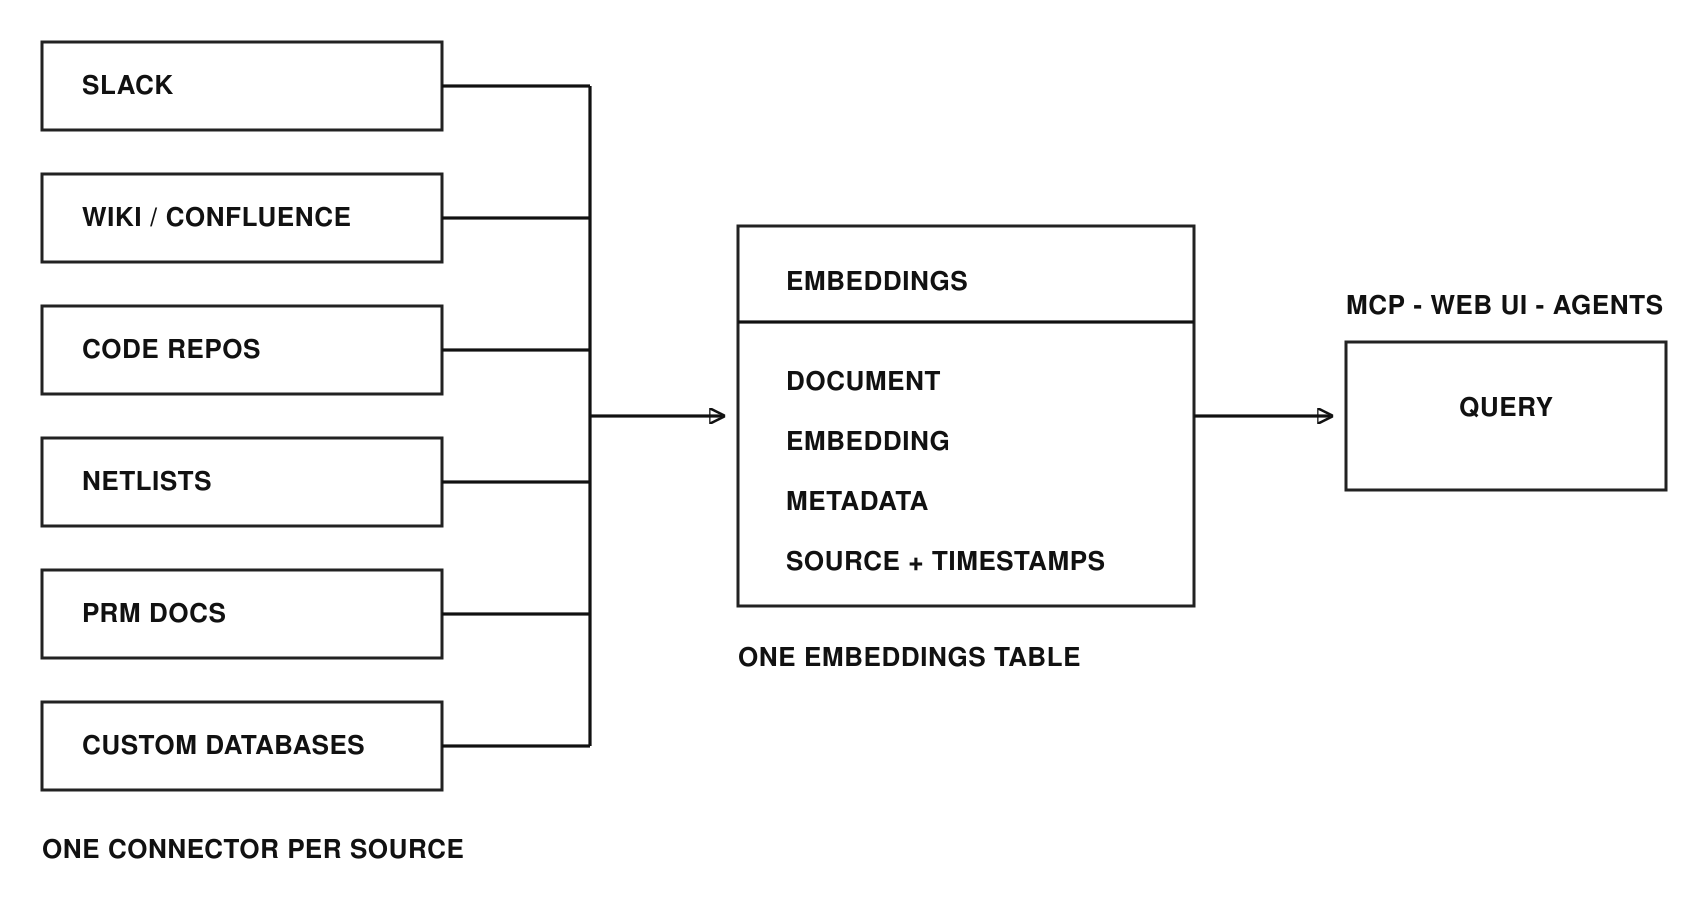
소스마다 커넥터 하나, 착지점은 임베딩 테이블 하나

How Cerebras Built Its Enterprise Knowledge Base

Cerebras가 하루 15,000건의 질문을 받는 사내 지식베이스를 만든 방법. 모든 것을 한 플랫폼에 모으는 단일 진실 공급원을 포기하고, 데이터가 이미 사는 곳에서 끌어와 단일 Postgres 임베딩 테이블에 착지시켰다.

July 17, 2026 · 9 분 · 서소영

포털 검색 늘었네…제로클릭, 허상이었나

AI가 검색을 죽인다는 통념이 데이터에서 정반대로 나왔다. ChatGPT 이용자 95%가 포털 검색을 병행하고 네이버 점유율은 오히려 상승했다. 포털이 ‘최종 검증지’로 격상되며 SEO·GEO를 함께 가져가는 VEO가 새 화두로 떠올랐다.

May 14, 2026 · 4 분 · 서소영

PageIndex: Vectorless, Reasoning-based RAG

벡터 DB도 청킹도 없이, LLM이 문서의 계층적 트리 인덱스를 추론하며 탐색하는 Vectorless RAG 프레임워크. FinanceBench 98.7% 정확도를 달성했다.

May 5, 2026 · 3 분 · 서소영

From Skill Text to Skill Structure: The SSL Representation for Agent Skills

에이전트 스킬 문서를 3계층 JSON 그래프(스케줄링·구조·논리)로 정규화하는 SSL 표현을 제안하고, 스킬 디스커버리와 리스크 평가에서 텍스트 기반 베이스라인을 유의미하게 이긴 논문.

April 29, 2026 · 4 분 · 서소영