Training a 4B model to produce 81% faster query plans than Postgres
4B 오픈웨이트 모델을 오프폴리시 증류와 에이전틱 RL로 후학습시켜 Postgres의 기본 쿼리 플랜보다 빠른 플랜을 만들게 한 개인 실험 기록이다. 조인 순서 벤치마크 113개 질의에서 기하평균 1.81배 speedup을 얻었고, 들어간 돈은 모두 1,200달러였다.
4B 오픈웨이트 모델을 오프폴리시 증류와 에이전틱 RL로 후학습시켜 Postgres의 기본 쿼리 플랜보다 빠른 플랜을 만들게 한 개인 실험 기록이다. 조인 순서 벤치마크 113개 질의에서 기하평균 1.81배 speedup을 얻었고, 들어간 돈은 모두 1,200달러였다.
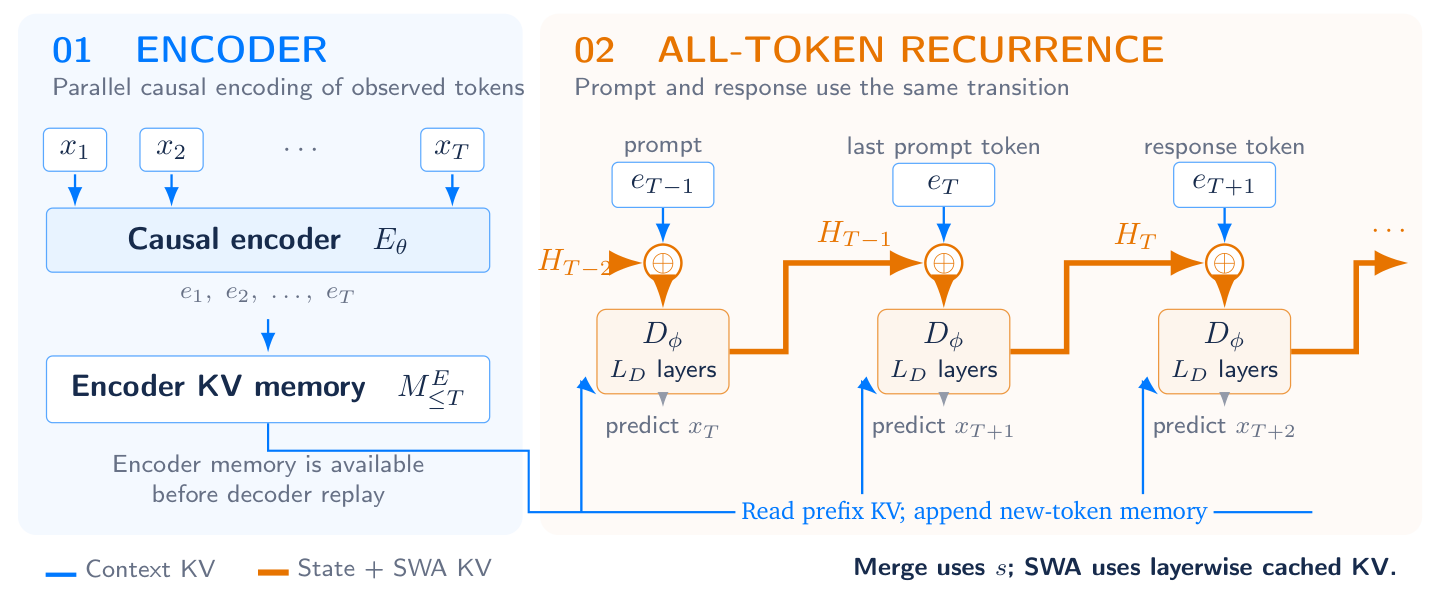
인과적 인코더가 전역 메모리를 만들고, 재귀 디코더가 프롬프트와 응답의 모든 토큰을 지나며 하나의 상태를 이어간다. 학습과 샘플링과 강화학습 리플레이가 같은 전이를 쓰도록 설계했고, 측정된 성능 수치는 아직 한 줄도 없다.
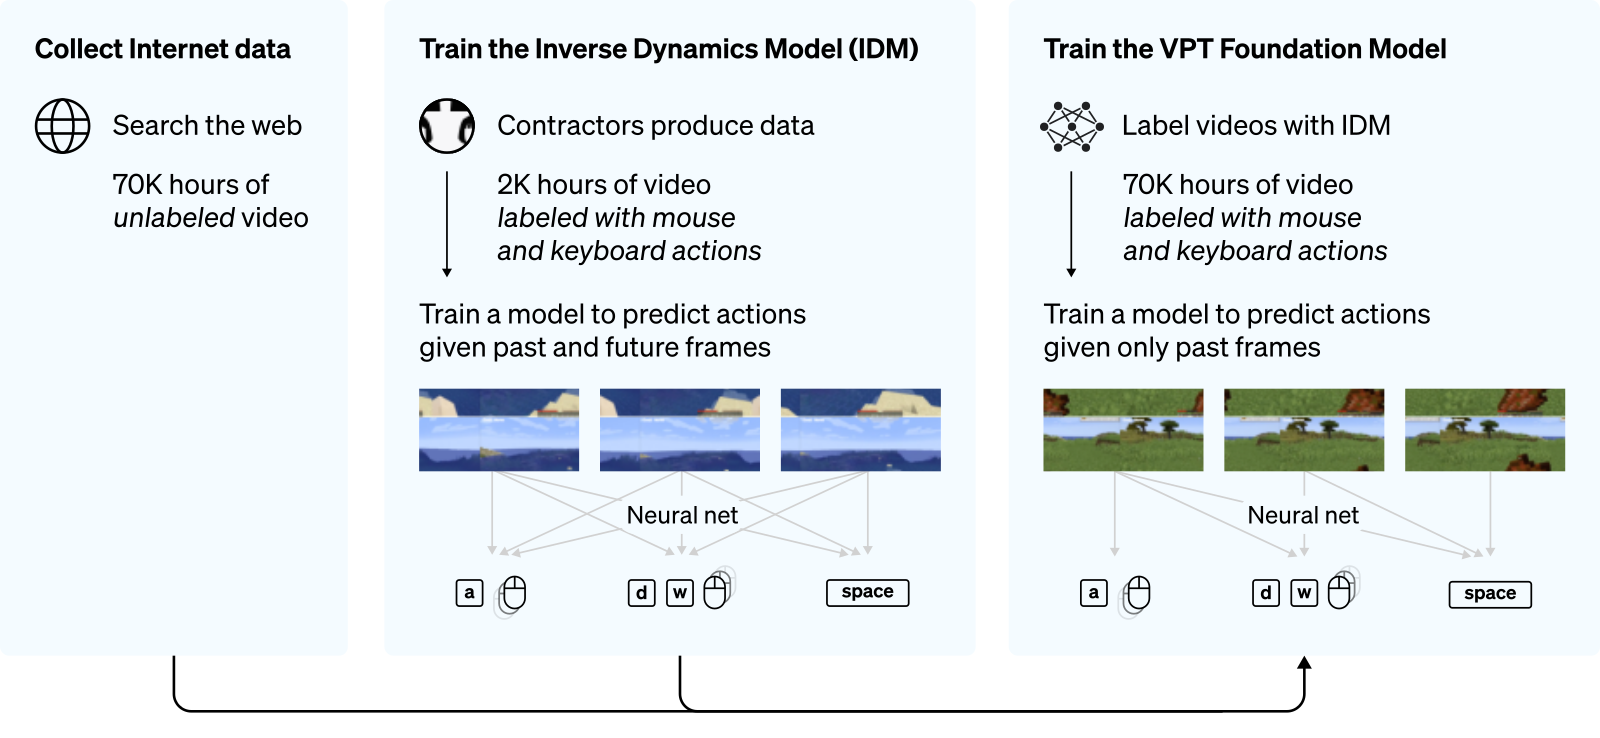
OpenAI 연구진은 행동 라벨이 없는 마인크래프트 플레이 영상 7만 시간에 역동역학 모델로 의사 라벨을 달았다. 이어 이 데이터로 행동을 사전학습하고 강화학습으로 미세조정해, 다이아몬드 곡괭이를 만드는 에이전트를 처음 보고했다.
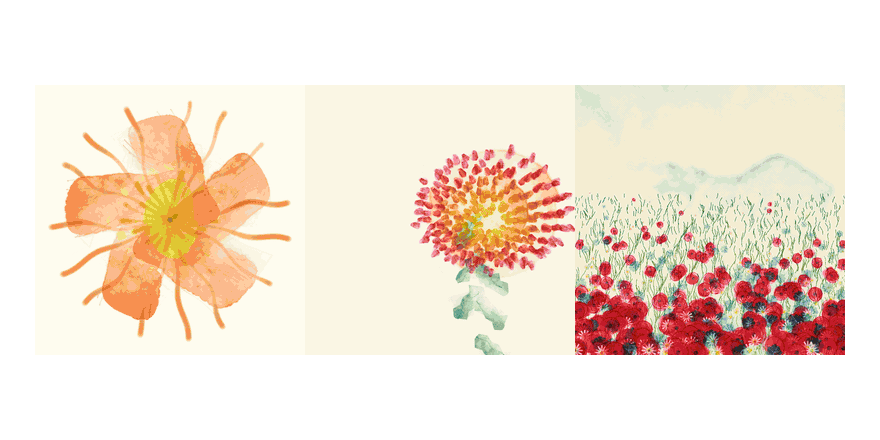
이 수채화들은 이미지 생성 모델이 만든 것이 아니다. 언어 모델이 그림을 그려 내는 자바스크립트를 작성했고, 그 코드를 쓰는 방법은 강화학습으로 익혔다.
HumanLayer 창업자 Dex Horthy의 에세이. 사람이 코드를 아예 읽지 않는 ‘불 끄고 돌아가는 소프트웨어 공장’은 작동하지 않는다. 하네스를 아무리 쌓아도 소용없는 이유는, 코딩 모델을 훈련시키는 검증기에 나쁜 설계를 벌하는 항목이 없기 때문이다.