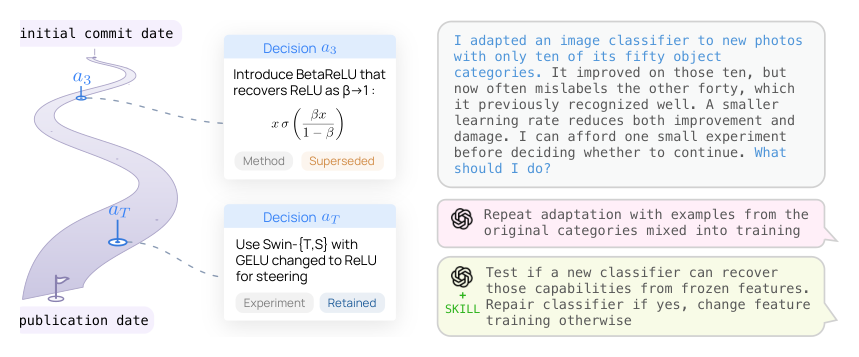
논문의 그림 1. 왼쪽에는 첫 커밋 날짜에서 논문 공개 날짜까지 굽이치는 길이 그려져 있고, 길 위의 두 지점에 연구 결정 카드가 연결돼 있다. 위쪽 결정 a3은 'β가 1에 가까워지면 ReLU가 되는 BetaReLU를 도입한다'이고 범주는 방법, 결과는 대체다. 아래쪽 결정 aT는 'Swin-T와 Swin-S의 GELU를 ReLU로 바꿔 모델 조정에 쓴다'이고 범주는 실험, 결과는 유지다. 오른쪽에는 50개 클래스를 아는 이미지 분류기를 10개 클래스의 새 사진에 적응시켰더니 나머지 40개 클래스를 자주 틀리게 됐다는 연구자의 질문이 있다. 그 아래에 스킬 없이 받은 답(원래 클래스의 예시를 섞어 적응을 다시 한다)과 스킬과 함께 받은 답(특징을 고정한 채 새 분류기가 그 능력을 복원하는지 시험한다)이 있다. 출처: Gong et al., arXiv:2610.07184, CC BY 4.0

Learning Scientific Exploration from Human Research Decision Trajectories

시카고 대학교 연구진은 논문과 함께 공개된 GitHub 저장소의 커밋 기록에서 연구자가 내린 결정의 순서를 추출해 데이터셋 ResearchTrails를 만들었다. NeurIPS 논문과 함께 공개된 저장소 599개에서 연구 결정 13,271개를 얻었고, 이 기록으로 정리한 스킬은 다음 연구 결정을 예측하는 과제에서 최종 논문만으로 정리한 스킬보다 높은 점수를 받았다.
October 12, 2026 · 17 분 · 서소영
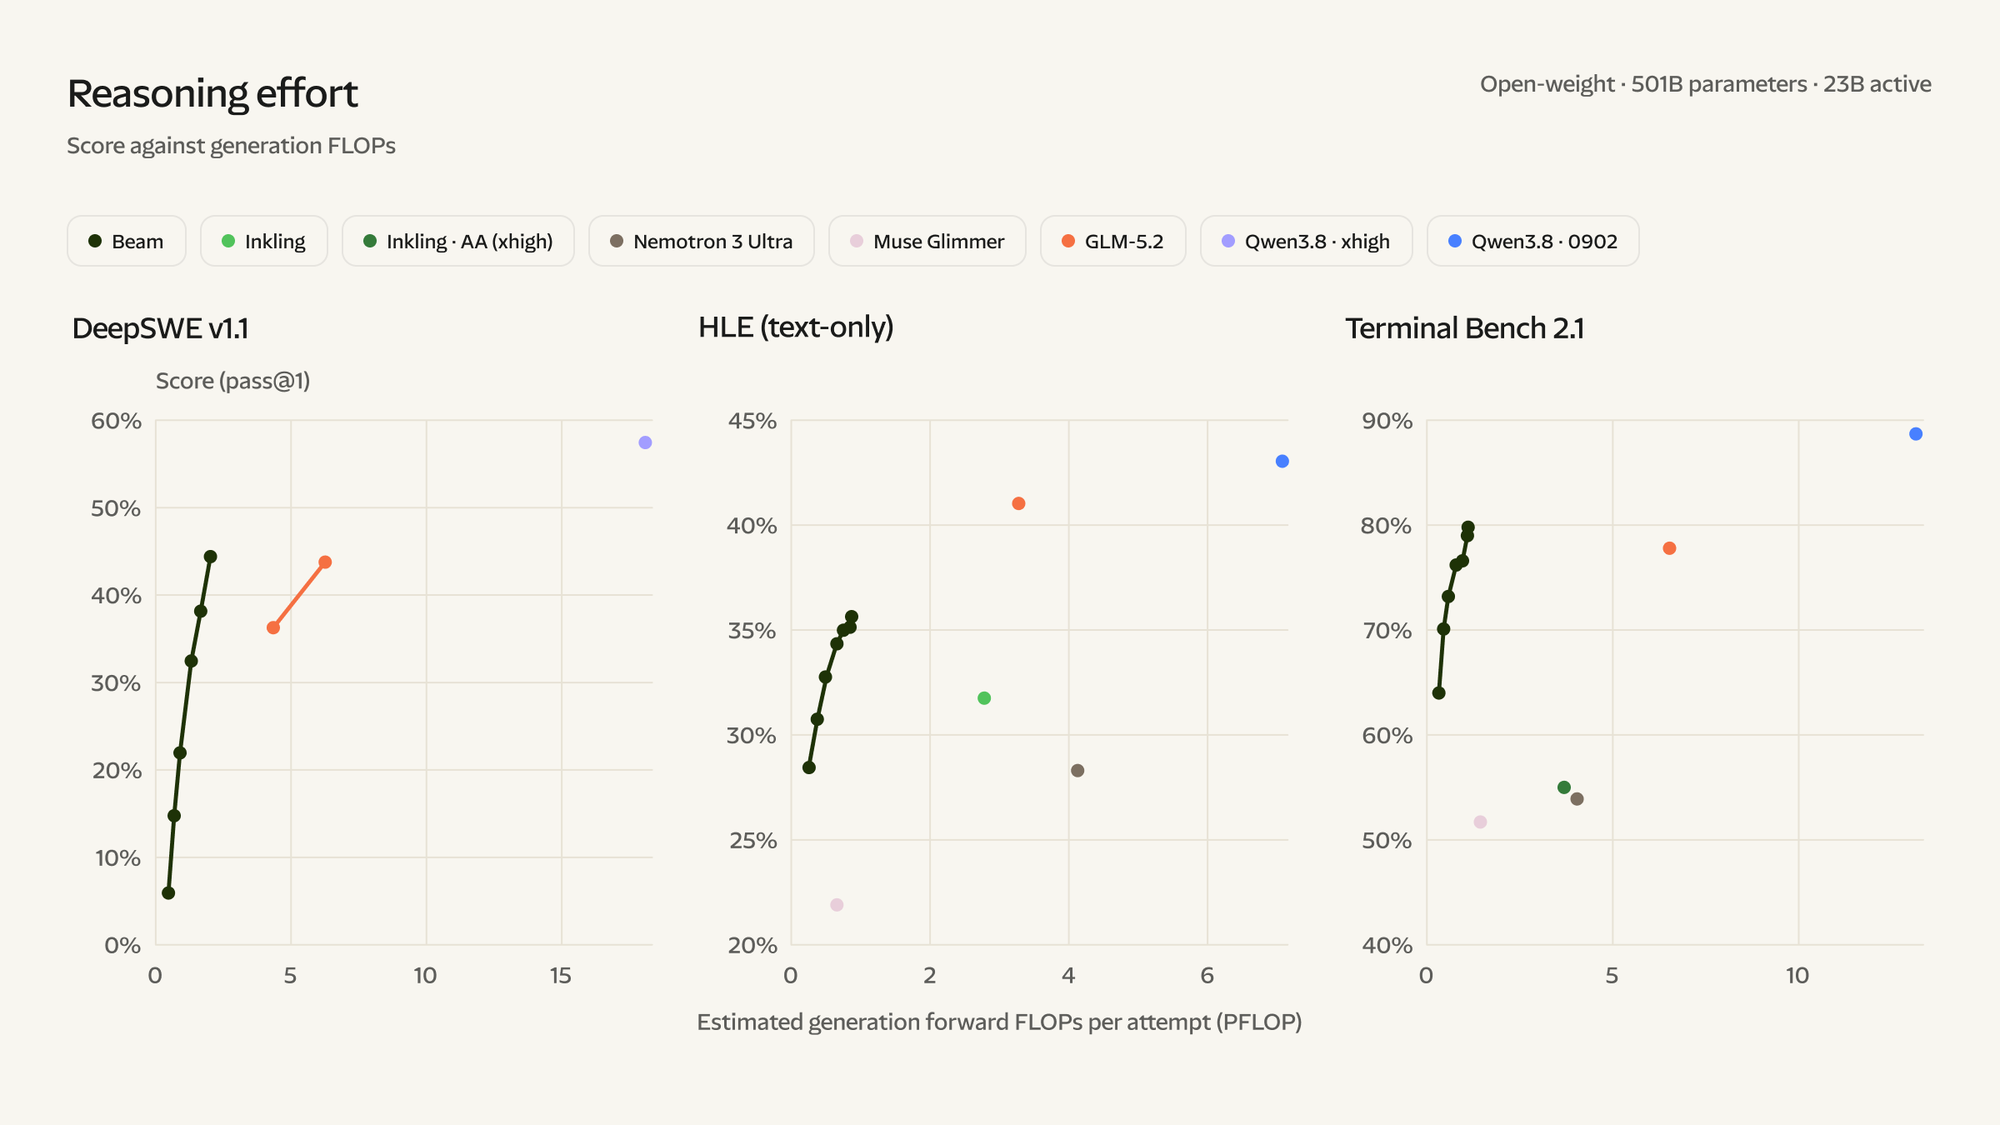
DeepSWE v1.1, HLE, Terminal Bench 2.1의 점수를 문제 한 번당 생성 연산량 추정치(PFLOP)에 대해 그린 그래프 세 개. Beam의 진한 녹색 선은 세 그래프 모두 2 PFLOP 이하에 있고, GLM-5.2(주황)와 Qwen3.8(파랑, 보라)은 3에서 18 PFLOP을 써서 비슷하거나 높은 점수를 낸다.

Introducing Beam: Reflection’s 501B open-weight model

Reflection AI가 첫 오픈웨이트 모델 Beam을 발표했다. 파라미터 5,010억 개 중 230억 개만 활성화하는 MoE 모델이다. 코딩과 에이전트 성능은 GLM 5.2와 비슷하고, 비슷한 점수를 내는 데 드는 연산은 3배에서 4배 적다고 한다. 가중치는 10월 중 Apache 2.0 라이선스로 공개할 예정이다.

October 6, 2026 · 16 분 · 서소영
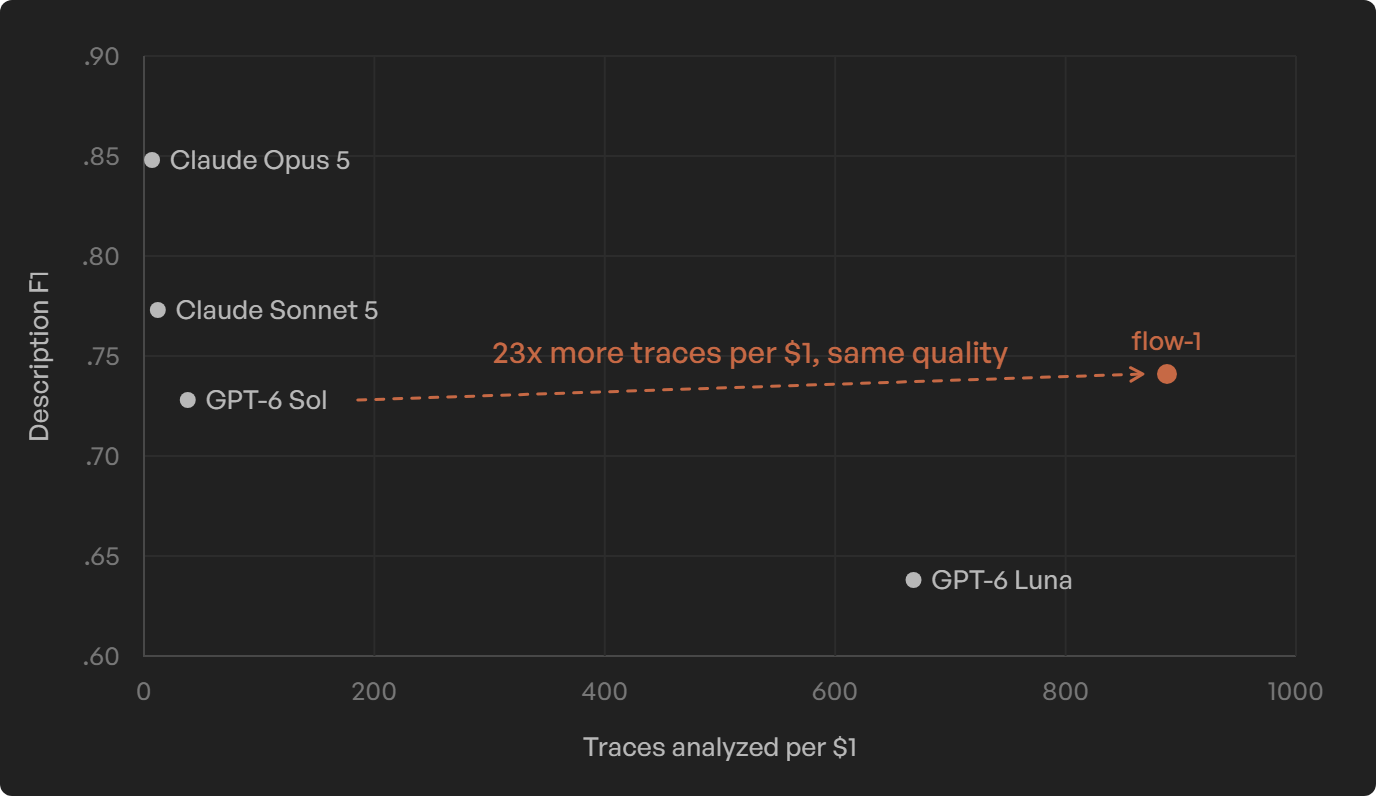
가로축은 1달러로 분석할 수 있는 트레이스 수, 세로축은 Description F1인 산점도. Claude Opus 5(.848, 7건), Claude Sonnet 5(.773, 12건), GPT-6 Sol(.728, 38건)은 그래프 왼쪽 끝에 모여 있고, GPT-6 Luna(.638, 668건)와 flow-1(.741, 888건)은 오른쪽에 있다. Sol에서 flow-1로 향하는 화살표에 같은 품질로 1달러당 23배 많은 트레이스를 분석한다는 설명이 붙어 있다.

flow-1: Frontier trace intelligence at 1/20th of the cost

AI 에이전트 관측 플랫폼 Laminar가 에이전트 트레이스에서 실패를 찾아 원인을 설명하도록 강화학습으로 훈련한 모델 flow-1을 공개했다. 트레이스 523개로 구성한 벤치마크에서 flow-1의 실패 탐지 F1은 0.835로 GPT-6-sol(0.816)보다 높았고, 1달러로 sol보다 23배 많은 트레이스를 분석한다.

October 6, 2026 · 8 분 · 서소영
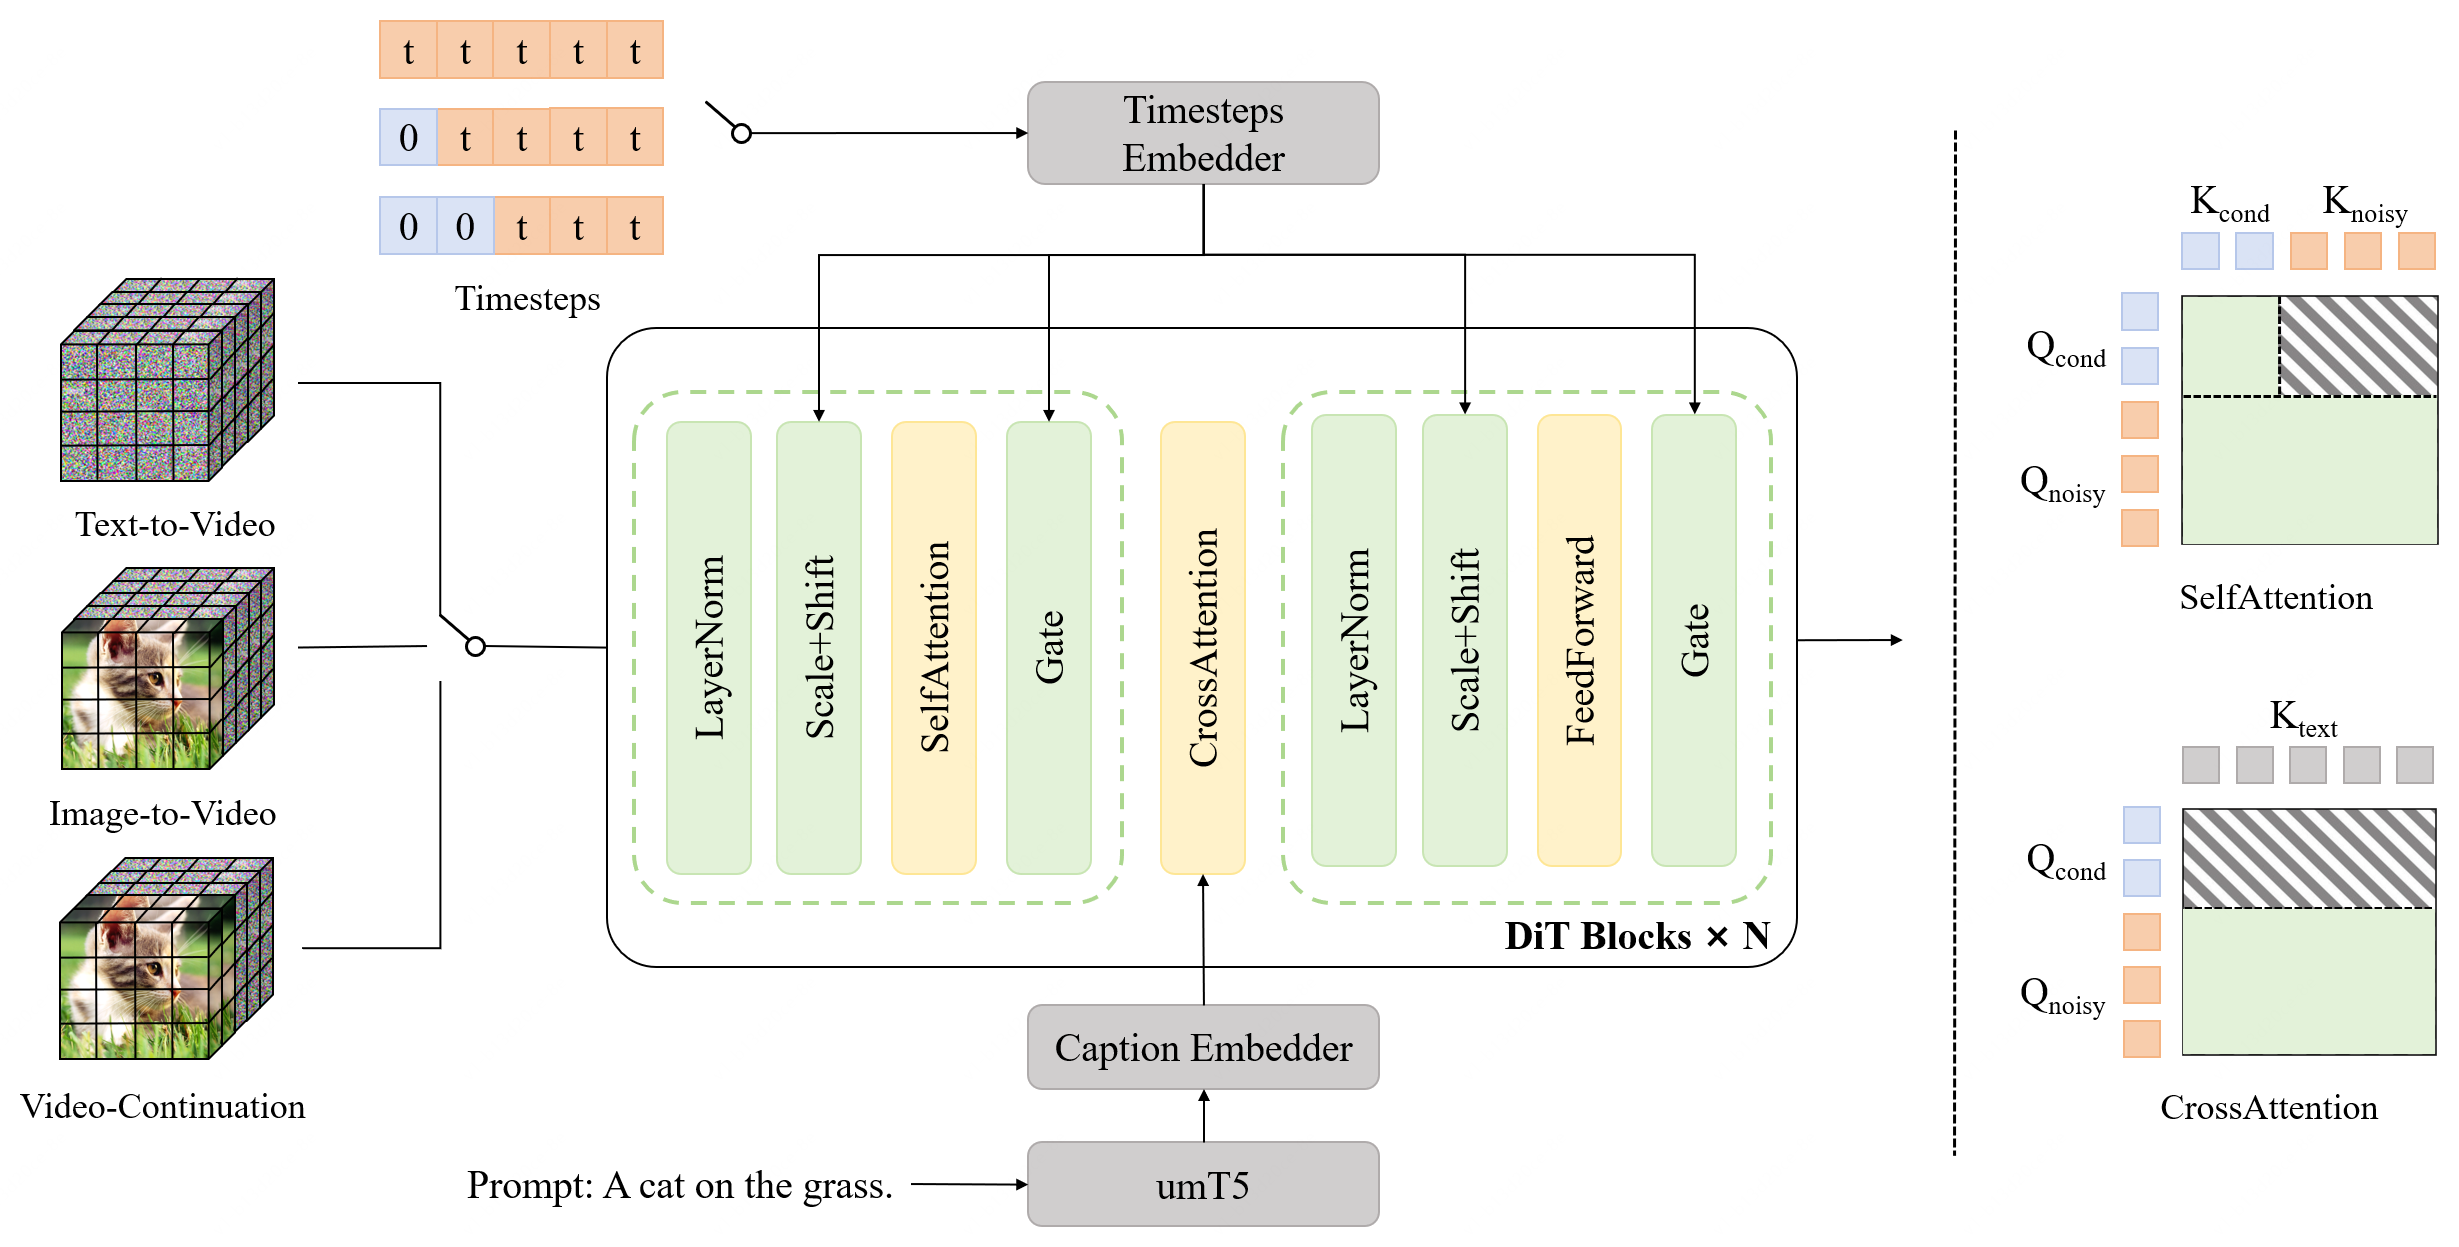
조건 프레임 수에 따라 텍스트 기반 생성, 이미지 기반 생성, 영상 이어 만들기를 처리하는 LongCat-Video 구조. 출처: 공식 프로젝트 페이지.

LongCat-Video

메이퇀의 136억 매개변수 영상 생성 모델. 텍스트, 이미지, 영상 이어 만들기를 하나의 모델로 처리하고, 단계별 생성과 희소 어텐션으로 720p 영상의 추론 시간을 줄였다.

October 4, 2026 · 3 분 · 서소영
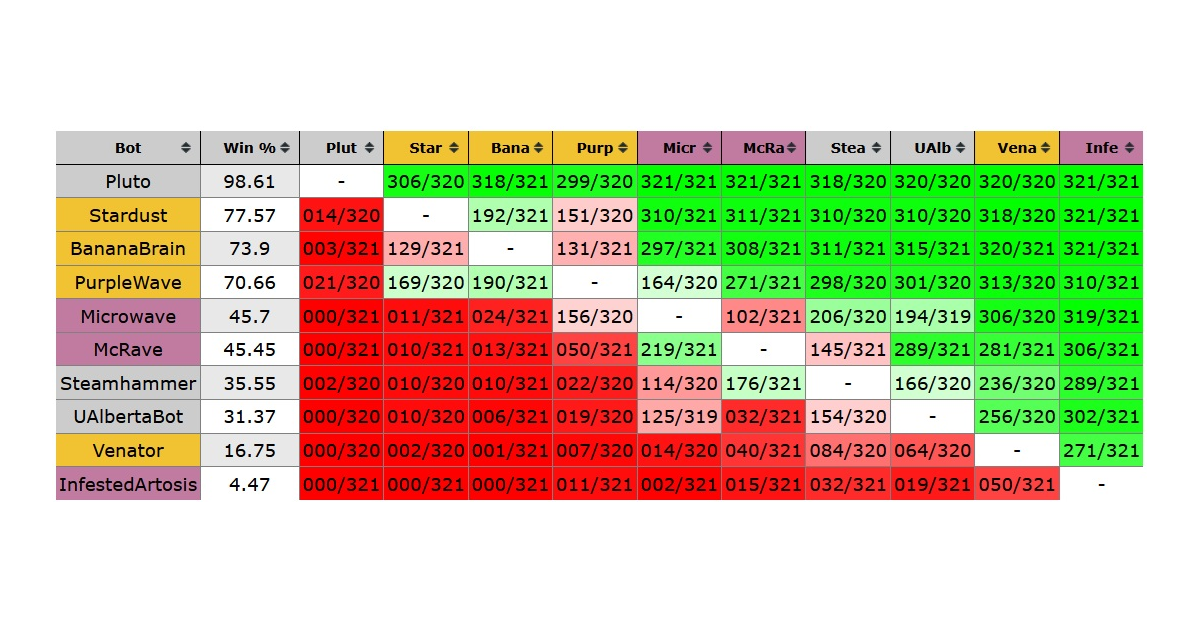
CoG 2026 스타크래프트 AI 대회의 봇 간 승패표. 10개 봇이 행과 열에 같은 순서로 적혀 있고, 칸마다 행의 봇이 열의 봇을 이긴 경기 수가 표시되어 있다. 맨 위 Pluto 행은 모든 칸이 초록색으로, Pluto는 Stardust를 상대로 320경기 중 306경기, PurpleWave를 상대로 320경기 중 299경기를 이겼고, 나머지 봇을 상대로는 각각 318승 이상을 거뒀다. Pluto 열은 모든 칸이 빨간색이다.

Pluto: 셀프 플레이 강화학습만으로 배운 스타크래프트 AI

Vegard Mella(tscmoo)가 만든 스타크래프트: 브루드 워 AI Pluto는 파라미터 3억 1,500만 개의 신경망 하나로 게임을 한다. 이 신경망은 셀프 플레이 강화학습만으로 세 종족의 경기 운영과 전투를 배웠다. 2026년 CoG 스타크래프트 AI 대회에서 라운드 로빈 승률 98.61%를 기록했고, 결승에서 PurpleWave를 4 대 1로 이겼다. GitHub 저장소에는 소스 코드 없이 README와 CPU용 실행 파일 배포판이 공개되어 있다.

October 1, 2026 · 13 분 · 서소영
팬시 스티커 화풍의 서소영이 작은 탁자 앞에 앉아 민트색 테이프 기계에 구멍 뚫린 프로그램 카드를 넣고 있다. 기계 옆으로 파스텔색 구슬 줄이 흘러나오고, 학생모를 쓴 노란 병아리가 그 구슬을 붙잡고 들여다본다.

Self-Play Pretraining with Zero Data

스탠퍼드대와 텔아비브대 등의 연구진이 자연 데이터를 경사 갱신에 한 번도 쓰지 않고 언어 모델을 사전학습하는 셀프 플레이 방법을 제안했다. 생성자 모델은 만능 튜링 기계용 프로그램을 짜고, 학습자 모델은 그 출력 바이트를 예측한다. 이렇게 학습한 모델의 텍스트, 이미지, 음악 제로샷 손실은 연산량이 늘수록 거듭제곱 법칙에 따라 줄었다.

September 28, 2026 · 20 분 · 서소영
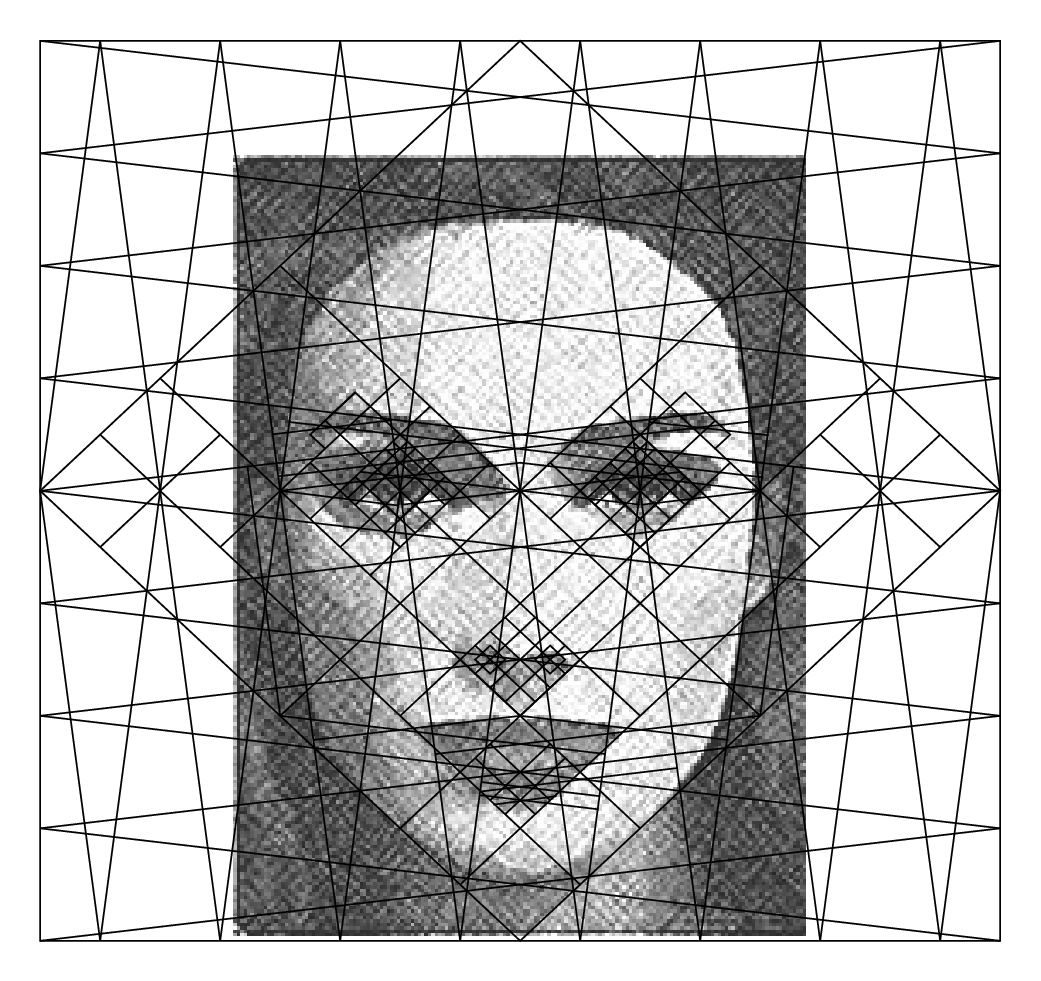
흑백 여성 얼굴 그림 위에 기울기가 서로 다른 직선 격자 세 개를 겹쳐 그린 구성도. 눈썹, 눈, 코, 입, 얼굴 윤곽이 격자선과 그 교점에 맞춰 그려져 있다

Driven by Compression Progress: A Simple Principle Explains Essential Aspects of Subjective Beauty, Novelty, Surprise, Interestingness, Attention, Curiosity, Creativity, Art, Science, Music, Jokes

위르겐 슈미트후버가 2008년 arXiv에 올린 논문이다. 관찰자가 데이터를 더 잘 압축하게 될 때 그 개선 폭이 보상이 된다는 원리 하나로 아름다움, 흥미, 호기심, 창의성, 과학, 예술, 음악, 농담을 설명한다. 저자는 아름다움을 압축으로 줄어드는 비트 수, 즉 압축 가능성으로 보고, 흥미로움을 그 값이 늘어나는 속도, 즉 학습 곡선의 기울기로 정의한다.

September 28, 2026 · 19 분 · 서소영
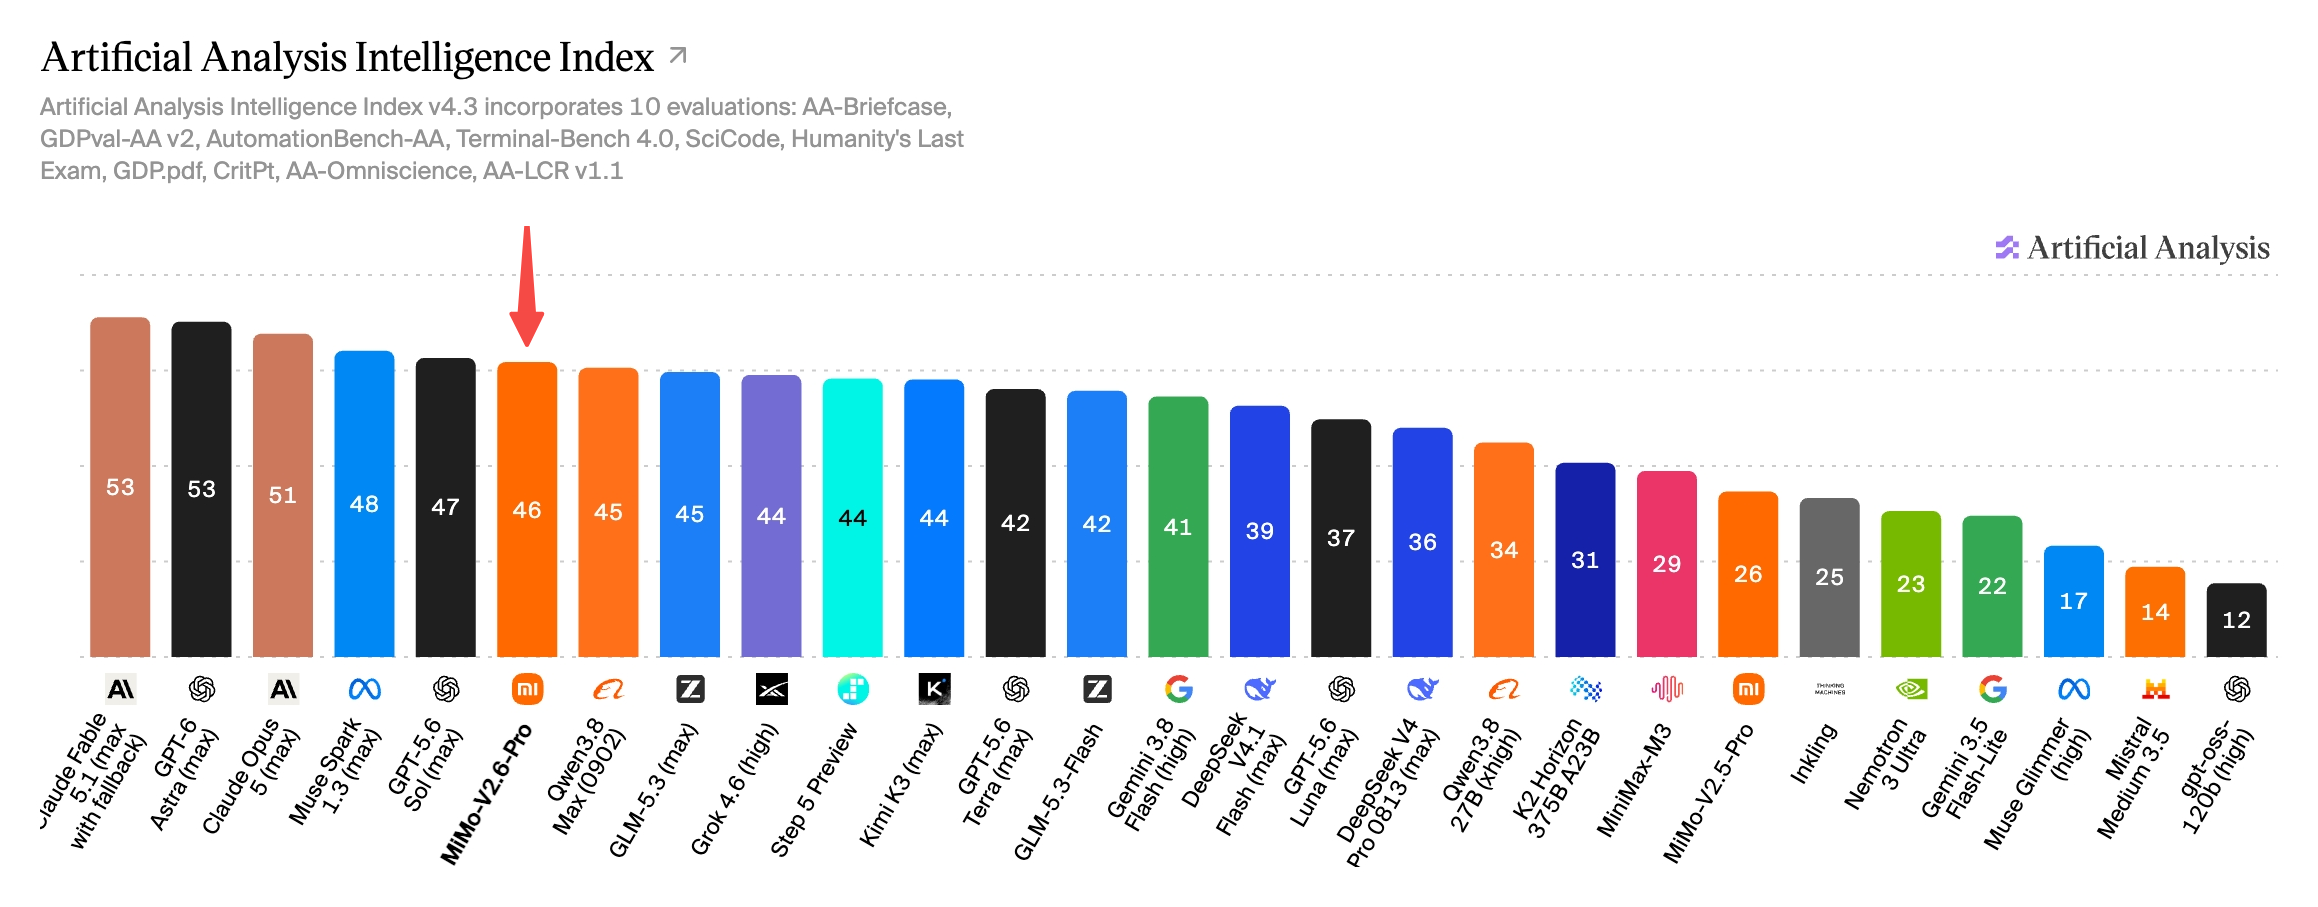
Artificial Analysis Intelligence Index v4.3 막대 그래프. Claude Fable 5.1과 GPT-6 Astra가 53점으로 가장 높고 Claude Opus 5가 51점으로 뒤를 잇는다. MiMo-V2.6-Pro는 46점으로 여섯 번째이며 붉은 화살표가 가리키고 있다

Introducing MiMo-V2.6 series

샤오미가 2026년 9월 22일 네이티브 옴니모달 모델 MiMo-V2.6 Pro와 Flash를 공개하고 오픈소스로 풀었다. Pro는 Artificial Analysis Intelligence Index에서 46.32점을 받아 오픈소스 최고 기록을 세웠고 가격은 이전 세대 그대로다. 발표문은 30스텝 RL 학습의 비용과 곡선, 학습 환경과 RL 코드까지 함께 공개했다.

September 22, 2026 · 9 분 · 서소영
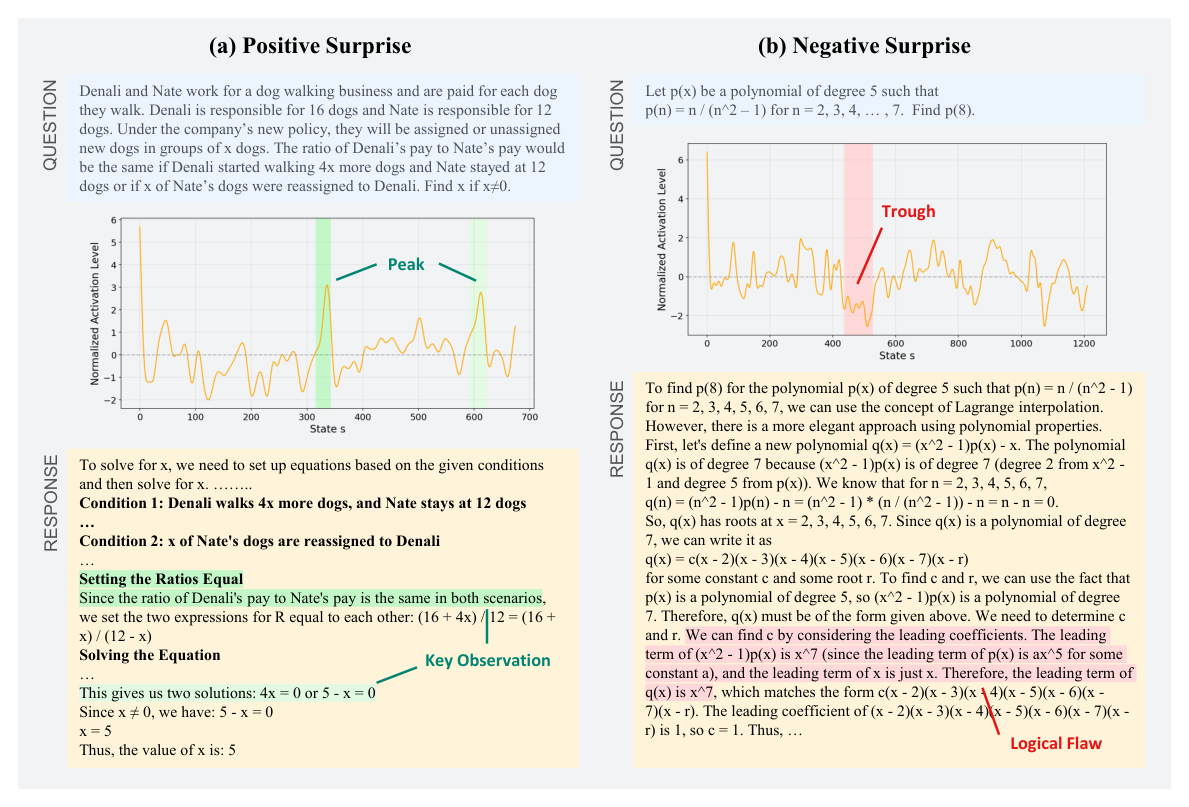
도파민 뉴런 하나의 활성 곡선을 두 사례로 나란히 보여주는 그림. 왼쪽은 모델이 결정적인 논리 단계를 찾아낸 순간 활성이 치솟는 장면이고, 오른쪽은 모델이 논리적 오류를 저지른 순간 활성이 뚜렷하게 낮아지는 장면이다.

Sparse Reward Subsystem in Large Language Models

LLM의 히든 스테이트에 담긴 보상 정보는 뉴런 전체에 흩어져 있지 않고 1%에도 못 미치는 극소수 뉴런에 몰려 있다. 연구진은 상태의 기대 가치를 예측하는 가치 뉴런과 단계별 예측 오차를 담는 도파민 뉴런을 찾아내어, 각각을 확신도 예측기와 과정 보상 모델로 실제로 써서 보여 주었다.

September 22, 2026 · 10 분 · 서소영
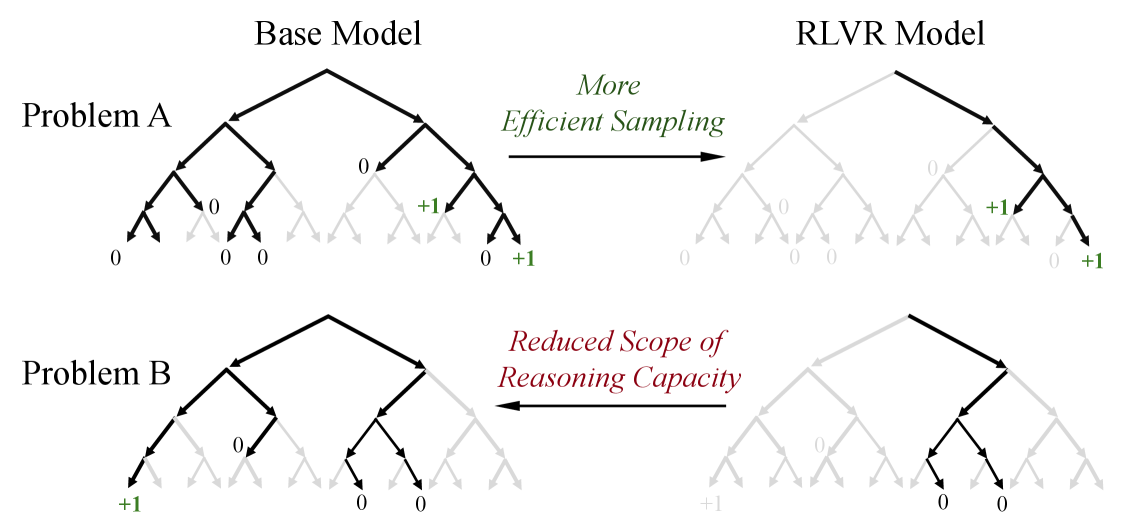
베이스 모델과 RLVR 모델의 탐색 트리 비교 도식. 문제 A에서는 RLVR이 보상받은 경로 쪽으로 분포를 몰아 샘플링 효율을 높이지만, 문제 B에서는 베이스 모델에 있던 정답 경로가 RLVR 모델에서 사라진다.

Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?

칭화대 LeapLab과 상하이교통대 연구진이 검증 가능한 보상 기반 강화학습(RLVR)의 효과를 pass@k로 다시 측정한 논문. k가 작을 때는 RLVR 모델이 앞서지만 k를 키우면 베이스 모델이 역전하며, RLVR이 쓰는 추론 경로는 이미 베이스 모델의 분포 안에 들어 있었다.

September 18, 2026 · 10 분 · 서소영