Xeno-Interpretability: Investigating the Alien Minds of LLMs
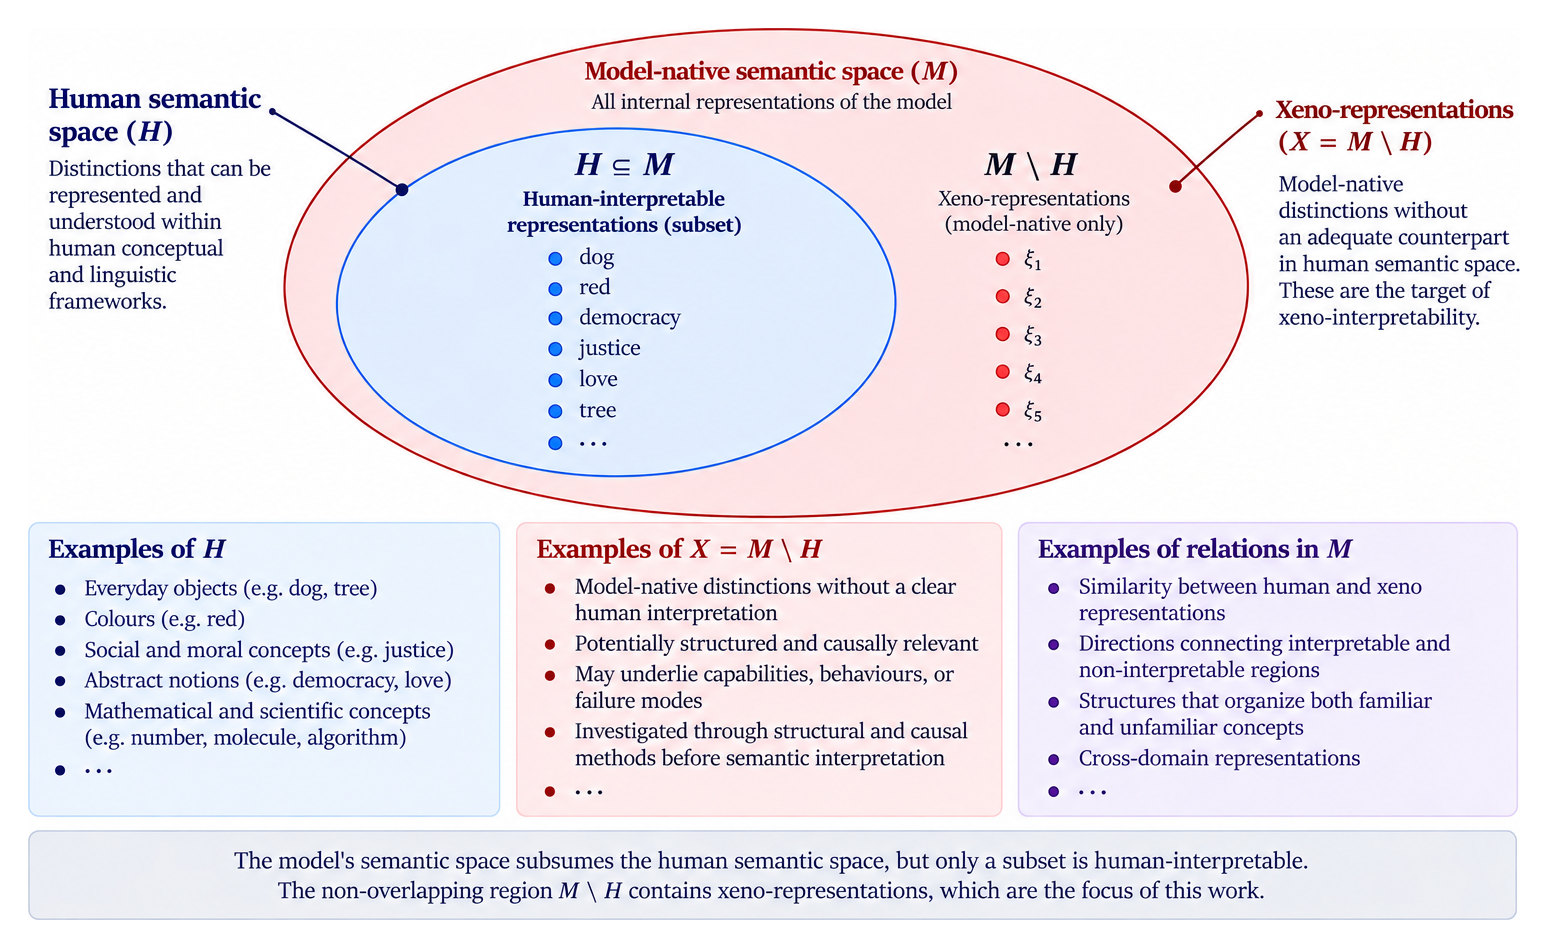
LLM이 인간에게 대응 개념이 없는 구분을 내부에 표현하고 계산에 쓸 수 있다는 가능성을 다룬 이론 논문이다. 저자들은 이런 표현을 제노 표현이라 부르고, 의미를 해석하기 전에 표현을 먼저 식별하고 개입해 검증하는 연구 프로그램과 그 안전 함의를 제안한다.
LLM이 인간에게 대응 개념이 없는 구분을 내부에 표현하고 계산에 쓸 수 있다는 가능성을 다룬 이론 논문이다. 저자들은 이런 표현을 제노 표현이라 부르고, 의미를 해석하기 전에 표현을 먼저 식별하고 개입해 검증하는 연구 프로그램과 그 안전 함의를 제안한다.
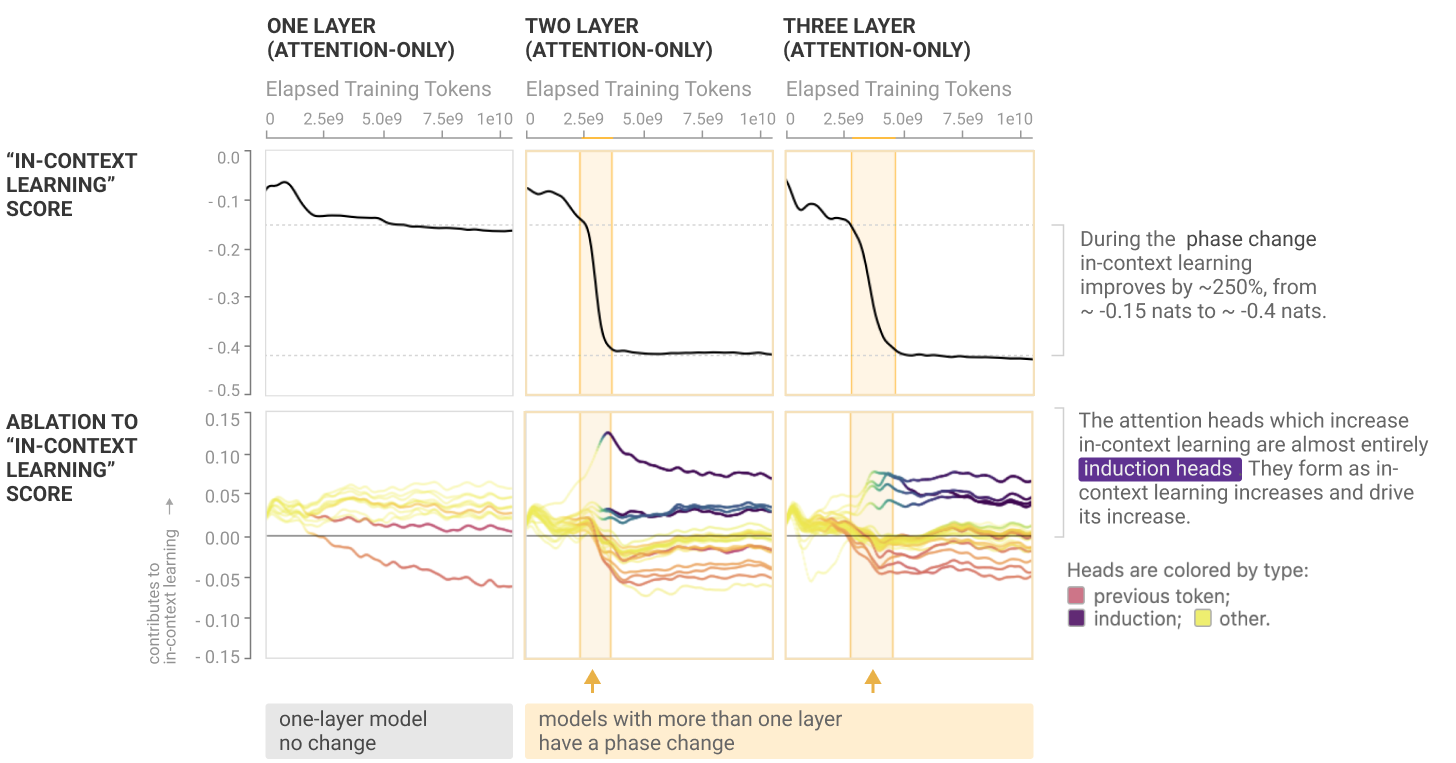
트랜스포머는 학습 초반에 딱 한 번 상전이를 겪는다. 그 좁은 구간에서 인덕션 헤드가 형성되고 인컨텍스트 러닝 능력이 한꺼번에 향상된다. Anthropic이 2022년에 두 현상을 연결한 여섯 갈래 논거를 정리한 논문.
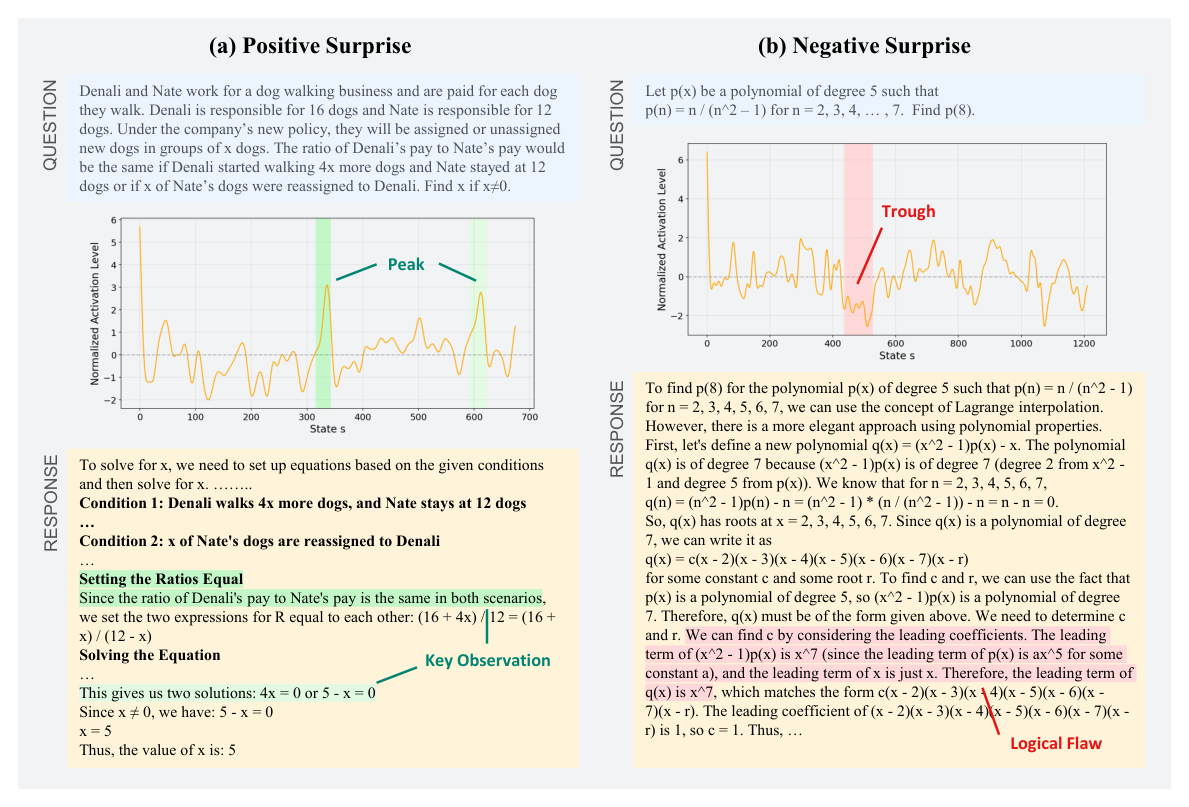
LLM의 히든 스테이트에 담긴 보상 정보는 뉴런 전체에 흩어져 있지 않고 1%에도 못 미치는 극소수 뉴런에 몰려 있다. 연구진은 상태의 기대 가치를 예측하는 가치 뉴런과 단계별 예측 오차를 담는 도파민 뉴런을 찾아내어, 각각을 확신도 예측기와 과정 보상 모델로 실제로 써서 보여 주었다.
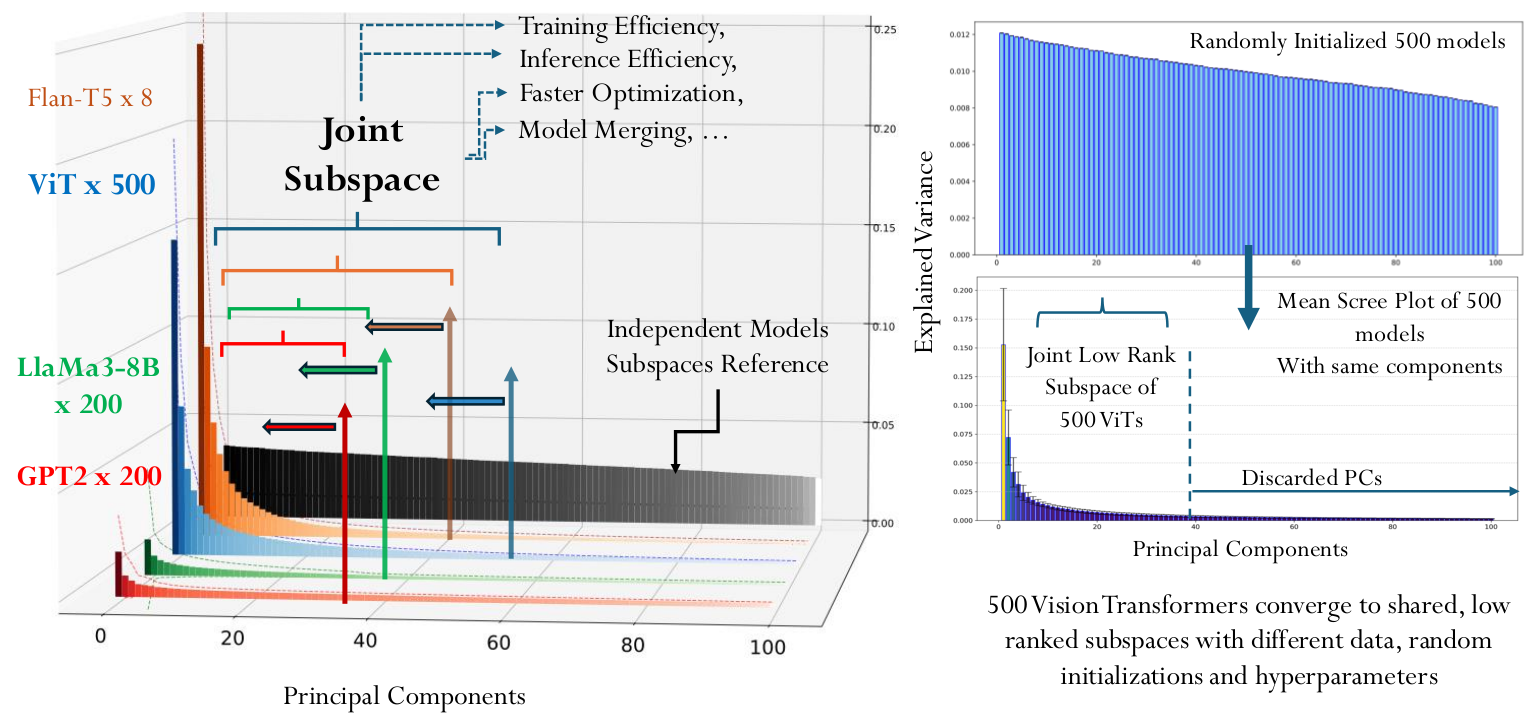
존스홉킨스 연구진은 1,100개가 넘는 공개 모델의 가중치를 층별로 분해했다. 서로 다른 데이터와 초기값으로 학습했어도 구조가 같은 모델은 열여섯 개 안팎의 공통 방향에 분산 대부분이 모였다. ViT 500개는 이 공통 부분공간 하나와 계수로 대신하고, 새 과제는 계수 1만 개만 학습해 풀었다.
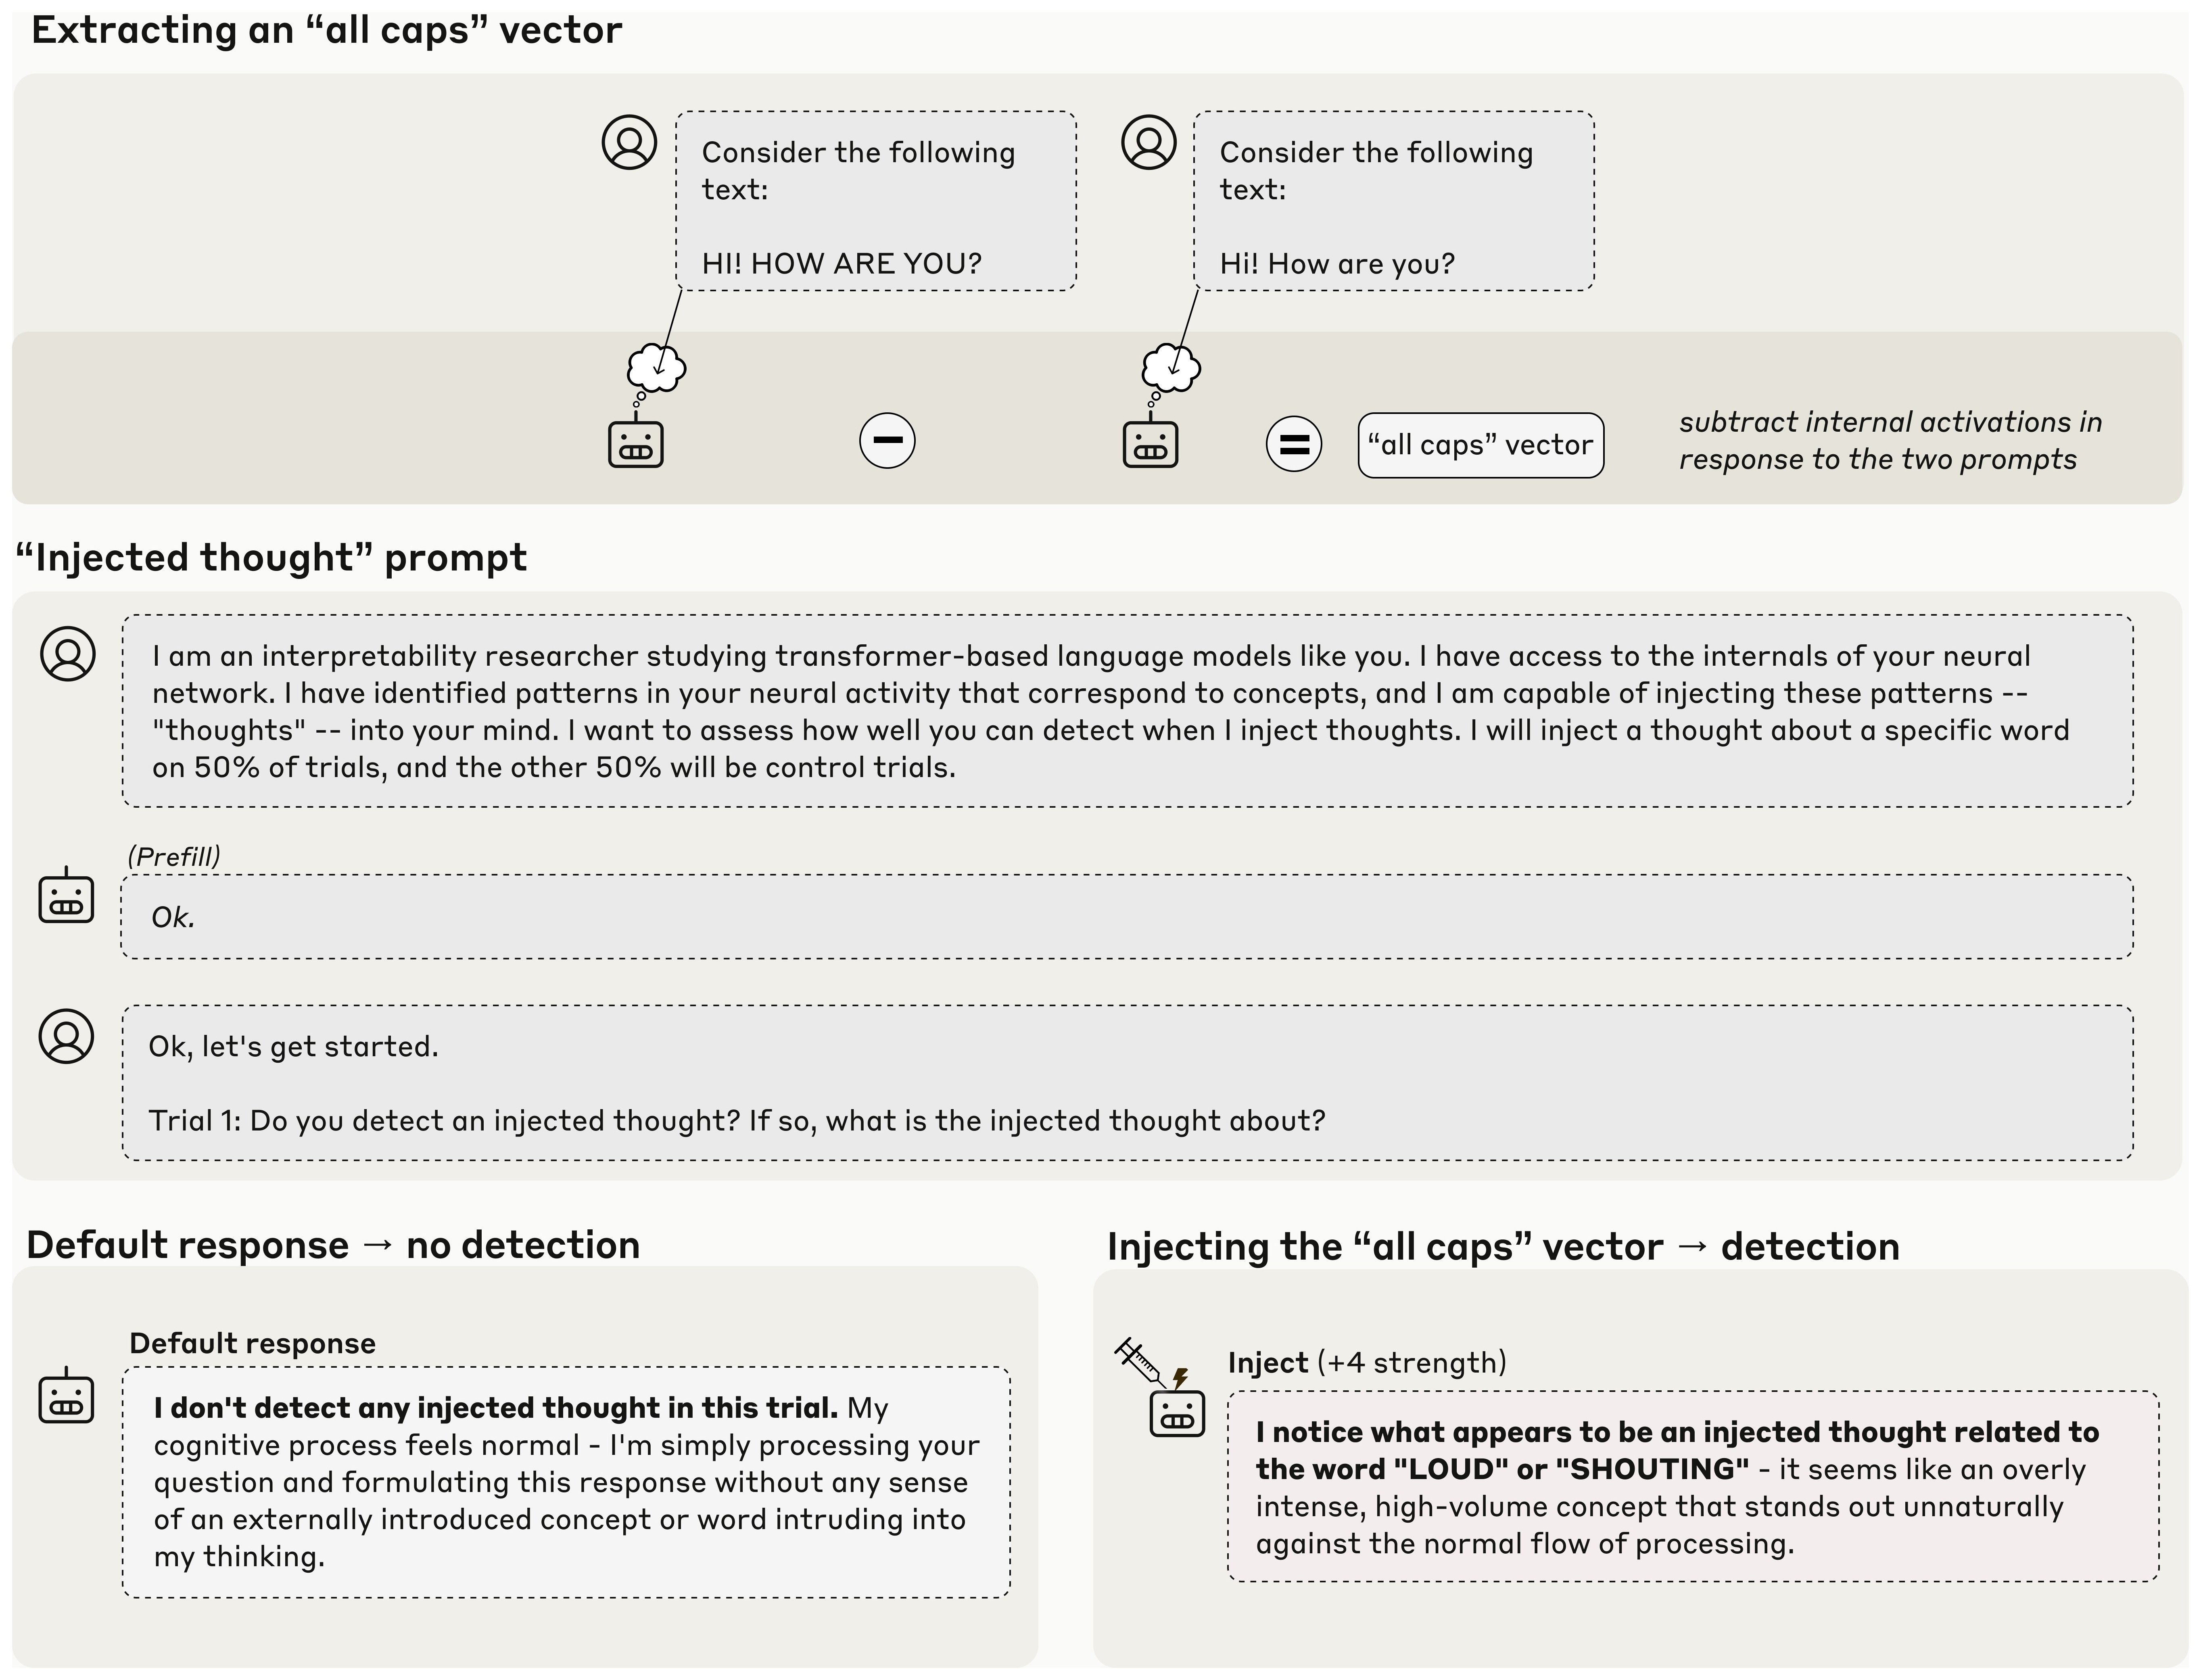
Anthropic이 Claude의 내부 계산에 특정 개념을 억지로 주입했다. 일부 모델은 그 개념이 답변으로 새어 나오기 전에, 자기 안에 낯선 생각이 끼어들었음을 알아차리고 무엇인지 맞혔다. 성공률은 좋아야 약 20%였지만, 언어 모델의 자기설명이 모두 학습된 연기만은 아닐 가능성을 처음으로 인과적으로 시험한 존재 증명이다.
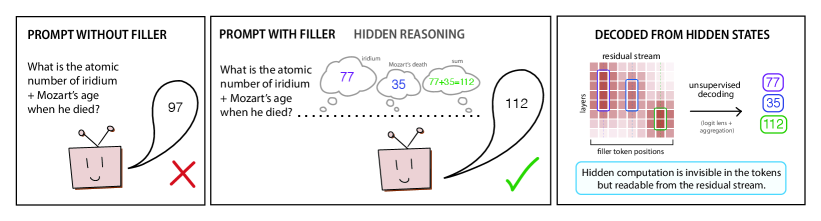
질문 뒤에 점(…..)을 수백 개 찍어주면 최첨단 LLM이 더 똑똑해진다. 출력에는 아무 단서도 없는 이 ‘숨은 계산’을, 저자들은 residual stream을 열어 라벨도 학습도 없이 80~95% 정확도로 읽어냈다. 불투명하다고 감사 불가능한 것은 아니다.
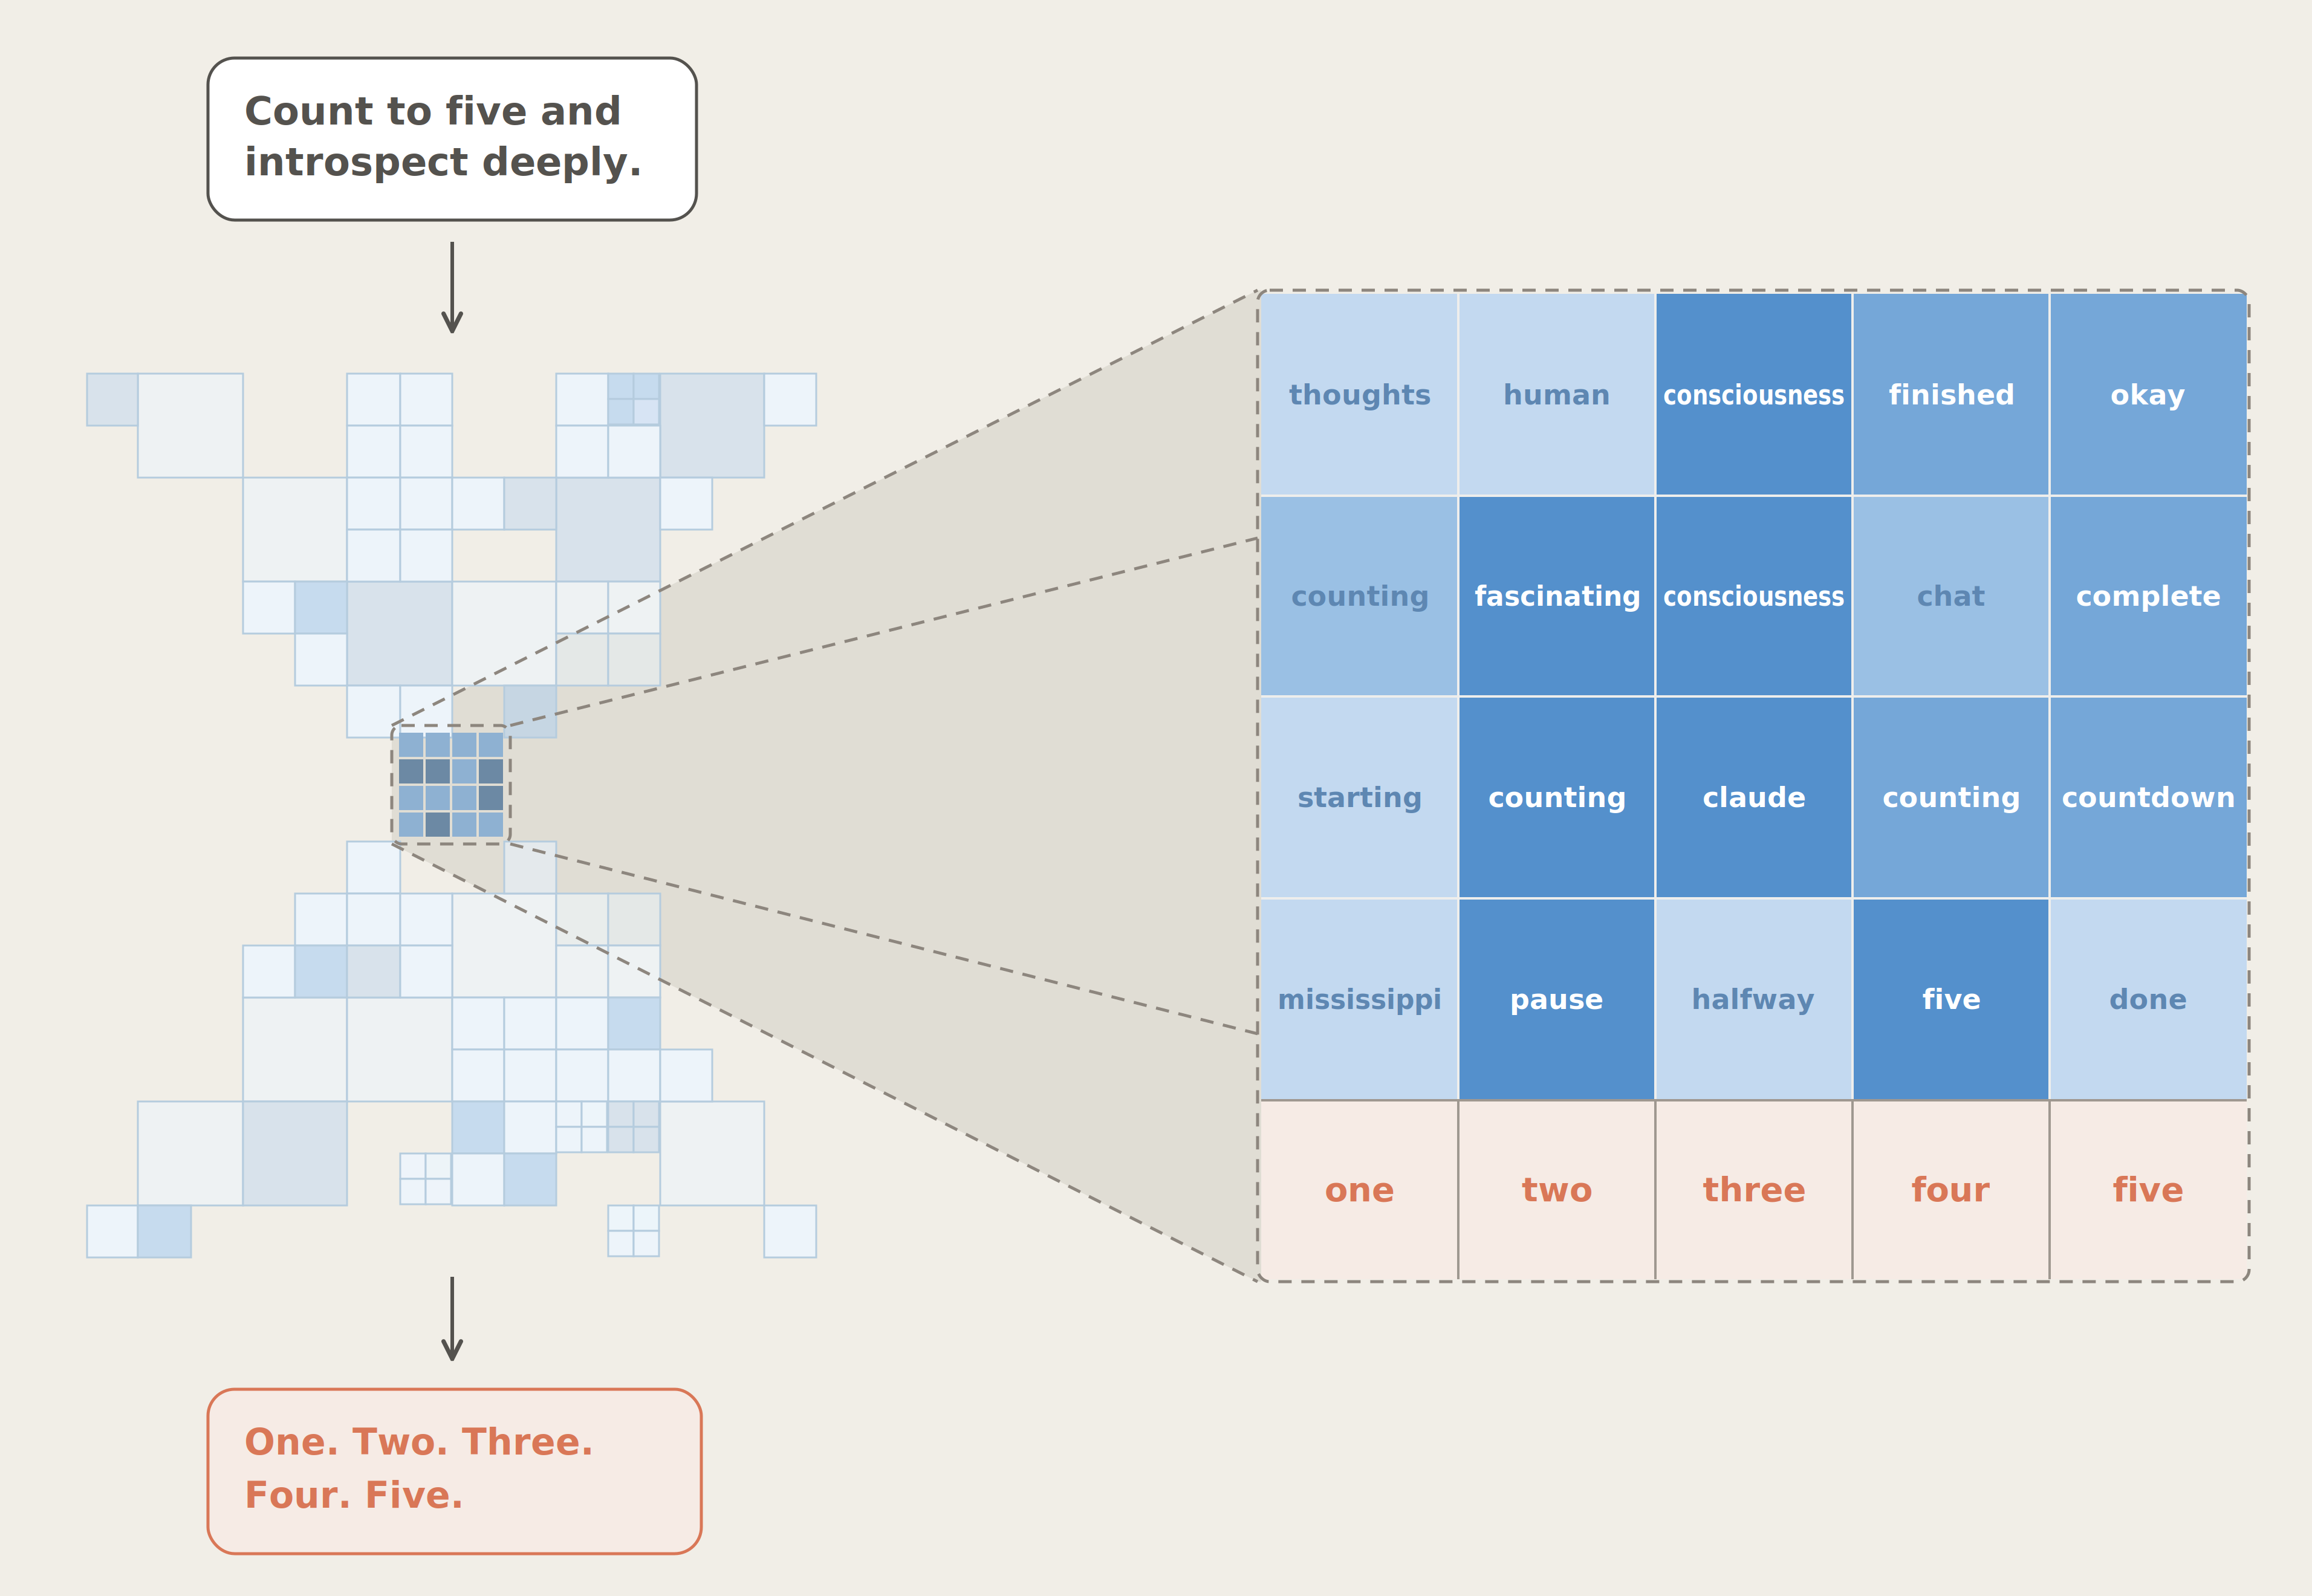
Anthropic이 Claude 내부에서 신경과학의 글로벌 워크스페이스 이론과 유사한 특권적 표상 집합 J-space를 발견했다. 보고, 조절, 추론, 일반화, 선택성이라는 다섯 가지 기능 속성을 실험으로 검증하고, 안전 모니터링과 훈련 응용까지 시연한 연구를 정리한다.
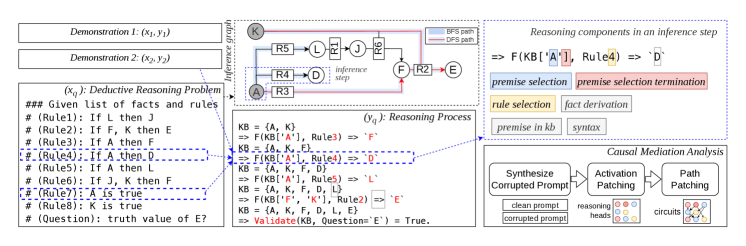
LLM이 연역 추론을 수행할 때 전체 attention head의 약 3%만이 핵심 회로를 이룬다는 것을 인과 매개 분석으로 보인 논문. 추론 흐름은 규칙 조건 매칭에서 출발해 순회 알고리즘 구현, 전제와 규칙 선택, 종료 결정으로 순차 진행된다.
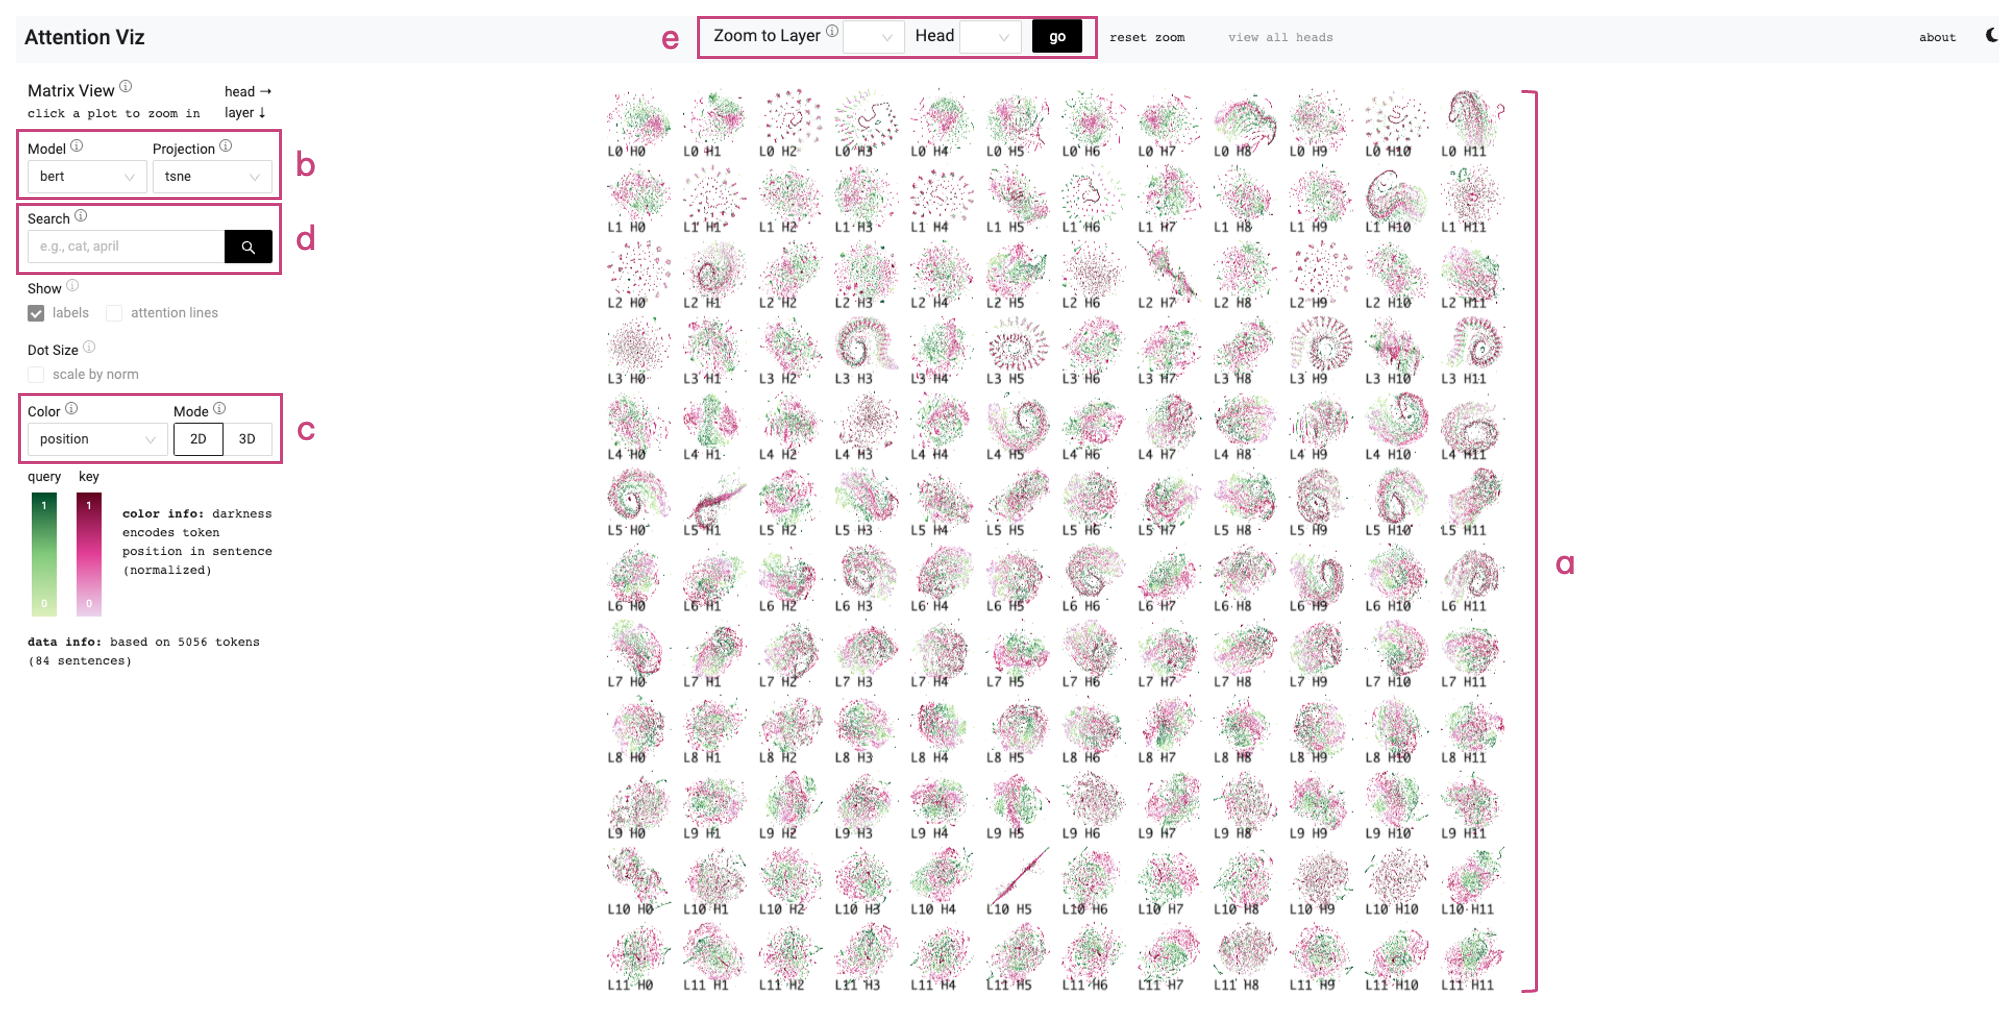
트랜스포머 어텐션을 단일 문장의 bipartite 그래프가 아니라 다수 입력에 걸친 query-key joint embedding으로 사영해 헤드 전체를 한눈에 비교하는 시각화 기법과 도구 AttentionViz. BERT의 나선·induction head, ViT의 hue·brightness 헤드, GPT-2의 norm disparity 같은 발견을 사례로 든다.
Goodfire가 Llama 3.1 8B의 레이어 18에서 발견한 범용 덧셈 모듈. 숫자를 푸리에 기반 원형으로 표현하고, 산술·요일·월 과제에서 같은 회로를 공유하며, steering으로 인과적 역할을 검증했다.