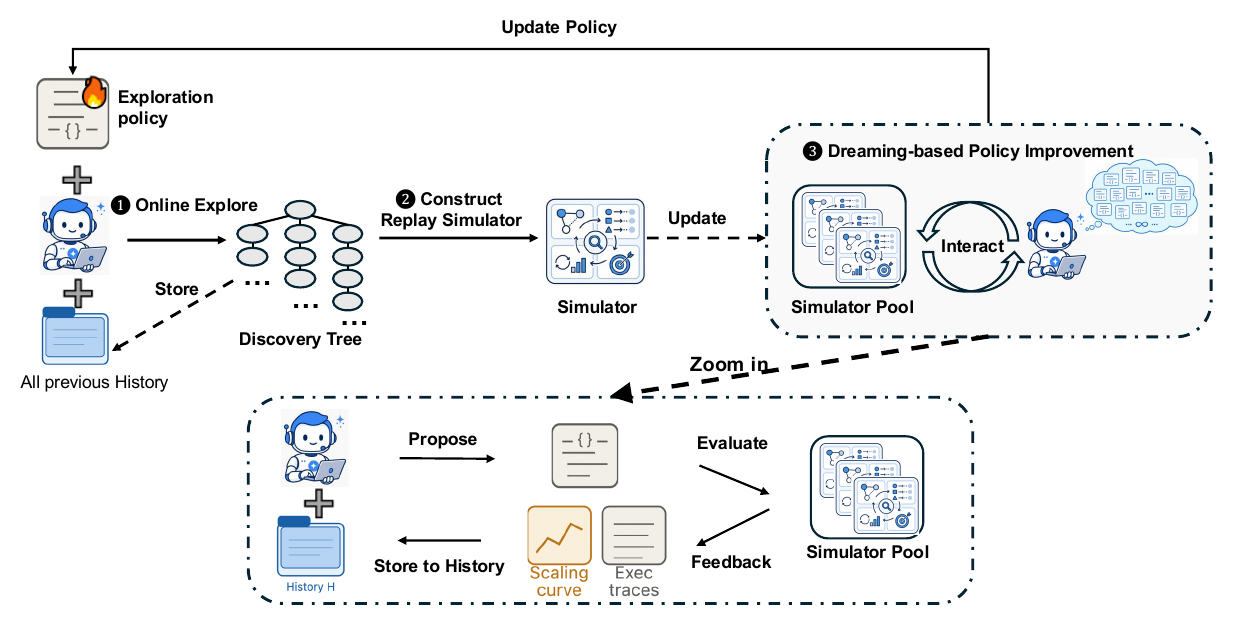
Dream-RSI: Recursive Self-Improvement through Evolving Worlds
구글과 구글 딥마인드, 메릴랜드대, 버지니아대의 연구자 17명이 코딩 에이전트의 탐색 정책을 재귀적으로 고쳐 쓰는 방법을 내놓았다. 새 정책을 시험하려고 발견 과정을 다시 돌리는 대신, 지난 실행이 남긴 발견 트리를 재생 시뮬레이터로 삼아 실행 비용 없이 수천 개의 후보를 채점한다.
구글과 구글 딥마인드, 메릴랜드대, 버지니아대의 연구자 17명이 코딩 에이전트의 탐색 정책을 재귀적으로 고쳐 쓰는 방법을 내놓았다. 새 정책을 시험하려고 발견 과정을 다시 돌리는 대신, 지난 실행이 남긴 발견 트리를 재생 시뮬레이터로 삼아 실행 비용 없이 수천 개의 후보를 채점한다.
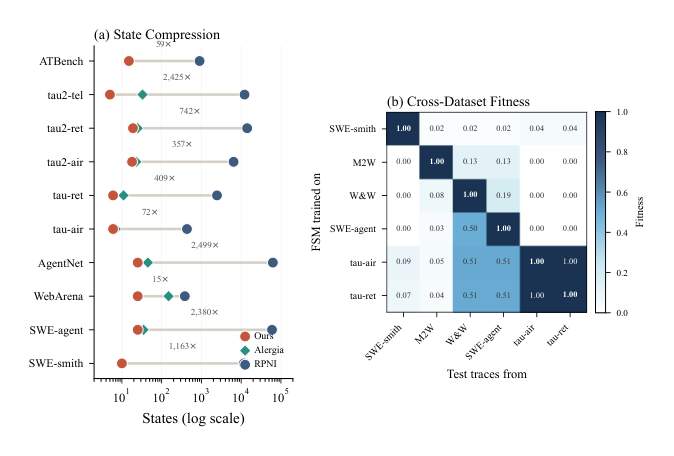
LLM 에이전트의 실행 로그 전체를 상태 7개에서 43개짜리 유한 상태 기계 한 대로 압축하면, 다음 행동 예측과 실패 예측과 런타임 감시가 같은 구조물 위에서 동시에 해결된다. 그리고 그 구조물의 모양은 모델이 아니라 배포 하네스가 정한다.
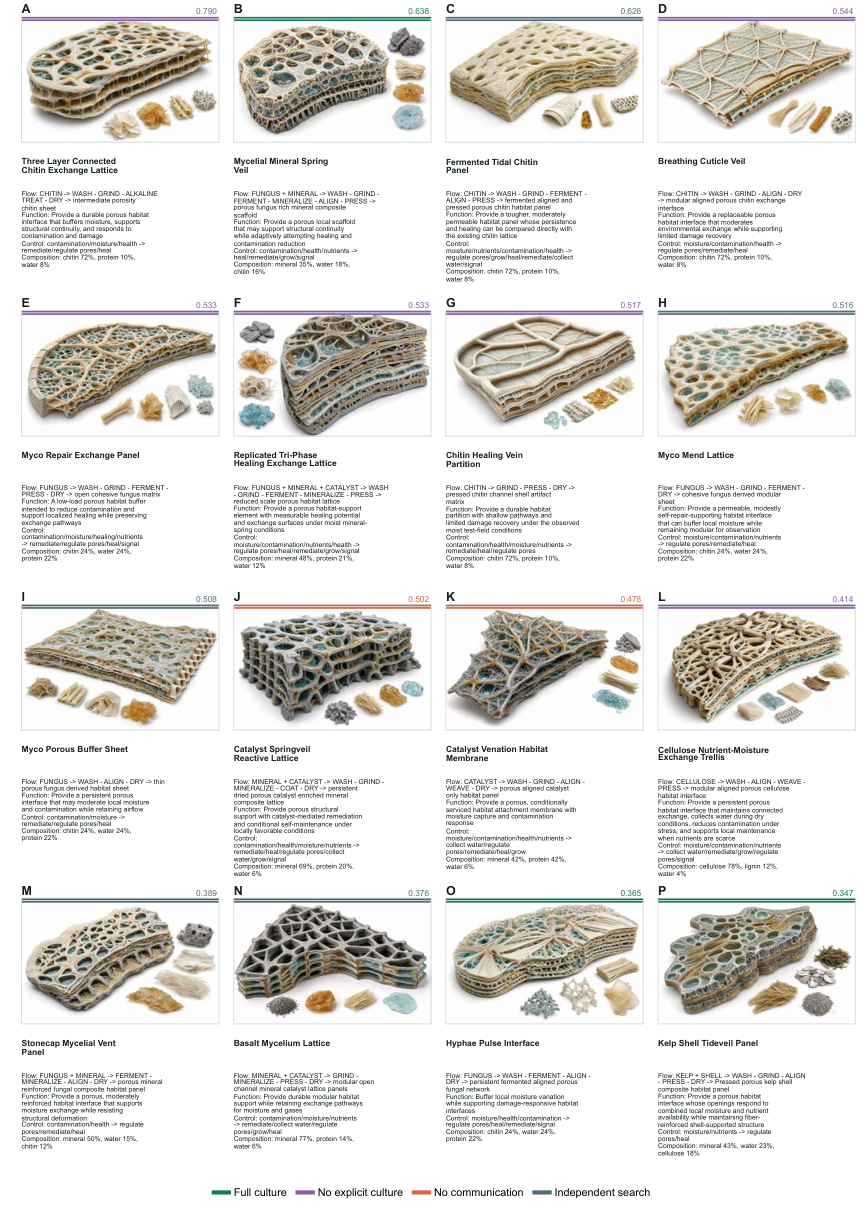
MIT 연구진이 역할도 레시피도 주지 않은 LLM 에이전트 수백 명을 지속적 물리 세계에 풀어놓고, 이들이 남긴 기술을 에이전트가 모두 사라진 뒤에 시험했다. 공유 세계를 가진 사회는 고립 탐색보다 넓고 견고한 기술 포트폴리오를 만들었지만, 최강 단일 발명품은 여전히 고립 탐색의 몫이었다.
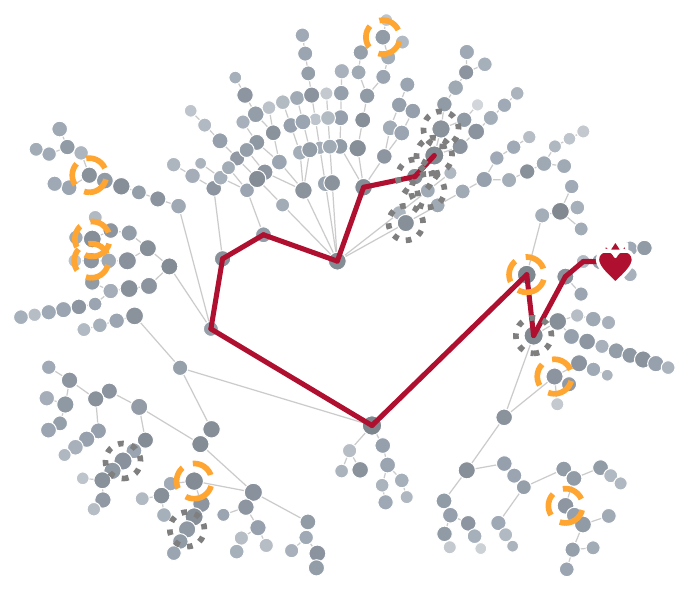
자기 개선 에이전트의 평가 기준을 고정하지 않고 에이전트와 함께 진화시키는 탐색 프레임워크. 코딩·논문 쓰기·증명 쓰기 세 영역에서 고정 평가자 기준선을 앞섰고, AI가 쓴 글을 지나치게 잘 받아주던 심사자의 편향까지 탐색 중에 교정했다.
선형으로 줄 세운 에이전트를 그래프로 다시 그리는 14단계 강의. 노드와 엣지에서 시작해 팬아웃·팬인, 검증자, 수렴하는 순환까지 Claude Code의 dynamic workflows로 짓는 법을 정리한다.
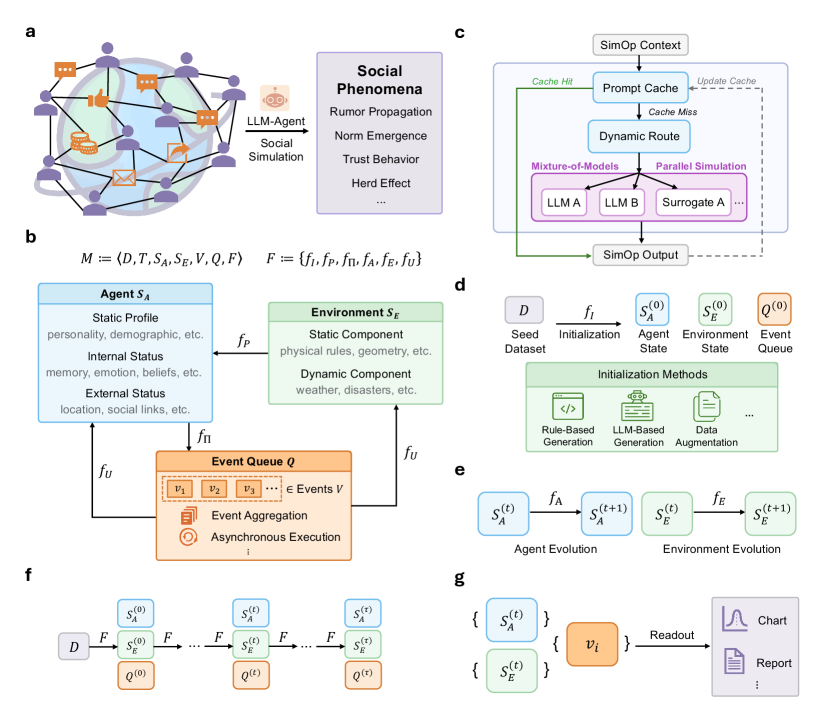
LLM 기반 사회 시뮬레이션을 10억 에이전트 규모로 끌어올린 Light Society 프레임워크. 완전 LLM과 증류된 대체 모델을 섞는 mixture-of-models 엔진으로 추론 비용을 낮추고, 신뢰 게임과 의견 확산 실험으로 인구 규모가 커질수록 인구통계 효과가 선명해진다는 것을 보인다.
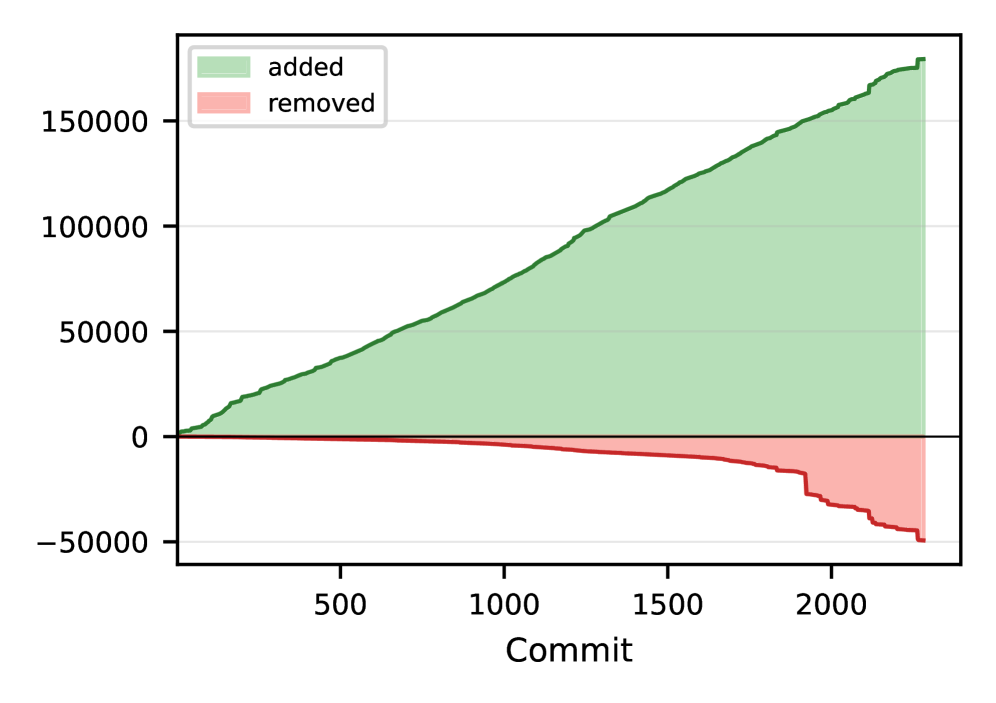
500쪽 넘는 대학원 대수적 조합론 교과서 전체를 3만 개 Claude 4.5 Opus 에이전트가 1주 만에 Lean으로 형식화한 사례 연구. 13만 줄, 5,900개 선언, 약 10만 달러. 형식 수학의 규모 기록이자 멀티에이전트 소프트웨어 공학의 규모 기록이기도 하다.
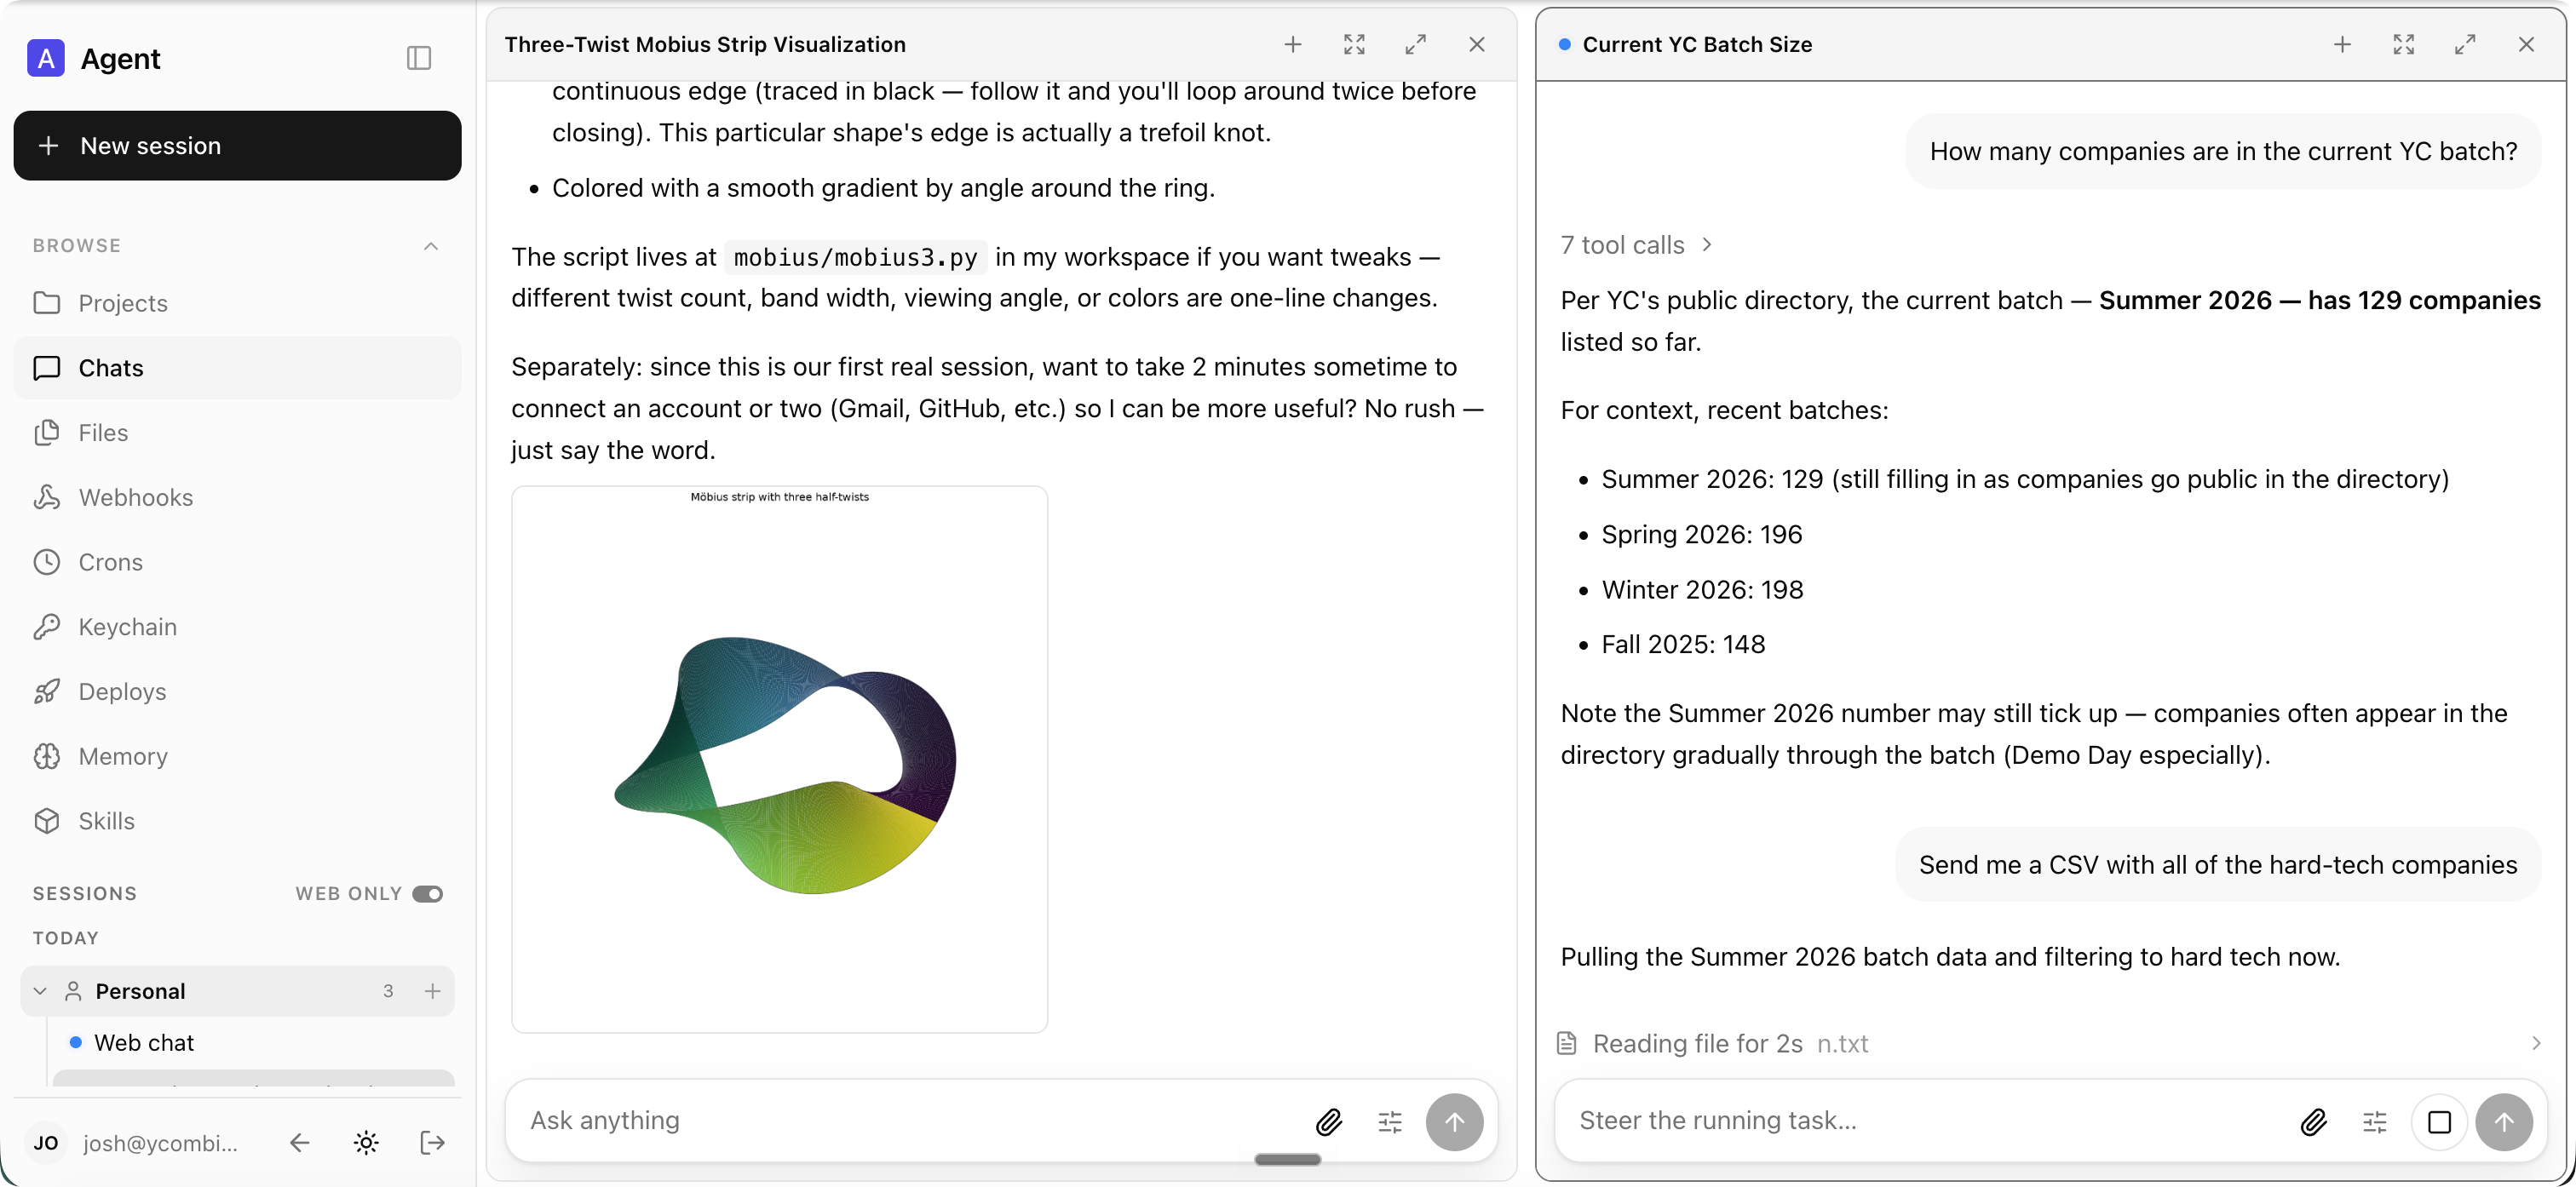
yc-software가 MIT로 공개한 멀티플레이어 에이전트 하네스 QM. 사람마다·방마다 격리된 스코프를 두고, 하네스와 모델을 갈아끼우며, 슬랙과 웹에서 조직 전체가 함께 쓰도록 설계됐다.
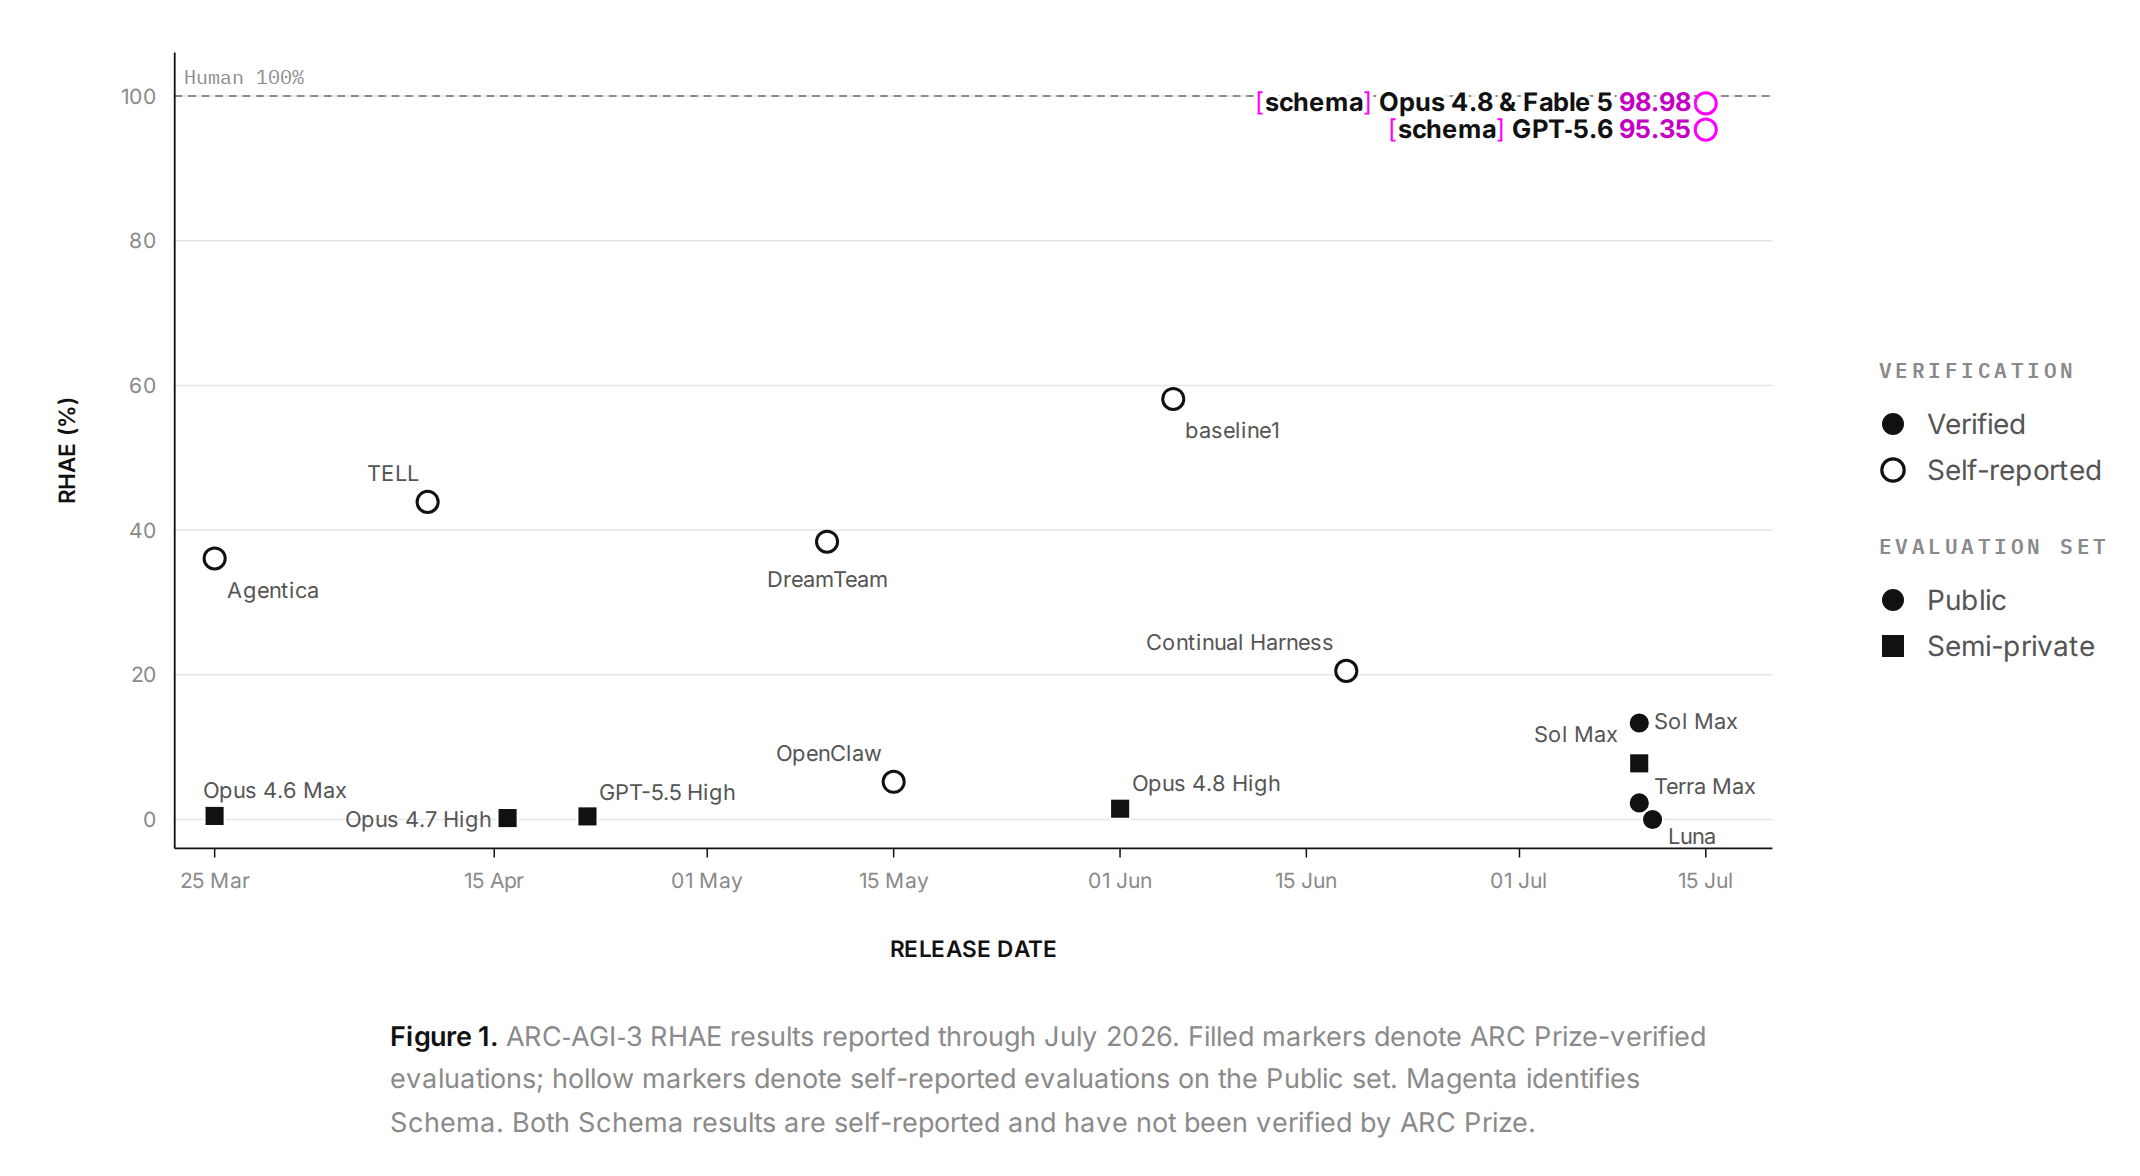
모델 가중치는 그대로 두고 ‘쓰는 방식’만 바꾼 에이전트 하니스 Schema가 ARC-AGI-3 Public에서 자가보고 98.98%를 기록했다. 핵심은 세계 모델을 읽고 diff할 수 있는 실행 가능한 프로그램으로 만들어, 기록된 현실 전체에 대해 검증하고, 그 안에서 계획을 탐색하는 것이다.
개인 AI 작업 환경을 ‘마찰을 줄인다’는 기준 하나로 진화시켰더니, 도착한 곳은 조직 인프라의 문법이었다. 그 과정의 기록.