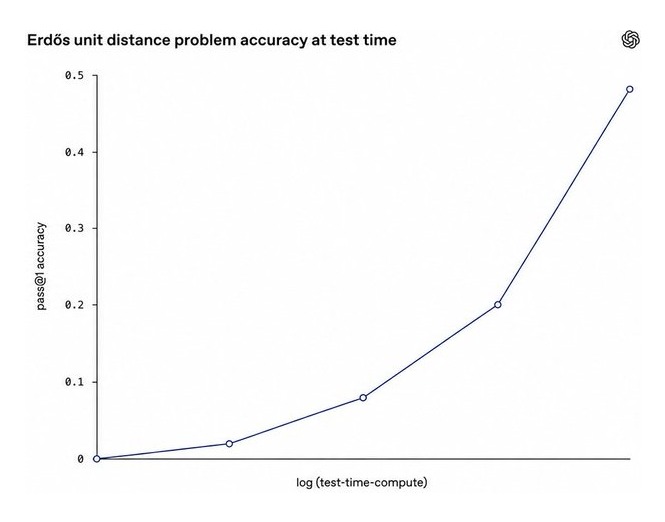
노암 브라운: 대규모 테스트 타임 컴퓨트의 함의 (2026)
OpenAI 추론 연구자 노암 브라운(@polynoamial)이 X에 올린 장문 글을 정리한다. 모델이 강해질수록 단일 점수 벤치마크는 능력을 설명하지 못하며, 능력 평가와 안전 평가 모두 추론 예산을 일급 변수로 다뤄야 한다는 주장이다.
OpenAI 추론 연구자 노암 브라운(@polynoamial)이 X에 올린 장문 글을 정리한다. 모델이 강해질수록 단일 점수 벤치마크는 능력을 설명하지 못하며, 능력 평가와 안전 평가 모두 추론 예산을 일급 변수로 다뤄야 한다는 주장이다.
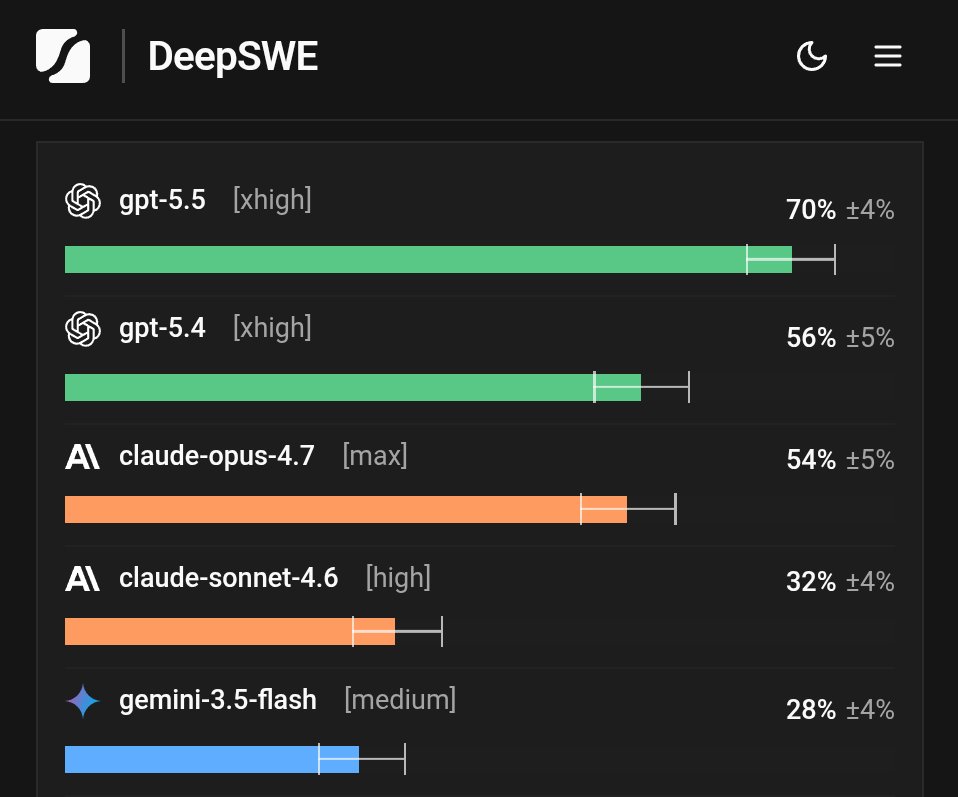
Datacurve가 처음부터 새로 쓴 오염 없는 과제로 프론티어 코딩 에이전트를 평가하니, SWE-Bench류에서 근접하던 모델들이 넓게 갈라졌다. gpt-5.5 70% vs claude-sonnet-4.6 32%.
ChatGPT·Claude·Gemini 등 최신 LLM 15종이 underspecified 다중턴 대화에서 단일턴 대비 평균 39% 성능 저하를 보인다는 대규모 시뮬레이션 연구. 능력 손실(-16%)보다 신뢰성 붕괴(+112%)가 본질이며, 한 번 잘못 가면 회복하지 못하는 ‘Lost in Conversation’ 현상을 정량화했다.
ARC Prize가 GPT-5.5와 Opus 4.7에게 한 번도 본 적 없는 게임 135개를 던졌다. 둘 다 1%도 못 풀었지만, 진짜 발견은 점수가 아니라 틀리는 방식의 차이였다.
ARC Prize가 GPT-5.5와 Opus 4.7을 ARC-AGI-3으로 평가한 분석 보고서. 두 모델 모두 1% 미만의 점수를 기록했지만, 진짜 발견은 점수가 아니라 실패의 질적 차이에 있다.
LLM에 문서 편집을 위임하면 프론티어 모델조차 20회 상호작용 후 평균 25%의 콘텐츠를 손상시킨다. Microsoft Research가 52개 전문 도메인 벤치마크(DELEGATE-52)로 실증했다.
Anthropic이 공개한 99문제 바이오인포매틱스 벤치마크 BioMysteryBench. 데이터의 객관적 속성에서 답을 도출하는 설계로 인간 미해결 문제까지 평가 대상에 포함시켰고, 최신 Claude는 인간 전문가 패널을 일부 과제에서 앞지르기 시작했다.
자연 대화 기반 ToM 벤치마크. 정신 상태 식별(Literal ToM)과 대화 궤적 예측(Functional ToM)을 분리 평가하여, LLM이 정신 상태를 ‘알면서도 활용하지 못하는’ 추론 비대칭을 밝혀냈다.
설득 대화 시나리오에서 LLM의 Theory of Mind을 BDI 프레임워크로 평가하는 벤치마크. GPT-4o조차 피설득자의 동적 욕구 추적에서 인간 대비 17%p, 설득자 의도 추론에서 32%p 뒤처진다.
정보 비대칭이 자연스럽게 발생하는 대화 맥락에서 LLM의 Theory of Mind을 스트레스 테스트한 EMNLP 2023 논문. 최선의 LLM도 인간과 큰 격차를 보이며, CoT와 파인튜닝으로도 해소되지 않는다.